
如何使用 MYSQL 安装和配置 HIVE Metastore
 大卫卡特
什么是 HIVE Metastore?
Hive 元数据存储库是一个用于存储与 Hive 相关的元数据(列名、数据类型、注释等)的存储库。 阿帕奇蜂巢 使用 MySQL or PostgreSQL. 这个 Hive metastore 是使用关系数据库中的表实现的。
元数据存储中并不保存任何实际的行数据。记录保存在 HDFS 上,元数据存储仅记录每个表的位置和列的名称,因此丢失元数据存储只会丢失数据模式,而不会丢失数据本身。
为什么要使用 MySQL 在 Hive 中作为 Metastore
元数据存储后端是一个可选组件,并非 Hive 的固定组成部分,而且默认配置刻意做到了极简。三个限制因素使得几乎所有 Hive 安装都放弃了它。
- 默认情况下,Hive 使用 Derby 数据库作为元数据存储。
- Derby 一次只能支持一个活跃用户。
- 不建议在生产环境中使用 Derby。
所以,这里的解决方案是:
- 绝大部分储备使用 MySQL 在后端用作元数据存储,以便同时连接多个用户到 Hive。
- MySQL 是独立元数据存储的最佳选择
如何安装和配置 Hive Metastore MySQL 数据库
以下九个步骤按顺序在已安装 Hadoop 和 Hive 的机器上运行。每个步骤最后都会附上实际终端或 shell 输出的屏幕截图。
步骤 1) 安装 MySQL 服务器
在此步骤中,我们将执行两项任务
- 安装 mysql-server
- 检查 mysql-server 及其进程
使用 sudo apt-get安装mysql-server 命令,我们可以下载 MySQL 服务器安装 MySQL 如下面的截图所示。

安装成功后, MySQL 将按以下屏幕截图所示运行,其中进程检查确认服务已启动。

步骤 2) 安装 MySQL Java 接头类型
安装 MySQL Java 连接器。这是用于 Java 出于依赖关系和连接目的,因为 Hive 达到 MySQL 通过 JDBC 连接。下一张截图显示了软件包的安装过程。

步骤 3)为连接器创建软链接
在 Hive lib 目录中为连接器创建软链接。这是两者之间的软链接。 Java 和 MySQL它会将驱动程序 JAR 文件添加到 Hive 类路径中。命令及其结果如下所示。

步骤 4)配置 MySQL Hive 中的存储
此 MySQL 必须先以 root 帐户打开 shell,然后才能创建任何 Hive 用户,如下所示。

- 输入 mysql -u root -p,然后输入密码
- 这里,-u 代表 root 用户名,-p 代表密码
- 输入上述命令后,用户必须输入有效的密码,然后按回车键。
- 然后它将进入 MySQL 壳模式
步骤 5)创建用户名和密码
创建用户名和密码 MySQL并授予权限。下面的屏幕截图显示了在内部运行的三条语句。 MySQL 贝壳。

我们必须执行如下所示的命令,
mysql> CREATE USER 'hiveuser'@'%' IDENTIFIED BY 'hivepassword';
mysql> GRANT all on *.* to 'hiveuser'@localhost identified by 'hivepassword';
mysql>  flush privileges;
On MySQL 8. 第二条语句的组合形式不再解析,因为 GRANT 语句中移除了 IDENTIFIED BY。请先创建帐户,然后再授予其权限,并对本地主机和通配符主机重复执行 CREATE USER 语句。
步骤 6)配置 hive-site.xml
- 步骤 5 之后,会为用户分配用户名和密码。 MySQL 数据库并授予权限。
- 在这里,我们将配置 Hive 中的一些属性,以便与……建立连接。 MySQL 数据库。
配置文件是从 Hive conf 目录打开的,如下一个屏幕截图所示。

下面的屏幕截图显示了已添加所有四个属性的最终文件。

从上面的截图中,我们可以观察到以下内容。这里我们定义了建立关系所必需的 4 个属性。 MySQL 作为 Hive 中的元数据存储。
这些如下:
- 此属性用于连接 URL这里我们定义连接。URL 在这个属性中,它充当 JDBC 连接字符串,并且也代表元数据存储位置。
- 此属性用于指定连接驱动程序名称。这里,我们需要在值标签中指定 com.mysql.jdbc.Driver 这个值。
- 此属性用于定义连接用户名。在本例中,我们将用户名定义为“hiveuser”。
- 此属性用于指定连接密码。在本例中,我们将“hivepassword”定义为用户密码。
将属性添加到 hive-site.xml 文件后,我们需要手动保存(Ctrl+S)并关闭文件。关闭文件后,我们需要创建一个 Hive 表并检查表的详细信息。 MySQL 存储。
将此代码放置在 hive-site.xml 中
配置单元-site.xml
<configuration>
	<property>
		<name>javax.jdo.option.ConnectionURL</name>
		<value>jdbc:mysql://localhost/metastore?createDatabaseIfNotExist=true</value>
		<description>metadata is stored in a MySQL server</description>
	</property>
	<property>
		<name>javax.jdo.option.ConnectionDriverName</name>
		<value>com.mysql.jdbc.Driver</value>
		<description>MySQL JDBC driver class</description>
	</property>
	<property>
		<name>javax.jdo.option.ConnectionUserName</name>
		<value>hiveuser</value>
		<description>user name for connecting to mysql server</description>
	</property>
	<property>
		<name>javax.jdo.option.ConnectionPassword</name>
		<value>hivepassword</value>
		<description>password for connecting to mysql server</description>
	</property>
</configuration>
以上两个值取决于所使用的连接器版本。 MySQL Connector/J 8 将驱动程序类重命名为 com.mysql.cj.jdbc.Driver,并且它还要求显式指定端口和 SSL 设置,因此需要现代的 URL 通常情况下,该文件会读取 jdbc:mysql://localhost:3306/metastore?createDatabaseIfNotExist=true&useSSL=false。由于密码以明文形式存在,因此该文件应该只有 Hive 服务帐户才能读取。
步骤 7)创建表
在 Hive 中创建表“guru99”,如下面的 Hive shell 所示。

从上面的截图中,我们可以观察到以下内容
- 创建一个名为“guru99”的表,其中包含两个列名
- 列名与其数据类型一并列出,一个是整数,另一个是字符串。
下一步,我们将检查它是否存储在…… MySQL 或没有。
步骤 8)进入 MySQL 壳模式
首先选择元数据存储数据库,其后的表列表如下所示。

从上面的截图中,我们可以观察到以下内容
- 首先,我们需要使用“使用元数据存储”来选择数据库。
- 选择元数据存储后,我们可以使用“show tables”命令检查其中存在的表,如屏幕截图所示。
- 无论在 Hive 中创建什么表,与这些表对应的元数据都存储在 TBLS 下。 MySQL 数据库
- “guru99”表是在Hive中创建的,因此相应的元数据存储在…… MySQL 在TBLS框架下
步骤 9)输入 select * from TBLS
检查创建的表是否存在于 MySQL 也可能没有。查询及其结果显示在下面的屏幕截图中。
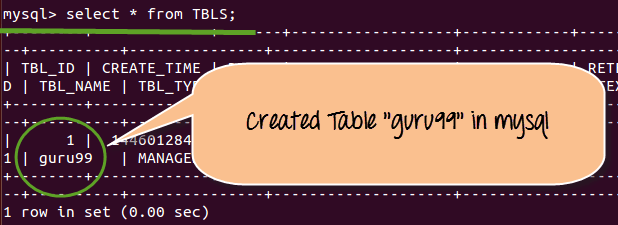
通过输入 select * from TBLS,它将显示我们在 Hive shell 模式下创建的表
从上面的截图我们可以观察到以下几点:
- 在 Hive 中创建的表名“guru99”可以显示在 MySQL 壳模式
- 除此之外,它还会提供诸如表创建时间、访问时间以及其他属性等信息,如上图所示。
如何使用 schematool 初始化 Hive Metastore Schema
连接中的 createDatabaseIfNotExist 标志 URL 它会创建一个空的元数据存储数据库,但不会创建 Hive 期望在其中存在的大约 70 个表。在 Hive 1.x 及更高版本中,这项工作属于 schematool 工具,因此请跳过此步骤。ping 这是新配置的元数据存储拒绝启动的最常见原因。
$HIVE_HOME/bin/schematool -dbType mysql -initSchema
该命令从 hive-site.xml 读取相同的四个属性,使用 hiveuser 帐户连接,并运行与 Hive 版本匹配的捆绑 SQL 脚本。成功运行后会显示完成消息,之后可以随时确认状态。
$HIVE_HOME/bin/schematool -dbType mysql -info
以下标志涵盖元数据存储模式的整个生命周期。
| 附加选项 | 它做什么 |
|---|---|
| -dbType | 指定后端数据库,例如 mysql、derby、postgres、oracle 或 mssql。 |
| -initSchema | 为当前 Hive 版本创建元数据存储表 |
| -信息 | 报告数据库中记录的模式版本 |
| -升级架构 | 在 Hive 升级后迁移现有模式 |
| -证实 | 检查架构中是否存在缺失的表和版本不匹配的情况 |
在首次启动之前,有一个相关的属性值得了解。当 hive.metastore.schema.verification 为 true 时,Hive 会比较 schema 版本。 MySQL 它会检查自身版本,如果版本不匹配则拒绝运行。这种检查是一种安全措施,因此正确的做法是运行升级而不是将其关闭。 MySQL 本文介绍的 Hive 安装使用了后端。 安装 Hive Ubuntu.
常见的 Hive Metastore 错误及其修复方法
此阶段的大多数故障都会产生少数几条消息中的一条,每条消息都指向上面的特定步骤,而不是 Hive 本身。
| 症状 | 原因及解决方法 |
|---|---|
| 元数据存储中未找到版本信息 | 该模式从未创建。请使用 `-initSchema` 参数对连接中指定的同一数据库运行 `schematool` 命令。 URL |
| JDBC 驱动程序出现 ClassNotFoundException 异常 | Hive lib 目录中缺少连接器 JAR 文件,或者正在使用 Connector/J 8,此时该类已更改为 com.mysql.cj.jdbc.Driver。请重新检查步骤 3 中的软链接。 |
| 用户 hiveuser 访问被拒绝 | 权限仅授予了一台主机。请为本地主机和通配符主机创建帐户,然后运行 flush privileges 命令。 |
| IDENTIFIED BY 附近存在语法错误 | MySQL 8. 从 GRANT 语句中移除 IDENTIFIED BY。先执行 CREATE USER,再执行 GRANT。 |
| 不允许获取公钥。 | Connector/J 8 默认拒绝未加密的握手。请在 JDBC 配置中添加 useSSL=false 和 allowPublicKeyRetrieval=true。 URL 在可信网络上 |
| Hive升级后缺少表 | 该模式仍然与旧版本匹配。请使用 `-upgradeSchema` 参数运行 schematool,而不是禁用模式验证。 |
一旦元数据存储可靠地响应,就会使用文中描述的语句创建它记录的表定义。 Hive 创建、修改和删除表.
