
Python RegEx: re.match(), re.search(), re.findall() med Eksempel
 Anna Blake
⚡ Smart oppsummering
Python Veiledningen for regulære uttrykk dekker re.match, re.search, re.findall og re.split gjennom praktiske eksempler. Lessons forklarer metategn, tegnklasser, grupper, flagg, substitusjon og vanlige mønstre for tekstparsing og validering.
Hva er regulært uttrykk i Python?
A Regulært uttrykk (RE) i et programmeringsspråk er en spesiell tekststreng som brukes til å beskrive et søkemønster. Den er ekstremt nyttig for f.eks.trachente informasjon fra tekst som kode, filer, logger, regneark eller til og med dokumenter.
Mens du bruker Python regulære uttrykk det første er å gjenkjenne er at alt i hovedsak er et tegn, og vi skriver mønstre for å matche en bestemt sekvens av tegn, også referert til som streng. Ascii eller latinske bokstaver er de som er på tastaturene dine, og Unicode brukes for å matche den fremmede teksten. Den inkluderer sifre og tegnsetting og alle spesialtegn som $#@!% osv.
For eksempel a Python regulære uttrykk kan fortelle et program å søke etter spesifikk tekst fra strengen og deretter skrive ut resultatet deretter. Uttrykk kan inkludere
- Tekstmatching
- Gjentakelse
- forgrening
- Mønster-komposisjon etc.
Regulært uttrykk eller RegEx in Python er angitt som RE (RE-er, regexes eller regex-mønster) importeres gjennom re modul. Python støtter regelmessig uttrykk gjennom biblioteker. RegEx i Python støtter ulike ting som Modifikatorer, identifikatorer og mellomromstegn.
| Identifikatorer | Modifikatorer | Tegn med hvite mellomrom | Rømning nødvendig |
|---|---|---|---|
| \d= et hvilket som helst tall (et siffer) | \d representerer et siffer. Eks: \d{1,5} vil deklarere siffer mellom 1,5 som 424,444,545 osv. | \n = ny linje | . + * ? [] $ ^ () {} | \ |
| \D= alt annet enn et tall (et ikke-siffer) | + = samsvarer med 1 eller flere | \s= mellomrom | |
| \s = mellomrom (tab, mellomrom, ny linje osv.) |
? = samsvarer med 0 eller 1 | \t =tab | |
| \S= alt annet enn et mellomrom | * = 0 eller mer | \e = rømme | |
| \w = bokstaver (Samsvar med alfanumerisk tegn, inkludert "_") | $ samsvarer med slutten av en streng | \r = vognretur | |
| \W =alt annet enn bokstaver (Svarer til et ikke-alfanumerisk tegn unntatt "_") | ^ samsvarer med starten på en streng | \f= skjemafeed | |
| . = alt annet enn bokstaver (punktum) | | samsvarer med enten eller x/y | ------ | |
| \b = et hvilket som helst tegn bortsett fra ny linje | [] = område eller "varians" | ------ | |
| \. | {x} = denne mengden av forrige kode | ------ |
Syntaks for regulært uttrykk (RE).
import re
- "re"-modul følger med Python primært brukt til strengsøking og manipulering
- Brukes også ofte for nettsider "Arrping"(f.eks.tracstore mengder data fra nettsteder)
Vi vil begynne uttrykksopplæringen med denne enkle øvelsen ved å bruke uttrykkene (w+) og (^).
Eksempel på w+ og ^ uttrykk
- «^»: Dette uttrykket samsvarer med starten på en streng
- "w+“: Dette uttrykket samsvarer med det alfanumeriske tegnet i strengen
Her vil vi se en Python RegEx Eksempel på hvordan vi kan bruke w+ og ^ uttrykk i koden vår. Vi dekker funksjonen re.findall() i Python, senere i denne opplæringen, men for en stund fokuserer vi ganske enkelt på \w+ og \^ uttrykk.
For eksempel, for strengen vår “guru99, education is fun” hvis vi kjører koden med w+ og^, vil den gi utdataene “guru99”.
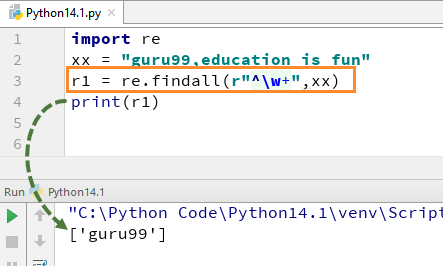
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+",xx)
print(r1)
Husk at hvis du fjerner +tegnet fra w+, vil utdata endres, og det vil bare gi det første tegnet i den første bokstaven, dvs. [g]
Eksempel på \s uttrykk i re.split funksjon
- "s": Dette uttrykket brukes for å lage et mellomrom i strengen
For å forstå hvordan dette RegEx inn Python fungerer, begynner vi med en enkel Python RegEx Eksempel på en delt funksjon. I eksemplet har vi delt hvert ord ved å bruke «re.split»-funksjonen og samtidig har vi brukt uttrykk \s som gjør det mulig å analysere hvert ord i strengen separat.

Når du kjører denne koden vil den gi deg utdataene ['vi', 'er', 'splitting', 'the', 'ord'].
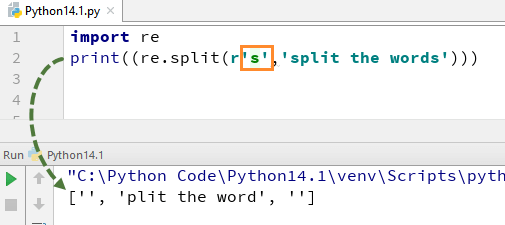
La nå se hva som skjer hvis du fjerner "\" fra s. Det er ikke noe 's'-alfabet i utdataene, dette er fordi vi har fjernet '\' fra strengen, og den evaluerer "s" som et vanlig tegn og deler dermed ordene der den finner "s" i strengen.
På samme måte er det serier av andre Python regulære uttrykk som du kan bruke på ulike måter i Python som \d,\D,$,\.,\b osv.
Her er den komplette koden
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+", xx)
print((re.split(r'\s','we are splitting the words')))
print((re.split(r's','split the words')))
Deretter skal vi se hvilke typer metoder som brukes med regulært uttrykk i Python.
Bruke regulære uttrykksmetoder
"re"-pakken gir flere metoder for å faktisk utføre spørringer på en inndatastreng. Vi vil se metodene for re in Python:
- re.match()
- forskning()
- re.findall()
Merknader: Basert på de regulære uttrykkene, Python tilbyr to forskjellige primitive operasjoner. Samsvarsmetoden sjekker etter samsvar bare i begynnelsen av strengen, mens søk sjekker for samsvar hvor som helst i strengen.
re.match()
re.match() funksjon av re in Python vil søke i det regulære uttrykksmønsteret og returnere den første forekomsten. De Python RegEx Match-metoden ser etter en match bare i begynnelsen av strengen. Så hvis en match blir funnet på den første linjen, returnerer den matchobjektet. Men hvis en match er funnet i en annen linje, vil Python RegEx Match-funksjonen returnerer null.
Tenk for eksempel på følgende kode for Python re.match() funksjon. Uttrykket "w+" og "\W" vil samsvare med ordene som begynner med bokstaven 'g', og deretter blir ikke alt som ikke starter med 'g' identifisert. For å sjekke samsvar for hvert element i listen eller strengen, kjører vi forloopen i denne Python re.match() Eksempel.

re.search(): Finne mønster i tekst
forskning() funksjonen vil søke i det regulære uttrykksmønsteret og returnere den første forekomsten. I motsetning til Python re.match(), vil den sjekke alle linjene i inndatastrengen. De Python re.search()-funksjonen returnerer et matchobjekt når mønsteret er funnet og "null" hvis mønsteret ikke blir funnet
Hvordan bruker jeg søk()?
For å bruke søke()-funksjonen, må du importere Python re modul først og utfør deretter koden. De Python re.search()-funksjonen tar "mønsteret" og "teksten" for å skanne fra hovedstrengen vår
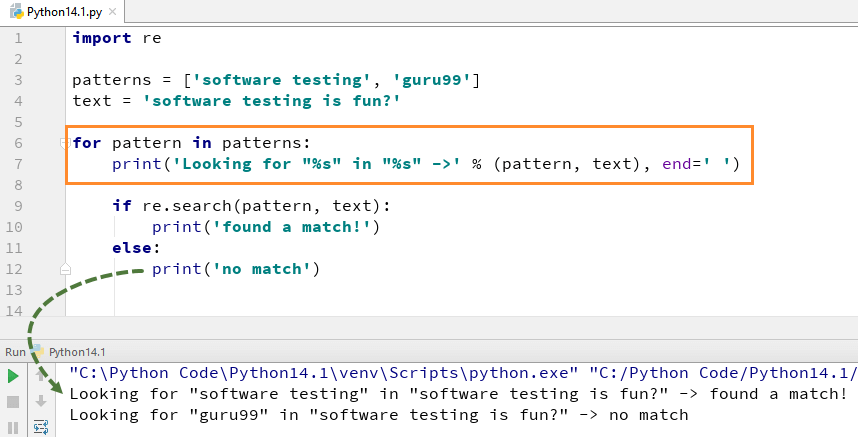
For eksempel her ser vi etter to bokstavelige strenger "Software testing" "guru99", i en tekststreng "Software" Testing er gøy». For "programvaretesting" fant vi samsvaret, og returnerer derfor utdataene til Python re.search() Eksempel som "funnet en match", mens for ordet "guru99" kunne vi ikke finne i strengen, og derfor returnerer det utdata som "No match".
re.findall()
finneall() modulen brukes til å søke etter «alle» forekomster som samsvarer med et gitt mønster. I motsetning til dette vil search()-modulen bare returnere den første forekomsten som samsvarer med det angitte mønsteret. findall() vil iterere over alle linjene i filen og returnere alle ikke-overlappendeping mønstermatchninger i ett enkelt trinn.
Slik bruker du re.findall() i Python?
Her har vi en liste med e-postadresser, og vi ønsker at alle e-postadressene skal hentes ut fra listen, vi bruker metoden re.findall() i Python. Den vil finne alle e-postadressene fra listen.
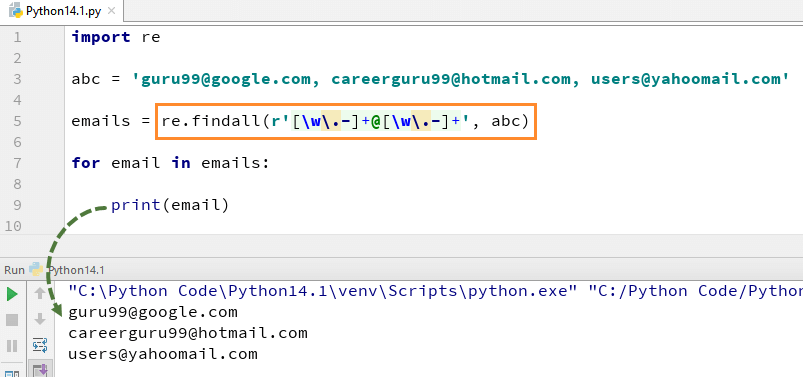
Her er den komplette koden for eksempel på re.findall()
import re

list = ["guru99 get", "guru99 give", "guru Selenium"]
for element in list:
    z = re.match("(g\w+)\W(g\w+)", element)
if z:
    print((z.groups()))

patterns = ['software testing', 'guru99']
text = 'software testing is fun?'
for pattern in patterns:
    print('Looking for "%s" in "%s" ->' % (pattern, text), end=' ')
    if re.search(pattern, text):
        print('found a match!')
else:
    print('no match')
abc = 'guru99@google.com, careerguru99@hotmail.com, users@yahoomail.com'
emails = re.findall(r'[\w\.-]+@[\w\.-]+', abc)
for email in emails:
    print(email)
Python Flagg
Mange Python Regex-metoder og Regex-funksjoner tar et valgfritt argument kalt Flags. Disse flaggene kan endre betydningen av det gitte Python Regex-mønster. For å forstå disse vil vi se ett eller to eksempler på disse flaggene.
Ulike flagg brukt i Python inkluderer
| Syntaks for Regex-flagg | Hva gjør dette flagget |
|---|---|
| [re.M] | La begynne/slutt vurdere hver linje |
| [re.I] | Den ignorerer saken |
| [re.S] | Gjør [ . ] |
| [re.U] | Få { \w,\W,\b,\B} til å følge Unicode-reglene |
| [re.L] | Få {\w,\W,\b,\B} til å følge lokalitet |
| [re.X] | Tillat kommentarer i Regex |
Eksempel på re.M eller Multiline Flags
I multiline samsvarer mønstertegnet [^] med det første tegnet i strengen og begynnelsen av hver linje (følger umiddelbart etter hver ny linje). Mens uttrykket lite "w" brukes til å markere mellomrommet med tegn. Når du kjører koden, skriver den første variabelen "k1" bare ut tegnet 'g' for ord guru99, mens når du legger til flerlinjeflagg, henter den ut de første tegnene i alle elementene i strengen.
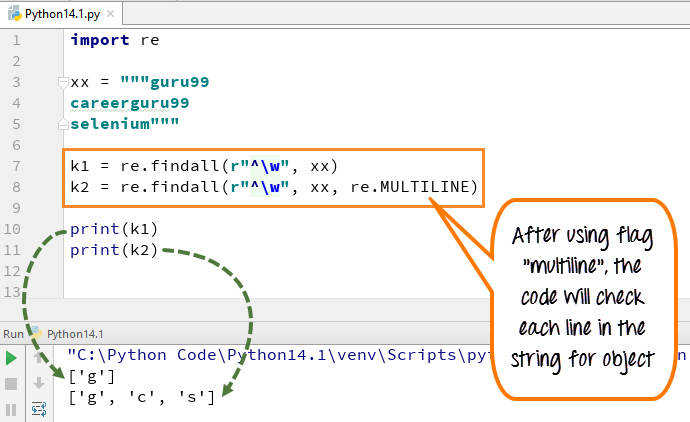
Her er koden
import re
xx = """guru99
careerguru99
selenium"""
k1 = re.findall(r"^\w", xx)
k2 = re.findall(r"^\w", xx, re.MULTILINE)
print(k1)
print(k2)
- Vi erklærte variabelen xx for streng ”guru99…. careerguru99….selenium”
- Kjør koden uten å bruke flagg med flere linjer, det gir utdata bare 'g' fra linjene
- Kjør koden med flagget "multiline", når du skriver ut 'k2' gir det utdata som 'g', 'c' og 's'
- Så forskjellen kan vi se etter og før vi legger til flere linjer i eksemplet ovenfor.
På samme måte kan du også bruke andre Python flagg som re.U (Unicode), re.L (Følg lokalitet), re.X (Tillat kommentar) osv.
Python 2 Eksempel
Kodene ovenfor er Python 3 eksempler, hvis du vil løpe inn Python 2 vurder følgende kode.
# Example of w+ and ^ Expression
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+",xx)
print r1

# Example of \s expression in re.split function
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+", xx)
print (re.split(r'\s','we are splitting the words'))
print (re.split(r's','split the words'))

# Using re.findall for text
import re

list = ["guru99 get", "guru99 give", "guru Selenium"]
for element in list:
    z = re.match("(g\w+)\W(g\w+)", element)
if z:
    print(z.groups())

patterns = ['software testing', 'guru99']
text = 'software testing is fun?'
for pattern in patterns:
    print 'Looking for "%s" in "%s" ->' % (pattern, text),
    if re.search(pattern, text):
        print 'found a match!'
else:
    print 'no match'
abc = 'guru99@google.com, careerguru99@hotmail.com, users@yahoomail.com'
emails = re.findall(r'[\w\.-]+@[\w\.-]+', abc)
for email in emails:
    print email

# Example of re.M or Multiline Flags
import re
xx = """guru99
careerguru99
selenium"""
k1 = re.findall(r"^\w", xx)
k2 = re.findall(r"^\w", xx, re.MULTILINE)
print k1
print k2
Test din Python Kunnskap
1. Hvilken metode brukes for å finne alle forekomster av et mønster i en streng?
- forskning()
- re.match()
- re.findall()
- re.split()
2. Hva representerer tegnklassen \d i regulære uttrykk?
- Ethvert siffer (0-9)
- Ethvert ikke-sifret tegn
- Ethvert mellomromstegn
- Enhver bokstav eller tall
3. Hvilken funksjon vil du bruke for å dele en streng basert på mellomrom?
- re.split(r'\s', streng)
- re.findall(r'\w+', streng)
- re.match(r'\s+', streng)
- re.split(r'\w+', streng)
4. Hva er hovedforskjellen mellom re.match() og re.search()?
- re.match() ser etter et mønster i starten av en streng, mens re.search() ser etter et mønster hvor som helst i strengen.
- re.match() returnerer alle treff, mens re.search() returnerer det første treffet.
- re.search() er raskere enn re.match().
- Begge funksjonene oppfører seg på samme måte.
