
R Data Frame: Cara Membuat, Menambahkan, Memilih & Subset
 Evelyn Clarke
⚡ Ringkasan Cerdas
R Data Frame menyimpan kolom-kolom dengan tipe berbeda dengan panjang yang sama, sehingga menjadikannya struktur persegi panjang standar untuk analisis. Tanda kurung siku memotong baris dan kolom, tanda dolar mencapai kolom, dan subset() memfilter berdasarkan kondisi.
Apa itu Bingkai Data?
A bingkai data adalah daftar vektor yang memiliki panjang yang sama. Sebuah matriks hanya berisi satu jenis data, sedangkan data frame menerima berbagai jenis data (numerik, karakter, faktor, dll.).
Definisi tersebut menempatkan data frame di antara dua tetangga yang akan sering Anda temui di R. A matriks berbentuk persegi panjang tetapi bertipe tunggal, dan sebuah daftar bersifat multi-tipe tetapi tidak rapi. Data frame meminjam satu properti dari masing-masing tipe.
| Structure | Jenis kolom | Panjang elemen | Penggunaan khas |
|---|---|---|---|
| vektor | Hanya satu jenis | Urutan tunggal | Satu variabel |
| Matriks | Hanya satu jenis | Rectangular | Aljabar numerik |
| Daftar | Campuran jenis apa pun | Mungkin berbeda untuk setiap elemen. | Koleksi sewenang-wenang |
| Kerangka data | Campuran jenis apa pun | Setiap kolom memiliki panjang yang sama. | Analisis tabular |
Karena data frame pada dasarnya adalah sebuah list, maka fungsi akses yang digunakan pada list juga berlaku di sini, itulah sebabnya tanda dolar ($) muncul lagi di tutorial ini.
Cara Membuat Bingkai Data
Kita dapat membuat kerangka data di R Dengan memasukkan variabel a, b, c, dan d ke dalam fungsi data.frame(). Kita dapat membuat data frame dan memberi nama kolom dengan names(), cukup dengan menentukan nama setiap variabel.
data.frame(df, stringsAsFactors = TRUE)
kasus:
- df: Ini bisa berupa matriks untuk diubah sebagai bingkai data atau kumpulan variabel untuk digabungkan
- stringAsFactors: Mengontrol apakah vektor karakter menjadi kolom faktor. Nilai default bawaan pabrik adalah TRUE pada rilis sebelumnya dan telah menjadi FALSE sejak R 4.0.0, jadi berikan nilai ini secara eksplisit jika perilaku tersebut penting.
Kita dapat membuat kerangka data di R untuk kumpulan data pertama kita dengan menggabungkan empat variabel dengan panjang yang sama.
# Create a, b, c, d variables
a <- c(10,20,30,40)
b <- c('book', 'pen', 'textbook', 'pencil_case')
c <- c(TRUE,FALSE,TRUE,FALSE)
d <- c(2.5, 8, 10, 7)
# Join the variables to create a data frame
df <- data.frame(a,b,c,d)
df
Keluaran:
##     a         b     c     d
## 1  10        book  TRUE   2.5
## 2  20         pen  FALSE  8.0
## 3  30    textbook  TRUE   10.0
## 4  40 pencil_case  FALSE  7.0
Setiap vektor menjadi sebuah kolom, dan keempat nilai dalam setiap vektor menjadi empat baris. Perhatikan bahwa argumen tidak diberi nama, sehingga R mengambil judul kolom dari nama variabel itu sendiri.
Kita dapat melihat header kolom memiliki nama yang sama dengan variabelnya. Kita dapat mengubah nama kolom di R dengan fungsi nama(). Periksa contoh R membuat kerangka data di bawah ini:
# Name the data frame
names(df) <- c('ID', 'items', 'store', 'price')
df
Keluaran:
##   ID       items store price
## 1 10        book  TRUE   2.5
## 2 20         pen FALSE   8.0
## 3 30    textbook  TRUE  10.0
## 4 40 pencil_case FALSE   7.0
Memberikan nilai ke names() akan mengganti semua header sekaligus, jadi vektor pengganti harus memiliki tepat satu entri per kolom. Untuk mengganti nama satu kolom saja, indeks vektor names, seperti names(df)[2] <- 'product'.
# Print the structure
str(df)
Keluaran:
## 'data.frame':    4 obs. of  4 variables:
##  $ ID   : num  10 20 30 40
##  $ items: Factor w/ 4 levels "book","pen","pencil_case",..: 1 2 4 3
##  $ store: logi  TRUE FALSE TRUE FALSE
##  $ price: num  2.5 8 10 7
Catatan versi. Output di atas dihasilkan pada rilis R yang lebih lama dari 4.0.0, di mana data.frame() secara default mengkonversi vektor karakter menjadi faktor, itulah sebabnya item dilaporkan sebagai Faktor dengan empat level. Dokumentasi dasar R mencatat bahwa pengaturan default bawaan pabrik ini diubah menjadi stringsAsFactors = FALSE untuk R 4.0.0Menjalankan kode yang sama pada rilis terbaru akan menghasilkan item sebagai kolom karakter biasa, dan str() akan mencetak chr. Tambahkan stringsAsFactors = TRUE ke panggilan data.frame() untuk mereproduksi output yang dicetak, atau baca tutorial faktor untuk saat faktor-faktor tersebut benar-benar dibutuhkan.
Bingkai Data Iris
Setelah kerangka dibuat, tugas selanjutnya adalah menarik kembali bagian-bagiannya. Pengirisian adalah cara dasar R untuk melakukan itu, dan menggunakan tanda kurung siku yang sama seperti vektor, hanya saja dengan dua posisi, bukan satu.
Kita dapat memotong nilai-nilai dari Data Frame menggunakan fungsi SLICE. Kita memilih baris dan kolom yang akan dikembalikan di dalam tanda kurung yang diawali dengan nama Data Frame.
Bingkai data terdiri dari baris dan kolom, df[A, B]. A mewakili baris dan B mewakili kolom. Kita dapat mengirisnya dengan menentukan baris dan/atau kolom.
Dari gambar 1 di bawah, bagian kiri mewakili baris, dan bagian kanan adalah kolom. Perhatikan bahwa simbol : berarti untuk. Misalnya, 1:3 bermaksud memilih nilai dari 1 untuk 3.

Pada diagram di bawah ini, kami menampilkan cara mengakses berbagai pilihan dari data frame:
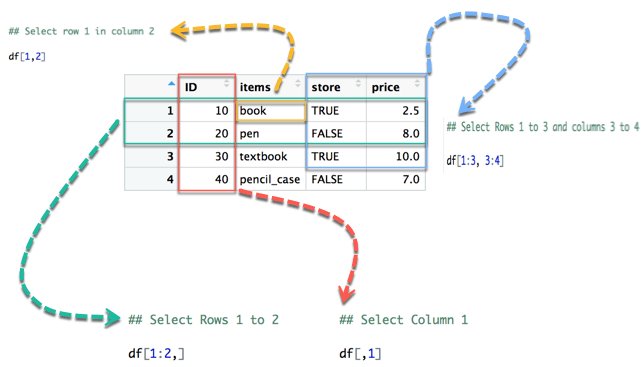
- Panah kuning memilih baris 1 di kolom 2
- Panah hijau memilih baris 1 untuk 2
- Panah merah memilih kolom 1
- Panah biru memilih baris 1 hingga 3 dan kolom 3 untuk 4
Perhatikan bahwa, jika kita membiarkan bagian kiri kosong, R akan memilih semua baris. Analoginya, jika bagian kanan dikosongkan, R akan memilih semua kolom.
Kita dapat menjalankan kode di konsol:
## Select row 1 in column 2
df[1,2]
Keluaran:
## [1] book
## Levels: book pen pencil_case textbook
Baris Levels muncul karena items merupakan faktor dalam sesi ini. Pada R 4.0.0 dan versi yang lebih baru, panggilan yang sama mencetak string tunggal "book" tanpa baris Levels.
## Select Rows 1 to 2
df[1:2,]
Keluaran:
##   ID items store price
## 1 10  book  TRUE   2.5
## 2 20   pen FALSE   8.0
## Select Columns 1
df[,1]
Keluaran:
## [1] 10 20 30 40
Memilih satu kolom dengan df[,1] akan menghapus pembungkus frame dan mengembalikan vektor biasa. Tambahkan drop = FALSE, seperti pada df[, 1, drop = FALSE], jika yang dibutuhkan adalah data frame satu kolom.
## Select Rows 1 to 3 and columns 3 to 4
df[1:3, 3:4]
Keluaran:
##   store price
## 1  TRUE   2.5
## 2 FALSE   8.0
## 3  TRUE  10.0
Dimungkinkan juga untuk memilih kolom berdasarkan namanya. Misalnya, kode di bawah ini...tracmemiliki dua kolom: ID dan toko.
# Slice with columns name
df[, c('ID', 'store')]
Keluaran:
##   ID store
## 1 10  TRUE
## 2 20 FALSE
## 3 30  TRUE
## 4 40 FALSE
Nama lebih aman daripada posisi dalam kode produksi, karena menyisipkan atau menyusun ulang kolom secara diam-diam mengubah apa yang dirujuk oleh df[, 3] sementara df[, 'store'] tetap menunjuk ke data yang sama.
Tambahkan Kolom ke Bingkai Data
Anda juga dapat menambahkan kolom ke Data Frame. Anda perlu menggunakan simbol $ untuk memberi nama variabel baru dan menambahkan kolom ke dataframe di R.
# Create a new vector
quantity <- c(10, 35, 40, 5)

# Add `quantity` to the `df` data frame
df$quantity <- quantity
df
Keluaran:
##   ID       items store price quantity
## 1 10        book  TRUE   2.5       10
## 2 20         pen FALSE   8.0       35
## 3 30    textbook  TRUE  10.0       40
## 4 40 pencil_case FALSE   7.0        5
Catatan: Jumlah elemen dalam vektor harus sama dengan jumlah elemen dalam data frame. Jalankan pernyataan berikut untuk menambahkan kolom ke data frame di R.
quantity <- c(10, 35, 40)
# Add `quantity` to the `df` data frame
df$quantity <- quantity
Memberikan kesalahan:
Error in `lt;-.data.frame`(`*tmp*`, quantity, value = c(10, 35, 40))
replacement has 3 rows, data has 4
Pesan tersebut menyebutkan operator penggantian untuk data frame dan menyatakan kedua jumlahnya, sehingga memberi tahu Anda dengan tepat apa yang perlu diperbaiki. R hanya mendaur ulang penggantian ketika panjangnya membagi habis jumlah baris, itulah sebabnya nilai dengan panjang 1 seperti df$currency <- 'EUR' diterima sementara vektor dengan panjang 3 terhadap empat baris ditolak. cbind() menambahkan kolom dengan cara yang sama, dan rbind() adalah pasangannya untuk menambahkan baris.
Pilih Kolom Bingkai Data
Terkadang, kita perlu menyimpan kolom dari sebuah data frame untuk penggunaan di masa mendatang atau melakukan operasi pada kolom tersebut. Kita dapat menggunakan tanda $ untuk memilih kolom dari sebuah data frame.
# Select the column ID
df$ID
Keluaran:
## [1] 1 2 3 4
Bacalah output tersebut dengan saksama. ID dibangun dari vektor c(10, 20, 30, 40), jadi konsol langsung akan mencetak 10 20 30 40 di sini; angka 1 2 3 4 yang ditampilkan di atas adalah posisi baris, bukan nilai yang tersimpan. [1] di awal baris hanyalah indeks elemen pertama pada baris tersebut, bukan bagian dari data.
Tiga rute mencapai kolom yang sama: df$ID, df[['ID']] dan df[, 'ID']. Tanda dolar melakukan pencocokan sebagian, sehingga df$I masih akan menemukan ID, yang nyaman di konsol tetapi berisiko dalam skrip yang disimpan.
Subset Bingkai Data
Di bagian sebelumnya, kami memilih seluruh kolom tanpa syarat. Apakah mungkin untuk bagian berdasarkan benar atau tidaknya kondisi tertentu.
Kami menggunakan fungsi subset().
subset(x, condition)
arguments:
- x: data frame used to perform the subset
- condition: define the conditional statement
Kami hanya ingin mengembalikan barang-barang dengan harga di atas 5, jadi kami dapat melakukan hal berikut:
# Select price above 5
subset(df, subset = price > 5)
Keluaran:
ID       items store price
2 20         pen FALSE     8
3 30    textbook  TRUE    10
4 40 pencil_case FALSE     7
Label baris 2, 3, dan 4 adalah nama baris asli yang dibawa dari df, yang menunjukkan bahwa baris pertama telah difilter. Fungsi subset() juga menerima argumen select untuk memilih kolom secara bersamaan, dan bentuk kurung siku yang setara adalah df[df$price > 5, ]. Bentuk kurung siku mempertahankan baris NA jika kondisinya tidak terpenuhi, sedangkan subset() menghapusnya, sehingga keduanya tidak selalu dapat saling menggantikan.
