
Tutorial Regresi Linier dengan TensorFlow [Contoh]
 Tim Editorial
⚡ Ringkasan Cerdas
Regresi Linier di TensorFlow memodelkan hubungan antara fitur numerik dan nilai target kontinu. Panduan ini melatih prediktor harga rumah di Boston dengan tiga cara berbeda, menggunakan Pandas, NumPy, dan pipeline input TensorFlow asli dengan estimator LinearRegressor.
Apa itu Regresi Linier?
linear Regression Regresi linier adalah pendekatan dalam statistik untuk memodelkan hubungan antara dua variabel. Pemodelan ini dilakukan antara respons skalar dan satu atau lebih variabel penjelas. Hubungan dengan satu variabel penjelas disebut regresi linier sederhana, dan dengan lebih dari satu variabel penjelas disebut regresi linier berganda.
TensorFlow menyediakan alat untuk memiliki kontrol penuh atas komputasi. Hal ini dilakukan dengan API tingkat rendah. Selain itu, TensorFlow dilengkapi dengan beragam API untuk melakukan banyak hal Mesin belajar Algoritma. Ini adalah API tingkat tinggi, dan TensorFlow menyebutnya sebagai estimator.
- API tingkat rendahMembangun arsitektur dan optimasi model dari awal. Ini rumit bagi pemula.
- API tingkat tinggiJelaskan algoritmanya. Algoritma ini mudah digunakan. TensorFlow menyediakan toolbox yang disebut... penduga untuk membangun, melatih, mengevaluasi dan membuat prediksi.
Dalam tutorial ini, Anda akan menggunakan estimator sajaPerhitungannya lebih cepat dan lebih mudah diimplementasikan. Bagian pertama menjelaskan cara menggunakan pengoptimal penurunan gradien untuk melatih regresi linier di TensorFlow. Pada bagian kedua, Anda akan menggunakan dataset Boston untuk memprediksi harga rumah menggunakan estimator TensorFlow.
Cara melatih model regresi linier
Sebelum kita mulai melatih model, mari kita lihat terlebih dahulu apa sebenarnya regresi linier itu.
Bayangkan Anda memiliki dua variabel, x dan y, dan tugas Anda adalah memprediksi nilai y dengan mengetahui nilai x. Jika Anda memplot data tersebut, Anda dapat melihat hubungan positif antara variabel independen Anda, x, dan variabel dependen Anda, y, seperti yang ditunjukkan oleh diagram sebar di bawah ini.

Anda dapat mengamati bahwa jika x=1, maka y akan kurang lebih sama dengan 6, dan jika x=2, maka y akan sekitar 8.5.
Ini bukan metode yang sangat akurat dan rentan terhadap kesalahan, terutama dengan kumpulan data yang berisi ratusan ribu titik.
Regresi linier dievaluasi dengan persamaan. Variabel y dijelaskan oleh satu atau banyak kovariat. Dalam contoh Anda, hanya ada satu variabel terikat. Jika Anda harus menulis persamaan ini, hasilnya akan menjadi:

Dengan:
 adalah biasnya. Artinya, jika x=0, maka y=
 adalah berat yang terkait dengan x
 Residual adalah kesalahan model. Ini mencakup apa yang tidak dapat dipelajari model dari data.
Bayangkan Anda cocok dengan model tersebut dan menemukan solusi berikut untuk:
- = 3.8
- = 2.78
Anda dapat mengganti angka-angka tersebut dalam persamaan dan hasilnya menjadi:
kamu= 3.8 + 2.78x
Sekarang Anda memiliki cara yang lebih baik untuk menemukan nilai y. Artinya, Anda dapat mengganti x dengan nilai apa pun yang Anda inginkan untuk memprediksi y. Pada gambar di bawah, kami telah mengganti x dalam persamaan dengan semua nilai dalam dataset dan memplot hasilnya.

Garis merah mewakili nilai yang sesuai, yaitu nilai y untuk setiap nilai x. Anda tidak perlu melihat nilai x untuk memprediksi y; untuk setiap x terdapat nilai yang sesuai dengan garis merah. Anda juga dapat memprediksi untuk nilai x yang lebih besar dari 2.
Jika Anda ingin memperluas regresi linier ke lebih banyak kovariat, Anda dapat melakukannya dengan menambahkan lebih banyak variabel ke dalam model. Perbedaan antara analisis tradisional dan regresi linier adalah bahwa regresi linier melihat bagaimana y akan bereaksi untuk setiap variabel x yang diambil secara independen.
Mari kita lihat sebuah contoh. Bayangkan Anda ingin memprediksi penjualan toko es krim. Dataset tersebut berisi berbagai informasi seperti cuaca (hujan, cerah, berawan) dan informasi pelanggan (gaji, jenis kelamin, status perkawinan).
Analisis tradisional akan mencoba memprediksi penjualan dengan, misalnya, menghitung rata-rata untuk setiap variabel dan mencoba memperkirakan penjualan untuk berbagai skenario. Hal ini akan menghasilkan prediksi yang kurang akurat dan membatasi analisis pada skenario yang dipilih.
Jika Anda menggunakan regresi linier, Anda dapat menulis persamaan ini:
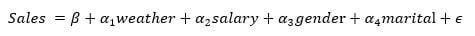
Algoritma akan menemukan solusi terbaik untuk bobot; artinya algoritma akan mencoba meminimalkan biaya, yaitu selisih antara garis yang dipasang dan titik data.
Cara kerja algoritma
Diagram di bawah ini merangkum siklus yang diulang oleh algoritma: memilih bobot, memprediksi y, mengukur kesalahan, dan mengoreksi bobot.

Algoritme akan memilih nomor acak untuk masing-masingnya  ke
 dan ganti nilai x untuk mendapatkan nilai prediksi y. Jika kumpulan data memiliki 100 observasi, algoritme menghitung 100 nilai prediksi.
Kita bisa menghitung kesalahannya, catat  , dari model tersebut, yang merupakan perbedaan antara nilai prediksi dan nilai sebenarnya. Kesalahan positif berarti model meremehkan prediksi y, dan kesalahan negatif berarti model melebih-lebihkan prediksi y.

Tujuan Anda adalah meminimalkan kuadrat kesalahan. Algoritma menghitung rata-rata kuadrat kesalahan. Langkah ini disebut minimisasi kesalahan. Untuk regresi linier, ini adalah Kesalahan Kuadrat Rata-rata, juga disebut UMK. Secara matematis, itu adalah:

Dimana:
 adalah bobotnya, jadi
 mengacu pada nilai prediksi
- y adalah nilai sebenarnya
- m adalah jumlah pengamatan
 mengacu pada nilai prediksi
Perhatikan bahwa  berarti menggunakan transpos matriks. Itu
 adalah notasi matematika dari mean.
Tujuannya adalah untuk menemukan yang terbaik  yang meminimalkan MSE.
Jika kesalahan rata-ratanya besar, berarti kinerja model buruk dan bobot tidak dipilih dengan benar. Untuk memperbaiki bobot, Anda perlu menggunakan pengoptimal. Pengoptimal tradisional disebut Keturunan Gradien.
Gradient descent mengambil turunan dan mengurangi atau menambah bobot. Jika turunannya positif, bobot dikurangi. Jika turunannya negatif, bobot ditambah. Model akan memperbarui bobot dan menghitung ulang kesalahan. Proses ini diulang sampai kesalahan tidak berubah lagi. Setiap tahapan disebut satu siklus. perulanganSelain itu, gradien dikalikan dengan laju pembelajaran, yang menunjukkan kecepatan pembelajaran.
Jika laju pembelajaran terlalu kecil, algoritma akan membutuhkan waktu yang sangat lama untuk konvergen, karena memerlukan lebih banyak iterasi. Jika laju pembelajaran terlalu tinggi, algoritma mungkin tidak akan pernah konvergen. Kurva kerugian di bawah ini memplot kesalahan terhadap jumlah iterasi untuk dataset ini.

Anda dapat melihat dari gambar di atas bahwa model tersebut mengulangi proses sekitar 20 kali sebelum menemukan nilai stabil untuk bobot, sehingga mencapai kesalahan terendah.
Perhatikan bahwa kesalahan tidak sama dengan nol tetapi stabil di sekitar 5. Ini berarti model tersebut membuat kesalahan tipikal sebesar 5. Jika Anda ingin mengurangi kesalahan, Anda perlu menambahkan lebih banyak informasi ke model, seperti lebih banyak variabel, atau menggunakan estimator yang berbeda.
Anda ingat persamaan pertama:

Bobot akhirnya adalah 3.8 dan 2.78. Video di bawah ini menunjukkan bagaimana penurunan gradien mengoptimalkan fungsi kerugian untuk menemukan bobot ini.
Cara melatih Regresi Linier dengan TensorFlow
Sekarang setelah Anda memiliki pemahaman yang lebih baik tentang apa yang terjadi di balik layar, Anda siap menggunakan API estimator yang disediakan oleh TensorFlow untuk melatih regresi linier pertama Anda menggunakan TensorFlow.
Catatan versi: Alur kerja estimator yang ditunjukkan di bawah ini ditulis berdasarkan TensorFlow 1.x dan rilis awal 2.x. TensorFlow menandai tf.estimator ke tf.feature_column API sepenuhnya dihentikan penggunaannya di versi 2.12 dan Estimator dihilangkan di versi 2.16. Pada instalasi terbaru, jalankan kode ini di dalam TensorFlow 1.15 atau 2.x-with-tf.compat.v1 lingkungan, atau memindahkannya ke Keras, di mana tf.keras.layers.Dense(1) Selain itu, lapisan pra-pemrosesan menggantikan LinearRegressor dan kolom fitur. Konsep-konsepnya — fitur, label, batch, epoch, MSE, dan penurunan gradien — tetap sama.
Anda akan menggunakan Boston Dataset, yang mencakup variabel-variabel berikut.
| Variabel | Deskripsi |
| kejahatan | tingkat kejahatan per kapita menurut kota |
| zn | proporsi lahan perumahan yang dikategorikan untuk lahan seluas lebih dari 25,000 kaki persegi. |
| indus | proporsi hektar bisnis non-ritel per kota. |
| nox | konsentrasi oksida nitrat |
| rm | jumlah rata-rata kamar per hunian |
| usia | proporsi unit yang ditempati pemilik yang dibangun sebelum tahun 1940 |
| dis | jarak tertimbang ke lima pusat ketenagakerjaan Boston |
| pajak | tarif pajak properti nilai penuh per dolar 10,000 |
| rasio | rasio murid-guru menurut kota |
| medv | Nilai median rumah yang ditempati pemilik dalam ribuan dolar |
Anda akan membuat tiga kumpulan data berbeda:
| kumpulan data | tujuan | bentuk |
| Pelatihan | Latih model dan dapatkan bobotnya | 400, 10 |
| Evaluasi | Evaluasi kinerja model pada data yang tidak terlihat | 100, 10 |
| Meramalkan | Gunakan model tersebut untuk memprediksi nilai rumah pada data baru | 6, 10 |
Tujuan dari metode ini adalah menggunakan fitur-fitur dalam dataset untuk memprediksi nilai rumah.
Pada bagian kedua tutorial ini, Anda akan mempelajari cara menggunakan TensorFlow dengan tiga cara berbeda untuk mengimpor data:
- Dengan Panda
- Dengan JumlahPy
- Hanya TensorFlow
Perhatikan bahwa ketiga opsi tersebut memberikan hasil yang sama.
Anda akan mempelajari cara menggunakan API tingkat tinggi untuk membangun, melatih, dan mengevaluasi model regresi linier TensorFlow. Jika Anda menggunakan API tingkat rendah, Anda harus mendefinisikan secara manual:
- Fungsi kerugian
- Pengoptimal: penurunan gradien
- perkalian matriks
- Grafik dan tensor
Ini membosankan dan lebih rumit bagi pemula.
Solusi Pandas
Anda perlu mengimpor perpustakaan yang diperlukan untuk melatih model.
import pandas as pd
from sklearn import datasets
import tensorflow as tf
import itertools
Langkah 1) Impor data dengan Panda.
Anda menentukan nama kolom dan menyimpannya dalam variabel COLUMNS. Anda dapat menggunakan pd.read_csv() untuk mengimpor data.
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
           "dis", "tax", "ptratio", "medv"]
Arahkan setiap panggilan ke file CSV yang telah Anda unduh sebelumnya.
training_set = pd.read_csv("E:/boston_train.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
test_set = pd.read_csv("E:/boston_test.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
prediction_set = pd.read_csv("E:/boston_predict.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
Anda dapat mencetak bentuk data.
print(training_set.shape, test_set.shape, prediction_set.shape)
Keluaran
(400, 10) (100, 10) (6, 10)
Perhatikan bahwa label, yaitu y Anda, termasuk dalam dataset. Jadi Anda perlu mendefinisikan dua daftar lain: satu hanya berisi fitur, dan satu lagi hanya berisi nama label. Kedua daftar ini akan memberi tahu estimator Anda fitur apa saja yang ada dalam dataset dan nama kolom mana yang merupakan label.
Itu dilakukan dengan kode di bawah ini.
FEATURES = ["crim", "zn", "indus", "nox", "rm",
                 "age", "dis", "tax", "ptratio"]
LABEL = "medv"
Langkah 2) Konversikan datanya
Anda perlu mengkonversi variabel numerik ke format yang tepat. TensorFlow menyediakan metode untuk mengkonversi variabel kontinu: tf.feature_column.numeric_column().
Pada langkah sebelumnya, Anda telah mendefinisikan daftar fitur yang ingin Anda sertakan dalam model. Sekarang Anda dapat menggunakan daftar ini untuk mengubahnya menjadi data numerik. Jika Anda ingin mengecualikan fitur dari model Anda, silakan hapus satu atau lebih variabel dari daftar FEATURES sebelum Anda membuat feature_cols.
Perhatikan bahwa Anda akan menggunakan Python Gunakan list comprehension dengan list FEATURES untuk membuat list baru bernama feature_cols. Ini membantu Anda menghindari penulisan tf.feature_column.numeric_column() sebanyak sembilan kali. List comprehension adalah cara yang lebih cepat dan lebih rapi untuk membuat list baru.
feature_cols = [tf.feature_column.numeric_column(k) for k in FEATURES]
Langkah 3) Tentukan penduganya
Pada langkah ini, Anda perlu mendefinisikan estimator. TensorFlow menyediakan enam estimator bawaan, tiga untuk tugas klasifikasi dan tiga untuk tugas regresi TensorFlow:
- Regresor
- Regresor DNN
- Regresor Linier
- DNNLinearCombinedRegressor
- menggolongkan
- Pengklasifikasi DNN
- Pengklasifikasi Linier
- Pengklasifikasi Gabungan DNNLinear
Dalam tutorial ini, Anda akan menggunakan Regresor Linier. Untuk mengakses fungsi ini, Anda perlu menggunakan tf.estimator.
Fungsi ini memerlukan dua argumen:
- feature_columns: berisi variabel-variabel yang akan disertakan dalam model.
- model_dir: jalur untuk menyimpan grafik, menyimpan parameter model, dan sebagainya.
TensorFlow akan secara otomatis membuat folder bernama train di direktori kerja Anda. Anda perlu menggunakan jalur ini untuk mengaksesnya. Papan Tensor, seperti yang ditunjukkan pada contoh regresi TensorFlow di bawah ini.
estimator = tf.estimator.LinearRegressor(
        feature_columns=feature_cols,
        model_dir="train")
Keluaran
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a215dc550>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Bagian yang rumit dengan TensorFlow adalah cara memasukkan data ke model. TensorFlow dirancang untuk bekerja dengan komputasi paralel dan kumpulan data yang sangat besar. Karena keterbatasan sumber daya mesin, tidak mungkin untuk memasukkan semua data ke model sekaligus. Untuk itu, Anda perlu memasukkan sejumlah data setiap kali. Perhatikan bahwa kita berbicara tentang kumpulan data yang sangat besar dengan jutaan atau lebih catatan. Jika Anda tidak menambahkan data secara bertahap, Anda akan mengalami kesalahan memori.
Misalnya, jika data Anda berisi 100 observasi dan Anda menentukan ukuran batch 10, itu berarti model akan melihat 10 observasi untuk setiap iterasi (10*10).
Setelah model melihat semua data, ia menyelesaikan satu epoch. Epoch mendefinisikan berapa kali Anda ingin model melihat data. Lebih baik mengatur langkah ini menjadi "none" dan membiarkan model melakukan sejumlah iterasi yang telah ditentukan.
Informasi kedua yang perlu ditambahkan adalah apakah Anda ingin mengacak data sebelum setiap iterasi. Selama pelatihan, penting untuk mengacak data agar model tidak mempelajari pola spesifik dari dataset. Jika model mempelajari detail pola data yang mendasarinya, model akan kesulitan menggeneralisasi prediksi untuk data yang belum pernah dilihat sebelumnya. Ini disebut overfitting. Model berkinerja baik pada data pelatihan tetapi tidak dapat memprediksi dengan benar untuk data yang belum pernah dilihat sebelumnya.
TensorFlow mempermudah kedua langkah ini. Saat data masuk ke pipeline, ia mengetahui berapa banyak observasi yang dibutuhkan (batch) dan apakah data tersebut perlu diacak.
Untuk memberi tahu TensorFlow cara memasukkan data ke model, Anda dapat menggunakan pandas_input_fn. Objek ini membutuhkan lima parameter:
- x: data fitur
- y: data label
- ukuran_batch: kumpulan. Secara default 128
- num_epoch: jumlah epoch, secara default 1
- shuffle: mengacak data atau tidak. Secara default, None
Anda perlu memasukkan data ke model berkali-kali, jadi Anda mendefinisikan sebuah fungsi untuk mengulangi proses ini. Sebut fungsi ini get_input_fn.
def get_input_fn(data_set, num_epochs=None, n_batch = 128, shuffle=True):
         return tf.estimator.inputs.pandas_input_fn(
         x=pd.DataFrame({k: data_set[k].values for k in FEATURES}),
         y = pd.Series(data_set[LABEL].values),
         batch_size=n_batch,
         num_epochs=num_epochs,
         shuffle=shuffle)
Metode yang biasa dilakukan untuk mengevaluasi kinerja suatu model adalah dengan:
- Latih modelnya
- Evaluasi model tersebut pada dataset yang berbeda.
- Buatlah prediksi
Estimator TensorFlow menyediakan tiga fungsi berbeda untuk melakukan ketiga langkah ini dengan mudah.
Langkah 4) Latih modelnya
Anda dapat menggunakan metode pelatihan estimator untuk menyesuaikan model. Estimator pelatihan membutuhkan input_fn dan sejumlah langkah. Anda dapat menggunakan fungsi yang Anda buat di atas untuk memasukkan data ke model. Kemudian Anda menginstruksikan model untuk melakukan iterasi sebanyak 1000 kali. Perhatikan bahwa Anda tidak menentukan jumlah epoch; Anda membiarkan model melakukan iterasi sebanyak 1000 kali. Jika Anda mengatur jumlah epoch menjadi 1, maka model akan melakukan iterasi empat kali, karena ada 400 data dalam set pelatihan dan ukuran batch adalah 128:
- 128 baris
- 128 baris
- 128 baris
- 16 baris
Oleh karena itu, lebih mudah untuk mengatur jumlah epoch menjadi nol dan menentukan jumlah iterasi, seperti yang ditunjukkan pada contoh klasifikasi TensorFlow di bawah ini.
estimator.train(input_fn=get_input_fn(training_set,
                                           num_epochs=None,
                                           n_batch = 128,
                                           shuffle=False),
                                           steps=1000)
Keluaran
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 238.616
INFO:tensorflow:loss = 13909.657, step = 101 (0.420 sec)
INFO:tensorflow:global_step/sec: 314.293
INFO:tensorflow:loss = 12881.449, step = 201 (0.320 sec)
INFO:tensorflow:global_step/sec: 303.863
INFO:tensorflow:loss = 12391.541, step = 301 (0.327 sec)
INFO:tensorflow:global_step/sec: 308.782
INFO:tensorflow:loss = 12050.5625, step = 401 (0.326 sec)
INFO:tensorflow:global_step/sec: 244.969
INFO:tensorflow:loss = 11766.134, step = 501 (0.407 sec)
INFO:tensorflow:global_step/sec: 155.966
INFO:tensorflow:loss = 11509.922, step = 601 (0.641 sec)
INFO:tensorflow:global_step/sec: 263.256
INFO:tensorflow:loss = 11272.889, step = 701 (0.379 sec)
INFO:tensorflow:global_step/sec: 254.112
INFO:tensorflow:loss = 11051.9795, step = 801 (0.396 sec)
INFO:tensorflow:global_step/sec: 292.405
INFO:tensorflow:loss = 10845.855, step = 901 (0.341 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Anda dapat memeriksa TensorBoard dengan perintah berikut:
activate hello-tf
# For MacOS
tensorboard --logdir=./train
# For Windows
tensorboard --logdir=train
Langkah 5) Evaluasi model Anda
Anda dapat mengevaluasi kesesuaian model Anda pada set pengujian dengan kode di bawah ini:
ev = estimator.evaluate(
          input_fn=get_input_fn(test_set,
          num_epochs=1,
          n_batch = 128,
          shuffle=False))
Keluaran
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
Anda dapat mencetak kerugian dengan kode di bawah ini:
loss_score = ev["loss"]
print("Loss: {0:f}".format(loss_score))
Keluaran
Loss: 3215.895996
Model tersebut memiliki kerugian sebesar 3215. Anda dapat memeriksa statistik ringkasan untuk mendapatkan gambaran seberapa besar kesalahannya.
training_set['medv'].describe()
Keluaran
count    400.000000
mean      22.625500
std        9.572593
min        5.000000
25%       16.600000
50%       21.400000
75%       25.025000
max       50.000000
Name: medv, dtype: float64
Dari statistik ringkasan di atas, Anda tahu bahwa harga rata-rata rumah adalah 22 ribu, dengan harga minimum 5 ribu dan maksimum 50 ribu. Karena kerugian yang dilaporkan adalah kesalahan kuadrat rata-rata, kesalahan tipikal dalam satuan aslinya kira-kira akar kuadrat dari 32.16, yaitu sekitar 5.7 ribu dolar.
Langkah 6) Buatlah prediksinya
Terakhir, Anda dapat menggunakan metode estimasi TensorFlow predict untuk memperkirakan nilai enam rumah di Boston.
y = estimator.predict(
         input_fn=get_input_fn(prediction_set,
         num_epochs=1,
         n_batch = 128,
         shuffle=False))
Untuk mencetak nilai estimasi, Anda dapat menggunakan kode ini:
predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Keluaran
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.96125], dtype=float32), array([27.270979], dtype=float32), array([29.299236], dtype=float32), array([16.436684], dtype=float32), array([21.460876], dtype=float32)]
Model ini memprediksi nilai-nilai berikut:
| Rumah | Ramalan |
| 1 | 32.29 |
| 2 | 18.96 |
| 3 | 27.27 |
| 4 | 29.29 |
| 5 | 16.43 |
| 6 | 21.46 |
Perlu dicatat bahwa kita tidak mengetahui nilai sebenarnya dari keenam rumah ini. Dalam tutorial pembelajaran mendalam, Anda akan mencoba mengalahkan model linier.
Solusi NumPy
Bagian ini menjelaskan cara melatih model menggunakan estimator NumPy untuk memasukkan data. Metodenya sama, kecuali Anda akan menggunakan estimator numpy_input_fn.
Baca ketiga file CSV yang sama, tetapi hanya simpan array NumPy mentah dengan akhiran .values.
training_set_n = pd.read_csv("E:/boston_train.csv").values
test_set_n = pd.read_csv("E:/boston_test.csv").values
prediction_set_n = pd.read_csv("E:/boston_predict.csv").values
Langkah 1) Impor data
Pertama-tama, Anda perlu membedakan variabel fitur dari label. Anda perlu melakukan ini untuk data pelatihan dan data evaluasi. Akan lebih cepat jika Anda mendefinisikan fungsi untuk memisahkan data.
def prepare_data(df):
        X_train = df[:, :-3]
        y_train = df[:,-3]
        return X_train, y_train
Anda dapat menggunakan fungsi ini untuk memisahkan label dari fitur-fitur dataset pelatihan dan evaluasi.
X_train, y_train = prepare_data(training_set_n)
X_test, y_test = prepare_data(test_set_n)
Anda perlu mengecualikan kolom terakhir dari dataset prediksi karena kolom tersebut hanya berisi NaN.
x_predict = prediction_set_n[:, :-2]
Konfirmasikan bentuk array. Perhatikan bahwa label tidak boleh memiliki dimensi kedua, yang berarti (400,).
print(X_train.shape, y_train.shape, x_predict.shape)
Keluaran
(400, 9) (400,) (6, 9)
Anda dapat membuat kolom fitur sebagai berikut:
feature_columns = [ tf.feature_column.numeric_column('x', shape=X_train.shape[1:])]
Estimator didefinisikan seperti sebelumnya: Anda menentukan kolom fitur dan tempat menyimpan grafik.
estimator = tf.estimator.LinearRegressor(
         feature_columns=feature_columns,
         model_dir="train1")
Keluaran
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train1', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a218d8f28>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Anda dapat menggunakan estimator NumPy untuk memasukkan data ke dalam model dan kemudian melatih model tersebut. Perhatikan bahwa kami mendefinisikan fungsi input_fn terlebih dahulu untuk memudahkan pembacaan.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
           x={"x": X_train},
           y=y_train,
           batch_size=128,
           shuffle=False,
           num_epochs=None)
estimator.train(input_fn = train_input,steps=5000)
Keluaran
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train1/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 490.057
INFO:tensorflow:loss = 13909.656, step = 101 (0.206 sec)
INFO:tensorflow:global_step/sec: 788.986
INFO:tensorflow:loss = 12881.45, step = 201 (0.126 sec)
INFO:tensorflow:global_step/sec: 736.339
INFO:tensorflow:loss = 12391.541, step = 301 (0.136 sec)
INFO:tensorflow:global_step/sec: 383.305
INFO:tensorflow:loss = 12050.561, step = 401 (0.260 sec)
INFO:tensorflow:global_step/sec: 859.832
INFO:tensorflow:loss = 11766.133, step = 501 (0.117 sec)
INFO:tensorflow:global_step/sec: 804.394
INFO:tensorflow:loss = 11509.918, step = 601 (0.125 sec)
INFO:tensorflow:global_step/sec: 753.059
INFO:tensorflow:loss = 11272.891, step = 701 (0.134 sec)
INFO:tensorflow:global_step/sec: 402.165
INFO:tensorflow:loss = 11051.979, step = 801 (0.248 sec)
INFO:tensorflow:global_step/sec: 344.022
INFO:tensorflow:loss = 10845.854, step = 901 (0.288 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train1/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.985.
Out[23]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x1a1b6ea860>
Anda mengulangi langkah yang sama dengan fungsi input yang berbeda untuk mengevaluasi model Anda.
eval_input = tf.estimator.inputs.numpy_input_fn(
       x={"x": X_test},
       y=y_test,
       shuffle=False,
       batch_size=128,
       num_epochs=1)
   estimator.evaluate(eval_input,steps=None)
Keluaran
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.158947, global_step = 1000, loss = 3215.8945
Out[24]:
{'average_loss': 32.158947, 'global_step': 1000, 'loss': 3215.8945}
Terakhir, Anda dapat menghitung prediksinya. Hasilnya seharusnya mirip dengan hasil Pandas.
test_input = tf.estimator.inputs.numpy_input_fn(
        x={"x": x_predict},
        batch_size=128,
        num_epochs=1,
        shuffle=False)
        y = estimator.predict(test_input)

predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Keluaran
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.961248], dtype=float32), array([27.270979], dtype=float32), array([29.299242], dtype=float32), array([16.43668], dtype=float32), array([21.460878], dtype=float32)]
Solusi TensorFlow
Bagian terakhir dikhususkan untuk sesuatu yang murni. TensorFlow solusi. Metode ini sedikit lebih rumit daripada dua metode lainnya.
Perhatikan bahwa jika Anda menggunakan Jupyter buku catatanAnda perlu memulai ulang dan membersihkan kernel untuk menjalankan sesi ini.
TensorFlow telah membangun alat yang hebat untuk memasukkan data ke dalam pipeline. Di bagian ini, Anda akan membangun fungsi input_fn sendiri.
Langkah 1) Tentukan jalur dan format data
Pertama-tama, Anda mendeklarasikan dua variabel dengan jalur file CSV. Perhatikan bahwa Anda memiliki dua file, satu untuk set pelatihan dan satu untuk set pengujian.
import tensorflow as tf
df_train = "E:/boston_train.csv"
df_eval = "E:/boston_test.csv"
Kemudian, Anda perlu menentukan kolom-kolom yang ingin Anda gunakan dari file CSV. Kita akan menggunakan semuanya. Setelah itu, Anda perlu mendeklarasikan tipe setiap variabel.
Variabel float didefinisikan oleh [0.]
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
                "dis", "tax", "ptratio", "medv"]
RECORDS_ALL = [[0.0], [0.0], [0.0], [0.0],[0.0],[0.0],[0.0],[0.0],[0.0],[0.0]]
Langkah 2) Tentukan fungsi input_fn
Fungsi tersebut dapat dibagi menjadi tiga bagian:
- Impor data
- Buat iteratornya
- Konsumsi datanya
Berikut adalah kode keseluruhan untuk mendefinisikan fungsi tersebut. Kode tersebut akan dijelaskan selanjutnya.
def input_fn(data_file, batch_size, num_epoch = None):
       # Step 1
          def parse_csv(value):
          columns = tf.decode_csv(value, record_defaults= RECORDS_ALL)
          features = dict(zip(COLUMNS, columns))
          #labels = features.pop('median_house_value')
          labels =  features.pop('medv')
          return features, labels

          # Extract lines from input files using the Dataset API.
          dataset = (tf.data.TextLineDataset(data_file) # Read text file
          .skip(1) # Skip header row
          .map(parse_csv))

          dataset = dataset.repeat(num_epoch)
          dataset = dataset.batch(batch_size)
          # Step 3
          iterator = dataset.make_one_shot_iterator()
          features, labels = iterator.get_next()
          return features, labels
Impor data
Untuk file CSV, metode dataset membaca satu baris dalam satu waktu. Untuk membangun dataset, Anda perlu menggunakan objek tersebut. TextLineDataset. Dataset Anda memiliki header, jadi Anda perlu menggunakan skip(1) untuk melewati baris pertama. Pada titik ini, Anda hanya membaca data dan mengecualikan header dalam pipeline. Untuk memasukkan data ke model, Anda perlu memisahkan fitur dari label. Metode yang digunakan untuk menerapkan transformasi apa pun pada data adalah map.
Metode ini memanggil fungsi yang akan Anda buat untuk memberi instruksi tentang cara mentransformasi data. Singkatnya, Anda perlu memasukkan data ke dalam TextLineObjek dataset, kecualikan header, dan terapkan transformasi yang diinstruksikan oleh sebuah fungsi.
Code penjelasan
- tf.data.TextLineDataset(data_file): baris ini membaca file CSV
- .skip(1): melewati header
- .map(parse_csv)): mengurai data menjadi tensor
Anda perlu mendefinisikan sebuah fungsi untuk memberikan instruksi pada objek map. Anda dapat menamai fungsi ini parse_csv.
Fungsi ini mengurai file CSV dengan metode tf.decode_csv dan mendeklarasikan fitur serta labelnya. Fitur dapat dideklarasikan sebagai kamus (dictionary) atau tuple. Anda menggunakan metode kamus karena lebih praktis.
Code penjelasan
- tf.decode_csv(value, record_defaults= RECORDS_ALL): metode decode_csv menggunakan output dari TextLineDataset yang akan dibaca dari file CSV. `record_defaults` memberi tahu TensorFlow tentang tipe kolom. Di TensorFlow 2.x, simbol ini berada di `tf.io.decode_csv`.
- dict(zip(COLUMNS, columns)): mengisi kamus dengan semua kolom extracted selama pemrosesan data ini
- features.pop('medv'): mengecualikan variabel target dari variabel fitur dan membuat variabel label.
Dataset membutuhkan elemen tambahan untuk secara iteratif memasukkan tensor. Anda perlu menambahkan metode `repeat` agar dataset dapat terus memasukkan data ke model tanpa batas. Jika Anda tidak menambahkan metode ini, model hanya akan berulang satu kali dan kemudian akan menampilkan kesalahan karena tidak ada lagi data yang dimasukkan ke dalam pipeline.
Setelah itu, Anda dapat mengontrol ukuran batch dengan metode batch. Artinya, Anda memberi tahu dataset berapa banyak data yang ingin Anda masukkan ke dalam pipeline untuk setiap iterasi. Jika Anda menetapkan ukuran batch yang besar, model akan menjadi lambat.
Langkah 3) Buat iteratornya
Sekarang Anda siap untuk langkah kedua: buat iterator untuk mengembalikan elemen dalam kumpulan data.
Cara paling sederhana untuk membuat operator adalah dengan metode make_one_shot_iterator.
Setelah itu, Anda dapat membuat fitur dan label dari iterator.
Langkah 4) Konsumsi datanya
Anda dapat memeriksa apa yang terjadi dengan fungsi input_fn. Anda perlu memanggil fungsi tersebut dalam sebuah sesi untuk mengonsumsi data. Anda dapat mencoba dengan ukuran batch sama dengan 1.
Perhatikan bahwa fungsi ini mencetak fitur dalam bentuk kamus dan label sebagai array.
Kode ini akan menampilkan baris pertama dari file CSV. Anda dapat mencoba menjalankan kode ini berkali-kali dengan ukuran batch yang berbeda.
next_batch = input_fn(df_train, batch_size = 1, num_epoch = None)
with tf.Session() as sess:
     first_batch  = sess.run(next_batch)
     print(first_batch)
Keluaran
({'crim': array([2.3004], dtype=float32), 'zn': array([0.], dtype=float32), 'indus': array([19.58], dtype=float32), 'nox': array([0.605], dtype=float32), 'rm': array([6.319], dtype=float32), 'age': array([96.1], dtype=float32), 'dis': array([2.1], dtype=float32), 'tax': array([403.], dtype=float32), 'ptratio': array([14.7], dtype=float32)}, array([23.8], dtype=float32))
Langkah 5) Tentukan kolom fitur
Anda perlu mendefinisikan kolom numerik sebagai berikut:
X1= tf.feature_column.numeric_column('crim')
X2= tf.feature_column.numeric_column('zn')
X3= tf.feature_column.numeric_column('indus')
X4= tf.feature_column.numeric_column('nox')
X5= tf.feature_column.numeric_column('rm')
X6= tf.feature_column.numeric_column('age')
X7= tf.feature_column.numeric_column('dis')
X8= tf.feature_column.numeric_column('tax')
X9= tf.feature_column.numeric_column('ptratio')
Perhatikan bahwa Anda perlu menggabungkan semua variabel dalam satu wadah.
base_columns = [X1, X2, X3,X4, X5, X6,X7, X8, X9]
Langkah 6) Bangun model
Anda dapat melatih model dengan estimator LinearRegressor.
model = tf.estimator.LinearRegressor(feature_columns=base_columns, model_dir='train3')
Keluaran
INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_model_dir': 'train3', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1820a010f0>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Anda perlu menggunakan fungsi lambda untuk memungkinkan Anda menulis argumen untuk fungsi input_fn. Jika Anda tidak menggunakan fungsi lambda, Anda tidak dapat melatih model.
# Train the estimator
model.train(steps =1000,
          input_fn= lambda : input_fn(df_train,batch_size=128, num_epoch = None))
Keluaran
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train3/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 72.5646
INFO:tensorflow:loss = 13909.657, step = 101 (1.380 sec)
INFO:tensorflow:global_step/sec: 101.355
INFO:tensorflow:loss = 12881.449, step = 201 (0.986 sec)
INFO:tensorflow:global_step/sec: 109.293
INFO:tensorflow:loss = 12391.541, step = 301 (0.915 sec)
INFO:tensorflow:global_step/sec: 102.235
INFO:tensorflow:loss = 12050.5625, step = 401 (0.978 sec)
INFO:tensorflow:global_step/sec: 104.656
INFO:tensorflow:loss = 11766.134, step = 501 (0.956 sec)
INFO:tensorflow:global_step/sec: 106.697
INFO:tensorflow:loss = 11509.922, step = 601 (0.938 sec)
INFO:tensorflow:global_step/sec: 118.454
INFO:tensorflow:loss = 11272.889, step = 701 (0.844 sec)
INFO:tensorflow:global_step/sec: 114.947
INFO:tensorflow:loss = 11051.9795, step = 801 (0.870 sec)
INFO:tensorflow:global_step/sec: 111.484
INFO:tensorflow:loss = 10845.855, step = 901 (0.897 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train3/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Out[8]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x18225eb8d0>
Anda dapat mengevaluasi kesesuaian model Anda pada set pengujian dengan kode di bawah ini:
results = model.evaluate(steps =None,input_fn=lambda: input_fn(df_eval, batch_size =128, num_epoch = 1))
for key in results:
print("   {}, was: {}".format(key, results[key]))
Keluaran
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
   average_loss, was: 32.158958435058594
   loss, was: 3215.89599609375
   global_step, was: 1000
Langkah terakhir adalah memprediksi nilai target berdasarkan nilai matriks fitur. Anda dapat menulis kamus dengan nilai-nilai yang ingin Anda prediksi. Model Anda memiliki sembilan fitur, jadi Anda perlu memberikan nilai untuk masing-masing fitur. Model akan memberikan prediksi untuk setiap fitur tersebut.
Pada kode di bawah ini, Anda menuliskan nilai-nilai dari setiap fitur yang terdapat dalam file CSV df_predict.
Anda perlu menulis fungsi input_fn baru karena tidak ada label dalam dataset. Anda dapat menggunakan API from_tensors dari objek Dataset.
prediction_input = {
          'crim': [0.03359,5.09017,0.12650,0.05515,8.15174,0.24522],
          'zn': [75.0,0.0,25.0,33.0,0.0,0.0],
          'indus': [2.95,18.10,5.13,2.18,18.10,9.90],
          'nox': [0.428,0.713,0.453,0.472,0.700,0.544],
          'rm': [7.024,6.297,6.762,7.236,5.390,5.782],
          'age': [15.8,91.8,43.4,41.1,98.9,71.7],
          'dis': [5.4011,2.3682,7.9809,4.0220,1.7281,4.0317],
          'tax': [252,666,284,222,666,304],
          'ptratio': [18.3,20.2,19.7,18.4,20.2,18.4]
     }
     def test_input_fn():
     dataset = tf.data.Dataset.from_tensors(prediction_input)
     return dataset

     # Predict all our prediction_input
     pred_results = model.predict(input_fn=test_input_fn)
Terakhir, Anda mencetak prediksi tersebut.
for pred in enumerate(pred_results):
print(pred)
Keluaran
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
(0, {'predictions': array([32.297546], dtype=float32)})
(1, {'predictions': array([18.96125], dtype=float32)})
(2, {'predictions': array([27.270979], dtype=float32)})
(3, {'predictions': array([29.299236], dtype=float32)})
(4, {'predictions': array([16.436684], dtype=float32)})
(5, {'predictions': array([21.460876], dtype=float32)})

INFO:tensorflow:Calling model_fn. INFO:tensorflow:Done calling model_fn. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from train3/model.ckpt-5000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. (0, {'predictions': array([35.60663], dtype=float32)}) (1, {'predictions': array([22.298521], dtype=float32)}) (2, {'predictions': array([25.74533], dtype=float32)}) (3, {'predictions': array([35.126694], dtype=float32)}) (4, {'predictions': array([17.94416], dtype=float32)}) (5, {'predictions': array([22.606628], dtype=float32)})
Ketiga pipeline tersebut menghasilkan enam prediksi yang sama, yang menegaskan bahwa pilihan antara Pandas, NumPy, dan dataset TensorFlow asli adalah masalah kenyamanan, bukan akurasi.
