
Buat dan Masukkan INDEX Cassandra
 David Carter
⚡ Ringkasan Cerdas
Buat dan hapus indeks di Cassandra Memungkinkan pemfilteran pada kolom yang bukan bagian dari kunci utama. Halaman ini membahas perintah CREATE INDEX dan DROP INDEX, aturan penamaan, jenis indeks yang tersedia, dan kasus-kasus di mana indeks bukanlah solusi yang tepat.
Cassandra Buat Indeks
Perintah 'Buat indeks' membuat indeks pada kolom yang ditentukan oleh pengguna. Jika data untuk kolom yang ingin Anda indeks sudah ada, Cassandra membuat indeks pada data selama eksekusi pernyataan 'buat indeks'.
- Setelah membuat indeks, Cassandra mengindeks data baru secara otomatis ketika data dimasukkan.
- Indeks tidak dapat dibuat pada kunci utama karena kunci utama sudah diindeks.
- Indeks pada kolom koleksi didukung, menggunakan bentuk KEYS, VALUES, atau ENTRIES tergantung pada apa yang perlu dicari.
- Tanpa mengindeks pada kolom, Cassandra Kolom tersebut tidak dapat difilter kecuali jika merupakan kunci utama.
Itulah mengapa, untuk memfilter kolom di Cassandra, indeks perlu dibuat.
Sintaksis
CREATE INDEX IndexName ON KeyspaceName.TableName (ColumnName);
Example
Berikut adalah cuplikan saat mencoba memfilter kolom "dept" tanpa membuat indeks. Sebagai tanggapan, kesalahan dikembalikan.

Berikut adalah cuplikan dimana indeks dibuat pada kolom dept.

CREATE INDEX DeptIndex ON University.Student (dept);
Berikut adalah cuplikan di mana kolom 'dept' akan berhasil difilter.

SELECT * FROM University.Student WHERE dept = 'CS';
Nama indeks bersifat opsional. Dengan menghilangkannya, maka... Cassandra menghasilkan satu secara otomatis, yang penting ketika indeks tersebut nantinya harus dihapus.
CREATE INDEX IF NOT EXISTS ON University.Student (dept);
Cassandra Jatuhkan Indeks
Perintah 'Jatuhkan indeks' menjatuhkan indeks yang ditentukan. Jika nama indeks tidak diberikan pada saat pembuatan indeks, maka nama indeks adalah NamaTabel_NamaKolom_idx.
- Jika indeks tidak ada, ia akan mengembalikan kesalahan kecuali IF EXISTS digunakan yang akan mengembalikan no-op.
- Anda harus menentukan nama keyspace bersama dengan nama indeks, jika tidak, indeks akan dicari di keyspace saat ini.
Sintaksis
DROP INDEX IF EXISTS KeyspaceName.IndexName;
Example
Berikut adalah cuplikan dari perintah 'Jatuhkan indeks' yang dijalankan yang menghapus indeks DeptIndex.
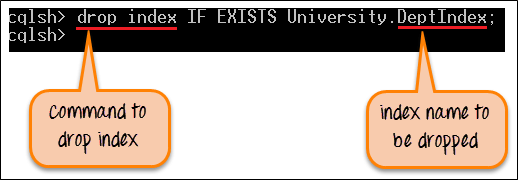
DROP INDEX IF EXISTS University.DeptIndex;
Setelah eksekusi perintah berhasil, DeptIndex akan dihapus dari keyspace. Sekarang data tidak dapat difilter berdasarkan departemen kolom.
Untuk memastikan indeks mana yang ada sebelum melakukan penghapusan.ping Pertama, jelaskan tabel tersebut dan baca definisi indeks di bagian bawah output.
DESCRIBE TABLE University.Student;
Jenis-jenis Indeks dalam Cassandra
Perintah di atas membuat indeks sekunder standar, tetapi terdapat tiga mekanisme berbeda yang berperilaku sangat berbeda.
| Tipe | Cara kerjanya | Terbaik untuk |
|---|---|---|
| Indeks sekunder | Setiap node hanya mengindeks data lokalnya sendiri, sehingga kueri tanpa kunci partisi harus menghubungi setiap node. | Kolom dengan kardinalitas sedang dikueri bersamaan dengan kunci partisi. |
| Indeks SASI | Indeks terlampir yang mendukung pencocokan awalan dan akhiran LIKE serta rentang numerik. | Pola pencarian teks. Masih berlabel eksperimental, jadi ujilah sebelum digunakan dalam produksi. |
| Indeks Terlampir Penyimpanan (SAI) | Diperkenalkan di Cassandra 5.0, berbagi satu struktur indeks di seluruh kolom dengan overhead penulisan yang lebih rendah. | Pengganti modern untuk kedua hal di atas adalah Cassandra 5 kelompok. |
Pengindeksan kolom koleksi menggunakan pengubah yang menyatakan bagian mana yang akan diindeks.
CREATE INDEX ON University.Teacher (VALUES(Email));
CREATE INDEX ON University.Course (KEYS(prereq));
CREATE INDEX ON University.Course (ENTRIES(prereq));
VALUES mencari elemen-elemen dalam sebuah set atau daftar, KEYS mencari kunci peta, dan ENTRIES mencocokkan pasangan kunci dan nilai. Pengindeksan koleksi dibahas lebih lanjut di bagian selanjutnya. Cassandra koleksi tutorial.
Kapan Sebaiknya Tidak Menggunakan Indeks dalam Cassandra
Indeks sekunder memang praktis, tetapi bukan indeks relasional, dan menggunakannya di tempat yang salah adalah penyebab umum lambatnya kinerja klaster. Empat situasi memerlukan pendekatan yang berbeda.
- Kardinalitas sangat tinggi. Mengindeks sesuatu yang hampir unik, seperti alamat email, berarti hampir setiap partisi menyimpan satu baris yang cocok, sehingga kueri menyebar ke seluruh klaster untuk mengembalikan satu catatan tunggal.
- Kardinalitas sangat rendah. Pengindeksan sebuah flag dengan dua nilai seperti aktif atau tidak aktif menghasilkan partisi indeks yang sangat besar, dan membaca salah satunya akan mengembalikan setengah dari tabel.
- Kolom yang diperbarui secara berkala. Setiap perubahan akan menulis entri indeks dan penanda (tombstone) untuk entri lama, sehingga penumpukan penanda akan menurunkan kualitas pembacaan seiring waktu.
- Kueri tanpa kunci partisi. Tanpa sistem tersebut, koordinator harus menghubungi setiap node dan menggabungkan hasilnya, yang tidak efisien seiring bertambahnya jumlah node.
Alternatif yang lebih tahan lama adalah tabel kedua yang dikunci berdasarkan kolom yang perlu dicari, yang dibuat bersamaan dengan tabel pertama. Hal ini mengikuti prinsip query-first yang dijelaskan dalam Cassandra aturan model data, dan sistem ini menyimpan setiap operasi baca ke satu partisi pada satu node.
Sebagai aturan umum, indeks cocok untuk kolom dengan kardinalitas sedang yang dikueri bersama dengan kunci partisi yang diketahui. Apa pun di luar deskripsi tersebut lebih baik ditangani oleh tabel yang dibuat khusus.
