
SAP HANNA ArchiPredmet: Pregled baze podataka
 Uredništvo
⚡ Pametni sažetak
SAP HANNA ArchiTektura, krajolik i dimenzioniranje čine temelj platforme za podatke u memoriji izgrađene na SUSE Linuxu i C++Ovaj članak objašnjava indeksni poslužitelj, mehanizme za pohranu, pohranu redaka i stupaca, delta spajanje i metode određivanja veličine hardvera.
Što je SAP HANA baza podataka?
SAP HANA je platforma za upravljanje podacima usmjerena na glavnu memoriju. Baza podataka radi na SUSE Linux Enterprise Serveru (SLES) i Red Hat Enterprise Linux (RHEL) i napisan je u C++Može se skalirati na više strojeva za vrlo velika opterećenja.
Ključne prednosti od SAP HANA:
- Iznimno brzo izvođenje upita jer se svi podaci učitavaju u memoriju, čime se uklanja spori I/O diskovni procesi s kritičnog puta.
- Kombinirani OLAP (Online analitička obrada) i OLTP (Online obrada transakcija) na istoj bazi podataka, pojednostavljujući podatkovni krajolik.
SAP HANA baza podataka izgrađena je od skupa mehanizama za obradu u memoriji. Mehanizam za izračun je glavni i komunicira s drugim mehanizmima kao što su relacijski mehanizam (pohrana redaka i stupaca), OLAP mehanizam, tekstualni mehanizam i mehanizam za obradu grafova. Relacija se nalazi ili u pohrani redaka ili u pohrani stupaca, a dodatni mehanizmi obrađuju tekstualne i grafičke podatke dok je memorija dostupna.
SAP HANNA Architektura
Podaci u stupčanoj pohrani komprimiraju se tehnikama kao što su kodiranje rječnika, kodiranje duljine niza, rijetko kodiranje, kodiranje klastera i neizravno kodiranje. Kada se dosegne ograničenje glavne memorije, objekti baze podataka koji se ne koriste (tablice, prikazi itd.) automatski se istovaruju na disk i ponovno učitavaju kada se ponovno zatraži.
Administratori također mogu ručno učitati ili istresti pojedinačnu tablicu klikom desne tipke miša na tablicu u SAP Studio HANA i odabir Istovariti or Opterećenje.
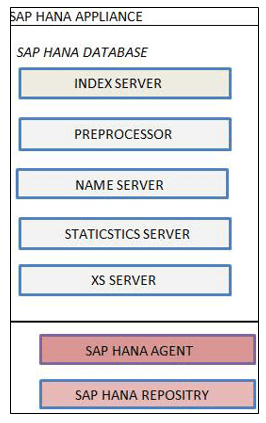
SAP HANA Server se sastoji od:
- Indeksni poslužitelj
- Poslužitelj pretprocesora
- Naziv poslužitelja
- Statistički poslužitelj
- XS motor
1. SAP HANA indeksni poslužitelj
Indeksni poslužitelj je glavni SAP Komponenta HANA baze podataka:
- To je srce SAP HANA mehanizam baze podataka.
- Sadrži stvarne pohrane podataka i motore koji obrađuju podatke.
- Izvršava dolazne SQL i MDX naredbe.
Arhitektura indeksnog poslužitelja prikazana je u nastavku.

SAP Pregled HANA indeksnog poslužitelja
- Upravitelj sesije i transakcija: Komponenta Sesija upravlja vezama i sesijama za bazu podataka. Upravitelj transakcija koordinira i kontrolira sve transakcije.
- SQL i MDX procesor: SQL procesor šalje upite odgovarajućem mehanizmu (SQL / SQL Script / R / Calc Engine). MDX procesor obrađuje višedimenzionalne upite (na primjer, prema analitičkom prikazu).
- SQL / SQL skripta / R / Calc Engine: Izvršava SQL, SQL skriptu, R i računske modele na podacima.
- spremište: Održava verzije za SAP HANA objekti metapodataka kao što su prikazi atributa, analitički prikazi i pohranjene procedure.
- Sloj perzistencije: Pruža ugrađenu mogućnost oporavka od katastrofe zapisivanjem točaka spremanja i zapisnika na volumen podataka na disku.
2. Poslužitelj predprocesora
Poslužitelj predprocesora koristi analiza teksta. On npr.tracts i priprema podatke iz tekstualnog sadržaja kada se pozove funkcija pretraživanja.
3. Poslužitelj imena
Poslužitelj imena sadrži informacije o cijelom sustavnom krajoliku. U distribuiranom raspoređivanju on tracks svaku pokrenutu komponentu i lokaciju podataka na čvorovima, tako da se upiti mogu usmjeriti na ispravan poslužitelj.
4. Statistički poslužitelj
Statistički poslužitelj prikuplja podatke o statusu, raspodjeli resursa, potrošnji i performansama za SAP HANA sustav. Napomena: u HANA SPS 7 i novijim verzijama, ugrađena statistička usluga izvodi se unutar indeksnog poslužitelja, a ne kao samostalni proces.
5. XS poslužitelj
XS Server hostira XS Engine, koji omogućuje vanjskim aplikacijama i programerima korištenje SAP HANA baza podataka putem HTTP-a. Sam XS Engine djeluje kao lagani HTTP poslužitelj, omogućujući klijentima temeljenim na pregledniku i REST klijentima izravnu komunikaciju s HANA-om.
SAP HANA Pejzaž
"HANA" je kratica za Analitički uređaj visokih performansi i isporučuje se kao kombinirana hardverska i softverska platforma.
- Moderni hardver nudi daleko više CPU jezgri, RAM-a i propusnosti za pohranu nego što su bili dizajnirani za korištenje stariji poslužitelji baza podataka.
- SAP HANA to iskorištava tako što keeping svi radni podaci u glavnoj memoriji, uklanjajući usko grlo diskovnog I/O sustava koje ograničava tradicionalne baze podataka.
Donji dijagram sažima SAP HANA hardverske i softverske inovacije.

SAP HANA podržava dva relacijska skladišta podataka: Red trgovina i Trgovina stupaca.
Red trgovina
Row Store se ponaša kao tradicionalna baza podataka (Oracle, SQL Server). Ključna razlika je u tome što se svi retci nalaze u glavnoj memoriji u SAP HANA, dok ih tradicionalna baza podataka prvenstveno drži na disku.
Trgovina stupaca
Column Store pohranjuje podatke u stupčastom obliku u memoriji. Ovdje se pohranjuju tablice stupaca, a mehanizam uravnotežuje dobre performanse pisanja s optimiziranim performansama čitanja. Donji dijagram prikazuje dvije strukture koje postižu tu ravnotežu.

Glavna pohrana
Glavna pohrana sadrži većinu podataka. Metode kompresije poput rječničkog kodiranja, klaster kodiranja, rijetkog kodiranja i kodiranja duljine niza primjenjuju se za uštedu memorije i ubrzanje pretraživanja.
- Izravno mijenjanje komprimiranih podataka u glavnoj memoriji je skupo, pa pisanje ne cilja glavnu memoriju.
- Umjesto toga, svaka promjena se zapisuje u zasebno područje koje se zove Delta ČuvanjeČitanja mogu doći do glavne ili delta memorije.
Podaci se mogu ručno učitati ili istovariti pomoću Učitaj u memoriju i Isprazni iz memorije opcije prikazane u nastavku.

Delta Čuvanje
Delta Pohrana je optimizirana za pisanje i koristi lakšu kompresiju. Sve nepotvrđene promjene u tablici stupaca čuvaju se ovdje. Kada je promjene potrebno spojiti natrag u glavnu pohranu, pokrenite Delta Spojiti operacija iz SAP Studio HANA.

- Delta spajanje premješta promjene prikupljene u delta pohrani u glavnu pohranu.
- Nakon spajanja, novi sadržaj glavne pohrane pohranjuje se na disk i kompresija se ponovno izračunava.
Kako se podaci kreću iz Delta u glavnu pohranu

Međuspremnik organiziran po redovima nazvan L1-Delta nalazi se ispred svake tablice stupaca, zbog čega tablica stupaca može apsorbirati zapise visokog protoka.
- Korisnik pokreće naredbu UPDATE ili INSERT na tablici.
- Podaci prvo stižu u L1-Delta (nepovezani podaci).
- Nakon potvrde, podaci se premještaju u stupčasto orijentirani L2-Delta tampon.
- Kada L2-Delta je pun ili se spajanje izvršava, podaci se zapisuju u glavnu memoriju.
Pohrana u stupcima je stoga optimizirana i za pisanje (kroz L1 i L2 deltu) i za čitanje (kroz glavnu pohranu). Nakon obrade, sloj perzistencije pohranjuje podatke na disk.
Primjer tablice temeljene na redovima:

Ista logička tablica pohranjuje se na disk različito ovisno o vrsti pohrane. U pohrani redova, retci se zapisuju susjedno:

U Column Storeu, vrijednosti iz istog stupca pohranjuju se zajedno:

Budući da vrijednosti stupaca dijele tip podataka i često se ponavljaju, raspored stupaca se izuzetno dobro komprimira - što je glavna memorijska prednost pohrane stupaca.

SAP HANA Određivanje veličine
Dimenzioniranje je proces određivanja hardverskih resursa - RAM-a, diska i CPU-a - potrebnih za SAP HANA sustav. Memorija je najvažniji faktor, CPU je drugi, a disk je izveden iz prva dva.
U SAP Implementacija HANA-e, odabir prave veličine poslužitelja za poslovno opterećenje jedan je od najvažnijih zadataka. U usporedbi s tradicionalnim DBMS-om, dimenzioniranje HANA-e razlikuje se u tri područja:
- Glavna memorija: vođen metapodacima plus količinom transakcijskih i analitičkih podataka pohranjenih u memoriji.
- CPU: procijenjeno, a ne izmjereno, na temelju upita o prognozi i obrazaca opterećenja.
- Disk: dimenzionirano za trajnost podataka i količine zapisnika, a ne za podatke online upita.
CPU i memorija aplikacijskog poslužitelja ostaju nepromijenjeni u usporedbi s prethodnom bazom podataka, jer HANA zamjenjuje samo sloj baze podataka.
SAP nudi nekoliko metoda za izračun ispravne veličine:
- Određivanje veličine pomoću ABAP izvješća (kod transakcije) ST03 podaci i izvješće /SDF/HDB_SIZING).
- Određivanje veličine pomoću skripte baze podataka za sustave koji nisu ABAP.
- Određivanje veličine pomoću SAP Brzi mjerač alat na SAP Tržnica usluga.
Kada se koristi alat Quick Sizer, zahtjev se prikazuje u donjem formatu.

