
Vodič za linearnu regresiju s TensorFlowom [Primjeri]
 Evelyn Clarke
⚡ Pametni sažetak
Linearna regresija u TensorFlowu modelira odnos između numeričkih značajki i kontinuirane ciljne vrijednosti. Ovaj vodič obučava prediktor cijena nekretnina u Bostonu na tri odvojena načina, koristeći Pandas, NumPy i izvorne ulazne cjevovode TensorFlowa s estimatorom LinearRegressor.
Što je linearna regresija?
Linearna regresija je pristup u statistici za modeliranje odnosa između dvije varijable. Ovo modeliranje se provodi između skalarnog odgovora i jedne ili više objašnjavajućih varijabli. Odnos s jednom objašnjavajućom varijablom naziva se jednostavna linearna regresija, a s više od jedne objašnjavajuće varijable naziva se višestruka linearna regresija.
TensorFlow pruža alate za potpunu kontrolu nad izračunima. To se radi pomoću API-ja niske razine. Povrh toga, TensorFlow je opremljen velikim nizom API-ja za izvođenje mnogih stroj za učenje algoritmi. Ovo je API visoke razine, a TensorFlow ih naziva estimatorima.
- API niske razineIzgraditi arhitekturu i optimizaciju modela od nule. To je komplicirano za početnike.
- API visoke razineDefinirajte algoritam. Jednostavan je za korištenje. TensorFlow pruža alatni okvir pod nazivom koji vrši procjenu konstruirati, obučiti, procijeniti i napraviti predviđanje.
U ovom ćete vodiču koristiti samo procjeniteljiIzračuni su brži i lakši za implementaciju. Prvi dio objašnjava kako koristiti optimizator gradijentnog spusta za treniranje linearne regresije u TensorFlowu. U drugom dijelu, koristit ćete skup podataka Boston za predviđanje cijene kuće pomoću TensorFlow estimatora.
Kako trenirati model linearne regresije
Prije nego što počnemo s treniranjem modela, pogledajmo što je zapravo linearna regresija.
Zamislite da imate dvije varijable, x i y, i vaš je zadatak predvidjeti vrijednost y znajući vrijednost x. Ako prikažete podatke, možete vidjeti pozitivan odnos između vaše nezavisne varijable, x, i vaše zavisne varijable, y, kao što pokazuje dijagram raspršenja u nastavku.

Možete primijetiti da ako je x=1, y će otprilike biti jednako 6, a ako je x=2, y će biti oko 8.5.
Ovo nije baš točna metoda i sklona je pogreškama, posebno kod skupa podataka koji sadrži stotine tisuća točaka.
Linearna regresija se procjenjuje jednadžbom. Varijabla y objašnjena je jednom ili više kovarijabli. U vašem primjeru postoji samo jedna zavisna varijabla. Ako morate napisati ovu jednadžbu, ona će biti:

S:
 je pristranost. To jest, ako je x=0, y=
 je težina povezana s x
 je rezidual ili pogreška modela. Uključuje ono što model ne može naučiti iz podataka
Zamislite da odgovarate modelu i da pronađete sljedeće rješenje za:
- = 3.8
- = 2.78
Možete zamijeniti te brojeve u jednadžbi i ona postaje:
y= 3.8 + 2.78x
Sada imate bolji način za pronalaženje vrijednosti za y. To jest, možete zamijeniti x bilo kojom vrijednošću koju želite kako biste predvidjeli y. Na slici ispod, zamijenili smo x u jednadžbi sa svim vrijednostima u skupu podataka i prikazali rezultat.

Crvena linija predstavlja prilagođenu vrijednost, odnosno vrijednosti y za svaku vrijednost x. Ne morate vidjeti vrijednost x da biste predvidjeli y; za svaki x postoji vrijednost koja pripada crvenoj liniji. Također možete predvidjeti za vrijednosti x veće od 2.
Ako želite proširiti linearnu regresiju na više kovarijanti, to možete učiniti dodavanjem više varijabli u model. Razlika između tradicionalne analize i linearne regresije je u tome što linearna regresija promatra kako će y reagirati za svaku varijablu x uzetu neovisno.
Pogledajmo primjer. Zamislite da želite predvidjeti prodaju slastičarnice. Skup podataka sadrži različite informacije poput vremena (kišovito, sunčano, oblačno) i informacije o kupcima (plaća, spol, bračni status).
Tradicionalna analiza pokušat će predvidjeti prodaju, recimo, izračunavanjem prosjeka za svaku varijablu i pokušajem procjene prodaje za različite scenarije. To će dovesti do loših predviđanja i ograničiti analizu na odabrani scenarij.
Ako koristite linearnu regresiju, možete napisati ovu jednadžbu:
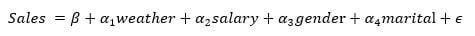
Algoritam će pronaći najbolje rješenje za težine; to znači da će pokušati minimizirati trošak, koji je razlika između prilagođene linije i podatkovnih točaka.
Kako algoritam radi
Donji dijagram sažima petlju koju algoritam ponavlja: odabir težina, predviđanje y, mjerenje pogreške i ispravljanje težina.

Algoritam će izabrati slučajni broj za svaki  i
 i zamijenite vrijednost x da dobijete predviđenu vrijednost y. Ako skup podataka ima 100 opažanja, algoritam izračunava 100 predviđenih vrijednosti.
Možemo izračunati pogrešku, primijećeno  , modela, što je razlika između predviđene vrijednosti i stvarne vrijednosti. Pozitivna pogreška znači da model podcjenjuje predviđanje y, a negativna pogreška znači da model precjenjuje predviđanje y.

Vaš je cilj minimizirati kvadrat pogreške. Algoritam izračunava srednju vrijednost kvadratne pogreške. Ovaj se korak naziva minimizacija pogreške. Za linearnu regresiju, ovo je Srednja kvadratna pogreška, koji se naziva i MSE. Matematički, to je:

Gdje:
 su utezi, dakle
 odnosi se na predviđenu vrijednost
- y je stvarna vrijednost
- m je broj opažanja
 odnosi se na predviđenu vrijednost
Imajte na umu da  znači da koristi transponiranje matrica. The
 je matematički zapis srednje vrijednosti.
Cilj je pronaći najbolje  što minimizira MSE.
Ako je prosječna pogreška velika, to znači da model radi loše i da težine nisu ispravno odabrane. Da biste ispravili težine, morate koristiti optimizator. Tradicionalni optimizator se zove Gradijentni silazak.
Gradijentni spust uzima derivaciju i smanjuje ili povećava težinu. Ako je derivacija pozitivna, težina se smanjuje. Ako je derivacija negativna, težina se povećava. Model će ažurirati težine i ponovno izračunati pogrešku. Ovaj se postupak ponavlja sve dok se pogreška više ne mijenja. Svaki prolaz naziva se ponavljanjeOsim toga, gradijenti se množe stopom učenja, što pokazuje brzinu učenja.
Ako je stopa učenja premala, algoritmu će trebati jako puno vremena da konvergira jer zahtijeva mnogo više iteracija. Ako je stopa učenja previsoka, algoritam možda nikada neće konvergirati. Krivulja gubitaka u nastavku prikazuje pogrešku u odnosu na broj iteracija za ovaj skup podataka.

Na gornjoj slici možete vidjeti da model ponavlja postupak oko 20 puta prije nego što pronađe stabilnu vrijednost za težine, čime postiže najmanju pogrešku.
Imajte na umu da pogreška nije jednaka nuli, već se stabilizira oko 5. To znači da model pravi tipičnu pogrešku od 5. Ako želite smanjiti pogrešku, morate dodati više informacija modelu, kao što su više varijabli ili koristiti različite estimatore.
Sjećate se prve jednadžbe:

Konačne težine su 3.8 i 2.78. Videozapis u nastavku pokazuje kako gradijentni spust optimizira funkciju gubitka kako bi pronašao te težine.
Kako trenirati linearnu regresiju s TensorFlowom
Sada kada bolje razumijete što se događa iza haube, spremni ste koristiti API za procjenu koji nudi TensorFlow za treniranje vaše prve linearne regresije pomoću TensorFlowa.
Napomena o verziji: Prikazani tijek rada estimatora napisan je za TensorFlow 1.x i rana izdanja 2.x. TensorFlow je označio tf.estimator i tf.feature_column API-ji su potpuno zastarjeli u verziji 2.12, a procjenitelji su ukinuti u verziji 2.16. Na trenutnoj instalaciji pokrenite ovaj kod unutar TensorFlow 1.15 ili 2.x-s-tf.compat.v1 okruženje ili ga prenijeti na Keras, gdje tf.keras.layers.Dense(1) plus slojevi predobrade zamjenjuju LinearRegressor i stupce značajki. Koncepti - značajke, oznake, serije, epohe, MSE i gradijentni spust - prenose se nepromijenjeni.
Koristit ćete Bostonski skup podataka koji uključuje sljedeće varijable.
| Varijabla | Description |
| zločinački | stopa kriminala po glavi stanovnika po gradu |
| zn | udio stambenog zemljišta podijeljenog na parcele veće od 25,000 sq.ft. |
| industrijski | udio ne-maloprodajnih poslovnih hektara po gradu. |
| NOx | koncentracija dušikovih oksida |
| rm | prosječan broj soba po stanu |
| starost | udio jedinica u kojima stanuju vlasnici izgrađenih prije 1940 |
| reći | mjerene udaljenosti do pet bostonskih centara za zapošljavanje |
| porez | stopa poreza na imovinu pune vrijednosti za 10,000 dolara |
| ptratio | omjer učenika i nastavnika po gradovima |
| medv | Srednja vrijednost domova u kojima žive vlasnici u tisućama dolara |
Stvorit ćete tri različita skupa podataka:
| skup podataka | cilj | oblikovati |
| Trening | Uvježbajte model i nabavite utege | 400, 10 |
| Procjena | Procijenite izvedbu modela na nevidljivim podacima | 100, 10 |
| Predvidjeti | Koristite model za predviđanje vrijednosti kuće na novim podacima | 6, 10 |
Cilj je koristiti značajke skupa podataka za predviđanje vrijednosti kuće.
Tijekom drugog dijela tutorijala naučit ćete kako koristiti TensorFlow s tri različita načina uvoza podataka:
- S Pandama
- Kontakt numpy
- Samo TensorFlow
Imajte na umu da sve tri opcije daju iste rezultate.
Naučit ćete kako koristiti API visoke razine za izgradnju, treniranje i evaluaciju TensorFlow linearnog regresijskog modela. Ako biste koristili API niske razine, morali biste ručno definirati:
- Funkcija gubitka
- Optimizator: gradijentni spust
- Množenje matrica
- Graf i tenzor
Ovo je zamorno i kompliciranije za početnika.
Pandas rješenje
Morate uvesti potrebne biblioteke za obuku modela.
import pandas as pd
from sklearn import datasets
import tensorflow as tf
import itertools
Korak 1) Uvezite podatke s pande.
Nazive stupaca definirate i pohranjujete u COLUMNS. Za uvoz podataka možete koristiti pd.read_csv().
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
           "dis", "tax", "ptratio", "medv"]
Usmjerite svaki poziv na CSV datoteke koje ste ranije preuzeli.
training_set = pd.read_csv("E:/boston_train.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
test_set = pd.read_csv("E:/boston_test.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
prediction_set = pd.read_csv("E:/boston_predict.csv", skipinitialspace=True,skiprows=1, names=COLUMNS)
Možete ispisati oblik podataka.
print(training_set.shape, test_set.shape, prediction_set.shape)
Izlaz
(400, 10) (100, 10) (6, 10)
Imajte na umu da je oznaka, odnosno vaš y, uključena u skup podataka. Stoga morate definirati dva druga popisa: jedan koji sadrži samo značajke i jedan samo s nazivom oznake. Ova dva popisa će vašem procjenitelju reći koja su značajke u skupu podataka i koji je naziv stupca oznaka.
To se radi s donjim kodom.
FEATURES = ["crim", "zn", "indus", "nox", "rm",
                 "age", "dis", "tax", "ptratio"]
LABEL = "medv"
Korak 2) Pretvorite podatke
Numeričke varijable trebate pretvoriti u odgovarajući format. TensorFlow pruža metodu za pretvaranje kontinuirane varijable: tf.feature_column.numeric_column().
U prethodnom koraku definirali ste popis značajki koje želite uključiti u model. Sada možete koristiti ovaj popis za njihovo pretvaranje u numeričke podatke. Ako želite isključiti značajke iz svog modela, slobodno izostavite jednu ili više varijabli s popisa FEATURES prije nego što konstruirate feature_cols.
Imajte na umu da ćete koristiti Python Razumijevanje popisa s popisom FEATURES za stvaranje novog popisa pod nazivom feature_cols. To vam pomaže da izbjegnete pisanje tf.feature_column.numeric_column() devet puta. Razumijevanje popisa je brži i čišći način stvaranja novih popisa.
feature_cols = [tf.feature_column.numeric_column(k) for k in FEATURES]
Korak 3) Definirajte procjenitelj
U ovom koraku morate definirati estimator. TensorFlow nudi šest unaprijed izgrađenih estimatora, tri za zadatke klasifikacije i tri za TensorFlow regresijske zadatke:
- Regresor
- DNNRegressor
- Linearni regresor
- DNNLinearni kombinirani regresor
- razvrstati
- DNNClassifikator
- Linearni klasifikator
- DNNLinearni kombinirani klasifikator
U ovom vodiču koristit ćete linearni regresor. Za pristup ovoj funkciji morate koristiti tf.estimator.
Funkcija treba dva argumenta:
- feature_columns: sadrži varijable koje treba uključiti u model
- model_dir: put za pohranu grafa, spremanje parametara modela i tako dalje
TensorFlow će automatski stvoriti mapu pod nazivom train u vašem radnom direktoriju. Za pristup morate koristiti ovu putanju TensorBoard, kao što je prikazano u primjeru regresije TensorFlow u nastavku.
estimator = tf.estimator.LinearRegressor(
        feature_columns=feature_cols,
        model_dir="train")
Izlaz
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a215dc550>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Najteži dio s TensorFlowom je način hranjenja modela. TensorFlow je dizajniran za rad s paralelnim računanjem i vrlo velikim skupovima podataka. Zbog ograničenja strojnih resursa, nemoguće je odjednom opskrbiti model svim podacima. Za to je potrebno svaki put unijeti seriju podataka. Imajte na umu da govorimo o ogromnim skupovima podataka s milijunima ili više zapisa. Ako ne dodate seriju, završit ćete s memorijskom pogreškom.
Na primjer, ako vaši podaci sadrže 100 opažanja i definirate veličinu serije od 10, to znači da će model vidjeti 10 opažanja za svaku iteraciju (10*10).
Kada model pregleda sve podatke, završava jednu epohu. Epoha definira koliko puta želite da model pregleda podatke. Bolje je postaviti ovaj korak na "nijedan" i pustiti model da izvrši određeni broj iteracija.
Druga informacija koju treba dodati je želite li promiješati podatke prije svake iteracije. Tijekom obuke važno je promiješati podatke kako model ne bi naučio određeni uzorak skupa podataka. Ako model nauči detalje temeljnog uzorka podataka, imat će poteškoća s generalizacijom predviđanja za nevidljive podatke. To se naziva prekomjerno prilagođavanje. Model dobro radi na podacima za obuku, ali ne može ispravno predvidjeti za nevidljive podatke.
TensorFlow olakšava ova dva koraka. Kada podaci stignu u cjevovod, zna koliko opažanja treba (serijski) i treba li podatke premjestiti.
Da biste uputili TensorFlow kako da unosi podatke u model, možete koristiti pandas_input_fn. Ovaj objekt treba pet parametara:
- x: podaci o značajkama
- y: podaci oznake
- veličina_serije: serija. Prema zadanim postavkama 128
- num_epoch: broj epoha, prema zadanim postavkama 1
- miješanje: miješanje podataka ili ne. Prema zadanim postavkama, Nema
Modelu morate unositi podatke mnogo puta, stoga definirate funkciju za ponavljanje ovog procesa. Nazovite tu funkciju get_input_fn.
def get_input_fn(data_set, num_epochs=None, n_batch = 128, shuffle=True):
         return tf.estimator.inputs.pandas_input_fn(
         x=pd.DataFrame({k: data_set[k].values for k in FEATURES}),
         y = pd.Series(data_set[LABEL].values),
         batch_size=n_batch,
         num_epochs=num_epochs,
         shuffle=shuffle)
Uobičajena metoda za procjenu izvedbe modela je:
- Uvježbajte model
- Procijenite model na drugom skupu podataka
- Napravite predviđanje
TensorFlow estimator nudi tri različite funkcije za jednostavno izvršavanje ova tri koraka.
Korak 4) Uvježbajte model
Možete koristiti metodu estimator train za prilagođavanje modela. Estimator vlaka treba input_fn i određeni broj koraka. Možete koristiti funkciju koju ste gore kreirali za hranjenje modela. Zatim dajete upute modelu da iterira 1000 puta. Imajte na umu da ne određujete broj epoha; dopuštate modelu da iterira 1000 puta. Ako postavite broj epoha na 1, model će iterirati četiri puta, jer u skupu za učenje postoji 400 zapisa, a veličina serije je 128:
- 128 reda
- 128 reda
- 128 reda
- 16 reda
Stoga je lakše postaviti broj epoha na nijednu i definirati broj iteracija, kao što je prikazano u primjeru klasifikacije TensorFlow u nastavku.
estimator.train(input_fn=get_input_fn(training_set,
                                           num_epochs=None,
                                           n_batch = 128,
                                           shuffle=False),
                                           steps=1000)
Izlaz
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 238.616
INFO:tensorflow:loss = 13909.657, step = 101 (0.420 sec)
INFO:tensorflow:global_step/sec: 314.293
INFO:tensorflow:loss = 12881.449, step = 201 (0.320 sec)
INFO:tensorflow:global_step/sec: 303.863
INFO:tensorflow:loss = 12391.541, step = 301 (0.327 sec)
INFO:tensorflow:global_step/sec: 308.782
INFO:tensorflow:loss = 12050.5625, step = 401 (0.326 sec)
INFO:tensorflow:global_step/sec: 244.969
INFO:tensorflow:loss = 11766.134, step = 501 (0.407 sec)
INFO:tensorflow:global_step/sec: 155.966
INFO:tensorflow:loss = 11509.922, step = 601 (0.641 sec)
INFO:tensorflow:global_step/sec: 263.256
INFO:tensorflow:loss = 11272.889, step = 701 (0.379 sec)
INFO:tensorflow:global_step/sec: 254.112
INFO:tensorflow:loss = 11051.9795, step = 801 (0.396 sec)
INFO:tensorflow:global_step/sec: 292.405
INFO:tensorflow:loss = 10845.855, step = 901 (0.341 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
TensorBoard možete provjeriti sljedećom naredbom:
activate hello-tf
# For MacOS
tensorboard --logdir=./train
# For Windows
tensorboard --logdir=train
Korak 5) Ocijenite svoj model
Možete procijeniti odgovara li vaš model na testnom setu pomoću donjeg koda:
ev = estimator.evaluate(
          input_fn=get_input_fn(test_set,
          num_epochs=1,
          n_batch = 128,
          shuffle=False))
Izlaz
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:43:13
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
Gubitak možete ispisati pomoću donjeg koda:
loss_score = ev["loss"]
print("Loss: {0:f}".format(loss_score))
Izlaz
Loss: 3215.895996
Model ima gubitak od 3215. Možete provjeriti sažetak statistike kako biste dobili ideju o tome koliko je velika pogreška.
training_set['medv'].describe()
Izlaz
count    400.000000
mean      22.625500
std        9.572593
min        5.000000
25%       16.600000
50%       21.400000
75%       25.025000
max       50.000000
Name: medv, dtype: float64
Iz gornje sažete statistike znate da je prosječna cijena kuće 22 tisuće, s minimalnom cijenom od 5 tisuća i maksimalnom od 50 tisuća. Budući da je prijavljeni gubitak srednja kvadratna pogreška, tipična pogreška u izvornim jedinicama je otprilike kvadratni korijen od 32.16, što je oko 5.7 tisuća dolara.
Korak 6) Napravite predviđanje
Konačno, možete koristiti metodu predviđanja TensorFlow za procjenu vrijednosti šest kuća u Bostonu.
y = estimator.predict(
         input_fn=get_input_fn(prediction_set,
         num_epochs=1,
         n_batch = 128,
         shuffle=False))
Za ispis procijenjenih vrijednosti možete koristiti ovaj kod:
predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Izlaz
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.96125], dtype=float32), array([27.270979], dtype=float32), array([29.299236], dtype=float32), array([16.436684], dtype=float32), array([21.460876], dtype=float32)]
Model predviđa sljedeće vrijednosti:
| Kuća | Proricanje |
| 1 | 32.29 |
| 2 | 18.96 |
| 3 | 27.27 |
| 4 | 29.29 |
| 5 | 16.43 |
| 6 | 21.46 |
Imajte na umu da ne znamo pravu vrijednost ovih šest kuća. U tutorijalu za duboko učenje pokušat ćete pobijediti linearni model.
NumPy rješenje
Ovaj odjeljak objašnjava kako trenirati model koristeći NumPy estimator za unos podataka. Metoda je ista, osim što ćete koristiti estimator numpy_input_fn.
Pročitajte iste tri CSV datoteke, ali zadržite samo sirove NumPy nizove s .values.
training_set_n = pd.read_csv("E:/boston_train.csv").values
test_set_n = pd.read_csv("E:/boston_test.csv").values
prediction_set_n = pd.read_csv("E:/boston_predict.csv").values
Korak 1) Uvezite podatke
Prije svega, morate razlikovati varijable značajki od oznake. To morate učiniti za podatke za učenje i podatke za evaluaciju. Brže je definirati funkciju za dijeljenje podataka.
def prepare_data(df):
        X_train = df[:, :-3]
        y_train = df[:,-3]
        return X_train, y_train
Funkciju možete koristiti za odvajanje oznake od značajki vlaka i procjenu skupova podataka.
X_train, y_train = prepare_data(training_set_n)
X_test, y_test = prepare_data(test_set_n)
Morate isključiti zadnji stupac skupa podataka za predviđanje jer sadrži samo NaN.
x_predict = prediction_set_n[:, :-2]
Potvrdite oblik polja. Imajte na umu da oznaka ne smije imati drugu dimenziju, što znači (400,).
print(X_train.shape, y_train.shape, x_predict.shape)
Izlaz
(400, 9) (400,) (6, 9)
Stupce značajki možete konstruirati na sljedeći način:
feature_columns = [ tf.feature_column.numeric_column('x', shape=X_train.shape[1:])]
Procjenitelj je definiran kao i prije: određujete stupce značajki i gdje spremiti graf.
estimator = tf.estimator.LinearRegressor(
         feature_columns=feature_columns,
         model_dir="train1")
Izlaz
INFO:tensorflow:Using default config.
INFO:tensorflow:Using config: {'_model_dir': 'train1', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1a218d8f28>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Možete koristiti NumPy estimator za unos podataka u model, a zatim za treniranje modela. Imajte na umu da smo unaprijed definirali funkciju input_fn radi lakše čitljivosti.
# Train the estimator
train_input = tf.estimator.inputs.numpy_input_fn(
           x={"x": X_train},
           y=y_train,
           batch_size=128,
           shuffle=False,
           num_epochs=None)
estimator.train(input_fn = train_input,steps=5000)
Izlaz
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train1/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 490.057
INFO:tensorflow:loss = 13909.656, step = 101 (0.206 sec)
INFO:tensorflow:global_step/sec: 788.986
INFO:tensorflow:loss = 12881.45, step = 201 (0.126 sec)
INFO:tensorflow:global_step/sec: 736.339
INFO:tensorflow:loss = 12391.541, step = 301 (0.136 sec)
INFO:tensorflow:global_step/sec: 383.305
INFO:tensorflow:loss = 12050.561, step = 401 (0.260 sec)
INFO:tensorflow:global_step/sec: 859.832
INFO:tensorflow:loss = 11766.133, step = 501 (0.117 sec)
INFO:tensorflow:global_step/sec: 804.394
INFO:tensorflow:loss = 11509.918, step = 601 (0.125 sec)
INFO:tensorflow:global_step/sec: 753.059
INFO:tensorflow:loss = 11272.891, step = 701 (0.134 sec)
INFO:tensorflow:global_step/sec: 402.165
INFO:tensorflow:loss = 11051.979, step = 801 (0.248 sec)
INFO:tensorflow:global_step/sec: 344.022
INFO:tensorflow:loss = 10845.854, step = 901 (0.288 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train1/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.985.
Out[23]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x1a1b6ea860>
Isti korak ponavljate s drugom ulaznom funkcijom kako biste procijenili svoj model.
eval_input = tf.estimator.inputs.numpy_input_fn(
       x={"x": X_test},
       y=y_test,
       shuffle=False,
       batch_size=128,
       num_epochs=1)
   estimator.evaluate(eval_input,steps=None)
Izlaz
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-01:44:00
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.158947, global_step = 1000, loss = 3215.8945
Out[24]:
{'average_loss': 32.158947, 'global_step': 1000, 'loss': 3215.8945}
Konačno, možete izračunati predviđanje. Trebalo bi biti slično rezultatu Pandasa.
test_input = tf.estimator.inputs.numpy_input_fn(
        x={"x": x_predict},
        batch_size=128,
        num_epochs=1,
        shuffle=False)
        y = estimator.predict(test_input)

predictions = list(p["predictions"] for p in itertools.islice(y, 6))
print("Predictions: {}".format(str(predictions)))
Izlaz
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train1/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
Predictions: [array([32.297546], dtype=float32), array([18.961248], dtype=float32), array([27.270979], dtype=float32), array([29.299242], dtype=float32), array([16.43668], dtype=float32), array([21.460878], dtype=float32)]
TensorFlow rješenje
Posljednji dio posvećen je čistom TensorFlow rješenje. Ova metoda je nešto složenija od druge dvije.
Imajte na umu da ako koristite Jupyter bilježnica, morate ponovno pokrenuti i očistiti kernel da biste pokrenuli ovu sesiju.
TensorFlow je izgradio izvrstan alat za prosljeđivanje podataka u cjevovod. U ovom odjeljku sami ćete izgraditi funkciju input_fn.
Korak 1) Definirajte put i format podataka
Prvo, deklarirate dvije varijable s putanjom CSV datoteka. Imajte na umu da imate dvije datoteke, jednu za skup za učenje i jednu za skup za testiranje.
import tensorflow as tf
df_train = "E:/boston_train.csv"
df_eval = "E:/boston_test.csv"
Zatim morate definirati stupce koje želite koristiti iz CSV datoteke. Koristit ćemo ih sve. Nakon toga morate deklarirati tip svake varijable.
Varijable s pomičnim brojem definirane su s [0.]
COLUMNS = ["crim", "zn", "indus", "nox", "rm", "age",
                "dis", "tax", "ptratio", "medv"]
RECORDS_ALL = [[0.0], [0.0], [0.0], [0.0],[0.0],[0.0],[0.0],[0.0],[0.0],[0.0]]
Korak 2) Definirajte funkciju input_fn
Funkcija se može podijeliti na tri dijela:
- Uvezite podatke
- Kreirajte iterator
- Konzumirajte podatke
Ispod je cjelokupni kod za definiranje funkcije. Kod će biti objašnjen kasnije.
def input_fn(data_file, batch_size, num_epoch = None):
       # Step 1
          def parse_csv(value):
          columns = tf.decode_csv(value, record_defaults= RECORDS_ALL)
          features = dict(zip(COLUMNS, columns))
          #labels = features.pop('median_house_value')
          labels =  features.pop('medv')
          return features, labels

          # Extract lines from input files using the Dataset API.
          dataset = (tf.data.TextLineDataset(data_file) # Read text file
          .skip(1) # Skip header row
          .map(parse_csv))

          dataset = dataset.repeat(num_epoch)
          dataset = dataset.batch(batch_size)
          # Step 3
          iterator = dataset.make_one_shot_iterator()
          features, labels = iterator.get_next()
          return features, labels
Uvezite podatke
Za CSV datoteku, metoda skupa podataka čita redak po redak. Za izradu skupa podataka potrebno je koristiti objekt TextLineSkup podataka. Vaš skup podataka ima zaglavlje, pa morate koristiti skip(1) za preskakanje prvog retka. U ovom trenutku čitate samo podatke i isključujete zaglavlje u cjevovodu. Za hranjenje modela morate odvojiti značajke od oznake. Metoda koja se koristi za primjenu bilo koje transformacije na podatke je map.
Ova metoda poziva funkciju koju ćete kreirati kako biste dali upute kako transformirati podatke. Ukratko, trebate proslijediti podatke u TextLineObjekt skupa podataka, isključite zaglavlje i primijenite transformaciju koju upućuje funkcija.
Code obrazloženje
- tf.podaci.TextLineSkup_podataka(data_file): ovaj redak čita CSV datoteku
- .skip(1): preskače zaglavlje
- .map(parse_csv)): parsira zapise u tenzore
Morate definirati funkciju za davanje uputa objektu karte. Ovu funkciju možete nazvati parse_csv.
Ova funkcija parsira CSV datoteku metodom tf.decode_csv i deklarira značajke i oznaku. Značajke se mogu deklarirati kao rječnik ili skup. Metodu rječnika koristite jer je praktičnija.
Code obrazloženje
- tf.decode_csv(value, record_defaults= RECORDS_ALL): metoda decode_csv koristi izlaz TextLineSkup podataka za čitanje CSV datoteke. record_defaults upućuje TensorFlow o vrstama stupaca. U TensorFlowu 2.x ovaj se simbol nalazi na tf.io.decode_csv.
- dict(zip(COLUMNS, columns)): popunjava rječnik svim stupcima extractijekom ove obrade podataka
- features.pop('medv'): isključuje ciljnu varijablu iz varijabli značajki i stvara varijablu oznake
Skup podataka treba dodatne elemente za iterativno punjenje tenzora. Doista, potrebno je dodati metodu repeat kako bi skup podataka mogao neograničeno puniti model. Ako ne dodate metodu, model će iterirati samo jednom, a zatim izbaciti grešku jer se u cjevovod više ne unose podaci.
Nakon toga, možete kontrolirati veličinu serije pomoću batch metode. To znači da skupu podataka govorite koliko podataka želite proslijediti u cjevovod za svaku iteraciju. Ako postavite veliku veličinu serije, model će biti spor.
Korak 3) Kreirajte iterator
Sada ste spremni za drugi korak: kreirajte iterator za vraćanje elemenata u skup podataka.
Najjednostavniji način kreiranja operatora je pomoću metode make_one_shot_iterator.
Nakon toga možete kreirati značajke i oznake iz iteratora.
Korak 4) Konzumirajte podatke
Možete provjeriti što se događa s funkcijom input_fn. Funkciju morate pozvati u sesiji kako biste koristili podatke. Pokušavate s veličinom serije jednakom 1.
Imajte na umu da ispisuje značajke u rječniku i oznaku kao niz.
Prikazat će se prvi redak CSV datoteke. Možete pokušati pokrenuti ovaj kod mnogo puta s različitim veličinama serija.
next_batch = input_fn(df_train, batch_size = 1, num_epoch = None)
with tf.Session() as sess:
     first_batch  = sess.run(next_batch)
     print(first_batch)
Izlaz
({'crim': array([2.3004], dtype=float32), 'zn': array([0.], dtype=float32), 'indus': array([19.58], dtype=float32), 'nox': array([0.605], dtype=float32), 'rm': array([6.319], dtype=float32), 'age': array([96.1], dtype=float32), 'dis': array([2.1], dtype=float32), 'tax': array([403.], dtype=float32), 'ptratio': array([14.7], dtype=float32)}, array([23.8], dtype=float32))
Korak 5) Definirajte stupac značajki
Numeričke stupce trebate definirati na sljedeći način:
X1= tf.feature_column.numeric_column('crim')
X2= tf.feature_column.numeric_column('zn')
X3= tf.feature_column.numeric_column('indus')
X4= tf.feature_column.numeric_column('nox')
X5= tf.feature_column.numeric_column('rm')
X6= tf.feature_column.numeric_column('age')
X7= tf.feature_column.numeric_column('dis')
X8= tf.feature_column.numeric_column('tax')
X9= tf.feature_column.numeric_column('ptratio')
Imajte na umu da morate kombinirati sve varijable u jednom skupu.
base_columns = [X1, X2, X3,X4, X5, X6,X7, X8, X9]
Korak 6) Izgradite model
Možete uvježbati model s estimatorom LinearRegressor.
model = tf.estimator.LinearRegressor(feature_columns=base_columns, model_dir='train3')
Izlaz
INFO:tensorflow:Using default config. INFO:tensorflow:Using config: {'_model_dir': 'train3', '_tf_random_seed': None, '_save_summary_steps': 100, '_save_checkpoints_steps': None, '_save_checkpoints_secs': 600, '_session_config': None, '_keep_checkpoint_max': 5, '_keep_checkpoint_every_n_hours': 10000, '_log_step_count_steps': 100, '_train_distribute': None, '_service': None, '_cluster_spec': <tensorflow.python.training.server_lib.ClusterSpec object at 0x1820a010f0>, '_task_type': 'worker', '_task_id': 0, '_global_id_in_cluster': 0, '_master': '', '_evaluation_master': '', '_is_chief': True, '_num_ps_replicas': 0, '_num_worker_replicas': 1}
Morate koristiti a lambda funkcija kako biste mogli napisati argumente za funkciju input_fn. Ako ne koristite lambda funkciju, ne možete trenirati model.
# Train the estimator
model.train(steps =1000,
          input_fn= lambda : input_fn(df_train,batch_size=128, num_epoch = None))
Izlaz
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Create CheckpointSaverHook.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Saving checkpoints for 1 into train3/model.ckpt.
INFO:tensorflow:loss = 83729.64, step = 1
INFO:tensorflow:global_step/sec: 72.5646
INFO:tensorflow:loss = 13909.657, step = 101 (1.380 sec)
INFO:tensorflow:global_step/sec: 101.355
INFO:tensorflow:loss = 12881.449, step = 201 (0.986 sec)
INFO:tensorflow:global_step/sec: 109.293
INFO:tensorflow:loss = 12391.541, step = 301 (0.915 sec)
INFO:tensorflow:global_step/sec: 102.235
INFO:tensorflow:loss = 12050.5625, step = 401 (0.978 sec)
INFO:tensorflow:global_step/sec: 104.656
INFO:tensorflow:loss = 11766.134, step = 501 (0.956 sec)
INFO:tensorflow:global_step/sec: 106.697
INFO:tensorflow:loss = 11509.922, step = 601 (0.938 sec)
INFO:tensorflow:global_step/sec: 118.454
INFO:tensorflow:loss = 11272.889, step = 701 (0.844 sec)
INFO:tensorflow:global_step/sec: 114.947
INFO:tensorflow:loss = 11051.9795, step = 801 (0.870 sec)
INFO:tensorflow:global_step/sec: 111.484
INFO:tensorflow:loss = 10845.855, step = 901 (0.897 sec)
INFO:tensorflow:Saving checkpoints for 1000 into train3/model.ckpt.
INFO:tensorflow:Loss for final step: 5925.9873.
Out[8]:
<tensorflow.python.estimator.canned.linear.LinearRegressor at 0x18225eb8d0>
Možete procijeniti odgovara li vaš model na testnom setu pomoću donjeg koda:
results = model.evaluate(steps =None,input_fn=lambda: input_fn(df_eval, batch_size =128, num_epoch = 1))
for key in results:
print("   {}, was: {}".format(key, results[key]))
Izlaz
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Starting evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
INFO:tensorflow:Finished evaluation at 2018-05-13-02:06:02
INFO:tensorflow:Saving dict for global step 1000: average_loss = 32.15896, global_step = 1000, loss = 3215.896
   average_loss, was: 32.158958435058594
   loss, was: 3215.89599609375
   global_step, was: 1000
Posljednji korak je predviđanje vrijednosti cilja na temelju vrijednosti matrice značajki. Možete napisati rječnik s vrijednostima koje želite predvidjeti. Vaš model ima devet značajki, pa morate navesti vrijednost za svaku. Model će dati predviđanje za svaku od njih.
U donjem kodu upisujete vrijednosti svake značajke koja se nalazi u CSV datoteci df_predict.
Morate napisati novu funkciju input_fn jer u skupu podataka nema oznake. Možete koristiti from_tensors API iz objekta Skup podataka.
prediction_input = {
          'crim': [0.03359,5.09017,0.12650,0.05515,8.15174,0.24522],
          'zn': [75.0,0.0,25.0,33.0,0.0,0.0],
          'indus': [2.95,18.10,5.13,2.18,18.10,9.90],
          'nox': [0.428,0.713,0.453,0.472,0.700,0.544],
          'rm': [7.024,6.297,6.762,7.236,5.390,5.782],
          'age': [15.8,91.8,43.4,41.1,98.9,71.7],
          'dis': [5.4011,2.3682,7.9809,4.0220,1.7281,4.0317],
          'tax': [252,666,284,222,666,304],
          'ptratio': [18.3,20.2,19.7,18.4,20.2,18.4]
     }
     def test_input_fn():
     dataset = tf.data.Dataset.from_tensors(prediction_input)
     return dataset

     # Predict all our prediction_input
     pred_results = model.predict(input_fn=test_input_fn)
Na kraju ispisujete predviđanja.
for pred in enumerate(pred_results):
print(pred)
Izlaz
INFO:tensorflow:Calling model_fn.
INFO:tensorflow:Done calling model_fn.
INFO:tensorflow:Graph was finalized.
INFO:tensorflow:Restoring parameters from train3/model.ckpt-1000
INFO:tensorflow:Running local_init_op.
INFO:tensorflow:Done running local_init_op.
(0, {'predictions': array([32.297546], dtype=float32)})
(1, {'predictions': array([18.96125], dtype=float32)})
(2, {'predictions': array([27.270979], dtype=float32)})
(3, {'predictions': array([29.299236], dtype=float32)})
(4, {'predictions': array([16.436684], dtype=float32)})
(5, {'predictions': array([21.460876], dtype=float32)})

INFO:tensorflow:Calling model_fn. INFO:tensorflow:Done calling model_fn. INFO:tensorflow:Graph was finalized. INFO:tensorflow:Restoring parameters from train3/model.ckpt-5000 INFO:tensorflow:Running local_init_op. INFO:tensorflow:Done running local_init_op. (0, {'predictions': array([35.60663], dtype=float32)}) (1, {'predictions': array([22.298521], dtype=float32)}) (2, {'predictions': array([25.74533], dtype=float32)}) (3, {'predictions': array([35.126694], dtype=float32)}) (4, {'predictions': array([17.94416], dtype=float32)}) (5, {'predictions': array([22.606628], dtype=float32)})
Sva tri cjevovoda vraćaju istih šest predviđanja, što potvrđuje da je izbor između Pandasa, NumPy-a i izvornog TensorFlow skupa podataka stvar praktičnosti, a ne točnosti.
