
Stvorite i ubacite INDEX Cassandra
 Uredništvo
⚡ Pametni sažetak
Stvori i ubaci indeks u Cassandra omogućuje filtriranje stupaca koji nisu dio primarnog ključa. Ova stranica pokriva naredbe CREATE INDEX i DROP INDEX, pravila imenovanja, dostupne vrste indeksa i slučajeve kada je indeks pogrešan odgovor.
Cassandra Stvori indeks
Naredba 'Create index' stvara indeks na stupcu koji odredi korisnik. Ako podaci već postoje za stupac koji želite indeksirati, Cassandra stvara indekse podataka tijekom izvođenja naredbe 'create index'.
- Nakon kreiranja indeksa, Cassandra automatski indeksira nove podatke kada se podaci umetnu.
- Indeks se ne može stvoriti na primarnom ključu jer je primarni ključ već indeksiran.
- Podržani su indeksi na stupcima kolekcije, korištenjem oblika KEYS, VALUES ili ENTRIES, ovisno o tome što treba pretraživati.
- Bez indeksiranja na stupcu, Cassandra Ne može filtrirati taj stupac osim ako nije primarni ključ.
Zato je za filtriranje stupaca u Cassandra, potrebno je kreirati indekse.
Sintaksa
CREATE INDEX IndexName ON KeyspaceName.TableName (ColumnName);
Primjer
Ovdje je snimka na kojoj se pokušalo filtrirati stupac "dept" bez stvaranja indeksa. Kao odgovor, vraćena je pogreška.

Ovdje je snimka gdje je indeks kreiran u stupcu dept.

CREATE INDEX DeptIndex ON University.Student (dept);
Ovdje je snimka gdje će biti uspješno filtriran 'dept' stupac.

SELECT * FROM University.Student WHERE dept = 'CS';
Naziv indeksa je opcionalan. Njegovo izostavljanje omogućuje Cassandra automatski ga generirati, što je važno kada se indeks kasnije mora izbrisati.
CREATE INDEX IF NOT EXISTS ON University.Student (dept);
Cassandra Ispustite indeks
Naredba 'Drop index' ispušta navedeni indeks. Ako ime indeksa nije dano tijekom stvaranja indeksa, tada je ime indeksa TableName_ColumnName_idx.
- Ako indeks ne postoji, vratit će pogrešku osim ako se ne koristi IF EXISTS koji će vratiti no-op.
- Morate navesti naziv ključnog prostora s nazivom indeksa, inače će se indeks tražiti u trenutnom ključnom prostoru.
Sintaksa
DROP INDEX IF EXISTS KeyspaceName.IndexName;
Primjer
Ovdje je snimka izvršene naredbe 'Drop index' koja ispušta indeks DeptIndex.
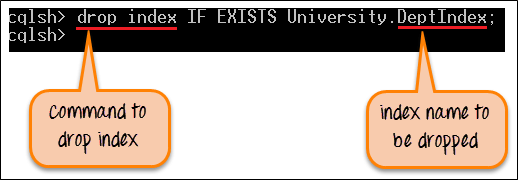
DROP INDEX IF EXISTS University.DeptIndex;
Nakon uspješnog izvođenja naredbe, DeptIndex će biti ispušten iz prostora ključeva. Sada se podaci ne mogu filtrirati prema odjelu stupca.
Za potvrdu koji indeksi postoje prije brisanjaping Prvo, opišite tablicu i pročitajte definicije indeksa na dnu ispisa.
DESCRIBE TABLE University.Student;
Vrste indeksa u Cassandra
Gornja naredba stvara standardni sekundarni indeks, ali postoje tri različita mehanizma i oni se ponašaju vrlo različito.
| Tip | Kako funkcionira | Najbolje za |
|---|---|---|
| Sekundarni indeks | Svaki čvor indeksira samo svoje lokalne podatke, tako da upit bez particijskog ključa mora kontaktirati svaki čvor. | Umjereni stupci kardinalnosti upitani su uz ključ particije. |
| SASI indeks | Priloženi indeks koji podržava podudaranje prefiksa i sufiksa LIKE plus numeričke raspone. | Uzorci pretraživanja teksta. Još uvijek su označeni kao eksperimentalni, stoga testirajte prije upotrebe u produkciji. |
| Indeks priložene pohrane (SAI) | Uveden u Cassandra 5.0, dijeljenje jedne indeksne strukture između stupaca s nižim opterećenjem pisanja. | Moderna zamjena za oboje gore navedeno Cassandra 5 klastera. |
Indeksiranje stupca kolekcije koristi modifikator koji određuje koji dio treba indeksirati.
CREATE INDEX ON University.Teacher (VALUES(Email));
CREATE INDEX ON University.Course (KEYS(prereq));
CREATE INDEX ON University.Course (ENTRIES(prereq));
VALUES pretražuje elemente skupa ili popisa, KEYS pretražuje ključeve mapiranja, a ENTRIES uspoređuje par ključ i vrijednost. Indeksiranje kolekcija detaljnije je opisano u Cassandra kolekcije udžbenik.
Kada ne koristiti indeks u Cassandra
Sekundarni indeks je praktičan, ali nije relacijski indeks, a korištenje na pogrešnom mjestu čest je uzrok sporih klastera. Četiri situacije zahtijevaju drugačiji pristup.
- Vrlo visoka kardinalnost. Indeksiranje nečega što je blizu jedinstvenosti, poput adrese e-pošte, znači da gotovo svaka particija sadrži jedan odgovarajući redak, pa se upit širi po cijelom klasteru kako bi vratio jedan zapis.
- Vrlo niska kardinalnost. Indeksiranje zastavice s dvije vrijednosti, kao što su aktivna ili neaktivna, stvara ogromne particije indeksa, a čitanje jedne vraća polovicu tablice.
- Često ažurirane kolumne. Svaka promjena zapisuje unos u indeks i tombstone za stari, pa nakupljanje tombstonea s vremenom degradira čitanja.
- Upiti bez particijske ključa. Bez njega, koordinator mora kontaktirati svaki čvor i spojiti rezultate, što se ne skalira kako se čvorovi dodaju.
Trajna alternativa je druga tablica s ključem prema stupcu koji treba pretraživati, napisana istovremeno s prvom. To slijedi princip "prvi upit" opisan u Cassandra pravila modela podatakai svako čitanje pohranjuje u jednu particiju na jednom čvoru.
Kao radno pravilo, indeks odgovara stupcu umjerene kardinalnosti koji se upituje zajedno s poznatim particijskim ključem. Svemu izvan tog opisa bolje odgovara namjenski izgrađena tablica.
