
Looge ja sisestage INDEX Cassandra
 David Carter
⚡ Nutikas kokkuvõte
Loo ja lisa indeks Cassandra võimaldab filtreerida veergude järgi, mis ei ole primaarvõtme osa. See leht käsitleb käske CREATE INDEX ja DROP INDEX, nimetamisreegleid, saadaolevaid indeksitüüpe ja juhtumeid, kus indeks on vale vastus.
Cassandra Loo indeks
Käsk 'Loo indeks' loob indeksi kasutaja määratud veerus. Kui andmed veeru kohta, mida soovite indekseerida, on juba olemas, Cassandra loob andmetele indeksid lause 'create index' täitmise ajal.
- Pärast indeksi loomist Cassandra indekseerib uued andmed andmete sisestamisel automaatselt.
- Indeksit ei saa primaarvõtmega luua, kuna primaarvõti on juba indekseeritud.
- Kollektsiooniveergude indeksid on toetatud, kasutades vormi KEYS, VALUES või ENTRIES, olenevalt sellest, mida on vaja otsida.
- Ilma veerus indekseerimata Cassandra Seda veergu ei saa filtreerida, kui see pole primaarvõti.
Sellepärast veergude filtreerimiseks Cassandra, tuleb luua indeksid.
Süntaks
CREATE INDEX IndexName ON KeyspaceName.TableName (ColumnName);
Näide
Siin on hetktõmmis, kus prooviti veergu "osakond" filtreerida ilma indeksit loomata. Vastuseks tagastati viga.

Siin on hetktõmmis, kus indeks luuakse osakonna veerus.

CREATE INDEX DeptIndex ON University.Student (dept);
Siin on hetktõmmis, kus see edukalt filtreeritakse veerus "osakond".

SELECT * FROM University.Student WHERE dept = 'CS';
Indeksi nimi on valikuline. Selle väljajätmine võimaldab Cassandra genereerib selle automaatselt, mis on oluline siis, kui indeks tuleb hiljem kustutada.
CREATE INDEX IF NOT EXISTS ON University.Student (dept);
Cassandra Kukkumise indeks
Käsk 'Drop index' tühistab määratud indeksi. Kui indeksi loomisel indeksi nime ei antud, on indeksi nimi Tabelinimi_VeeruNimi_idx.
- Kui indeksit pole, tagastab see veateate, välja arvatud juhul, kui kasutatakse IF EXISTS, mis tagastab no-op.
- Võtmeruumi nimi tuleb määrata koos indeksi nimega, vastasel juhul otsitakse indeksit praegusest võtmeruumist.
Süntaks
DROP INDEX IF EXISTS KeyspaceName.IndexName;
Näide
Siin on hetktõmmis käivitatud käsust "Drop index", mis tühistab indeksi DeptIndex.
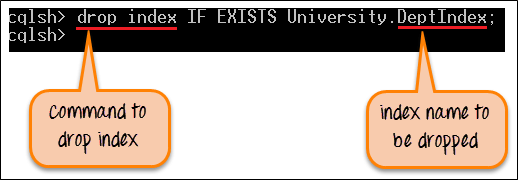
DROP INDEX IF EXISTS University.DeptIndex;
Pärast käsu edukat täitmist eemaldatakse DeptIndex klahviruumist. Nüüd ei saa andmeid veeru osakonna järgi filtreerida.
Enne indeksite eemaldamist kinnitamaks, millised indeksid on olemasping esiteks kirjelda tabelit ja loe väljundi allosas olevaid indeksi definitsioone.
DESCRIBE TABLE University.Student;
Indeksi tüübid Cassandra
Ülaltoodud käsk loob standardse teisese indeksi, kuid eksisteerib kolm erinevat mehhanismi ja need käituvad väga erinevalt.
| KASUTUSALA | Kuidas see töötab? | Parim on |
|---|---|---|
| Teisene indeks | Iga sõlm indekseerib ainult oma kohalikke andmeid, seega peab partitsioonivõtmeta päring võtma ühendust iga sõlmega. | Mõõdukate kardinaalsusega veergude päringud koos partitsioonivõtmega. |
| SASI indeks | Lisatud indeks, mis toetab LIKE ees- ja järelliite vastavust ning numbrilisi vahemikke. | Tekstiotsingu mustrid. Ikka veel katsejärgus, seega testige enne tootmiskasutust. |
| Salvestusruumi lisatud indeks (SAI) | Sisseehitatud Cassandra 5.0, jagades ühte indeksistruktuuri veergude vahel väiksema kirjutamiskuluga. | Mõlema ülaltoodu kaasaegne asendaja Cassandra 5 klastrit. |
Kollektsiooniveeru indekseerimine kasutab modifikaatorit, mis määrab, millist osa indekseerida.
CREATE INDEX ON University.Teacher (VALUES(Email));
CREATE INDEX ON University.Course (KEYS(prereq));
CREATE INDEX ON University.Course (ENTRIES(prereq));
VALUES otsib hulga või loendi elemente, KEYS otsib vastevõtmeid ja ENTRIES leiab võtme ja väärtuse paari. Kollektsiooni indekseerimist käsitletakse lähemalt järgmises jaotises. Cassandra kollektsioonid juhendaja.
Millal mitte kasutada indeksit Cassandra
Teisene indeks on mugav, kuid see ei ole relatsiooniline indeks ja selle kasutamine vales kohas on aeglaste klastrite levinud põhjus. Neli olukorda nõuavad erinevat lähenemist.
- Väga kõrge kardinaalsus. Millegi peaaegu unikaalsele sarnase (nt e-posti aadressi) indekseerimine tähendab, et peaaegu igas partitsioonis on üks vastav rida, seega hajub päring üle kogu klastri ja tagastab ühe kirje.
- Väga madal kardinaalsus. Kahe väärtusega lipu (nt aktiivne või mitteaktiivne) indekseerimine loob tohutud indekspartitsioonid ja ühe väärtuse lugemine tagastab poole tabelist.
- Sageli uuendatavad veerud. Iga muudatusega luuakse registrikirje ja vana hauakivi, seega hauakivide kogunemine halvendab lugemiste kvaliteeti aja jooksul.
- Päringud ilma partitsioonivõtmeta. Ilma selleta peab koordinaator iga sõlmega ühendust võtma ja tulemused ühendama, mis sõlmede lisamisel ei skaleeru.
Püsiv alternatiiv on teine tabel, mis on võtmestatud otsingut vajava veeru järgi ja kirjutatud samaaegselt esimesega. See järgib päringu-kõigepealt põhimõtet, mida on kirjeldatud jaotises Cassandra andmemudeli reeglidja see hoiab iga lugemise ühele partitsioonile ühel sõlmel.
Tööreeglina sobib indeks mõõduka kardinaalsusega veerule, millele päringu esitatakse koos teadaoleva partitsioonivõtmega. Kõigele, mis sellest kirjeldusest välja jääb, sobib paremini otstarbeks loodud tabel.
