
SAP ХАНА ArchiTecture: Преглед на базата данни
 Редакционен екип
⚡ Умно обобщение
SAP ХАНА ArchiТекстурата, ландшафтът и оразмеряването формират основата на платформа за данни в паметта, изградена върху SUSE Linux и C++Тази статия обяснява индексния сървър, механизмите за съхранение, хранилищата на редове и колони, делта сливането и методите за оразмеряване на хардуера.
Какво е SAP База данни HANA?
SAP HANA е платформа за управление на данни, фокусирана върху основната памет. Базата данни работи на SUSE Linux Enterprise Server (SLES) и Red Hat Enterprise Linux (RHEL) и е написан на C++Може да се мащабира на множество машини за много големи натоварвания.
Основни предимства на SAP ХАНА:
- Изключително бърза производителност на заявки, защото всички данни се зареждат в паметта, премахвайки бавните дискови входно-изходни операции от критичния път.
- Смесено използване на OLAP (онлайн аналитична обработка) и OLTP (онлайн обработка на транзакции) в една и съща база данни, опростявайки информационния пейзаж.
SAP Базата данни HANA е изградена от набор от процесори в паметта. Изчислителният механизъм е основният и взаимодейства с други механизми, като например релационния механизъм (хранилище за редове и колони), OLAP механизма, текстовия механизъм и графичния механизъм. Релационната таблица се намира или в хранилището за редове, или в хранилището за колони, а допълнителни механизми обработват текстови и графични данни, докато има налична памет.
SAP ХАНА Archiтекстура
Данните в хранилището на колони се компресират с помощта на техники като речниково кодиране, кодиране по дължина на изпълнение, разредено кодиране, клъстерно кодиране и индиректно кодиране. Когато се достигне лимитът на основната памет, обектите на базата данни, които не се използват (таблици, изгледи и др.), се разтоварват автоматично на диска и се зареждат отново, когато бъдат поискани отново.
Администраторите могат също така да зареждат или разтоварват отделна таблица ръчно, като щракнат с десния бутон върху нея в SAP Студио ХАНА и избора разтоварвам or Натоварване.
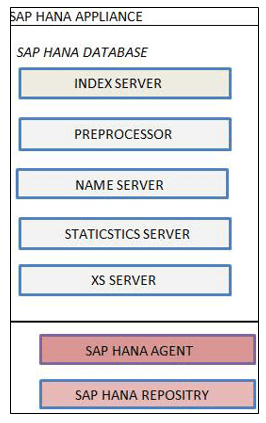
SAP HANA сървърът се състои от:
- Индекс сървър
- Препроцесорен сървър
- Name Server
- Статистически сървър
- XS двигател
1. SAP HANA индекс сървър
Индексният сървър е основният SAP Компонент на базата данни HANA:
- Това е сърцето на SAP HANA двигател на базата данни.
- Той съдържа действителните хранилища на данни и двигателите, които обработват данните.
- Изпълнява входящи SQL и MDX оператори.
Архитектурата на индексния сървър е показана по-долу.

SAP Общ преглед на HANA Index Server
- Мениджър на сесии и транзакции: Компонентът „Сесия“ управлява връзките и сесиите за базата данни. Мениджърът на транзакции координира и контролира всички транзакции.
- SQL и MDX процесор: SQL процесорът изпраща заявки към съответния енджин (SQL / SQL Script / R / Calc Engine). MDX процесорът обработва многомерни заявки (например към аналитичен изглед).
- SQL / SQL Script / R / Calc Engine: Изпълнява SQL, SQL Script, R и изчислителни модели спрямо данните.
- Repository: Поддържа версиите за SAP Обекти с метаданни на HANA, като например изгледи на атрибути, аналитични изгледи и съхранени процедури.
- Слой за устойчивост: Предоставя вградената възможност за възстановяване след бедствия, като записва точки на запазване и регистрационни файлове в обема с данни на диска.
2. Сървър за предпроцесор
Сървърът за предпроцесор се използва от текстовия анализ. Той еtracts и подготвя данни от текстово съдържание, когато се извика функцията за търсене.
3. Сървър за имена
Сървърът за имена (name server) съхранява информация за целия системен пейзаж. В разпределено внедряване той tracks всеки работещ компонент и местоположението на данните в различните възли, така че заявките да могат да бъдат насочени към правилния сървър.
4. Статистически сървър
Статистическият сървър събира данни за състоянието, разпределението на ресурсите, потреблението и производителността за SAP HANA система. Забележка: в HANA SPS 7 и по-нови версии, вградената статистическа услуга се изпълнява вътре в индексния сървър, а не като самостоятелен процес.
5. XS сървър
XS сървърът е домакин на XS Engine, който позволява на външни приложения и разработчици да използват SAP HANA база данни през HTTP. Самият XS Engine действа като лек HTTP сървър, позволявайки на браузър-базирани и REST клиенти да комуникират директно с HANA.
SAP Хана пейзаж
„ХАНА“ означава Високоефективен аналитичен уред и се доставя като комбинирана хардуерна и софтуерна платформа.
- Съвременният хардуер предлага много повече процесорни ядра, RAM памет и пропускателна способност за съхранение, отколкото са били проектирани да използват стари сървъри за бази данни.
- SAP HANA използва това от keeping всички работни данни в основната памет, елиминирайки пречките при дисковия вход/изход, които ограничават традиционните бази данни.
Диаграмата по-долу обобщава SAP Хардуерни и софтуерни иновации в HANA.

SAP HANA поддържа две релационни хранилища за данни: Магазин за редове намлява Магазин за колони.
Магазин за редове
Row Store се държи като традиционна база данни (Oracle, SQL Server). Ключовата разлика е, че всички редове се намират в основната памет в SAP HANA, докато традиционната база данни ги съхранява предимно на диск.
Магазин за колони
Column Store съхранява данните в паметта в колонен вид. Тук се съхраняват таблици с колони и системата балансира добрата производителност при запис с оптимизираната производителност при четене. Диаграмата по-долу показва двете структури, които постигат този баланс.

Основно хранилище
Главното хранилище съхранява по-голямата част от данните. Прилагат се методи за компресия, като например речниково кодиране, клъстерно кодиране, разредено кодиране и кодиране на дължина на изпълнение, за да се спести памет и да се ускори търсенето.
- Модифицирането на компресирани данни директно в основната памет е скъпо, така че записите не са насочени към основната памет.
- Вместо това, всяка промяна се записва в отделна област, наречена Delta СъхранениеЧетенията могат да достигнат или до основното, или до делта хранилище.
Данните могат да бъдат зареждани или изваждани ръчно с помощта на Зареждане в паметта намлява Изтегляне от паметта опциите, показани по-долу.

Delta Съхранение
Delta Паметта е оптимизирана за записи и използва по-лека компресия. Всички некоммитирани промени в таблица с колони се съхраняват тук. Когато промените трябва да бъдат обединени обратно в основната памет, изпълнете командата Delta Обединяване операция от SAP Студио ХАНА.

- Делта сливането премества промените, събрани в делта хранилището, в основното хранилище.
- След сливането, новото съдържание на основното хранилище се запазва на диска и компресията се преизчислява.
Как се преместват данните от Delta към основното хранилище

Буфер, организиран по редове, наречен L1-Delta се намира пред всяка таблица с колони, поради което таблицата с колони може да абсорбира високопроизводителни записи.
- Потребителят изпълнява UPDATE или INSERT спрямо таблицата.
- Данните първо попадат в L1-Delta (некоммитирани данни).
- След като бъдат потвърдени, данните се преместват в колонно-ориентирания L2-Delta буфер.
- Когато L2-Delta е пълен или сливането се изпълнява, данните се записват в основното хранилище.
Следователно, колонното съхранение е оптимизирано както за запис (чрез L1 и L2 делта), така и за четене (чрез основното хранилище). След обработка, данните се съхраняват от слоя за съхранение на данни на диска.
Пример за таблица, базирана на редове:

Една и съща логическа таблица се съхранява на диска по различен начин в зависимост от типа на хранилището. В Row Store редовете се записват последователно:

В Column Store стойностите от една и съща колона се съхраняват заедно:

Тъй като стойностите на колоните споделят типа данни и често се повтарят, оформлението на колоните се компресира изключително добре – което е основното предимство на паметта на хранилището за колони.

SAP HANA Оразмеряване
Оразмеряването е процес на определяне на хардуерните ресурси - RAM, диск и CPU - необходими за SAP HANA система. Паметта е най-важният фактор, процесорът е втори, а дискът е производен на първите два.
В SAP При внедряването на HANA, изборът на правилния размер на сървъра за бизнес натоварването е една от най-важните задачи. В сравнение с традиционната СУБД, оразмеряването на HANA се различава в три области:
- Основна памет: задвижвани от метаданни плюс обема на транзакционните и аналитични данни, съхранявани в паметта.
- CPU: приблизителни, а не измерени, базирани на прогнозни заявки и модели на натоварване.
- Disk: оразмерен за съхранение на данни и обеми на лог файлове, а не за данни от онлайн заявки.
Процесорът и паметта на сървъра на приложенията остават непроменени в сравнение с предишната база данни, тъй като HANA замества само нивото на базата данни.
SAP предлага няколко метода за изчисляване на правилния размер:
- Оразмеряване с помощта на ABAP отчет (код на транзакцията) ST03 данни и отчет /SDF/HDB_SIZING).
- Оразмеряване с помощта на скрипт за база данни за системи, които не са ABAP.
- Оразмеряване с помощта на SAP Бърз размерител инструмент на SAP Пазар на услуги.
Когато се използва инструментът Quick Sizer, изискването се показва във формата по-долу.

