
Как да заредите основни данни от плосък файл в SAP BI/BW
 Редакционен екип
⚡ Умно обобщение
Зареждане на основни данни от плосък файл в SAP BI/BW чрез конфигуриране на плоска файлова система, създаване на DataSource, трансформация, DTP и InfoPackage. Структурираният работен процес осигурява чиста карта на атрибутите.ping, валидиран бившtracи надеждно зареждане в InfoObjects.
Зареждане на основни данни от плосък файл
Зареждане на основни данни SAP BI/BW е фундаментална задача за аналитично отчитане. В това ръководство ще научите как да зареждате основни данни в инфообект от плосък файл, използвайки ясен и повтаряем работен процес.
Ще научим натоварването с помощта на сценарий: Зареждане на основни данни в InfoObject ЗМАТ (Номер на материал), който има атрибута ZMAT_NM (Име на материал). По-долу са подробни стъпки за зареждане на данни в инфообекта за главни данни от плосък файл.
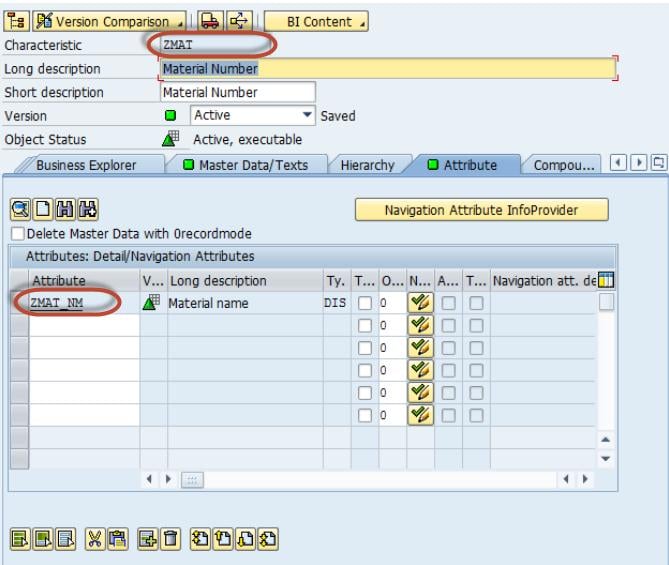
Стъпка 1: Създайте изходна система за плоския файл
Първият етап е да се регистрира система с плоски изходни файлове, така че SAP Бизнес разузнаването (BI) може да разпознае откъде произхождат входящите данни.
- Отидете на кода на транзакцията RSA1.
- Щракнете върху бутона OK.
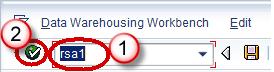
На следващия екран:
- Отидете до Раздел „Моделиране“ > Изходни системи.
- Щракнете с десния бутон върху папката с име ФАЙЛ и изберете „Създаване“ от контекстното меню.
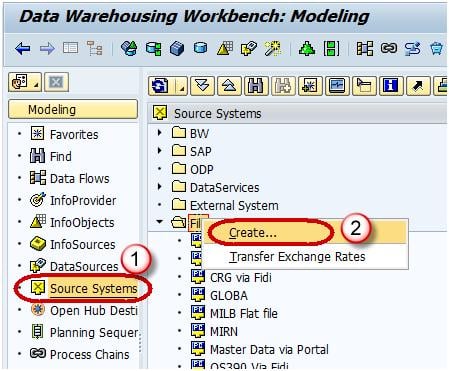
На следващия екран:
- Въведете името на логическата система.
- Въведете Descriptйон.
- Кликнете Продължете.
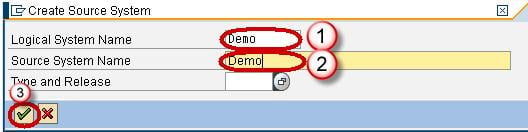
Стъпка 2: Създаване на компонент на приложението
Компонентите на приложението организират източниците на данни логически. Дефинирайте такъв, преди да създадете източника на данни, така че зареждането на плоския файл да бъде групирано разумно.
- Отидете до Раздел „Моделиране“ > „Източници на данни“.
- Изберете изходната система, която току-що създадохте.
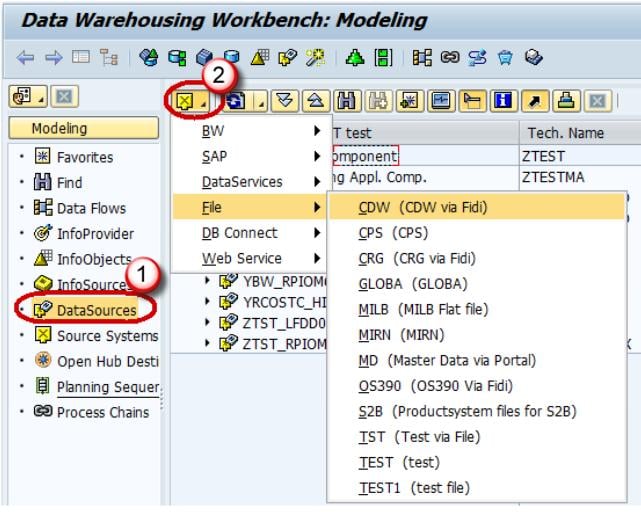
- Щракнете с десния бутон и изберете Създаване на компонент на приложението.
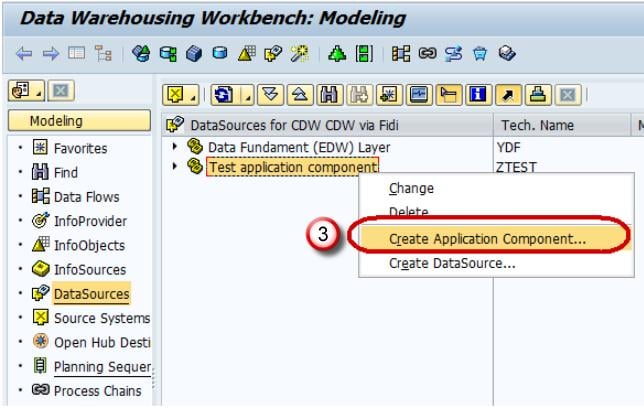
- Въведете техническото име.
- Въведете Descriptйон.
- Кликнете Продължете.

Създаване на източника на данни
След това създайте DataSource под Application Component, за да съхранявате входящата структура на плоския файл.
- Отидете до Раздел „Моделиране“ > „Източници на данни“.
- Щракнете с десния бутон и изберете Създаване на източник на данни.
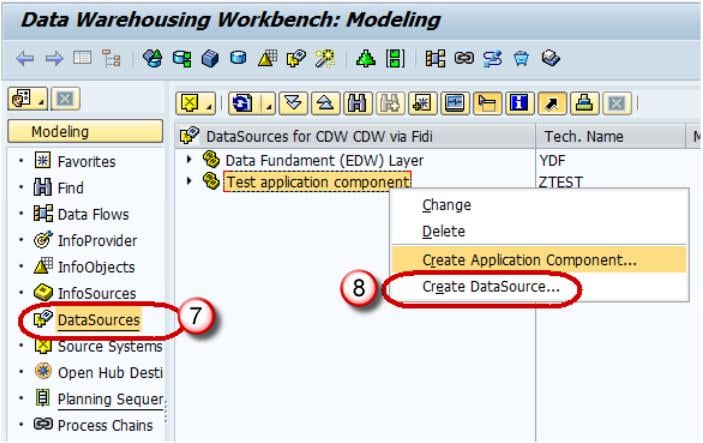
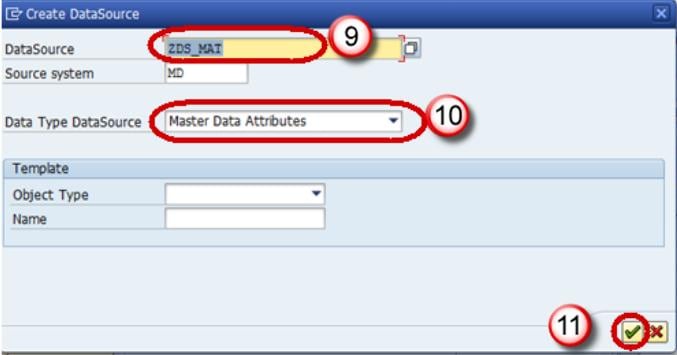
- Въведете техническото име.
- Изберете типа данни за източника на данни.
- Кликнете Продължете.
- Въведете полетата, показани по-долу. Тази структура трябва да съответства на DSO към който ще бъдат заредени данните за транзакциите.

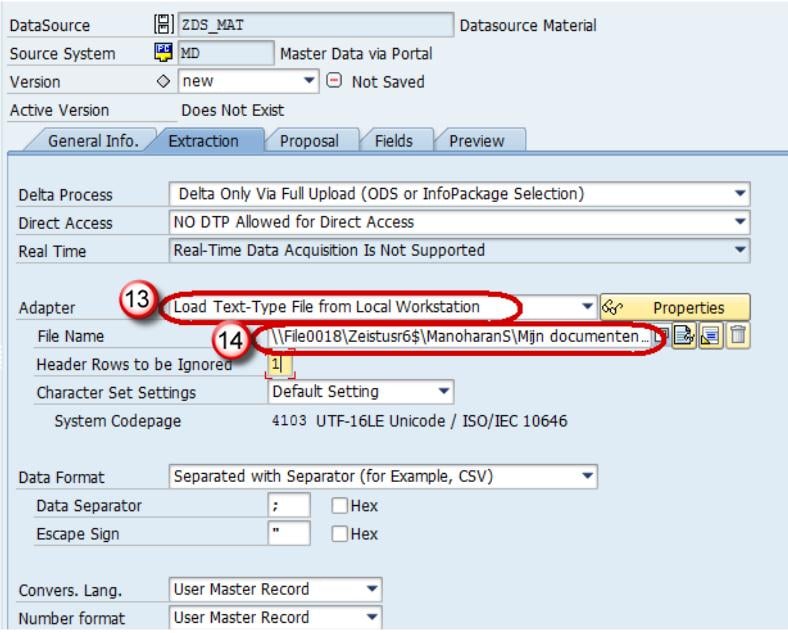
- в ExtracАЦИ в раздела изберете адаптера като „Зареждане на текстов файл от локална работна станция“.
- Изберете пътя до файла, където се намира плоският файл, след което активирайте DataSource.
Кликнете Спестявания.
Стъпка 3: Създаване на трансформация между DataSource и InfoObject атрибут
Трансформацията определя как изходните полета се съпоставят с атрибутите на целевия инфообект. SAP Карта с автоматични предложения за BIpings, когато имената на полетата се подравняват.
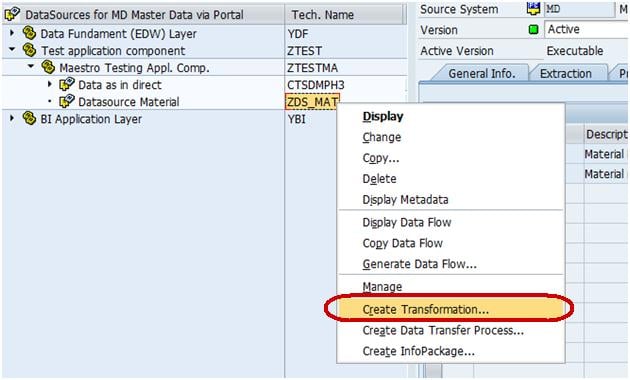
Щракнете с десния бутон върху DataSource и изберете Създаване на трансформация.
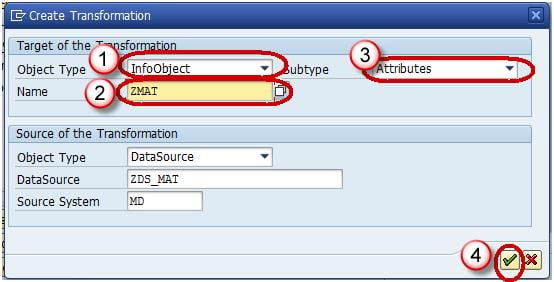
На следващия екран:
- Въведете Target Тип обект.
- Въведете Target Име на обект.
- Въведете подтипа.
- Кликнете Продължете.
Трансформацията е създадена с автоматична картаping от изходните полета към целевите полета.
Създаване на процес за трансфер на данни (DTP)
DTP прехвърля записи от PSA в активната целева група данни.
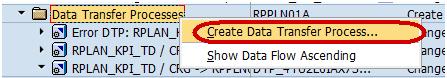
Щракнете с десния бутон върху папката DTP и изберете Създаване на процес за прехвърляне на данни от контекстното меню.
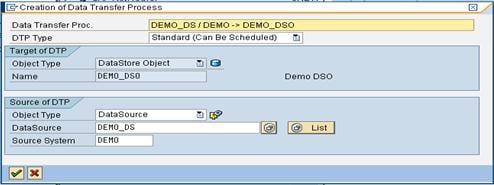
Екранът по-долу показва успешно създадения DTP.
Стъпка 4: Създаване на инфопакет и планиране на зареждането на данни
Инфопакетът контролира как плоският файл се чете в PSA. Планирайте го преди да стартирате DTP.
- Въведете RSA1 в командния ред.
- Натискане Въведете.
- Отидете до Раздел „Моделиране“ > „Източници на данни“.
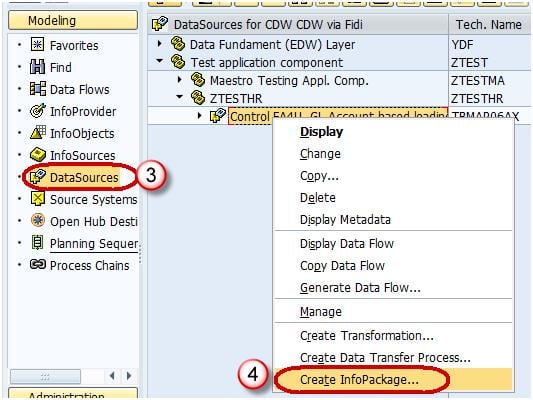
- Щракнете с десния бутон върху DataSource и изберете Създаване на инфопакет.
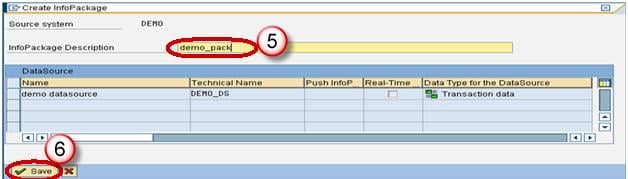
- Въведете Инфопакета Descriptйон.
- Кликнете Спестявания.
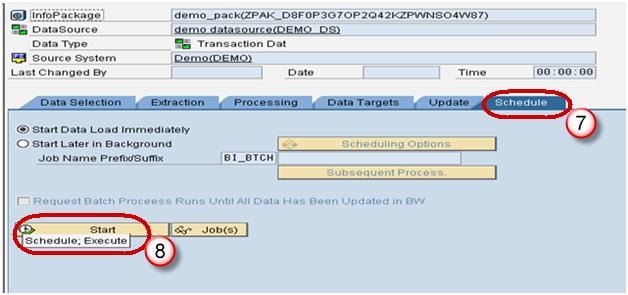
- Щракнете върху Планирам раздела.
- Кликнете Начало за да започне зареждането от плоския файл към DataSource.
Стъпка 5: Зареждане на данни в DSO
Последният етап изпълнява DTP, за да премести записи от PSA в активния инфообект за главни данни.
- Щракнете върху Изпълнение раздел в DTP.
- Щракнете върху Изпълнение бутон, за да започнете зареждането на данни от DataSource (PSA) в DSO.

Най-добри практики за зареждане на основни данни от плоски файлове
Следването на няколко доказани навика прави зареждането на плоски файлове предвидимо и лесно за отстраняване на проблеми. SAP BI/BW.
- Валидирайте плоския файл: Уверете се, че редът на полетата, разделителите и форматите на датата във файла съответстват на структурата на DataSource преди активиране.
- Ключове на атрибутите за съвпадение: Проверете дали ключовото поле на инфообекта е уникално в изходния файл, за да избегнете отхвърляне на зареждането.
- Тест с малки проби: Първо стартирайте InfoPackage и DTP с малък файл, след което мащабирайте до пълен обем след картата.ping се потвърждава.
- Мониторирайте PSA записи: Проверете PSA след изпълнението на InfoPackage, за да потвърдите броя на записите, преди да задействате DTP.
- Документирайте товара: Запишете имената на компонентите на приложението, източника на данни и DTP, така че натоварването да може да бъде лесно възпроизведено или предадено.
