
Създайте и пуснете INDEX Cassandra
 Дейвид Картър
⚡ Умно обобщение
Създаване и пускане на индекс в Cassandra активира филтриране по колони, които не са част от първичния ключ. Тази страница обхваща командите CREATE INDEX и DROP INDEX, правилата за именуване, наличните типове индекси и случаите, в които даден индекс е грешен отговор.
Cassandra Създаване на индекс
Командата 'Създаване на индекс' създава индекс върху колоната, зададена от потребителя. Ако данните вече съществуват за колоната, която искате да индексирате, Cassandra създава индекси на данните по време на изпълнението на оператора 'create index'.
- След като създадете индекс, Cassandra индексира нови данни автоматично, когато се вмъкнат данни.
- Индексът не може да бъде създаден върху първичен ключ, тъй като първичен ключ вече е индексиран.
- Поддържат се индекси върху колони от колекции, използващи формата KEYS, VALUES или ENTRIES, в зависимост от това какво трябва да се търси.
- Без индексиране на колоната, Cassandra не може да филтрира тази колона, освен ако не е първичен ключ.
Ето защо, за филтриране на колони в Cassandra, трябва да се създадат индекси.
Синтаксис
CREATE INDEX IndexName ON KeyspaceName.TableName (ColumnName);
Пример
Ето моментната снимка, където се опита да филтрира колона „dept“, без да създава индекс. В отговор грешката беше върната.

Ето моментната снимка, където индексът е създаден в колона dept.

CREATE INDEX DeptIndex ON University.Student (dept);
Ето моментната снимка, където ще бъде успешно филтрирана колона „dept“.

SELECT * FROM University.Student WHERE dept = 'CS';
Името на индекса е по избор. Пропускането му позволява Cassandra генерирайте такъв автоматично, което е от значение, когато индексът по-късно трябва да бъде премахнат.
CREATE INDEX IF NOT EXISTS ON University.Student (dept);
Cassandra Изпуснете индекс
Командата 'Drop index' премахва зададения индекс. Ако името на индекса не е дадено по време на създаването на индекса, тогава името на индекса е TableName_ColumnName_idx.
- Ако индексът не съществува, той ще върне грешка, освен ако не се използва IF EXISTS, който ще върне no-op.
- Трябва да укажете името на ключовото пространство заедно с името на индекса, в противен случай индексът ще се търси в текущото ключово пространство.
Синтаксис
DROP INDEX IF EXISTS KeyspaceName.IndexName;
Пример
Ето моментната снимка на изпълнената команда „Drop index“, която премахва индекса DeptIndex.
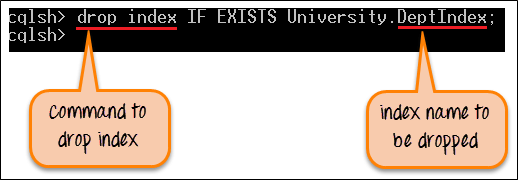
DROP INDEX IF EXISTS University.DeptIndex;
След успешното изпълнение на командата, DeptIndex ще бъде премахнат от пространството на ключовете. Сега данните не могат да бъдат филтрирани от отдел колона.
За да потвърдите кои индекси съществуват преди изтриванетоping първо, опишете таблицата и прочетете дефинициите на индексите в долната част на изхода.
DESCRIBE TABLE University.Student;
Видове индекси в Cassandra
Командата по-горе създава стандартен вторичен индекс, но съществуват три различни механизма и те се държат много различно.
| Тип | Как работи | Най - доброто за |
|---|---|---|
| Вторичен индекс | Всеки възел индексира само собствените си локални данни, така че заявка без ключ за дял трябва да се свърже с всеки възел. | Колони с умерена кардиналност, заявени заедно с ключ на дял. |
| Индекс SASI | Прикачен индекс, поддържащ съвпадение на префикси и суфикси LIKE, плюс числови диапазони. | Модели за търсене на текст. Все още е маркирано като експериментално, така че тествайте преди употреба в производствения процес. |
| Индекс на прикрепено съхранение (SAI) | Въведено в Cassandra 5.0, споделяйки една индексна структура в колоните с по-ниски разходи за запис. | Съвременният заместител и на двете по-горе Cassandra 5 клъстера. |
Индексирането на колона от колекция използва модификатор, който указва коя част да се индексира.
CREATE INDEX ON University.Teacher (VALUES(Email));
CREATE INDEX ON University.Course (KEYS(prereq));
CREATE INDEX ON University.Course (ENTRIES(prereq));
VALUES търси елементите на набор или списък, KEYS търси ключове за карта, а ENTRIES съпоставя двойка ключ и стойност. Индексирането на колекции е разгледано по-подробно в Cassandra колекции настойнически.
Кога не е добре да се използва индекс в Cassandra
Вторичният индекс е удобен, но не е релационен индекс, а използването му на грешното място е честа причина за бавни клъстери. Четири ситуации изискват различен подход.
- Много висока кардиналност. Индексирането на нещо близко до уникално, като например имейл адрес, означава, че почти всеки дял съдържа един съответстващ ред, така че заявката се разпростира по целия клъстер, за да върне един запис.
- Много ниска кардиналност. Индексирането на флаг с две стойности, като например активен или неактивен, създава огромни индексни дялове, а прочитането на един връща половината от таблицата.
- Често актуализирани колони. Всяка промяна записва индексен запис и надгробен камък за стария, така че натрупването на надгробни камъни влошава четенето с течение на времето.
- Заявки без ключ за дял. Без такъв, координаторът трябва да се свърже с всеки възел и да обедини резултатите, което не се мащабира с добавянето на възли.
Устойчивата алтернатива е втора таблица, ключова от колоната, която се нуждае от търсене, записана едновременно с първата. Това следва принципа „заявка първо“, описан в Cassandra правила за модел на даннии запазва всяко четене в един дял на един възел.
Като работно правило, индексът е подходящ за колона с умерена кардиналност, която се запитва заедно с известен ключ на дяла. Всичко извън това описание се обслужва по-добре от специално изградена таблица.
