
نموذج Seq2seq (من تسلسل إلى تسلسل) باستخدام بايثونTorch
 فريق التحرير
⚡ ملخص ذكي
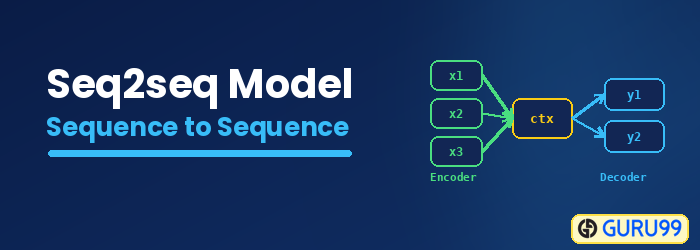
Seq2Seq عبارة عن بنية ترميز-فك ترميز تقوم بربط تسلسل الإدخال بتسلسل الإخراج باستخدام شبكتين عصبيتين متكررتين، مما يدعم الترجمة الآلية ومهام معالجة اللغة الطبيعية الأخرى حيث تختلف أطوال الإدخال والإخراج.
ما هو البرمجة اللغوية العصبية؟
تُعدّ معالجة اللغة الطبيعية (NLP) أحد فروع الذكاء الاصطناعي الشائعة، والتي تساعد أجهزة الكمبيوتر على فهم الإنسان والتفاعل معه والاستجابة له بلغته الطبيعية. وتُعتبر معالجة اللغة الطبيعية المحرك الأساسي وراء الذكاء الاصطناعي. Google Translate التي تساعدنا على فهم اللغات الأخرى.
ما هو Seq2Seq؟
Seq2Seq هي إحدى طرق الترجمة الآلية القائمة على التشفير وفك التشفير ومعالجة اللغة التي تقوم بتعيين مدخلات التسلسل إلى مخرجات التسلسل باستخدام علامة وقيمة انتباه. تتمثل الفكرة في استخدام شبكتين RNN تعملان معًا مع رمز خاص وتحاول التنبؤ بتسلسل الحالة التالي من التسلسل السابق.
كيفية التنبؤ بالتسلسل من التسلسل السابق
فيما يلي خطوات التنبؤ بتسلسل من التسلسل السابق باستخدام بايثونTorالفصل.
الخطوة 1) تحميل بياناتنا
بالنسبة لمجموعة البيانات الخاصة بنا، ستستخدم مجموعة بيانات من أزواج الجمل ثنائية اللغة المحددة بعلامات جدولة. سأستخدم هنا مجموعة البيانات من الإنجليزية إلى الإندونيسية. يمكنك اختيار أي شيء تريده ولكن تذكر تغيير اسم الملف والدليل في الكود.
from __future__ import unicode_literals, print_function, division
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F

import numpy as np
import pandas as pd

import os
import re
import random

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
الخطوة 2) إعداد البيانات
لا يمكنك استخدام مجموعة البيانات مباشرةً. عليك تقسيم الجمل إلى كلمات وتحويلها إلى متجه أحادي الترميز. سيتم فهرسة كل كلمة بشكل فريد في فئة Lang لإنشاء قاموس. ستقوم فئة Lang بتخزين كل جملة وتقسيمها كلمة بكلمة باستخدام addSentence. ثم أنشئ قاموسًا بفهرسة كل كلمة غير معروفة لنماذج Sequence to Sequence.
SOS_token = 0
EOS_token = 1
MAX_LENGTH = 20

#initialize Lang Class
class Lang:
   def __init__(self):
       #initialize containers to hold the words and corresponding index
       self.word2index = {}
       self.word2count = {}
       self.index2word = {0: "SOS", 1: "EOS"}
       self.n_words = 2  # Count SOS and EOS

#split a sentence into words and add it to the container
   def addSentence(self, sentence):
       for word in sentence.split(' '):
           self.addWord(word)

#If the word is not in the container, the word will be added to it, else, update the word counter
   def addWord(self, word):
       if word not in self.word2index:
           self.word2index[word] = self.n_words
           self.word2count[word] = 1
           self.index2word[self.n_words] = word
           self.n_words += 1
       else:
           self.word2count[word] += 1
فئة Lang هي فئة ستساعدنا في إنشاء قاموس. لكل لغة، سيتم تقسيم كل جملة إلى كلمات ثم إضافتها إلى الحاوية. ستخزن كل حاوية الكلمات في الفهرس المناسب، وتحسب عدد مرات تكرار الكلمة، وتضيف فهرس الكلمة حتى نتمكن من استخدامه للعثور على فهرس كلمة ما أو البحث عن كلمة من فهرسها.
نظرًا لأن بياناتنا مفصولة بواسطة TAB، فأنت بحاجة إلى استخدامها الباندا بصفتنا مُحمِّل بيانات، سيقرأ Pandas بياناتنا كإطار بيانات ويقسمها إلى جملة المصدر وجملة الهدف. لكل جملة، ستقوم بتحويلها إلى أحرف صغيرة، وإزالة جميع الأحرف غير الموجودة، وتحويلها من Unicode إلى ASCII، ثم تقسيم الجمل بحيث تحتوي على كل كلمة فيها.
#Normalize every sentence
def normalize_sentence(df, lang):
   sentence = df[lang].str.lower()
   sentence = sentence.str.replace('[^A-Za-z\s]+', '')
   sentence = sentence.str.normalize('NFD')
   sentence = sentence.str.encode('ascii', errors='ignore').str.decode('utf-8')
   return sentence

def read_sentence(df, lang1, lang2):
   sentence1 = normalize_sentence(df, lang1)
   sentence2 = normalize_sentence(df, lang2)
   return sentence1, sentence2

def read_file(loc, lang1, lang2):
   df = pd.read_csv(loc, delimiter='\t', header=None, names=[lang1, lang2])
   return df

def process_data(lang1,lang2):
   df = read_file('text/%s-%s.txt' % (lang1, lang2), lang1, lang2)
   print("Read %s sentence pairs" % len(df))
   sentence1, sentence2 = read_sentence(df, lang1, lang2)

   source = Lang()
   target = Lang()
   pairs = []
   for i in range(len(df)):
       if len(sentence1[i].split(' ')) < MAX_LENGTH and len(sentence2[i].split(' ')) < MAX_LENGTH:
           full = [sentence1[i], sentence2[i]]
           source.addSentence(sentence1[i])
           target.addSentence(sentence2[i])
           pairs.append(full)

   return source, target, pairs
من الوظائف المفيدة الأخرى التي ستستخدمها تحويل الأزواج إلى موترات. هذا مهم للغاية لأن شبكتنا تقرأ بيانات الموترات فقط. كما أنه مهم لأنه الجزء الذي يُضاف فيه رمز مميز في نهاية كل جملة لإعلام الشبكة باكتمال الإدخال. لكل كلمة في الجملة، ستحصل الشبكة على فهرس الكلمة المناسبة في القاموس وتضيف رمزًا مميزًا في نهاية الجملة.
def indexesFromSentence(lang, sentence):
   return [lang.word2index[word] for word in sentence.split(' ')]

def tensorFromSentence(lang, sentence):
   indexes = indexesFromSentence(lang, sentence)
   indexes.append(EOS_token)
   return torch.tensor(indexes, dtype=torch.long, device=device).view(-1, 1)

def tensorsFromPair(input_lang, output_lang, pair):
   input_tensor = tensorFromSentence(input_lang, pair[0])
   target_tensor = tensorFromSentence(output_lang, pair[1])
   return (input_tensor, target_tensor)
نموذج Seq2Seq

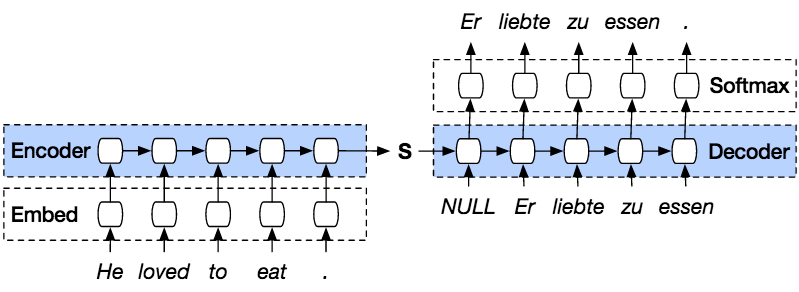
PyTorنموذج Seq2seq هو نوع من النماذج التي تستخدم لغة بايثونTorيُوضع مُشفّر ومُفكّك الشفرة في أعلى النموذج. يقوم المُشفّر بتشفير الجملة كلمةً كلمةً في فهرس للمفردات أو الكلمات المعروفة، بينما يتنبأ المُفكّك بمخرجات المدخلات المُشفّرة عن طريق فك تشفيرها بالتسلسل، ويحاول استخدام المدخل الأخير كمدخل تالٍ إن أمكن. بهذه الطريقة، يُمكن أيضًا التنبؤ بالمدخل التالي لتكوين جملة. تُخصّص لكل جملة رمزٌ مميزٌ لتمييز نهاية التسلسل. في نهاية التنبؤ، يُخصّص رمزٌ مميزٌ أيضًا لتمييز نهاية المخرجات. لذا، يُمرّر المُشفّر حالةً إلى المُفكّك للتنبؤ بالمخرجات.

سيقوم المُشفِّر بتشفير جملة الإدخال كلمةً كلمةً بالتسلسل، وفي النهاية ستكون هناك علامة مميزة لتمييز نهاية الجملة. يتكون المُشفِّر من طبقة تضمين وطبقة GRU. طبقة التضمين عبارة عن جدول بحث يخزن تضمين الإدخال في قاموس كلمات ذي حجم ثابت. سيتم تمريره إلى طبقة GRU. طبقة GRU هي وحدة تكرارية بوابية تتكون من نوع متعدد الطبقات. RNN من شأنها أن تحسب المدخلات المتسلسلة. ستقوم هذه الطبقة بحساب الحالة المخفية من الحالة السابقة وتحديث إعادة التعيين والتحديث والبوابات الجديدة.

يقوم المُفكِّك بفك تشفير المُدخل من مُخرج المُشفِّر. ويحاول التنبؤ بالمُخرج التالي واستخدامه كمُدخل تالٍ إن أمكن. يتكون المُفكِّك من طبقة تضمين، وطبقة GRU، وطبقة خطية. تُنشئ طبقة التضمين جدول بحث للمُخرج وتُمرِّره إلى طبقة GRU لحساب حالة المُخرج المُتوقعة. بعد ذلك، تُساعد الطبقة الخطية في حساب دالة التنشيط لتحديد القيمة الحقيقية للمُخرج المُتوقع.
class Encoder(nn.Module):
   def __init__(self, input_dim, hidden_dim, embbed_dim, num_layers):
       super(Encoder, self).__init__()

       #set the encoder input dimesion , embbed dimesion, hidden dimesion, and number of layers
       self.input_dim = input_dim
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.num_layers = num_layers

       #initialize the embedding layer with input and embbed dimention
       self.embedding = nn.Embedding(input_dim, self.embbed_dim)
       #intialize the GRU to take the input dimetion of embbed, and output dimention of hidden and
       #set the number of gru layers
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)

   def forward(self, src):
       embedded = self.embedding(src).view(1,1,-1)
       outputs, hidden = self.gru(embedded)
       return outputs, hidden

class Decoder(nn.Module):
   def __init__(self, output_dim, hidden_dim, embbed_dim, num_layers):
       super(Decoder, self).__init__()

#set the encoder output dimension, embed dimension, hidden dimension, and number of layers
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.output_dim = output_dim
       self.num_layers = num_layers

# initialize every layer with the appropriate dimension. For the decoder layer, it will consist of an embedding, GRU, a Linear layer and a Log softmax activation function.
       self.embedding = nn.Embedding(output_dim, self.embbed_dim)
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)
       self.out = nn.Linear(self.hidden_dim, output_dim)
       self.softmax = nn.LogSoftmax(dim=1)

   def forward(self, input, hidden):
# reshape the input to (1, batch_size)
       input = input.view(1, -1)
       embedded = F.relu(self.embedding(input))
       output, hidden = self.gru(embedded, hidden)
       prediction = self.softmax(self.out(output[0]))
       return prediction, hidden

class Seq2Seq(nn.Module):
   def __init__(self, encoder, decoder, device, MAX_LENGTH=MAX_LENGTH):
       super().__init__()

#initialize the encoder and decoder
       self.encoder = encoder
       self.decoder = decoder
       self.device = device

   def forward(self, source, target, teacher_forcing_ratio=0.5):
       input_length = source.size(0) #get the input length (number of words in sentence)
       batch_size = target.shape[1]
       target_length = target.shape[0]
       vocab_size = self.decoder.output_dim

#initialize a variable to hold the predicted outputs
       outputs = torch.zeros(target_length, batch_size, vocab_size).to(self.device)

#encode every word in a sentence
       for i in range(input_length):
           encoder_output, encoder_hidden = self.encoder(source[i])

#use the encoder's hidden layer as the decoder hidden
       decoder_hidden = encoder_hidden.to(device)

#add a token before the first predicted word
       decoder_input = torch.tensor([SOS_token], device=device)  # SOS

#topk is used to get the top K value over a list
#predict the output word from the current target word. If we enable the teaching force, then the next decoder input is the next word, else, use the decoder output highest value.
       for t in range(target_length):
           decoder_output, decoder_hidden = self.decoder(decoder_input, decoder_hidden)
           outputs[t] = decoder_output
           teacher_force = random.random() < teacher_forcing_ratio
           topv, topi = decoder_output.topk(1)
           input = (target[t] if teacher_force else topi)
           if(teacher_force == False and input.item() == EOS_token):
               break

       return outputs
الخطوة 3) تدريب النموذج
تبدأ عملية التدريب في نماذج Seq2seq بتحويل كل زوج من الجمل إلى موترات من فهرس لانغ الخاص بها. سيستخدم نموذجنا من تسلسل إلى تسلسل خوارزمية التدرج العشوائي (SGD) كمُحسِّن ودالة NLLLoss لحساب الخسائر. تبدأ عملية التدريب بتغذية النموذج بزوج من الجمل للتنبؤ بالمخرجات الصحيحة. في كل خطوة، تُحسب مخرجات النموذج باستخدام الكلمات الصحيحة لإيجاد الخسائر وتحديث المعلمات. وبما أنك ستستخدم 75000 تكرار، فسيولد نموذجنا من تسلسل إلى تسلسل 75000 زوجًا عشوائيًا من مجموعة البيانات.
teacher_forcing_ratio = 0.5

def clacModel(model, input_tensor, target_tensor, model_optimizer, criterion):
   model_optimizer.zero_grad()

   input_length = input_tensor.size(0)
   loss = 0
   epoch_loss = 0
   # print(input_tensor.shape)

   output = model(input_tensor, target_tensor)

   num_iter = output.size(0)
   print(num_iter)

#calculate the loss from a predicted sentence with the expected result
   for ot in range(num_iter):
       loss += criterion(output[ot], target_tensor[ot])

   loss.backward()
   model_optimizer.step()
   epoch_loss = loss.item() / num_iter

   return epoch_loss

def trainModel(model, source, target, pairs, num_iteration=20000):
   model.train()

   optimizer = optim.SGD(model.parameters(), lr=0.01)
   criterion = nn.NLLLoss()
   total_loss_iterations = 0

   training_pairs = [tensorsFromPair(source, target, random.choice(pairs))
                     for i in range(num_iteration)]

   for iter in range(1, num_iteration+1):
       training_pair = training_pairs[iter - 1]
       input_tensor = training_pair[0]
       target_tensor = training_pair[1]

       loss = clacModel(model, input_tensor, target_tensor, optimizer, criterion)

       total_loss_iterations += loss

       if iter % 5000 == 0:
           avarage_loss= total_loss_iterations / 5000
           total_loss_iterations = 0
           print('%d %.4f' % (iter, avarage_loss))

   torch.save(model.state_dict(), 'mytraining.pt')
   return model
الخطوة 4) اختبار النموذج
عملية تقييم Seq2seq PyTorتتمثل مهمة هذه الخطوة في التحقق من مخرجات النموذج. سيتم إدخال كل زوج من نماذج التسلسل إلى التسلسل إلى النموذج لتوليد الكلمات المتوقعة. بعد ذلك، ستنظر إلى أعلى قيمة في كل مخرج للعثور على الفهرس الصحيح. وفي النهاية، ستقارن ذلك لمعرفة مدى تطابق تنبؤ نموذجنا مع الجملة الصحيحة.
def evaluate(model, input_lang, output_lang, sentences, max_length=MAX_LENGTH): with torch.no_grad(): input_tensor = tensorFromSentence(input_lang, sentences[0]) output_tensor = tensorFromSentence(output_lang, sentences[1]) decoded_words = [] output = model(input_tensor, output_tensor) # print(output_tensor) for ot in range(output.size(0)): topv, topi = output[ot].topk(1) # print(topi) if topi[0].item() == EOS_token: decoded_words.append('' ) break else: decoded_words.append(output_lang.index2word[topi[0].item()]) return decoded_words def evaluateRandomly(model, source, target, pairs, n=10): for i in range(n): pair = random.choice(pairs) print('source {}'.format(pair[0])) print('target {}'.format(pair[1])) output_words = evaluate(model, source, target, pair) output_sentence = ' '.join(output_words) print('predicted {}'.format(output_sentence))
والآن، لنبدأ تدريبنا باستخدام Seq to Seq، مع عدد التكرارات 75000 وعدد طبقات RNN 1 مع حجم مخفي 512.
lang1 = 'eng'
lang2 = 'ind'
source, target, pairs = process_data(lang1, lang2)

randomize = random.choice(pairs)
print('random sentence {}'.format(randomize))

#print number of words
input_size = source.n_words
output_size = target.n_words
print('Input : {} Output : {}'.format(input_size, output_size))

embed_size = 256
hidden_size = 512
num_layers = 1
num_iteration = 100000

#create encoder-decoder model
encoder = Encoder(input_size, hidden_size, embed_size, num_layers)
decoder = Decoder(output_size, hidden_size, embed_size, num_layers)

model = Seq2Seq(encoder, decoder, device).to(device)

#print model
print(encoder)
print(decoder)

model = trainModel(model, source, target, pairs, num_iteration)
evaluateRandomly(model, source, target, pairs)
كما ترون، الجملة المتوقعة لدينا ليست متطابقة بشكل جيد، لذلك من أجل الحصول على دقة أعلى، تحتاج إلى التدريب باستخدام المزيد من البيانات ومحاولة إضافة المزيد من التكرارات وعدد الطبقات باستخدام التعلم التسلسلي للتسلسل.
random sentence ['tom is finishing his work', 'tom sedang menyelesaikan pekerjaannya']
Input : 3551 Output : 4253
Encoder(
  (embedding): Embedding(3551, 256)
  (gru): GRU(256, 512)
)
Decoder(
  (embedding): Embedding(4253, 256)
  (gru): GRU(256, 512)
  (out): Linear(in_features=512, out_features=4253, bias=True)
  (softmax): LogSoftmax()
)
5000 4.0906
10000 3.9129
15000 3.8171
20000 3.8369
25000 3.8199
30000 3.7957
75000 3.7044
