
创建并删除索引 Cassandra
 编辑团队
Cassandra 创建索引
命令“创建索引”在用户指定的列上创建索引。如果要索引的列的数据已经存在, Cassandra 在“create index”语句执行期间对数据创建索引。
- 创建索引后, Cassandra 当插入数据时自动索引新数据。
- 无法在主键上创建索引,因为主键已被索引。
- 支持对集合列创建索引,根据需要搜索的内容,可以使用 KEYS、VALUES 或 ENTRIES 形式。
- 如果未对列建立索引, Cassandra 除非该列是主键,否则无法对其进行筛选。
这就是为什么需要对列进行筛选的原因 Cassandra需要创建索引。
句法
CREATE INDEX IndexName ON KeyspaceName.TableName (ColumnName);
例如:
以下是尝试过滤“dept”列而不创建索引的快照。结果返回了错误。

这是在 dept 列上创建索引的快照。

CREATE INDEX DeptIndex ON University.Student (dept);
这是成功过滤“dept”列的快照。

SELECT * FROM University.Student WHERE dept = 'CS';
索引名称是可选的。省略索引名称会…… Cassandra 自动生成一个索引,这在以后需要删除索引时很重要。
CREATE INDEX IF NOT EXISTS ON University.Student (dept);
Cassandra 删除索引
命令“Drop index”删除指定索引。如果在创建索引时未指定索引名称,则索引名称为 TableName_ColumnName_idx。
- 如果索引不存在,它将返回错误,除非使用 IF EXISTS,否则将返回无操作。
- 必须将键空间名称与索引名称一起指定,否则将在当前键空间中查找索引。
句法
DROP INDEX IF EXISTS KeyspaceName.IndexName;
例如:
这是执行命令“Drop index”的快照,该命令删除了索引 DeptIndex。
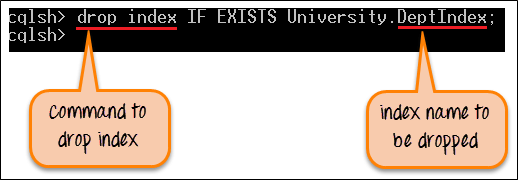
DROP INDEX IF EXISTS University.DeptIndex;
命令执行成功后,DeptIndex 将从键空间中删除。现在无法按列 dept 过滤数据。
在删除之前确认哪些索引存在。ping 第一,描述表格并阅读输出底部的索引定义。
DESCRIBE TABLE University.Student;
索引类型 Cassandra
上面的命令创建了一个标准的二级索引,但实际上存在三种不同的机制,它们的行为也截然不同。
| 类型 | 它是如何运行的? | 最适合 |
|---|---|---|
| 二级索引 | 每个节点只索引自己的本地数据,因此没有分区键的查询必须联系每个节点。 | 与分区键一起查询中等基数列。 |
| SASI指数 | 附加索引支持 LIKE 前缀和后缀匹配以及数值范围。 | 文本搜索模式。目前仍处于实验阶段,请在正式使用前进行测试。 |
| 存储附加索引 (SAI) | 介绍 Cassandra 5.0,跨列共享一个索引结构,写入开销更低。 | 以上两者的现代替代品是…… Cassandra 5 个集群。 |
对集合列进行索引时,会使用修饰符来指定要索引的部分。
CREATE INDEX ON University.Teacher (VALUES(Email));
CREATE INDEX ON University.Course (KEYS(prereq));
CREATE INDEX ON University.Course (ENTRIES(prereq));
VALUES 用于搜索集合或列表中的元素,KEYS 用于搜索映射键,ENTRIES 用于匹配键值对。集合索引将在后续章节中详细介绍。 Cassandra 收藏 教程。
何时不应使用索引 Cassandra
辅助索引虽然方便,但它并非关系索引,在错误的位置使用辅助索引是导致集群运行缓慢的常见原因。以下四种情况需要采用不同的方法。
- 基数非常高。 对接近唯一值的内容(例如电子邮件地址)进行索引,意味着几乎每个分区都包含一个匹配的行,因此查询会遍历整个集群以返回单个记录。
- 基数非常低。 对像 active 或 inactive 这样的双值标志进行索引会产生巨大的索引分区,读取一个分区会返回半个表。
- 经常更新的专栏。 每次更改都会写入一个索引条目和一个旧条目的墓碑,因此墓碑的积累会随着时间的推移降低读取性能。
- 没有分区键的查询。 如果没有协调器,协调器必须联系每个节点并合并结果,随着节点的增加,这种方法无法扩展。
更持久的替代方案是创建第二个表,该表以需要搜索的列为键,并与第一个表同时写入。这遵循了查询优先原则,如前所述。 Cassandra 数据模型规则它将每次读取操作都保存在单个节点上的单个分区中。
一般来说,索引适用于基数适中的列,并且该列需要与已知的分区键一起查询。超出此范围的情况,最好使用专门创建的表。
