
图的邻接表和矩阵表示
 陈莎拉
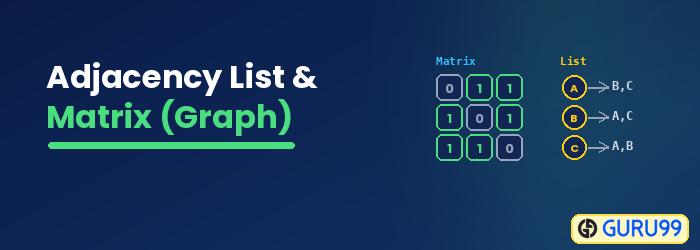
尽管它们看起来不同, 图形类型 可以用类似的方式表示。图表示法通常有两种类型:
- 邻接矩阵
- 邻接表
邻接表
邻接表由链表组成。每个顶点都被视为一个数组索引,每个元素代表一个链表。这些链表包含与索引顶点共享一条边的所有顶点。
以下是一个邻接表的示例:

设一个图包含 V 个顶点和 E 条边。邻接表的空间复杂度为 O(N)。 O(V + E)该值与实际边的数量成正比,而不是与每对可能的顶点成正比。
最坏情况下的空间复杂度变为 O(V²) 如果给定的图是完全图,因为每个顶点都与其他每个顶点相连。
邻接矩阵
邻接矩阵由一个二维数组构成。对于一个有 V 个顶点的图,矩阵的大小为 V × V.
说 matrix[i][j] = 5这意味着节点 i 和节点 j 之间存在一条边,权重为 5。
让我们来看一下下面的图及其邻接矩阵:

我们建立了 二维阵列 使用这些步骤:
步骤1) 顶点 A 与 B 有一条直接边,权重为 5。因此,A 行 B 列的单元格将被填充 5。A 行的其余单元格将被填充 0。
步骤2) 顶点 B 与 C 有一条直接边,权重为 4。因此,B 行 C 列的单元格将被填充 4。B 行的其余单元格将被填充 0,因为 B 没有与其他任何节点的出边。
步骤3) 顶点 C 与其他任何顶点都没有直接边。因此,第 C 行将填充零。
步骤4) 顶点 D 与 A 和 C 有一条有向边。
- D 行 A 列的单元格值为 7。D 行 C 列的单元格值为 2。
- D 行的其余单元格将用零填充。
步骤5) 顶点 E 与 B 和 D 有一条有向边。E 行 B 列的单元格值为 6。E 行 D 列的单元格值为 3。E 行的其余单元格将填充为零。
以下是需要注意的几点:
- 当邻接矩阵的主对角线元素为 0 时,该图没有自环。
- 如果点 (a, b) 和 (b, a) 处的单元格值不同,则该图是有向图;否则,该图是无向图。
- 如果任何单元格的值大于 1,则该图为加权图。
邻接矩阵的主要问题在于它需要占用大量的空间。即使不存在的边也会在内存中分配单元格。
例如,如果一个图有 100 个节点,那么就需要 10,000 个单元格来存储它。 内存图中的边数较少时,分配如此大的内存可能会造成浪费。因此,使用邻接矩阵的空间复杂度为 O(N²)其中 N 是图中的节点数。
邻接表与邻接矩阵
在选择表示方法之前,最好将两种模型在实际图工作负载的主要操作上进行并排比较:
| 操作 | 邻接矩阵 | 邻接表 |
|---|---|---|
| 空间复杂度 | O(V²) | O(V + E) |
| 添加一个顶点 | O(V²) | O(1) |
| 添加边缘 | O(1) | O(1) |
| 去除边缘 | O(1) | 欧氏距离 |
| 检查边 (i, j) 是否存在 | O(1) | O(i 的度) |
| 遍历 i 的邻居 | (V) | O(i 的度) |
| 最适合 | 稠密图,频繁的边查询 | 稀疏图,遍历密集型任务 |
简而言之,邻接矩阵在常数时间边查找方面胜出,而邻接表在内存和邻居迭代方面胜出,这就是为什么 BFS、DFS 和 Dijkstra 等算法通常与邻接表配合使用的原因。
图表示法的优点和缺点
每种表示方法都有其自身的优缺点。了解两种模型的优势和劣势有助于你为正在解决的问题选择合适的模型。
邻接矩阵的优点:
- 常数时间 O(1) 的任意顶点对之间的边存在性查询。
- 固定索引使得基于矩阵的算法(如 Floyd-Warshall 算法和传递闭包)易于实现。
- 加权边自然地契合在单个矩阵单元中。
邻接矩阵的缺点:
- 当图稀疏时,会浪费 O(V²) 内存。
- 添加新顶点需要调整整个矩阵的大小。
- 即使一个顶点只有几条边,遍历该顶点的邻居也需要 O(V) 的时间复杂度。
邻接表的优点:
- 仅使用 O(V + E) 内存,这接近稀疏图中的实际边数。
- 添加新顶点或边的时间复杂度为 O(1)。
- 诸如 BFS 和 DFS 之类的遍历算法以 O(度) 的速度迭代邻居,总运行时间为 O(V + E)。
邻接表的缺点:
- 检查特定边是否存在需要 O(度) 时间,而不是 O(1)。
- 由于链表分散在内存中,缓存局部性较弱。
- 加权边需要一个伴随字段或一个键值对列表,这稍微复杂化了数据结构。
何时使用邻接表,何时使用邻接矩阵
表示方法的选择取决于图的密度以及您最常执行的操作。请使用以下快速指南选择合适的结构:
- 优先选择邻接矩阵 当图很稠密(E 接近 V²),边很少变化,以及当你的算法多次询问“i 和 j 之间是否有边?”时。
- 优先使用邻接表 当图稀疏时(E 远小于 V²),当顶点集或边集在执行过程中增长时,以及当你使用 BFS、DFS 或其他算法遍历图时,都会出现问题。 迪杰斯特拉最短路径算法.
- 倾向于混合模式 (邻接表加上边的哈希集)当您需要快速的邻居迭代和 O(1) 的边查询时,需要额外的内存。
现代图库(如 NetworkX 和 igraph)默认使用邻接表,因为大多数现实世界的图(社交网络、路线图、网页、软件包依赖关系)都是稀疏的,并且遍历量很大。
