
البرنامج التعليمي لـ Hive Join & SubQuery مع أمثلة
 فريق التحرير
⚡ ملخص ذكي
تجمع عمليات الربط في Hive الصفوف من جدولين أو أكثر بناءً على عمود مطابق، وتقوم الاستعلامات الفرعية بتضمين استعلام واحد داخل استعلام آخر، لذلك يتم توضيح كليهما هنا على جدولين نموذجيين تم تحميلهما من ملفات نصية عادية.

انضم إلى الاستعلامات
يمكن إجراء استعلامات الربط على جدولين موجودين في خلية النحللفهم مفاهيم الربط بوضوح، نقوم بإنشاء جدولين هنا:
- sample_joins (المتعلقة بتفاصيل العميل)
- sample_joins1 (متعلقة بتفاصيل الطلبات التي يقدمها الموظفون)
الخطوة 1) إنشاء جدول "sample_joins" بأعمدة تحمل أسماء المعرف، والاسم، والعمر، والعنوان، والراتب للموظفين. تُظهر لقطة الشاشة أدناه عبارة CREATE TABLE وتأكيدها.

الخطوة 2) جارٍ تحميل البيانات وعرضها. تُظهر لقطة الشاشة التالية أمر التحميل متبوعًا بمحتويات الجدول.
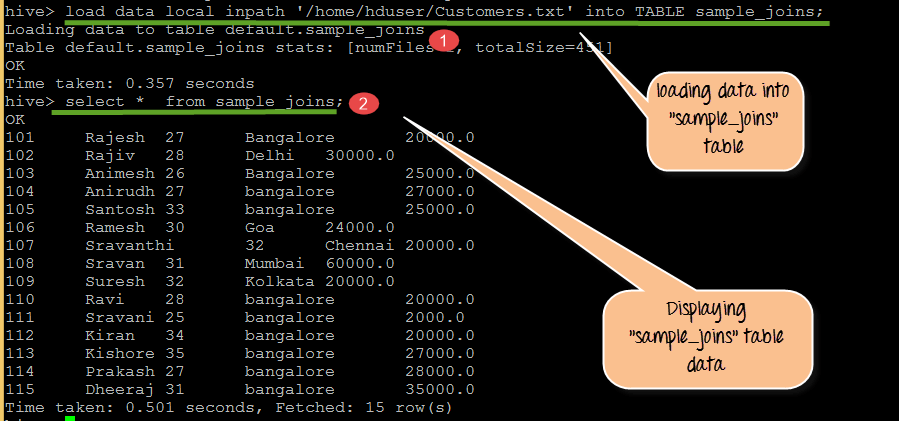
من لقطة الشاشة أعلاه:
- تحميل البيانات إلى Sample_joins من Customers.txt
- عرض محتويات الجدول Sample_joins
الخطوة 3) إنشاء جدول sample_joins1، ثم تحميل وعرض بياناته، كما هو موضح في لقطة الشاشة أدناه.

من لقطة الشاشة أعلاه، يمكننا ملاحظة ما يلي:
- إنشاء جدول sample_joins1 بالأعمدة التالية: Orderid و Date1 و Id و Amount
- تحميل البيانات إلى Sample_joins1 من Orders.txt
- عرض السجلات الموجودة في Sample_joins1
سنتناول فيما يلي أنواع الربط المختلفة التي يمكن إجراؤها على الجداول التي أنشأناها. قبل ذلك، يجب مراعاة النقاط التالية المتعلقة بالربط.
بعض النقاط التي يجب مراعاتها في عمليات الربط:
- لا يُسمح إلا بعمليات الربط القائمة على المساواة في عمليات الربط.
- يمكن ضم أكثر من جدولين في نفس الاستعلام
- توجد عمليات الربط الخارجي الأيسر والأيمن والكامل لتوفير مزيد من التحكم في عبارة ON التي لا يوجد لها تطابق
- عمليات الربط ليست تبادلية
- تكون الصلات ترابطية يسارية بغض النظر عما إذا كانت صلات يسارية أو يمينية
يعكس شرط المساواة في Hive الوضع الذي كان عليه لسنوات عديدة. بدءًا من Hive 2.2.0، أصبح بالإمكان استخدام تعابير معقدة في عبارة ON (HIVE-15211)، لذا يُقبل شرط عدم المساواة في الإصدارات الحالية. أما في الإصدارات الأقدم، فيجب أن يكون الشرط اختبارًا للمساواة، مع نقل أي شرط آخر إلى عبارة WHERE.
نوع مختلف من الصلات
توجد أربعة أنواع من الوصلات. وهي:
- صلة داخلية
- ترك صلة خارجية
- الصلة الخارجية اليمنى
- صلة خارجية كاملة
يتم توضيح كل نوع أدناه مقابل نفس الجدولين، لذا فإن الشيء الوحيد الذي يتغير بين الأمثلة هو الصفوف غير المتطابقة التي تبقى.
صلة داخلية
سيتم استرجاع السجلات المشتركة بين الجدولين من خلال هذا الربط الداخلي. تحتوي النتيجة في لقطة الشاشة أدناه على العملاء الذين لديهم طلب مطابق فقط.

من لقطة الشاشة أعلاه، يمكننا ملاحظة ما يلي:
- هنا نقوم بتنفيذ استعلام ربط باستخدام الكلمة المفتاحية JOIN بين الجدولين sample_joins و sample_joins1، مع شرط المطابقة (c.Id = o.Id).
- يعرض الناتج السجلات المشتركة الموجودة في كلا الجدولين، والتي تم تحديدها عن طريق التحقق من الشرط المذكور في الاستعلام.
الاستعلام:
SELECT c.Id, c.Name, c.Age, o.Amount FROM sample_joins c JOIN sample_joins1 o ON(c.Id=o.Id);
ترك صلة خارجية
- خلية تُعيد عملية الربط الخارجي الأيسر (LEFT OUTER JOIN) جميع الصفوف من الجدول الأيسر حتى لو لم تكن هناك أي تطابقات في الجدول الأيمن.
- إذا لم تتطابق عبارة ON مع أي سجلات في الجدول الصحيح، فإن عملية الربط ستُرجع سجلاً في النتيجة يحتوي على قيمة NULL في كل عمود من الجدول الصحيح.
تُظهر لقطة الشاشة أدناه ظهور جميع العملاء، بما في ذلك أولئك الذين ليس لديهم طلب.

من لقطة الشاشة أعلاه، يمكننا ملاحظة ما يلي:
- هنا نقوم بتنفيذ استعلام ربط باستخدام الكلمة المفتاحية "LEFT OUTER JOIN" بين الجدولين sample_joins و sample_joins1، مع شرط المطابقة (c.Id = o.Id). على سبيل المثال، نستخدم هنا معرّف الموظف كمرجع؛ حيث يتحقق الاستعلام مما إذا كان المعرّف مشتركًا بين الجدول الأيمن والجدول الأيسر. وهو بمثابة شرط المطابقة.
- يعرض الناتج السجلات المختارة وفقًا للشرط المذكور في الاستعلام. القيم الفارغة (NULL) في الناتج أعلاه هي أعمدة لا تحتوي على قيم من الجدول الصحيح، أي sample_joins1.
الاستعلام:
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c LEFT OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
حق الانضمام الخارجي
- تُعيد عملية الربط الخارجي الأيمن في HiveQL جميع الصفوف من الجدول الأيمن حتى لو لم تكن هناك أي تطابقات في الجدول الأيسر.
- إذا لم تتطابق عبارة ON مع أي سجلات في الجدول الأيسر، فإن عملية الربط ستُرجع سجلاً في النتيجة يحتوي على قيمة NULL في كل عمود من الجدول الأيسر.
- تُعيد عمليات الربط من نوع RIGHT دائمًا سجلات من الجدول الأيمن وسجلات مطابقة من الجدول الأيسر. إذا لم يكن للجدول الأيسر قيمة مقابلة للعمود، فستُعيد العملية قيمًا فارغة (NULL) في ذلك الموضع.
تُظهر لقطة الشاشة أدناه صورة معكوسة للنتيجة السابقة: كل طلب يظهر، سواء كان مطابقًا أم لا.

من لقطة الشاشة أعلاه، يمكننا ملاحظة ما يلي:
- هنا نقوم بتنفيذ استعلام ربط باستخدام الكلمة المفتاحية "RIGHT OUTER JOIN" بين الجدولين sample_joins و sample_joins1، مع شرط المطابقة (c.Id = o.Id).
- يعرض الناتج السجلات التي تم تحديدها عن طريق التحقق من الشرط المذكور في الاستعلام.
الاستعلام:
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c RIGHT OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
وصلة خارجية كاملة
يجمع هذا الاستعلام سجلات كل من الجدولين sample_joins و sample_joins1 بناءً على شرط JOIN المحدد في الاستعلام.
يقوم بإرجاع جميع السجلات من كلا الجدولين ويملأ القيم الفارغة للأعمدة التي تكون قيمها المطابقة مفقودة على أي من الجانبين، كما توضح لقطة الشاشة أدناه.

من لقطة الشاشة أعلاه، يمكننا ملاحظة ما يلي:
- هنا نقوم بتنفيذ استعلام ربط باستخدام الكلمة المفتاحية "FULL OUTER JOIN" بين الجدولين sample_joins و sample_joins1، مع شرط المطابقة (c.Id = o.Id).
- يعرض الناتج جميع السجلات الموجودة في كلا الجدولين، والتي تم اختيارها بناءً على الشرط المذكور في الاستعلام. تشير القيم الفارغة (NULL) في الناتج هنا إلى القيم المفقودة من أعمدة كلا الجدولين.
الاستعلام:
SELECT c.Id, c.Name, o.Amount, o.Date1 FROM sample_joins c FULL OUTER JOIN sample_joins1 o ON(c.Id=o.Id)
الاستعلامات الفرعية
تُتيح عمليات الربط وضع الجداول جنبًا إلى جنب. أما الاستعلام الفرعي فيقوم بشيء مختلف: فهو يُضمّن استعلامًا داخل استعلام آخر بحيث يمكن للاستعلام الخارجي العمل بناءً على نتيجة تم حسابها مسبقًا.
يُعرف الاستعلام الموجود داخل استعلام آخر بالاستعلام الفرعي. ويعتمد الاستعلام الرئيسي على القيم التي يُرجعها الاستعلام الفرعي.
يمكن تصنيف الاستعلامات الفرعية إلى نوعين:
- الاستعلامات الفرعية في عبارة FROM
- الاستعلامات الفرعية في جملة WHERE
متى يجب استخدام:
- للحصول على قيمة معينة مدمجة من قيمتي عمود من جداول مختلفة
- اعتماد قيم جدول واحد على جداول أخرى
- التحقق المقارن لقيم عمود واحد مقابل الجداول الأخرى
بناء الجملة:
Subquery in FROM clause
SELECT <column names 1, 2…n>From (SubQuery) <TableName_Main >
Subquery in WHERE clause
SELECT <column names 1, 2…n> From<TableName_Main>WHERE col1 IN (SubQuery);
على سبيل المثال:
SELECT col1 FROM (SELECT a+b AS col1 FROM t1) t2
هنا، t1 و t2 هما اسما جدولين. العبارة الداخلية هي الاستعلام الفرعي المُنفَّذ على الجدول t1. أما a و b فهما عمودان يُضافان في الاستعلام الفرعي ويُسندان إلى العمود col1. قيمة العمود col1 هي القيمة الموجودة في الجدول الرئيسي. هذا العمود "col1" الموجود في الاستعلام الفرعي يُعادل قيمة العمود col1 في استعلام الجدول الرئيسي.
تضمين البرامج النصية المخصصة
عندما يقوم استعلام فرعي بإعادة تشكيل البيانات باستخدام HiveQL فقط، يقوم نص برمجي مضمن بتسليم الصفوف إلى التعليمات البرمجية المكتوبة خارج Hive.
يُتيح Hive إمكانية كتابة برامج نصية مُخصصة لتلبية متطلبات العملاء. يستطيع المستخدمون كتابة برامجهم النصية الخاصة بعمليات الخرائط والاختزال لتلبية تلك المتطلبات. تُسمى هذه البرامج النصية المُدمجة المُخصصة. يتم تعريف منطق البرمجة في البرنامج النصي المُخصص، ويمكننا استخدامه أثناء عملية استخراج البيانات وتحويلها وتحميلها (ETL).
متى يتم اختيار البرامج النصية المضمنة؟
- حيث تعني المتطلبات الخاصة بالعميل أن على المطورين كتابة ونشر البرامج النصية في Hive
- حيث لا تعمل وظائف Hive المدمجة مع متطلبات مجال محددة
لهذا الغرض، يستخدم Hive عبارة TRANSFORM لتضمين كل من نصوص الخرائط والاختزال.
في هذه البرامج النصية المخصصة المضمنة، يجب علينا مراعاة النقاط التالية:
- سيتم تحويل الأعمدة إلى سلسلة نصية وفصلها بعلامة الجدولة قبل إرسالها إلى برنامج المستخدم النصي.
- سيتم التعامل مع المخرجات القياسية لبرنامج المستخدم النصي كأعمدة نصية مفصولة بعلامات الجدولة.
نموذج نص برمجي مضمن:
FROM (
	FROM pv_users
	MAP pv_users.userid, pv_users.date
	USING 'map_script'
	AS dt, uid
	CLUSTER BY dt) map_output

INSERT OVERWRITE TABLE pv_users_reduced
	REDUCE map_output.dt, map_output.uid
	USING 'reduce_script'
	AS date, count;
من النص البرمجي أعلاه، يمكننا ملاحظة ما يلي. هذا مجرد نص برمجي نموذجي للفهم.
- pv_users هو جدول المستخدمين، والذي يحتوي على حقول مثل معرف المستخدم والتاريخ كما هو مذكور في map_script
- يتم تعريف نص الاختزال بناءً على التاريخ وعدد المستخدمين في جدول pv_users
