
Hive ETL: تحميل أمثلة بيانات JSON وXML والنص
 فريق التحرير
⚡ ملخص ذكي
يقوم Hive ETL بتحويل ملفات النصوص وملفات XML وملفات JSON إلى جداول قابلة للاستعلام عن طريق تحميلها إلى Hive واستخراجهاtracالقيم باستخدام xpath() و get_json_object()، مما يمنح المحللين واجهة SQL على بيانات Hadoop شبه المهيكلة.
Hive كأداة ETL وتخزين البيانات على رأس Hadoop يوفر النظام البيئي وظائف مثل نمذجة البيانات، ومعالجة البيانات، ومعالجتها، والاستعلام عنها.tracيشير مصطلح "tion" في Hive إلى إنشاء الجداول في Hive وتحميل البيانات المهيكلة وشبه المهيكلة بالإضافة إلى الاستعلام عن البيانات بناءً على المتطلبات.
لمعالجة البيانات على دفعات، سنكتب نصوصًا برمجية مخصصة باستخدام نصوص برمجية مخصصة للخرائط والاختزال في لغة برمجة نصية. وهذا يوفر SQL مثل البيئة ودعم الاستعلام السهل.
العمل مع البيانات المنظمة باستخدام الخلية
البيانات المنظمة تعني أن البيانات تأتي بتنسيق صحيح من صفوف وأعمدة. وهذا أشبه بـ RDBMS البيانات مع الصفوف والأعمدة المناسبة.
سنقوم هنا بتحميل البيانات المنظمة الموجودة في ملفات نصية في Hive.
الخطوة 1) في هذه الخطوة نقوم بإنشاء جدول "employees_guru" بأسماء الأعمدة مثل المعرف والاسم والعمر والعنوان والرواتب وقسم الموظفين مع أنواع البيانات.

من لقطة الشاشة أعلاه، يمكننا ملاحظة ما يلي:
- إنشاء جدول "employees_guru"
- جارٍ تحميل البيانات من ملف Employees.txt إلى جدول "employees_guru"
الخطوة 2) في هذه الخطوة، نعرض المحتويات المخزنة في هذا الجدول باستخدام أمر "تحديد". يمكننا ملاحظة محتويات الجدول في لقطة الشاشة التالية.

مقتطف من نموذج التعليمات البرمجية
الاستعلامات المطلوب تنفيذها
1) Create table employees_guru(Id INT, Name STRING, Age INT, Address STRING, Salary FLOAT, Department STRING)
> Row format delimited
> Fields terminated by ',';
2) load data local inpath '/home/hduser/Employees.txt' into TABLE employees_guru;
3) select * from employees_guru;
العمل مع البيانات شبه المهيكلة باستخدام Hive (XML، JSON)
يؤدي Hive وظائف ETL في نظام Hadoop البيئي من خلال العمل كـ أداة ETLقد يكون من الصعب تنفيذ MapReduce في بعض أنواع التطبيقات؛ يمكن لـ Hive تقليل هذا التعقيد وتوفير أفضل حل لتطبيقات تكنولوجيا المعلومات من حيث قطاع تخزين البيانات.
يمكن معالجة البيانات شبه المهيكلة، مثل XML وJSON، بسهولة أكبر باستخدام Hive. سنستعرض أولاً كيفية استخدام Hive لـ XML.
جدول XML إلى Hive
في هذا، سنقوم بتحميل بيانات XML إلى جداول الخلية، وسنجلب القيم المخزنة داخل علامات XML.
الخطوة 1) إنشاء جدول "xmlsample_guru" مع عمود من نوع بيانات السلسلة النصية.

من لقطة الشاشة أعلاه، يمكننا ملاحظة ما يلي:
- إنشاء الجدول "xmlsample_guru"
- جارٍ تحميل البيانات من ملف test.xml إلى الجدول "xmlsample_guru"
الخطوة 2) باستخدام كسباث باستخدام الطريقة xpath()، سنتمكن من جلب البيانات المخزنة داخل علامات XML.
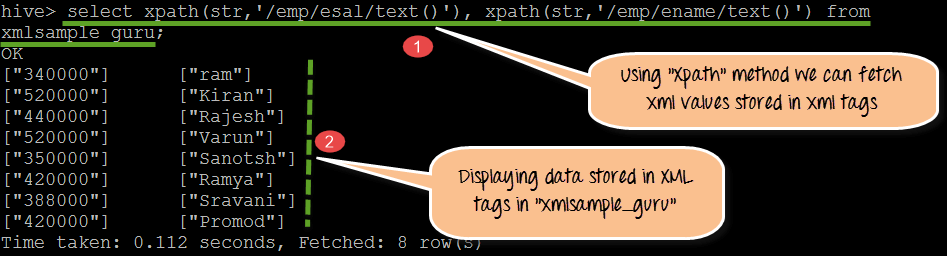
من لقطة الشاشة أعلاه، يمكننا ملاحظة ما يلي:
- باستخدام طريقة xpath()، نقوم بجلب القيم المخزنة تحت /emp/esal/ و /emp/ename/
- القيم الموجودة داخل وسوم XML. في هذه الخطوة، نعرض القيم الفعلية المخزنة ضمن وسوم XML في الجدول "xmlsample_guru".
لاحظ أن xpath() تُرجع مصفوفة من السلاسل النصية؛ xpath_string() و xpath_int() و xpath_double() تُرجع قيمة واحدة من نوع محدد.
الخطوة 3) في هذه الخطوة، سنقوم بجلب وعرض ملف XML الخام للجدول "xmlsample_guru".

من لقطة الشاشة أعلاه، يمكننا ملاحظة ما يلي:
- يتم عرض بيانات XML الفعلية مع العلامات
- إذا لاحظنا علامة واحدة، فستكون مع "emp" كعلامة رئيسية مع "ename" و "esal" كعلامات فرعية.
Code مقتطف:
الاستعلامات المطلوب تنفيذها
1) create table xmlsample_guru(str string);                                                                                                   2) load data local inpath '/home/hduser/test.xml' overwrite  into table xmlsample_guru;
3) select xpath(str,'emp/ename/text()'), xpath(str,'emp/esal/text()') from xmlsample_guru;
جسون (Javaتدوين كائنات النص
تُخزَّن بيانات مواقع التواصل الاجتماعي والمواقع الإلكترونية عادةً بصيغة JSON. عند محاولة جلب البيانات من الخوادم الإلكترونية، تُعاد ملفات JSON. باستخدام Hive كمخزن بيانات، يُمكننا تحميل بيانات JSON إلى جداول Hive عبر إنشاء مخططات.
JSON إلى جدول Hive
في هذا، سنقوم بتحميل بيانات JSON إلى جداول Hive، وسنقوم بجلب القيم المخزنة في مخطط JSON.
الخطوة 1) في هذه الخطوة، سنقوم بإنشاء جدول JSON باسم "json_guru". بعد إنشائه، سنقوم بتحميل وعرض محتويات المخطط الفعلي.

من لقطة الشاشة أعلاه، يمكننا ملاحظة ما يلي:
- إنشاء الجدول "json_guru"
- جارٍ تحميل البيانات من ملف test.json إلى الجدول "json_guru"
- عرض المخطط الفعلي لملف JSON المخزن في جدول json_guru
الخطوة 2) باستخدام طريقة get_json_object() يمكننا جلب قيم البيانات المخزنة في التسلسل الهرمي JSON.

من لقطة الشاشة أعلاه، يمكننا ملاحظة ما يلي:
- باستخدام الدالة get_json_object(str,'$.ecode')، يمكن استرجاع قيم ecode من جدول json_guru. وبالمثل، باستخدام الدالتين get_json_object(str,'$.ename') و get_json_object(str,'$.sal')، سيتم استرجاع قيم ename و sal من جدول json_guru.
- القيم المخزنة داخل التسلسل الهرمي لـ JSON في json_guru
لأن get_json_object() يقوم بتحليل المستند مرة واحدة لكل استدعاء، فإن json_tuple() يكون أرخص عندما تكون هناك حاجة إلى عدة مفاتيح، ويقوم JSON SerDe بربط المستند بالأعمدة المكتوبة في وقت التحميل.
Code قصاصة
الاستعلامات المطلوب تنفيذها
1) create table json_guru(str string);
2) load data inpath 'home/hduser/test.json' into table json_guru;
3) select * from json_guru;
4) select get_json_object(str,'$.ecode') as ecode, get_json_object(str,'$.ename') as ename ,get_json_object(str,'$.sal') as salary from json_guru;
تحويل بيانات JSON المعقدة إلى جدول Hive
في هذا، سنقوم بتحميل بيانات JSON المعقدة إلى جداول Hive، وسنقوم بجلب القيم المخزنة في مخطط JSON.
الخطوة 1) إنشاء complexjson_guru بحقل عمود واحد.

من لقطة الشاشة أعلاه، يمكننا ملاحظة ما يلي:
- إنشاء جدول complexjson_guru يحتوي على حقل عمود واحد من نوع بيانات نصية.
- تحميل البيانات إلى complexjson_guru من ملف emp.json المعقد بصيغة JSON
الخطوة 2) باستخدام get_json_object يمكننا استرداد المحتوى الفعلي المخزن داخل التسلسل الهرمي لملف JSON.
من خلال لقطة الشاشة التالية، يمكننا رؤية مخرجات البيانات المخزنة في complexjson_guru.
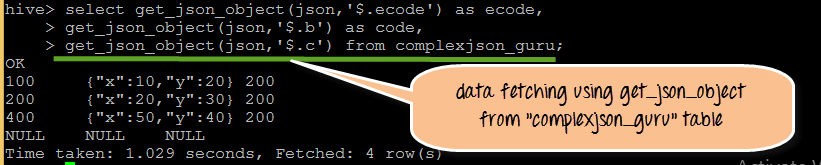
الخطوة 3) في هذه الخطوة، باستخدام أمر "Select" يمكننا رؤية بيانات JSON المعقدة المخزنة داخل الجدول "complexjson_guru".

مقتطف من نموذج التعليمات البرمجية
الاستعلامات المطلوب تنفيذها
1) create table complexjson_guru(json string);
2) load data inpath 'home/hduser/emp.json' into table complexjson_guru;
3) select get_json_object(json,'$.ecode') as ecode ,get_json_object(json,'$.b') as code, get_json_object(json,'$.c') from complexjson_guru;
4) select * from complexjson_guru;
هايف في المشاريع الآنية - متى وأين يُستخدم
متى وأين يُستخدم Hive في بيئة Hadoop؟
متى
- عند العمل مع وظائف إحصائية قوية وفعالة في بيئة هادوب
- عند العمل مع معالجة البيانات المنظمة وشبه المنظمة
- كأداة لتخزين البيانات مع هادوب
- استيعاب البيانات في الوقت الفعلي باستخدام HBase، حيث يمكن استخدام Hive
في
- لسهولة الاستخدام كأداة ETL وتخزين البيانات
- لتوفير بيئة شبيهة بـ SQL وللاستعلام مثل SQL باستخدام HiveQL
- استخدام ونشر نصوص برمجية مخصصة للخرائط والمُخفِّضات لتلبية متطلبات العميل المحددة
