
数据仓库建模中的星型模式是什么?
 编辑团队
什么是星型模式?
A 星型模式 数据仓库中的星型模式是一种建模结构,其中一个中心事实表连接到多个相关的维度表。它被称为星型模式,因为其布局类似于星星,事实表位于中心,维度表像星点一样向外辐射。
星型模式是数据仓库中最简单的模式,也称为星型连接模式。由于其维度表是非规范化的,因此该模型针对查询超大型数据集进行了优化,使其成为一种常见的选择。 维度建模 和报告。
什么是多维模式?
A 多维模式 专为数据仓库系统建模而设计。这些模式满足了为分析目的而构建的超大型数据库的独特需求。 OLAP 而不是用于日常交易处理。
数据仓库模式类型: 多维模式主要有三种类型,每一种都有其自身的优势。
- 星图 – 一个直接连接到非规范化维度表的中心事实表。
- 雪花模式 – 星型模式的扩展,其中维度被规范化为额外的子维度表。
- 星系图 – 也称为事实星座,它使用多个共享公共维度表的事实表。
由于雪花模式直接建立在星型模式之上,因此在详细学习星型模式示例之前,比较这两个模型会很有帮助。
星型模式与雪花模式
星形图和 雪花模式 两者都围绕事实表和维度表组织数据,但它们在维度的存储方式上有所不同。星型模式将每个维度保存在单个非规范化的表中,而雪花模式则将这些维度规范化到多个相关的表中。
- 结构体: 星形模式扁平而简单;雪花模式将维度分支成子维度。
- 查询速度: 星型模式需要的连接更少,因此查询通常运行速度更快,SQL 也更简单。
- 存储: Snowflake模式消除了冗余,因此占用空间更少,但增加了设计复杂性。
- 数据的完整性: 归一化的雪花维度能更好地保证完整性,而非归一化的星形维度则有利于性能。
- 易于使用: 星型模式更容易被分析人员理解和维护,而雪花型模式则需要更精心的设计。
在实践中,团队通常会为需要快速、直接报告的数据集市和仪表板选择星型模式,而当节省存储空间和严格一致性更为重要时,则会选择雪花模式。
星形图示例
在以下星型模式示例中,事实表位于中心,并保存每个维度表的键,例如 Dealer_ID、Model_ID、Date_ID、Product_ID 和 Branch_ID,以及可衡量的属性,例如销售数量和收入。
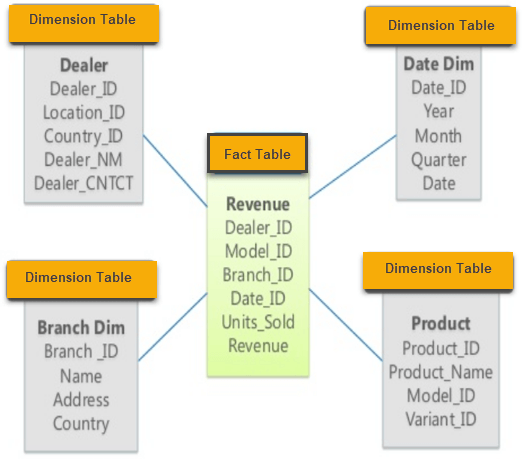
每个周围的维度表都为这些度量值添加了描述性上下文,因此单个查询可以按经销商、型号、日期、产品或分支机构对销售事实进行分组或筛选,而无需连接任何其他表。
事实表
星型模式中的事实表包含事实信息,并与维度表相连。事实表包含两种类型的列:
- 用于存储事实或指标的列。
- 链接到每个维度表的外键。
通常情况下,事实表的主键是一个复合键,由构成该表的所有外键组成。
事实表可以包含详细级别的事实,也可以包含汇总级别的事实。包含汇总事实的事实表通常称为汇总表,它们通常包含已经汇总到一定级别的事实。
尺寸表
维度是一种将数据按层次结构分类的结构。没有层次结构和级别的维度称为扁平维度或列表。每个维度表的主键都是事实表复合主键的一部分。
维度属性是描述性的文本属性,用于描述维度值,例如产品名称或城市。由于维度表存储的是这种描述性上下文,而不是事务事件,因此事实表通常比维度表大得多。
如何设计星型结构
星型模式的设计遵循 Ralph Kimball 推广的维度建模方法。其目标是围绕清晰、可重用的维度组织业务度量,从而使最终模型易于查询和快速生成报告。以下五个步骤概述了大多数维度建模项目遵循的流程,从最高层次的业务问题逐步深入到物理事实表和维度表。
- 确定业务流程: 选择您要分析的活动,例如销售、发货ping或者库存。此决策定义了事实表将衡量的内容。
- 申报粮食: 确定每行事实所代表的详细程度,例如每行代表一个商品项、每笔交易或每天。清晰的粒度有助于保持模型的一致性。
- 确定尺寸: 列出对事实进行切片所需的描述性上下文,例如产品、客户、经销商、分店和日期。每一项都将成为一个属性维度表。
- 找出事实: 确定企业想要的数值指标 track,例如销量、收入或成本,并将它们放入中央事实表中。
- 打造明星: 通过外键将事实表连接到每个维度表,保持ping 维度被非规范化,因此该图形成一个由维度包围的单一中心事实表。
构建好星型表之后,为每个维度添加代理键,确保每个事实表都关联一个日期维度,并确认所有事实表的粒度一致。此外,最好先加载原子性的、最低级别的数据,因为汇总表可以稍后生成。遵循这些规则可以优化模式,使其兼具高性能和简洁性。 数据仓库 报告。
星型模式的特点
- 星型模式中的每个维度都仅由一个维度表表示。
- 每个维度表都包含自己的一组属性。
- 维度表通过外键与事实表连接。
- 维度表之间没有连接。
- 事实表包含键和度量。
- 星型架构易于理解,并能实现最佳磁盘利用率。
- 维度表未规范化。例如,在上面的示例中,Country_ID 没有像其他维度表那样单独的 Country 查找表。 OLTP 设计将会。
- 该模式被众多商业智能工具广泛支持。
星型模式的优点
星型模式具有诸多优点,使其成为数据仓库设计的热门起点:
- 从高度规范化的事务数据源获取数据时,星型模式使用比其他模式更简单的连接逻辑。
- 星型模式简化了常见的业务报告逻辑,例如期间报告和截至报告。
- 星型模式被 OLAP 系统广泛用于高效构建多维数据集,并且在大多数主流 OLAP 系统中,星型模式可以作为数据源,而无需设计多维数据集结构。
- 通过启用可应用于查询的特定性能调优,查询处理器可以提供更好的执行计划。
星形图的缺点
- 由于模式高度非规范化,数据完整性没有得到严格执行。
- 它在满足高级分析需求方面不够灵活。
- 星型模式不会强化业务实体之间的多对多关系。
何时使用星形图
当快速、可预测的查询性能比节省存储空间更重要时,星型模式是理想之选。由于该模型保持维度表的非规范化状态,并减少了连接次数,因此非常适合业务用户需要反复对大量历史数据运行类似报表、仪表板和聚合操作的分析型工作负载。
星型模式非常适合的典型情况包括:
- 数据集市: 部门 数据集市 结构清晰易懂,关系简单明了。
- 商业智能仪表盘: 商业智能 工具可以清晰地映射到星型模式,因此可以快速构建报告和可视化效果。
- OLAP 多维数据集: 星型模式是 OLAP 多维数据集、聚合和切片分析的天然来源。
如果优先级转向最小化存储、严格的数据完整性或深度且不断变化的层级结构,那么雪花模式或更规范化的设计可能更合适。许多团队甚至将两者结合起来,从星型模式开始,然后仅对真正需要规范化的维度进行规范化。
