
SAP HANA Archi结构:数据库概述
 编辑团队
⚡ 智能摘要
SAP HANA Archi架构、景观和规模构成了基于 SUSE Linux 构建的内存数据平台的基础, C++本文解释了索引服务器、存储引擎、行存储和列存储、增量合并以及硬件容量规划方法。
什么是 SAP HANA数据库?
SAP HANA 是一个以主内存为中心的数据管理平台。该数据库运行在 SUSE Linux Enterprise Server (SLES) 上,并且 Red Hat Enterprise Linux (RHEL)是用以下语言编写的: C++它可以跨多台机器横向扩展,以应对非常大的工作负载。
主要优点 SAP 哈娜:
- 由于所有数据都加载到内存中,从而消除了关键路径上的缓慢磁盘 I/O,因此查询性能极快。
- 在同一数据库上混合使用 OLAP(联机分析处理)和 OLTP(联机事务处理),简化数据环境。
SAP HANA 数据库由一组内存处理引擎构建而成。计算引擎是主引擎,它与其他引擎交互,例如关系引擎(行存储和列存储)、OLAP 引擎、文本引擎和图引擎。关系表存储在行存储或列存储中,而其他引擎则在内存可用时处理文本和图数据。
SAP HANA Archi质地
列式存储中的数据采用字典编码、游程编码、稀疏编码、簇编码和间接编码等技术进行压缩。当达到主内存限制时,未使用的数据库对象(表、视图等)会自动卸载到磁盘,并在再次请求时重新加载。
管理员还可以通过右键单击表格来手动加载或卸载单个表格。 SAP HANA 工作室 并选择 卸下 or 载荷.
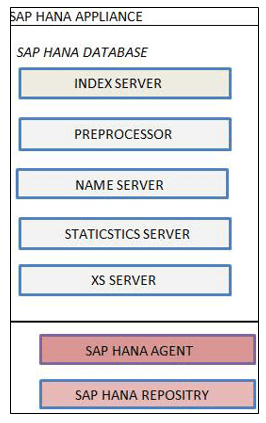
SAP HANA 服务器由以下部分组成:
- 索引服务器
- 预处理服务器
- 域名服务器
- 统计服务器
- XS 引擎
1. SAP HANA 索引服务器
索引服务器是主要 SAP HANA数据库组件:
- 它是……的核心 SAP HANA数据库引擎。
- 它包含实际的数据存储库和处理数据的引擎。
- 它执行传入的 SQL 和 MDX 语句。
索引服务器架构如下所示。

SAP HANA 索引服务器概述
- 会话和事务管理器: 会话组件管理数据库的连接和会话。事务管理器协调和控制所有事务。
- SQL 和 MDX 处理器: SQL处理器将查询发送到相应的引擎(SQL/SQL脚本/R/计算引擎)。MDX处理器处理多维查询(例如,针对分析视图的查询)。
- SQL / SQL 脚本 / R / 计算引擎: 对数据执行 SQL、SQL 脚本、R 和计算模型。
- 库: 维护版本控制 SAP HANA 元数据对象,例如属性视图、分析视图和存储过程。
- 持久层: 通过将保存点和日志写入磁盘上的数据卷,提供内置的灾难恢复功能。
2. 预处理器服务器
预处理器服务器由文本分析使用。它trac当调用搜索功能时,ts 会根据文本内容准备数据。
3. 名称服务器
名称服务器保存着整个系统环境的信息。在分布式部署中,它 tracks 获取每个运行组件以及跨节点的数据位置,以便将查询路由到正确的服务器。
4. 统计服务器
统计服务器收集以下各项的状态、资源分配、消耗和性能数据: SAP HANA 系统。注意:在 HANA SPS 7 及更高版本中,嵌入式统计服务在索引服务器内部运行,而不是作为独立进程运行。
5. XS 服务器
XS 服务器托管 XS 引擎,外部应用程序和开发人员可以使用该引擎。 SAP 通过 HTTP 协议访问 HANA 数据库。XS Engine 本身充当轻量级 HTTP 服务器,使基于浏览器和 REST 的客户端能够直接与 HANA 通信。
SAP HANA 景观
“HANA”代表 高性能分析设备 它以软硬件结合的平台形式交付。
- 现代硬件提供的 CPU 核心数、内存和存储带宽远远超过传统数据库服务器的设计用途。
- SAP HANA 通过 kee 来利用这一点ping 所有工作数据都存储在主内存中,消除了限制传统数据库的磁盘 I/O 瓶颈。
下图总结了…… SAP HANA硬件和软件创新。

SAP HANA 支持两种关系数据存储: 行存储 和 列存储.
行存储
行存储的行为类似于传统数据库(Oracle(SQL Server)。主要区别在于所有行都驻留在主内存中。 SAP HANA 将数据存储在磁盘上,而传统数据库则主要将数据存储在磁盘上。
列存储
列式存储以列的形式将数据保存在内存中。列式表存储于此,引擎会在良好的写入性能和优化的读取性能之间取得平衡。下图展示了实现这种平衡的两种结构。

主存
主存储器存储大部分数据。为了节省内存并加快搜索速度,采用了字典编码、聚类编码、稀疏编码和游程编码等压缩方法。
- 直接在主存储器中修改压缩数据成本很高,因此写入操作不会针对主存储器。
- 相反,所有更改都会写入一个名为“单独区域”的文件中。 Delta 存放读取操作可以访问主存储或增量存储。
可以使用以下方法手动加载或卸载数据: 加载到内存 和 从内存中卸载 以下列出一些选项。

Delta 存放
Delta 此存储针对写入进行了优化,并使用了较轻量的压缩。所有对列式表的未提交更改都保存在此处。当需要将更改合并回主存储时,请运行以下命令: Delta 合并 操作从 SAP HANA 工作室。

- 增量合并会将增量存储中收集的更改移动到主存储中。
- 合并后,新的主存储内容将持久化到磁盘,并重新计算压缩率。
数据如何流动 Delta 到主存储

行式缓冲区 L1-Delta 它位于每个列式表的前面,这就是为什么列式表可以承受高吞吐量写入的原因。
- 用户对表执行 UPDATE 或 INSERT 操作。
- 数据首先落在 L1 层。Delta (未提交的数据)。
- 一旦提交,数据就会移动到面向列的 L2 存储中。Delta 缓冲。
- 当 L2-Delta 如果主存储器已满或合并操作完成,则数据写入主存储器。
因此,列式存储既针对写入进行了优化(通过 L1 和 L2 增量缓存),也针对读取进行了优化(通过主存储)。处理完成后,数据由持久层持久化到磁盘。
行式表格示例:

同一个逻辑表在磁盘上的存储方式会因存储类型的不同而有所差异。在行存储中,行是连续写入的:

在列存储中,来自同一列的值存储在一起:

由于列值共享数据类型并且经常重复,因此列布局可以得到非常好的压缩——这是列存储的主要内存优势。

SAP HANA 大小
容量规划是指确定系统所需的硬件资源(内存、磁盘和 CPU)的过程。 SAP HANA系统。内存是最重要的因素,CPU次之,磁盘则由前两者衍生而来。
在一个 SAP 在 HANA 实施过程中,为业务工作负载选择合适的服务器规模是最关键的任务之一。与传统数据库管理系统 (DBMS) 相比,HANA 的规模调整主要体现在以下三个方面:
- 主内存: 受元数据以及内存中存储的大量事务和分析数据驱动。
- CPU: 采用估算而非测量的方式,根据预测查询和负载模式进行估算。
- 磁盘: 专为数据持久性和日志量而设计,不适用于在线查询数据。
与之前的数据库相比,应用服务器的 CPU 和内存保持不变,因为 HANA 只替换了数据库层。
SAP 提供了几种计算正确尺寸的方法:
- 使用 ABAP 报表(事务代码)进行尺寸计算 ST03 数据和报告 /SDF/HDB_SIZING).
- 使用数据库脚本对非 ABAP 系统进行容量规划。
- 使用尺寸 SAP 快速尺寸 上的工具 SAP 服务市场。
使用快速尺寸计算工具时,需求将以下列格式显示。

