
SAP HANA 中的 DS(数据服务)
 梅森·加西亚
⚡ 智能摘要
SAP 数据服务是企业级 ETL 平台,可将来自异构数据源的数据移动和清洗并导入到系统中。 SAP HANA 设计器、作业服务器、引擎、存储库和访问服务器协同工作,以构建、调度和运行数据流。
什么是 SAP 数据服务?
SAP 数据服务是一个 ETL 工具,它为来自异构源的数据集成、转换、数据质量、数据分析和文本数据处理提供了一个单一的企业级解决方案,并将数据导入到目标数据库或数据仓库中。
应用程序(称为作业)在设计器中创建,其中数据映射位于设计器中。ping 并定义了变换。该产品也称为 SAP BusinessObjects 数据服务,简称 SAP BODS,这两个名称指的都是同一种工具。 SAP 数据服务 4.3 是当前版本;4.2 版本已于 2023 年 5 月 31 日停止主流维护,因此新的部署应该从 4.3 开始。
在一个 SAP HANA 架构, SAP 当数据需要在导入过程中进行重塑,而不是直接复制时,数据服务是首选方案。以下各节将介绍该工具的功能、各部分如何协同工作,以及完整的工作负载示例。 SAP ECC表 SAP 花。
特点 SAP 数据服务
以下功能解释了原因 SAP 数据服务定位为企业级平台,而不是简单的复制工具。
- 它提供高性能并行转换。
- 它拥有全面的管理工具和报告工具。
- 它支持多用户。
- SAP 董事会 对基于Web服务的应用程序非常灵活。
- 它允许使用具有丰富函数集的脚本语言。
- SAP 数据服务可以集成 SAP LT复制服务器(SLT) 采用基于触发的技术。SLT 为每个组件添加了增量功能。 SAP 或非SAP 源表允许捕获变更数据并从源表传输增量数据。
- 使用仪表板和流程审计进行数据验证。
- 一款具备日程安排功能和监控仪表盘的管理工具。
- 调试、内置性能分析和数据查看。
- SAP 数据服务支持多种数据源和目标:
- 任何应用程序,例如 SAP.
- 任何支持批量加载和变更数据捕获的数据库。
- 文件格式:固定宽度、逗号分隔、COBOL、XML 和 Excel.
这些功能由一小套可安装组件实现,每个组件都有其独特的作用。
组件 SAP 数据服务
SAP 数据服务包含以下组件。
- 设计师 它是一款开发工具,可用于创建、测试和执行填充数据仓库的作业。开发人员可以通过在源到目标流程图中选择图标来创建对象并对其进行配置。它可用于通过指定工作流和数据流来创建应用程序。要打开数据服务设计器,请转到…… 开始菜单 -> 所有程序 -> SAP 数据服务 -> 数据服务设计器.

- 作业服务器 – 这是一个启动数据服务处理引擎的应用程序,并作为该引擎和数据服务套件的接口。
- 发动机 – 数据服务引擎执行应用程序中定义的各个作业。
- 存储库 – 存储库是一个数据库,用于存储 Designer 预定义对象和用户定义对象(源和目标元数据、转换规则)。存储库有两种类型:
- 本地存储库 (供 Designer 和 Job Server 使用)。
- 中央储存库 (用于对象共享和版本控制)。
- 存取伺服器 – 访问服务器在 Web 应用程序、数据服务作业服务器和引擎之间传递消息。
- 管理员 – Web 管理员提供基于浏览器的数据服务资源管理功能,详情如下:
- 配置、启动和停止ping 实时服务。
- 调度、监控和执行批量作业。
- 配置作业服务器、访问服务器和存储库的使用。
- 管理用户。
- 通过 Web 服务发布批量作业和实时服务。
- 配置和管理适配器。
了解每个组件的功能只是问题的一半。下图展示了它们在负载期间的通信方式。
SAP 数据服务 Archi质地
数据服务架构包含以下组件:
- 中央存储库——用于作业服务器的存储库配置、安全管理、版本控制和对象共享。
- 设计器 – 用于创建项目、作业、工作流程和数据流,并运行它们。
- 本地存储库 – 您可以在此处创建、更改和启动作业、工作流和数据流。
- 作业服务器和引擎——它管理作业。
- 访问服务器 – 用于执行开发人员在存储库中创建的实时作业。
下图展示了数据服务及其组件之间的关系。

SAP 董事会 Archi质地
设计师窗户细节
设计器是开发人员花费时间最多的组件,因此其布局值得首先了解。数据服务设计器各部分的详细信息如下:
- 工具栏 (用于打开、保存、返回、验证、执行等)。
- 项目区 (包含当前项目,其中包括作业、工作流和数据流。在数据服务中,所有实体都是对象)。
- 工作空间 (应用程序窗口区域,用于定义、显示和修改对象)。
- 本地对象库 (它包含本地存储库对象,例如转换、作业、工作流、数据流等)。
- 工具调色板 (工具面板上的按钮允许您向工作区添加新对象)。

对象层次
下图显示了数据服务中关键对象类型的层次关系。

注意: 下面图例标识了层次结构中的可选元素。

工作流程和条件语句是可选的。
使用的物体 SAP 数据服务详情如下。
| 对象 | 描述 |
|---|---|
| 项目 | 项目是设计器窗口中的最高级别对象。项目可以帮助您组织在数据服务中创建的其他对象。一次只能打开一个项目,“打开”是指“在项目区域中可见”。 |
| 工作 | “任务”是指您可以独立安排执行的最小工作单元。 |
| 脚本 | 过程中的行子集。 |
| 工作流程 | “工作流程”是指将多个数据流整合为一个连贯的工作流程,以完成整个任务。工作流程是可选的。工作流程是一种可以执行以下操作的程序:
|
| 数据流 | “数据流”是指将源数据转换为目标数据的过程。数据流是一个可重用对象,它始终由工作流或作业调用。它的用途包括:
|
| 数据存储 | 连接数据服务与源数据库和目标数据库的逻辑通道。数据存储:
|
| Target | 数据服务从源加载数据到的表或文件。 |
SAP 数据服务 vs SLT vs DXC
SAP 数据服务是其中之一 数据供应 的选项 SAP HANA,选错方法会增加成本,再多的调优也无法弥补。下表比较了三种服务器端方法。
| 标准 | SAP 数据服务 | SLT | DXC |
|---|---|---|---|
| 延迟 | 批量或定时 | 即时的 | 批处理,由数据源调度 |
| 转型 | 完整的 ETL、清洗和分析 | 简单的筛选和字段规则 | 除此以外,没有其他选择。tracTor逻辑 |
| 来源范围 | SAP 和非SAP文件、应用程序 | SAP 和非SAP 数据库 | SAP 仅限商务套件 |
| 需要额外服务器 | 是的,作业服务器 | 通常是 | 没有 |
| 最适合 | 数据质量和多源整合 | Opera实时数据的国家报告 | 重用现有业务内容示例trac职权范围 |
简而言之,选择 SAP 当数据在最终提交之前需要进行清洗、合并或标准化处理时,请使用数据服务。当报表需要反映实际发生的交易时,请选择 SLT。 DXC 当一个经过验证的商业内容示例tracTor 已经能够生成你需要的语义。对于一次性数据集,如果没有重复的计划, 平面文件上传 比配置这三者中的任何一个都要快。
如何从某个数据源加载数据 SAP 使用源表 SAP 数据服务
在数据服务中,一切皆对象。每个源数据库和目标数据库都需要单独的数据存储。
从以下位置加载数据的完整序列 SAP 下方列出了源表格。接下来将详细介绍每个步骤。
- 在源和 BODS 之间创建数据存储
- 将元数据(结构)导入BODS
- 配置导入服务器
- 将元数据导入 HANA 系统
- 在 BODS 和 HANA 之间创建数据存储
- 建立专案
- 创建作业(批处理或实时)
- 创建工作流程
- 创建数据流
- 将对象添加到数据流中
- 执行作业
- 在 HANA 中查看数据预览
步骤1) 在两者之间创建数据存储 SAP 来源和BODS。
- 要从某个位置加载数据 SAP 来源到 SAP 通过 HANA SAP BODS 需要数据存储。因此,我们首先创建一个数据存储,如下所示:项目 -> 新建 -> 数据存储

- 此时将弹出“创建新数据存储”窗口。请按如下方式输入详细信息:
- 输入数据存储名称“ds_ecc”。
- 选择数据存储类型名称为“SAP 应用”。
- 请输入数据库服务器名称。
- 请输入用户名和密码。
- 点击“应用”按钮。
- 点击“确定”按钮。

- 数据存储区将创建完成。请查看下方创建的数据存储区。
- 转到本地对象库。
- 选择“数据存储”选项卡。
- 将显示数据存储“ds_ecc”。

步骤2) 将元数据(结构)导入 BODS 服务器。
我们已经创建了 ECC 到 BODS 的数据存储;现在我们将元数据从 ECC 导入到 BODS。要导入,请按照以下步骤操作。
- 选择数据存储“ds_ecc”,然后单击鼠标右键。
- 选择“按名称导入”选项。

将会弹出“按名称导入”窗口。请按如下方式输入详细信息:
- 选择类型为表。
- 请输入要导入的表名称。这里我们导入的是KNA1表。
- 点击“导入”按钮。KNA1 表将出现在“ds_ecc”数据源的“表”节点下。

表元数据将按如下方式导入到数据存储 ds_ecc 中。

步骤3) 配置导入服务器。
目前,我们已将一个表导入到为 ECC 创建的数据存储“ds_ecc”中。 SAP BODS 连接。将数据导入到 SAP HANA我们需要配置导入服务器。
- 要做到这一点,请转到 快速查看 -> 配置导入服务器 如下。

- 将出现一个“选择系统”的弹出窗口。选择该系统。 SAP HANA 系统(此处为 HDB)如下所示。

- 点击“下一步”按钮。此时将弹出另一个窗口,要求输入数据服务凭据。请输入以下详细信息:
- SAP BODS 服务器地址(此处为 BODS:6400)。
- SAP BODS 存储库名称(HANAUSER 存储库名称)。
- ODBC 数据源(ZTDS_DS)。
- 默认端口 SAP BODS 服务器(8080)。

点击“完成”按钮。
步骤4) 将元数据导入 HANA 系统。
导入服务器现已配置完成,因此可以从中导入元数据。 SAP BODS 服务器。
- 在“快速查看”中点击“导入”选项。
- 将会弹出导入选项窗口。选择“选择性导入元数据”选项。

点击“下一步”按钮。
将会弹出“选择性导入元数据”窗口,我们可以在其中选择目标系统。
- 点击 SAP HANA 系统(此处为 HDB)。

点击“下一步”按钮。
步骤5) 在 BODS 和 HANA 之间创建数据存储。
在 BODS 中,源和目标需要单独的数据存储。源数据存储已存在,因此接下来会在 BODS 和 HANA 之间创建一个名为“DS_BODS_HANA”的目标数据存储。
- 转到项目->新建->数据存储。
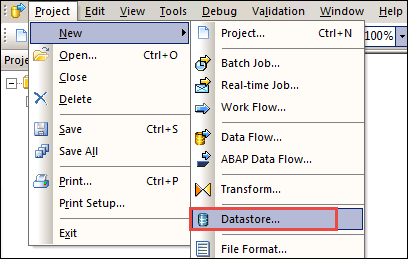
- 将显示如下所示的“创建新数据存储”屏幕。
- 输入数据存储名称(DS_BODS_HANA)。
- 输入数据存储类型为“数据库”。
- 请输入数据库类型 SAP 花。
- 选择数据库版本。
- 进入 SAP HANA数据库服务器名称。
- 输入端口名称 SAP HANA 数据库。
- 请输入用户名和密码。
- 勾选“启用自动数据传输”。

点击“应用”,然后点击“确定”按钮。
数据存储“DS_BODS_HANA”将显示在本地对象库的数据存储选项卡下,如下所示。

- 现在我们将一个表导入到数据存储“DS_BODS_HANA”中。
- 选择数据存储“DS_BODS_HANA”,然后单击鼠标右键。
- 选择“按名称导入”。

- 将会弹出如下所示的“按名称导入”窗口。
- 选择类型为表。
- 输入名称 KNA1。
- 所有者将显示为 Hanauser。
- 点击“导入”按钮。

该表将被导入到“DS_BODS_HANA”数据存储中。要查看表中的数据,请按照以下步骤操作。
- 单击数据存储“DS_BODS_HANA”中的表“KNA1”。
- 数据将以表格形式显示。

步骤 6)定义项目。 项目用于对相关对象进行分组和组织。一个项目可以包含任意数量的作业、工作流和数据流。
- 转到“设计器项目”菜单。
- 选择“新建”选项。
- 选择“项目”选项。

此时会弹出一个创建新项目的窗口,如下所示。输入项目名称,然后单击“创建”按钮。系统将创建一个项目文件夹,在本例中为 BODS_DHK。

步骤 7)定义工作。 作业是一个可重用对象,包含工作流和数据流。作业可以手动执行,也可以按计划执行。要执行 BODS 流程,必须先定义一个作业。
我们创建一个名为 JOB_Customer 的职位。
- 选择上一步创建的项目(BODS_DHK),右键单击,然后选择“新建批处理作业”。
- 将其重命名为“JOB_Customer”。

步骤 8)定义工作流程。
- 在项目区域中选择“JOB_Customer”作业。
- 单击工具面板上的工作流程按钮。单击空白工作区。工作区中将出现工作流程图标。
- 将工作流名称更改为“WF_Customer”。

单击工作流名称,工作区中将出现该工作流的空白视图。

步骤 9)定义数据流。
- 点击工作流程“WF_Customer”。
- 单击工具面板上的“数据流”按钮。单击空白工作区。工作区中将出现一个数据流图标。
- 将数据流名称更改为“DF_Customer”。
- 数据流也会显示在左侧项目区域的作业名称下方。

步骤 10)向数据流中添加对象。
在数据流中,我们提供了将源数据转换为目标表所需格式的指令。
使用了三个物体:
- 源的对象。
- 目标表的对象。
- 用于查询转换的对象,它将源列映射到目标列。
点击数据流 DF_Customer。将出现如下所示的空白工作区。
- 指定源的对象 – 转到数据存储“ds_ecc”,选择表 KNA1,然后将其拖放到空白数据流屏幕上。
- 指定目标对象 – 从存储库中选择数据存储“DS_BODS_HANA”,然后选择表 KNA1。
- 将其拖放到工作区,然后选择“生成”。 Target“选项”。现在将有两个表,一个源表和一个目标表。

- 查询转换 – 这是一个用于根据用户特定条件的输入模式检索数据,并将数据从源传输到目标的工具。
- 从工具面板中选择“查询变换”图标,然后将其拖放到工作区中的源对象和目标对象之间。
- 将查询对象链接到数据源。
- 将查询对象链接到目标表。

Double单击“查询”图标,将输入模式中的列映射到输出模式。ping 出现一个窗口,我们在其中执行以下操作:
- 已选择源表 KNA1。
- 选择源表中的所有列,右键单击,然后选择“映射到输出”。
- 目标输出被选为查询,并且列将被映射。

保存并验证项目。 点击“验证”图标。此时会弹出一个窗口,确认验证成功。

步骤 11)执行作业。 要执行此作业,请按照以下路径操作。
- 选择项目区域图标打开项目,然后选择已创建的项目。
- 选择作业并右键单击。
- 选择“执行”选项来执行作业。
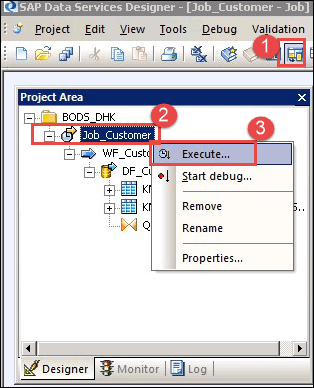
作业执行完毕后,将显示“作业日志”窗口,其中会显示所有与该作业相关的消息。最后一条消息将是“作业”。已成功完成”。

步骤 12)验证并检查数据 SAP HANA 数据库。
- 登录到 SAP HANA数据库通过 SAP HANA 工作室并选择 HANAUSER 模式。
- 在“表”节点中选择 KNA1 表。
- 右键单击表 KNA1,然后选择“打开数据预览”。
- BODS 进程加载的 KNA1 数据将显示在数据预览屏幕中。

源表与此预览之间的行数匹配,确认加载已正确完成,然后管理员可以安排该作业重复运行。
