
R 语言中的 t 检验:单样本和配对样本示例
 伊芙琳·克拉克
什么是统计推断?
统计推断是一门通过分析数据分布来得出结论的艺术。数据科学家经常会遇到一些只能用科学方法解答的问题。因此,统计推断是一种检验假设是否成立(即是否被数据验证)的策略。
评估假设的常用策略是t检验,它可以告诉你两个均值是否相等。它也被称为…… 学生测试可以计算以下 t 检验:
- 单个向量与固定值进行比较(单样本t检验)
- 来自两个不同组的两个向量(独立双样本t检验)
- 对同一受试者测量的两个向量(配对t检验)
所有t检验都假设数据是随机抽样的,并且这些值(或者,对于配对检验,是差异值)来自近似正态分布的总体。独立双样本t检验还假设两组数据彼此独立,而经典形式则假设它们的方差相等。
R 编程中的 T 检验是什么?
T 检验的基本思想是使用统计数据来评估两个相反的假设:
- H0零假设,即总体均值等于待检验的值。
- H1备择假设,即总体均值与该值不同
t检验适用于小样本量,此时正态近似不可靠。它要求数据近似服从正态分布。
R 中的 T 检验语法
R 中 t.test() 的基本语法是:
t.test(x, y = NULL,
       mu = 0, var.equal = FALSE)
arguments:
- x : A vector to compute the one-sample t-test
- y: A second vector to compute the two sample t-test
- mu: Mean of the population under the null hypothesis
- var.equal: Specify whether the variances of the two vectors are equal. By default, set to `FALSE`
- paired: Set to `TRUE` when the two vectors are repeated measures on the same subjects
在运行任何操作之前,请确保您的数据布局与测试的正确变体相匹配。
R语言中的t检验类型
选择错误的变体是 t 检验中最常见的错误,因此首先要将你的数据布局与正确的调用相匹配。
| 类型 | 在以下情况下使用 | R 调用 |
|---|---|---|
| 单样本 | 一组与已知目标值进行比较 | t.test(x, mu = value) |
| 独立双样本(Welch) | 两个独立的组,方差可能不相等。 | t.test(x, y) |
| 独立双样本(合并) | 两个方差相等的独立组 | t.test(x, y, var.equal = TRUE) |
| 配对 | 同一批受试者进行了两次测量。 | t.test(x, y, paired = TRUE) |
| 片面 | 你只关心一个方向上的差异。 | t.test(x, mu = value, alternative = “greater”) |
超过三个组别后,t 检验不再适用。请改用其他方法。 方差分析检验这样可以将总体错误率保持在 5%,而不是通过重复的成对比较来提高错误率。
R 中的单样本 T 检验
单样本 t 检验或学生检验将向量的平均值与理论平均值进行比较,  . 计算 t 检验的公式为:

在这里,
 指的是平均值
 达到理论平均值
- s 是标准差
- n 观察次数。
 指的是平均值
为了评估 t 检验的统计显著性,您需要计算 p-值。 该 p-值 范围从 0 到 1,解释如下:
- p 值小于 0.05 表示可以拒绝原假设。需要注意的是,拒绝原假设 H0 并不等同于证明备择假设 H1 为真,它仅仅意味着在原假设 H0 下,数据不太可能成立。
- p 值大于 0.05 表示没有足够的证据拒绝原假设。
您可以通过查看自由度等于的学生分布中 t 检验的相应绝对值来构建 p 值 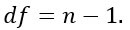
例如,对于 5 个观测值,您需要将 t 值与自由度为 4 的 t 分布进行比较,置信水平为 95%。在双侧检验中,要拒绝原假设,t 值的绝对值必须大于 2.776。
参见下表:

R 中的单样本 T 检验示例
假设您是一家生产饼干的公司。每块饼干应该含有 10 克糖。饼干是由一台机器生产的,该机器在混合所有东西之前将糖添加到碗中。您认为机器不会为每块饼干添加 10 克糖。如果您的假设成立,则需要修理机器。您存储了 XNUMX 块饼干的糖含量。
注意::您可以使用函数 rnorm() 创建随机向量。此函数生成正态分布的值。基本语法是:
rnorm(n, mean, sd)
arguments
- n: Number of observations to generate
- mean: The mean of the distribution. Optional
- sd: The standard deviation of the distribution. Optional
您可以创建一个具有 30 个观测值的分布,其平均值为 9.99,标准差为 0.04。
set.seed(123)
sugar_cookie <- rnorm(30, mean = 9.99, sd = 0.04)
head(sugar_cookie)
输出:
## [1] 9.967581 9.980793 10.052348 9.992820 9.995172 10.058603
您可以使用单样本 t 检验来检查糖的含量是否与食谱不同。您可以进行假设检验:
- H0:平均含糖量相当于10
- H1:平均含糖量与 10 不同
您使用的显著性水平为 0.05。
# H0 : mu = 10
t.test(sugar_cookie, mu = 10)
这是输出:

单样本t检验的p值为0.1079,高于0.05的阈值。均值的95%置信区间为9.973至10.002克,包含目标值10。因此,不能拒绝原假设H0:没有足够的证据表明机器偏离了配方。
R语言中的独立双样本t检验
独立双样本 t 检验是最常用的变体,适用于两组测量数据来自不同对象的情况:两家商店、两台机器、两个治疗组。
假设一家工厂有两条生产线,你想知道它们灌装的罐子重量是否相同。
set.seed(123)
line_a <- rnorm(25, mean = 500, sd = 8)
line_b <- rnorm(25, mean = 505, sd = 8)

# Welch test, the safe default
t.test(line_a, line_b)

# Pooled test, only when the variances are equal
t.test(line_a, line_b, var.equal = TRUE)
分四步读取输出结果。
- t 是两个均值之间差距的标准化大小。它的符号仅反映您传递向量的顺序。
- df 是自由度。Welch检验得到的是小数;合并检验得到的是等于n1 + n2 – 2的整数。
- p-值 如果真实均值相同,出现如此大差距的概率是多少?
- 置信区间 它界定了真实差异的范围。当该范围包含零时,表示该差异在该显著性水平上不显著。
如果您的数据位于一个包含一列数值和一列因子的单个数据框中,请改用公式界面,这样更容易阅读,并且避免手动拆分数据:
t.test(weight ~ line, data = jars)
使用哪个版本? 除非您已测试并确认方差相等,否则请将 `var.equal` 保留其默认值 `FALSE`。当方差恰好相等时,韦尔奇校正几乎不会消耗任何计算资源;而当方差不相等时,它则能保护您免受损失。
R 中的配对 T 检验
配对t检验,也称为相关样本t检验,适用于对同一组数据进行两次测量的情况。典型应用包括:
- A / B测试:比较两个变体
- 病例对照研究:同一受试者治疗前后的情况
R 中的配对 T 检验示例
一家饮料公司有兴趣了解折扣计划对销售的影响。该公司决定跟踪正在推广该计划的一家商店的每日销售情况。在计划结束时,该公司想知道计划前后商店的平均销售额是否存在统计差异。
- 电子产品生产专员 trac在项目开始前,我们每天都统计了销售额。这是我们的第一个向量。
- 该计划推广一周,每天记录销售情况。这是我们的第二个载体。
- 您将执行 t 检验来判断程序的有效性。这称为配对 t 检验,因为两个向量的值来自同一分布(即同一家商店)。
假设检验是:
- H0:均值无差异
- H1:两种方式不同
请记住,经典的t检验假设两组的方差未知但相等。实际数据很少能完全满足这一假设,忽略这种差异会导致结果失真。
解决方法是使用 Welch t 检验,它放宽了方差齐性假设。R 默认应用 Welch t 检验,因为除非另行指定,否则 var.equal 的值为 FALSE。在本数据集中,两个向量的标准差相同,因此您可以安全地将 var.equal 设置为 TRUE。
您从高斯分布中创建两个随机向量,其中计划后的销售额具有更高的平均值。
set.seed(123)
# sales before the program
sales_before <- rnorm(7, mean = 50000, sd = 50)
# sales after the program.This has higher mean
sales_after <- rnorm(7, mean = 50075, sd = 50)
# draw the distribution
t.test(sales_before, sales_after,var.equal = TRUE)

p 值为 0.04606,略低于 0.05 的阈值,因此拒绝原假设 H0,并得出结论:两个平均值存在显著差异。折扣活动似乎提升了销售额。
⚠️重要: 上面的调用将两个向量进行比较,如下所示: 独立 样本。由于这两个系列都是对同一店铺的测量,因此统计上正确的调用会增加 配对 = TRUE:
t.test(sales_before, sales_after, paired = TRUE)
配对检验形式检验的是每日差异的均值,而不是两个均值的差异。它消除了两个向量共有的店铺层面的变异,因此具有更高的统计功效。
如何在 R 语言中检验 t 检验的假设
t检验的p值只有在其假设成立时才有意义。每项假设都有直接的检验方法。
1. 正常性。 单样本和双样本检验假设数值近似服从正态分布;配对检验假设…… 差异 是。检查QQ图并使用Shapiro-Wilk检验进行确认:
qqnorm(sugar_cookie); qqline(sugar_cookie)
shapiro.test(sugar_cookie)

# for a paired design, test the differences
shapiro.test(sales_after - sales_before)
Shapiro-Wilk p 值大于 0.05 表示无法拒绝正态性假设。此外,当每组观测值超过 30 个时,中心极限定理使得 t 检验对中等程度的偏态分布具有稳健性。
2. 方差相等。 只有合并双样本检验才需要这样做。用F检验来验证:
var.test(line_a, line_b)
p 值大于 0.05 支持方差相等,这证明 var.equal = TRUE 是合理的。
3. 独立性。 这是研究设计本身决定的,事后无法验证。如果同一受试者对两个向量均有贡献,则独立性检验就不适用,此时需要将 paired 设置为 TRUE。
当一个假设不成立时。 对于明显不符合正态分布且样本量较小的数据,请使用基于秩的替代方法:`wilcox.test(x, y)` 替代双样本 t 检验,`wilcox.test(x, y, paired = TRUE)` 替代配对 t 检验。这两种方法都不要求数据服从正态分布,但当数据实际上服从正态分布时,它们的检验效能会略有下降。
R 语言中的 t 检验:关键要点和测试参考
- 统计推断是生成有关数据分布的结论的艺术。
- T 检验属于推断统计学家族。它通常用于查明两组平均值之间是否存在统计差异。
- 单样本 t 检验,或称学生 t 检验,是将向量的均值与理论均值进行比较。
- 配对 t 检验,或称相关样本 t 检验,适用于对同一组样本进行两次测量的情况。
下表总结了上述各项测试:
| 《测试》(Test) | 待检验的假设 | p-值 | Code | 可选参数 |
|---|---|---|---|---|
| 单样本 t 检验 | 向量的均值与理论均值不同 | 0.05 |
t.test(x, mu = mean)
|
|
| 配对样本 t 检验 | 对于同一组受试者,均值 A 与均值 B 不同。 | 0.05 |
t.test(A, B, paired = TRUE) |
var.equal = TRUE
|
如果您愿意在独立的双样本检验中假设方差相等,请将 var.equal 设置为 TRUE。将其保留为默认值 FALSE 则运行更安全的 Welch 校正。
