
R 编程中的函数示例
 伊芙琳·克拉克
⚡ 智能摘要
R 语言中的函数将一组指令打包在一个名称下,因此只需一次调用即可运行重复的任务。内置的数学和统计辅助函数、用户自定义函数以及环境变量 sco 都提供了丰富的功能。ping这里将介绍条件参数,并附上示例。
R 中的函数是什么?
A function在编程环境中,是一组指令。程序员构建一个函数来避免 重复相同的任务,或减少 复杂.
函数应该
- 为执行特定任务而编写
- 可能包含或不包含参数
- 包含主体
- 可能返回一个或多个值,也可能不返回任何值。
函数的一般方法是使用参数部分作为 输入, 喂食 身体 部分并最终返回 产量。函数的语法如下:
function (arglist)  {
  #Function body
}
R 重要的内置函数
R 中有很多内置函数。R 会将您的输入参数与其函数参数(按值或按位置)进行匹配,然后执行函数体。函数参数可以具有默认值:如果您未指定这些参数,R 将采用默认值。
注意::
通过在控制台中运行函数本身的名称,就可以查看函数的源代码。
Typing 函数名不带括号会打印其源代码,如下面的控制台所示。

我们将看到三组函数的实际作用
- 一般功能
- 数学函数
- 统计功能
一般功能
我们已经熟悉诸如 cbind()、rbind()、range() 等通用函数。 种类()以及 order() 函数。每个函数都有其特定的任务,接受参数并返回输出。以下是一些必须了解的重要函数:
diff() 函数
如果你工作 时间序列,你需要通过采取他们的 滞后值。 一个 平稳过程 允许时间序列的均值、方差和自相关性保持不变。这主要提高了时间序列的预测精度。这可以通过 `diff()` 函数实现。我们可以构建一个具有趋势的随机时间序列数据,然后使用 `diff()` 函数将其平稳化。`diff()` 函数接受一个参数(向量),并返回合适的滞后和迭代差分。
注意:我们经常需要生成随机数据,但为了进行学习和比较,我们希望不同机器生成的数据完全相同。为了确保所有机器生成的数据一致,我们使用 `set.seed()` 函数,并指定任意值 123。`set.seed()` 会固定伪随机数生成器的初始值,从而保证每台机器生成的序列相同。如果没有 `set.seed()`,每次运行都会返回不同的序列。
set.seed(123)
## Create the data
x = rnorm(1000)
ts <- cumsum(x)
## Stationary the serie
diff_ts <- diff(ts)
par(mfrow=c(1,2))
## Plot the series
plot(ts, type='l')
plot(diff(ts), type='l')
下面的两个面板将原始累积序列与差分序列并列显示,差分序列现在围绕一个恒定的均值波动。

length() 函数
很多情况下,我们需要知道向量的长度以便进行计算或在 for 循环中使用。`length()` 函数用于计算向量 `x` 的行数。以下代码导入了 cars 数据集并返回了行数。
注意:`length()` 函数返回向量中元素的数量。如果将该函数传递给一个 矩阵 如果是数据框,则返回列数。
dt <- cars
## number columns
length(dt)
输出:
## [1] 1
## number rows
length(dt[,1])
输出:
## [1] 50
数学函数
除了通用的辅助函数之外,R 还提供了一系列数学函数,可以对向量逐个元素进行运算。
| Opera器 | 描述 |
|---|---|
| 绝对(x) | 取 x 的绝对值 |
| 对数(x,基数=y) | 取 x 以 y 为底的对数; 如果未指定底数,则返回自然对数 |
| 经验 (x) | 返回 x 的指数 |
| 平方根(x) | 返回 x 的平方根 |
| 阶乘(x) | 返回 x 的阶乘(x!) |
# sequence of number from 44 to 55 both including incremented by 1
x_vector <- seq(45,55, by = 1)
#logarithm
log(x_vector)
输出:
##  [1] 3.806662 3.828641 3.850148 3.871201 3.891820 3.912023 3.931826
##  [8] 3.951244 3.970292 3.988984 4.007333
#exponential
exp(x_vector)
#squared root
sqrt(x_vector)
输出:
##  [1] 6.708204 6.782330 6.855655 6.928203 7.000000 7.071068 7.141428
##  [8] 7.211103 7.280110 7.348469 7.416198
#factorial
factorial(x_vector)
输出:
##  [1] 1.196222e+56 5.502622e+57 2.586232e+59 1.241392e+61 6.082819e+62
##  [6] 3.041409e+64 1.551119e+66 8.065818e+67 4.274883e+69 2.308437e+71
## [11] 1.269640e+73
统计功能
数学函数对数值进行转换,而统计函数则对这些数值进行概括。R 标准安装包中包含了丰富的统计函数。在本教程中,我们将简要介绍其中最重要的几个函数。
基本统计函数
| Opera器 | 描述 |
|---|---|
| 平均值(x) | x 的平均值 |
| 中位数(x) | x 的中位数 |
| 变量(x) | x 的方差 |
| 标准差(x) | x 的标准差 |
| 比例(x) | x 的标准分数 (z 分数) |
| 分位数(x) | x 的四分位数 |
| 摘要(x) | x 的摘要:平均值、最小值、最大值等。 |
speed <- dt$speed
speed
# Mean speed of cars dataset
mean(speed)
输出:
## [1] 15.4
# Median speed of cars dataset
median(speed)
输出:
## [1] 15
# Variance speed of cars dataset
var(speed)
输出:
## [1] 27.95918
# Standard deviation speed of cars dataset
sd(speed)
输出:
## [1] 5.287644
# Standardize vector speed of cars dataset
head(scale(speed), 5)
输出:
##           [,1]
## [1,] -2.155969
## [2,] -2.155969
## [3,] -1.588609
## [4,] -1.588609
## [5,] -1.399489
# Quantile speed of cars dataset
quantile(speed)
输出:
##   0%  25%  50%  75% 100%
##    4   12   15   19   25
# Summary speed of cars dataset
summary(speed)
输出:
##    Min. 1st Qu.  Median    Mean 3rd Qu.    Max.
##     4.0    12.0    15.0    15.4    19.0    25.0
到目前为止,我们已经学习了很多 R 内置函数。
注意:小心使用 论证的类别例如,可以是数值、布尔值或字符串。例如,如果我们需要传递一个字符串值,我们需要将字符串用引号括起来:“ABC”。
在 R 中编写函数
有时,我们需要编写自己的函数,因为我们需要完成一项特定任务,而没有现成的函数可用。用户自定义函数涉及…… 姓名, 参数 配备 身体.
function.name <- function(arguments)
{
    computations on the arguments
    some other code
}
注意::一个好的做法是将用户定义函数命名为与内置函数不同的名称。这样可以避免混淆。
单参数函数
在下一个代码片段中,我们定义了一个简单的平方函数。该函数接受一个值并返回该值的平方。
square_function<- function(n)
{
  # compute the square of integer `n`
  n^2
}
# calling the function and passing value 4
square_function(4)
Code 说明
- 该函数名为 square_function;我们可以随意调用它。
- 它接收一个参数“n”。我们 没有指定变量的类型,以便用户可以传递整数、向量或矩阵
- 该函数接受输入“n”并返回输入的平方。使用完该函数后,我们可以使用 rm() 函数将其删除。
# 创建函数后
rm(square_function)
square_function
在控制台上,我们可以看到一条错误消息:错误:未找到对象“square_function”,表明该函数不存在。
环境科学ping
在 R 中, 环境 是函数、变量、数据框等对象的集合。
每次启动 RStudio 时,R 都会打开一个环境。
可用的顶层环境是 全球环境名为 R_GlobalEnv。我们还有 当地环境.
我们可以列出当前环境的内容。
ls(environment())
输出
## [1] "diff_ts"         "dt"              "speed"           "square_function"
## [5] "ts"              "x"               "x_vector"
您可以看到在 R_GlobalEnv 中创建的所有变量和函数。
以上列表会根据您在 RStudio 中执行的历史代码而有所不同。
需要注意的是 nsquare_function 函数的参数不在这个全局环境中。
每个函数都会创建一个新的环境。在上面的例子中,函数 square_function() 在内部创建了一个新的环境。 全球环境.
为了澄清 全球化 和 本地 让我们来看下面的例子,了解一下环境。
这些函数以 x 为参数,并将其添加到 y 中,在函数外部和内部定义

函数 f 返回输出 15。这是因为 y 是在全局环境中定义的。全局环境中定义的任何变量都可以在本地使用。变量 y 在所有函数调用期间都具有值 10,并且可以随时访问。
让我们看看如果变量 y 在函数内部定义会发生什么。
我们需要在使用 rm r 运行此代码之前删除“y”
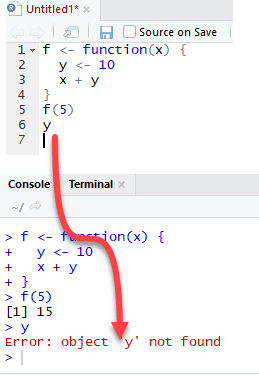
当我们调用 f(15) 时,输出也是 5,但是当我们尝试打印值 y 时返回错误。变量 y 不在全局环境中。
最后,R 使用最新的变量定义传递到函数主体内部。让我们考虑以下示例:

R 忽略了函数外部定义的 y 值,因为我们在函数主体内部明确创建了 y 变量。
多参数函数
我们可以编写一个具有多个参数的函数。考虑名为“times”的函数。它是将两个变量相乘的简单函数。
times <- function(x,y) {
  x*y
	}
times(2,4)
输出:
## [1] 8
什么时候应该写函数?
数据科学家需要执行许多重复性任务。大多数时候,我们会反复复制粘贴代码块。例如,在运行某个函数之前,强烈建议对变量进行归一化。 机器学习 算法。对变量进行规范化的公式为:

我们已经知道如何在 R 中使用 min() 和 max() 函数。我们使用 tibble 库来创建数据框。到目前为止,Tibble 是从头开始创建数据集最方便的函数。
library(tibble)
# Create a data frame
data_frame <- tibble(
  c1 = rnorm(50, 5, 1.5),
  c2 = rnorm(50, 5, 1.5),
  c3 = rnorm(50, 5, 1.5),
)
我们将分两步计算上述函数。第一步,我们创建一个名为 c1_norm 的变量,它是 c1 的重缩放值。第二步,我们只需复制粘贴 c1_norm 的代码,并将其替换为 c2 和 c3 即可。
带有 c1 列的函数的详细信息:
提名者: : data_frame$c1 -min(data_frame$c1))
分母:max(data_frame$c1)-min(data_frame$c1))
因此,我们可以将它们相除以得到 c1 列的标准化值:
(data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
我们可以创建 c1_norm、c2_norm 和 c3_norm:
Create c1_norm: rescaling of c1
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
# show the first five values
head(data_frame$c1_norm, 5)
输出:
## [1] 0.3400113 0.4198788 0.8524394 0.4925860 0.5067991
有效。我们可以复制并粘贴
data_frame$c1_norm <- (data_frame$c1 -min(data_frame$c1))/(max(data_frame$c1)-min(data_frame$c1))
然后将 c1_norm 更改为 c2_norm,将 c1 更改为 c2。我们执行相同操作来创建 c3_norm
data_frame$c2_norm <- (data_frame$c2 - min(data_frame$c2))/(max(data_frame$c2)-min(data_frame$c2))
data_frame$c3_norm <- (data_frame$c3 - min(data_frame$c3))/(max(data_frame$c3)-min(data_frame$c3))
我们完美地重新调整了变量 c1、c2 和 c3。
然而,这种方法容易出错。我们可能复制粘贴后忘记更改列名。因此,一个好的做法是,每次需要粘贴相同代码超过两次时,都编写一个函数。我们可以将代码重新组织成一个公式,并在需要时调用它。要编写我们自己的函数,我们需要提供:
- 名称:规范化。
- 参数的数量:我们只需要一个参数,即我们在计算中使用的列。
- 主体:这只是我们想要返回的公式。
我们将逐步创建函数 normalize。
步骤1) 我们创建分子,即 x – min(x)。在 R 语言中,我们可以将分子存储在一个变量中,如下所示:
nominator <- x-min(x)
步骤2) 我们计算分母:max(x) – min(x)。我们可以复制步骤 1 的思路,并将计算结果存储在一个变量中:
denominator <- max(x)-min(x)
步骤3) 我们执行分子和分母之间的除法。
normalize <- nominator/denominator
步骤4) 要将值返回给调用函数,我们需要在 return() 中传递 normalize 来获取函数的输出。
return(normalize)
步骤5) 我们已准备好通过包装来使用该函数。ping 括号内的所有内容。
normalize <- function(x){
  # step 1: create the nominator
  nominator <- x-min(x)
  # step 2: create the denominator
  denominator <- max(x)-min(x)
  # step 3: divide nominator by denominator
  normalize <- nominator/denominator
  # return the value
  return(normalize)
}
让我们用变量 c1 测试我们的函数:
normalize(data_frame$c1)
运行完美。我们创建了第一个函数。
使用函数可以更全面地完成重复性任务。我们可以对不同的列使用归一化公式,如下所示:
data_frame$c1_norm_function <- normalize (data_frame$c1)
data_frame$c2_norm_function <- normalize	(data_frame$c2)
data_frame$c3_norm_function <- normalize	(data_frame$c3)
虽然例子很简单,但我们仍然可以从中看出公式的强大之处。上面的代码更易于阅读,并且避免了粘贴代码时容易出现的错误。
带条件的函数
normalize() 函数始终执行相同的操作。有时,我们需要在函数中添加条件,以便代码能够返回不同的输出。
在机器学习任务中,我们需要将数据集分为训练集和测试集。训练集允许算法从数据中学习。为了测试模型的性能,我们可以使用测试集来返回性能指标。R 没有创建两个数据集的函数。我们可以编写自己的函数来执行此操作。我们的函数接受两个参数,称为 split_data()。背后的想法很简单,我们将数据集的长度(即观察次数)乘以 0.8。例如,如果我们想将数据集拆分为 80/20,并且我们的数据集包含 100 行,那么我们的函数将乘以 0.8*100 = 80。将选择 80 行作为我们的训练数据。
我们将使用 airquality 数据集来测试我们的用户定义函数。airquality 数据集有 153 行。我们可以通过以下代码查看:
nrow(airquality)
输出:
## [1] 153
我们将按照以下步骤进行:
split_data <- function(df, train = TRUE)
Arguments:
-df: Define the dataset
-train: Specify if the function returns the train set or test set. By default, set to TRUE
我们的函数有两个参数。参数 train 是一个布尔参数。如果将其设置为 TRUE,我们的函数将创建训练数据集,否则将创建测试数据集。
我们可以像处理 normalize() 函数那样继续。我们先编写一次性代码,然后将所有带有条件的部分都包裹在函数体中,从而创建一个函数。
第三步:
我们需要计算数据集的长度。这可以通过函数 nrow() 完成。Nrow 返回数据集中的总行数。我们称之为变量长度。
length<- nrow(airquality)
length
输出:
## [1] 153
第三步:
我们将长度乘以 0.8。它将返回要选择的行数。应该是 153*0.8 = 122.4
total_row <- length*0.8
total_row
输出:
## [1] 122.4
我们想在 airquality 数据集的 122 行中选择 153 行。我们创建一个包含从 1 到 total_row 的值的列表。我们将结果存储在名为 split 的变量中
split <- 1:total_row
split[1:5]
输出:
## [1] 1 2 3 4 5
split 从数据集中选择前 122 行。例如,我们可以看到我们的变量 split 收集了值 1、2、3、4、5 等等。这些值将成为我们选择要返回的行时的索引。
第三步:
我们需要根据存储在拆分变量中的值来选择 airquality 数据集中的行。具体操作如下:
train_df <- airquality[split, ]
head(train_df)
输出:
##[1]    Ozone Solar.R Wind Temp Month Day
##[2]  51    13     137 10.3   76     6  20
##[3]  15    18      65 13.2   58     5  15
##[4]  64    32     236  9.2   81     7   3
##[5]  27    NA      NA  8.0   57     5  27
##[6]  58    NA      47 10.3   73     6  27
##[7]  44    23     148  8.0   82     6  13
第三步:
我们可以使用剩余的行 123:153 创建测试数据集。这是通过在拆分前使用 – 来完成的。
test_df <- airquality[-split, ]
head(test_df)
输出:
##[1] Ozone Solar.R Wind Temp Month Day
##[2]  123    85     188  6.3   94     8  31
##[3]  124    96     167  6.9   91     9   1
##[4]  125    78     197  5.1   92     9   2
##[5]  126    73     183  2.8   93     9   3
##[6]  127    91     189  4.6   93     9   4
##[7]  128    47      95  7.4   87     9   5
第三步:
我们可以在函数主体内创建条件。请记住,我们有一个参数 train,它是一个布尔值,默认情况下设置为 TRUE,以返回训练集。要创建条件,我们使用 if 语法:
  if (train ==TRUE){
    train_df <- airquality[split, ]
      return(train)
  } else {
    test_df <- airquality[-split, ]
      return(test)
  }
就是这样,我们可以编写函数了。我们只需要将 airquality 改为 df,因为我们想将函数尝试到任意 数据框,不仅仅是空气质量:
split_data <- function(df, train = TRUE){
  length<- nrow(df)
  total_row <- length *0.8
  split <- 1:total_row
  if (train ==TRUE){
    train_df <- df[split, ]
      return(train_df)
  } else {
    test_df <- df[-split, ]
      return(test_df)
  }
}
让我们用空气质量数据集来测试一下我们的函数。我们应该有一个包含 122 行的训练集和一个包含 31 行的测试集。
train <- split_data(airquality, train = TRUE)
dim(train)
输出:
## [1] 122 6
test <- split_data(airquality, train = FALSE)
dim(test)
输出:
## [1] 31 6
