
Python RegEx:re.match()、re.search()、re.findall() 示例
 编辑团队
⚡ 智能摘要
Python 正则表达式教程通过实际示例涵盖了 re.match、re.search、re.findall 和 re.split。 Lessons 解释了元字符、字符类、字符组、标志、替换以及文本解析和验证的常见模式。
正则表达式 Python?
A 正则表达式 (RE) 在编程语言中,`--search` 是一种用于描述搜索模式的特殊文本字符串。它对于例如搜索模式非常有用。trac从代码、文件、日志、电子表格甚至文档等文本中提取信息。
在使用 Python 正则表达式首先要认识到的是,一切本质上都是字符,我们编写的模式是为了匹配特定的字符序列,也称为字符串。Ascii 或拉丁字母是键盘上的字母,Unicode 用于匹配外来文本。它包括数字和标点符号以及所有特殊字符,如 $#@!% 等。
例如,a Python 正则表达式可以告诉程序从字符串中搜索特定文本,然后打印出相应的结果。表达式可以包括
- 文本匹配
- 重复
- 分枝
- 图案构图等
正则表达式或 RegEx Python 表示为 RE(RE、正则表达式或正则表达式模式)通过以下方式导入 重新模块. Python 通过库支持正则表达式。RegEx 中的 Python 支持各种各样的事情,比如 修饰符、标识符和空格字符.
| 标识符 | 修饰符 | 空白字符 | 需要逃离 |
|---|---|---|---|
| \d= 任意数字(一位数字) | \d 代表数字。例如:\d{1,5} 它将声明 1,5 之间的数字,如 424,444,545 等。 | \n = 新行 | . + * ? [] $ ^ () {} | \ |
| \D= 除了数字之外的任何内容(非数字) | + = 匹配 1 个或多个 | \s= 空格 | |
| \s = 空格 (制表符、空格、换行符等) |
? = 匹配 0 或 1 | \t =制表符 | |
| \S= 除空格外的任何字符 | * = 0 或更多 | \e = 转义 | |
| \w = 字母(匹配字母数字字符,包括“_”) | $ 匹配字符串的结尾 | \r = 回车 | |
| \W = 除字母以外的任何字符(匹配除“_”之外的非字母数字字符) | ^ 匹配字符串的开头 | \f= 换页符 | |
| . = 除字母(句点)以外的任何字符 | | 匹配或 x/y | ------ | |
| \b = 除换行符之外的任意字符 | [] = 范围或“方差” | ------ | |
| \. | {x} = 前面代码的数量 | ------ |
正则表达式(RE)语法
import re
- 包含“re”模块 Python 主要用于字符串搜索和操作
- 也经常用于网页“斯克拉ping“ (前任trac(来自网站的大量数据)
我们将通过使用表达式 (w+) 和 (^) 的简单练习来开始表达式教程。
w+ 和 ^ 表达式的示例
- “^”: 此表达式匹配字符串的开头
- “w+“:此表达式匹配字符串中的字母数字字符
在这里我们将看到 Python RegEx 示例,说明如何在代码中使用 w+ 和 ^ 表达式。我们在 Python,但暂时我们只关注 \w+ 和 \^ 表达式。
例如,对于我们的字符串“guru99, education is fun”,如果我们使用 w+ 和 ^ 执行代码,它将输出“guru99”。
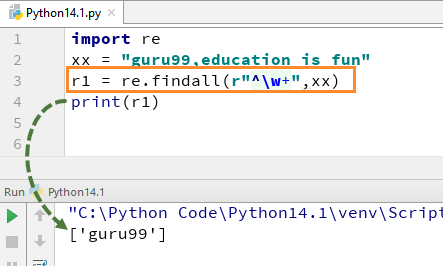
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+",xx)
print(r1)
请记住,如果从 w+ 中删除 + 号,输出将会发生变化,并且只会给出第一个字母的第一个字符,即 [g]
re.split 函数中 \s 表达式的示例
- “s”:此表达式用于在字符串中创建空格
要理解此 RegEx 如何 Python 我们从一个简单的开始 Python RegEx 拆分函数示例。在示例中,我们使用“re.split”函数拆分每个单词,同时使用表达式 \s 来分别解析字符串中的每个单词。

当你执行此代码时,它将给你输出 ['we', 'are', 'splitting', 'the', 'words']。
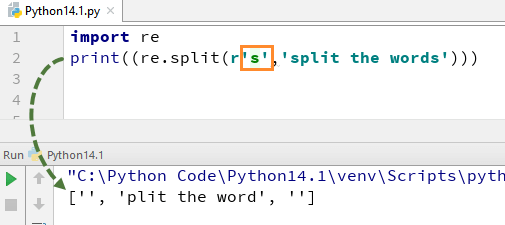
现在,让我们看看如果从 s 中删除“\”,会发生什么情况。输出中没有“s”字母,这是因为我们已从字符串中删除了“\”,并且它将“s”评估为常规字符,因此在字符串中找到“s”时会拆分单词。
同样,还有一系列其他的 Python 正则表达式可以以多种方式使用 Python 例如 \d、\D、$、\.、\b 等等。
以下是完整的代码
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+", xx)
print((re.split(r'\s','we are splitting the words')))
print((re.split(r's','split the words')))
接下来,我们将看到正则表达式中使用的方法类型 Python.
使用正则表达式方法
“re” 包提供了几种对输入字符串执行查询的方法。我们将在 Python:
- 重新匹配()
- 研究()
- 重新findall()
注意::根据正则表达式, Python 提供两种不同的基本操作。match 方法仅在字符串开头检查匹配,而 search 检查字符串中任意位置的匹配。
重新匹配()
重新匹配() re 的功能 Python 将搜索正则表达式模式并返回第一个匹配项。 Python RegEx Match 方法仅在字符串开头检查匹配项。因此,如果在第一行找到匹配项,它将返回匹配对象。但如果在其他行找到匹配项,则 Python RegEx Match 函数返回空值。
例如,考虑以下代码 Python re.match() 函数。表达式“w+”和“\W”将匹配以字母“g”开头的单词,此后,不以“g”开头的任何单词都无法识别。为了检查列表或字符串中每个元素的匹配情况,我们在此运行 forloop Python re.match() 示例。

re.search():在文本中查找模式
研究() 函数将搜索正则表达式模式并返回第一个匹配项。与 Python re.match(),它将检查输入字符串的所有行。 Python 如果找到模式,re.search() 函数将返回匹配对象;如果未找到模式,则返回“null”
如何使用search()?
为了使用 search() 函数,您需要导入 Python 重新模块,然后执行代码。 Python re.search() 函数从主字符串中获取“模式”和“文本”进行扫描
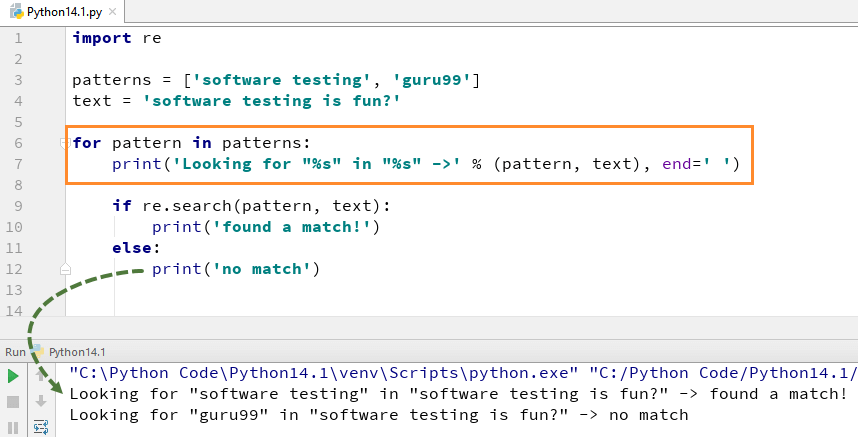
例如,我们在文本字符串“Software 测试与验证 很有趣”。对于“软件测试”,我们找到了匹配项,因此它返回输出 Python re.search() 示例为“找到匹配项”,而对于单词“guru99”,我们在字符串中找不到,因此它返回输出“无匹配”。
重新findall()
找到所有() `findall` 模块用于搜索与给定模式匹配的“所有”匹配项。相比之下,`search()` 模块只会返回与指定模式匹配的第一个匹配项。`findall()` 会遍历文件中的所有行,并返回所有不重叠的匹配项。ping 单步完成模式匹配。
如何在 Python?
这里我们有一个电子邮件地址列表,我们希望从列表中取出所有电子邮件地址,我们使用方法 re.findall() Python。它将从列表中查找所有电子邮件地址。
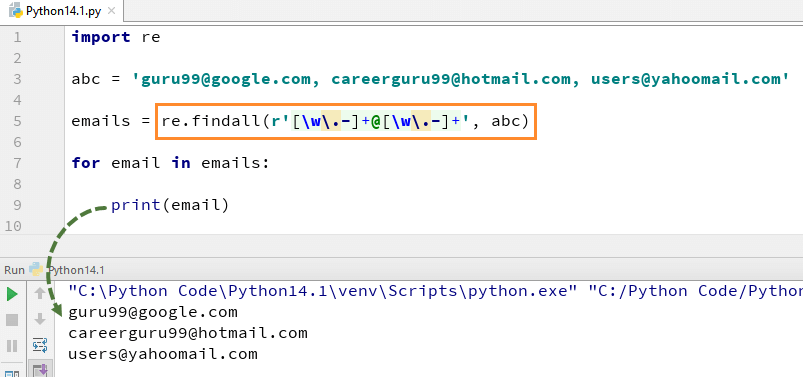
以下是 re.findall() 示例的完整代码
import re

list = ["guru99 get", "guru99 give", "guru Selenium"]
for element in list:
    z = re.match("(g\w+)\W(g\w+)", element)
if z:
    print((z.groups()))

patterns = ['software testing', 'guru99']
text = 'software testing is fun?'
for pattern in patterns:
    print('Looking for "%s" in "%s" ->' % (pattern, text), end=' ')
    if re.search(pattern, text):
        print('found a match!')
else:
    print('no match')
abc = 'guru99@google.com, careerguru99@hotmail.com, users@yahoomail.com'
emails = re.findall(r'[\w\.-]+@[\w\.-]+', abc)
for email in emails:
    print(email)
Python 旗
更多来自Google的 Python Regex 方法和 Regex 函数采用称为 Flags 的可选参数。此标志可以修改给定 Python 正则表达式模式。为了理解这些,我们将看到这些标志的一两个示例。
用于 Python 包括
| 正则表达式标志的语法 | 此标志的作用是什么 |
|---|---|
| [重新.M] | 使开始/结束考虑每一行 |
| [回复我] | 忽略大小写 |
| [回复] | 制作 [ 。 ] |
| [回复.U] | 使 { \w,\W,\b,\B} 遵循 Unicode 规则 |
| [回复.L] | 使 {\w,\W,\b,\B} 遵循语言环境 |
| [回复.X] | 允许在正则表达式中进行评论 |
re.M 或多行标志的示例
在多行中,模式字符 [^] 匹配字符串的第一个字符和每行的开头(紧跟在每个换行符之后)。而表达式小“w”用于用字符标记空格。当您运行代码时,第一个变量“k1”仅打印出单词 guru99 的字符“g”,而当您添加多行标志时,它会提取字符串中所有元素的第一个字符。
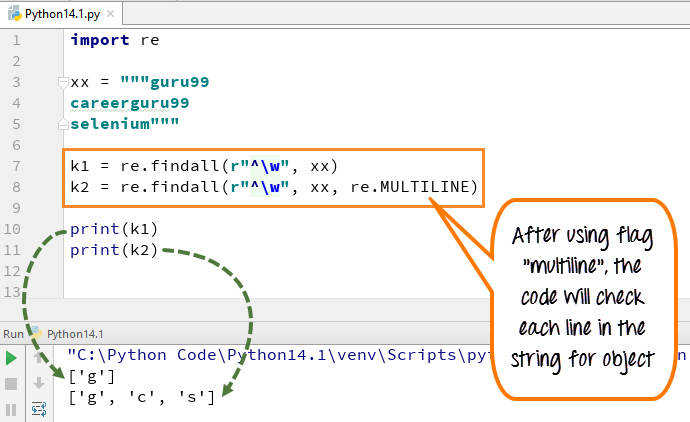
这是代码
import re
xx = """guru99
careerguru99
selenium"""
k1 = re.findall(r"^\w", xx)
k2 = re.findall(r"^\w", xx, re.MULTILINE)
print(k1)
print(k2)
- 我们为字符串“guru99….careerguru99….selenium”声明了变量xx
- 运行代码时不使用多行标志,它只会输出以下行中的“g”
- 使用标志“multiline”运行代码,当你打印“k2”时,它会输出“g”、“c”和“s”
- 因此,我们可以在上面的例子中看到添加多行之后和之前的区别。
同样,您也可以使用其他 Python 标志如 re.U (Unicode)、re.L (遵循区域设置)、re.X (允许评论) 等。
Python 2示例
以上代码是 Python 3 个例子,如果你想跑步 Python 2 请考虑以下代码。
# Example of w+ and ^ Expression
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+",xx)
print r1

# Example of \s expression in re.split function
import re
xx = "guru99,education ">is fun"
r1 = re.findall(r"^\w+", xx)
print (re.split(r'\s','we are splitting the words'))
print (re.split(r's','split the words'))

# Using re.findall for text
import re

list = ["guru99 get", "guru99 give", "guru Selenium"]
for element in list:
    z = re.match("(g\w+)\W(g\w+)", element)
if z:
    print(z.groups())

patterns = ['software testing', 'guru99']
text = 'software testing is fun?'
for pattern in patterns:
    print 'Looking for "%s" in "%s" ->' % (pattern, text),
    if re.search(pattern, text):
        print 'found a match!'
else:
    print 'no match'
abc = 'guru99@google.com, careerguru99@hotmail.com, users@yahoomail.com'
emails = re.findall(r'[\w\.-]+@[\w\.-]+', abc)
for email in emails:
    print email

# Example of re.M or Multiline Flags
import re
xx = """guru99
careerguru99
selenium"""
k1 = re.findall(r"^\w", xx)
k2 = re.findall(r"^\w", xx, re.MULTILINE)
print k1
print k2
测试你的 Python 知识库
1. 哪种方法可用于查找字符串中某个模式的所有出现位置?
- 研究()
- 重新匹配()
- 重新findall()
- 重新分割()
2. \d 字符类在正则表达式中代表什么?
- 任意数字(0-9)
- 任何非数字字符
- 任何空白字符
- 任意字母或数字
3. 你会使用哪个函数来根据空格分割字符串?
- re.split(r'\s',字符串)
- re.findall(r'\w+',字符串)
- re.match(r'\s+',字符串)
- re.split(r'\w+',字符串)
4. re.match() 和 re.search() 的主要区别是什么?
- re.match() 在字符串的开头寻找模式,而 re.search() 在字符串中的任何位置寻找模式。
- re.match() 返回所有匹配项,而 re.search() 返回第一个匹配项。
- re.search() 比 re.match() 更快。
- 两个函数的行为方式相同。
