
Python XML 文件 – 如何读取、写入和解析
 安娜·布莱克
⚡ 智能摘要
Python XML 处理功能允许您使用内置的 minidom 和 ElementTree 模块读取、写入和解析 XML 文档。minidom 类将文件作为 DOM 加载到内存中,而 ElementTree 则提供更快、更高效的处理方式。 Pythonic 树 API。
以下各节涵盖了 XML 文件的解析、写入和读取。 Python.
什么是 XML?
XML 代表可扩展标记语言。它旨在存储和传输少量到中等量的数据,并广泛用于共享结构化信息。
Python 它允许您解析和修改 XML 文档。要解析 XML 文档,您需要将整个 XML 文档加载到内存中。在本教程中,我们将了解如何使用 XML minidom 类。 Python 加载和解析 XML 文件。
如何使用 minidom 解析 XML
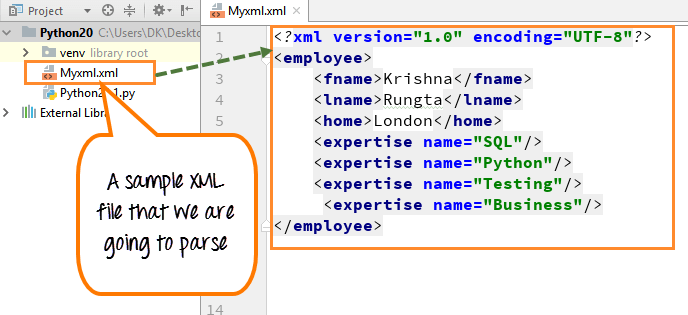
我们已经创建了一个要解析的示例 XML 文件。
步骤 1) 创建示例 XML 文件
在文件中,我们可以看到名字、姓氏、家庭和专业领域(SQL、 Python(测试和业务)。
步骤2)使用解析函数加载并解析XML文件
解析完文档后,我们将打印出文档根节点的“节点名称”和“第一个子节点标签名称”。标签名称和节点名称是 XML 文件的标准属性。
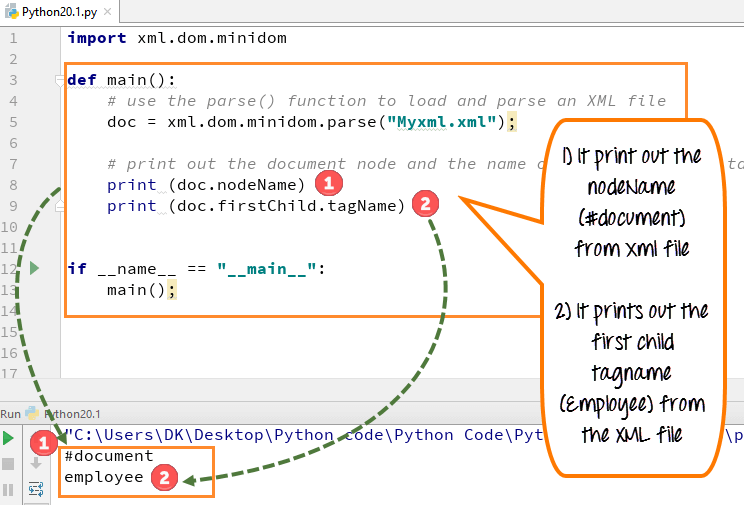
- 导入 xml.dom.minidom 模块并声明要解析的文件(myxml.xml)。
- 该文件包含员工的一些基本信息,如名字、姓氏、家庭、专业知识等。
- 我们使用 XML minidom 上的解析函数来加载和解析 XML 文件
- 我们有一个名为 doc 的变量,doc 会获取解析函数的结果。
- 我们想要打印文件中的节点名和子标签名,因此我们在打印函数中声明了它们。
- 运行代码 - 它从 XML 文件中打印出节点名称 (#document) 以及 XML 文件中的第一个子标记名 (employee)
注意:节点名和子标签名是 XML DOM 的标准名称或属性。
步骤 3)从 XML 文档中调用 XML 标签列表并打印它
接下来,我们还可以从 XML 文档中调用 XML 标签列表并将其打印出来。这里我们打印出了诸如 SQL 之类的技能集。 Python, 测试与验证 和商业。

- 声明变量“专业知识”,我们将从中得出结果。trac员工拥有的所有专业知识名称
- 使用名为“getElementsByTagName”的 dom 标准函数
- 这将获取所有名为 skill 的元素
- 声明一个循环,遍历每个技能标签
- 运行代码——它会列出四项技能。
如何编写 XML 节点
我们可以使用“createElement”函数创建一个新属性,然后将这个新属性或标签附加到现有的 XML 标签中。我们在 XML 文件中添加了一个新标签“BigData”。
- 您需要编写代码,将新属性(BigData)添加到现有的 XML 标签中。
- 然后,您需要打印出附加了新属性的 XML 标签。
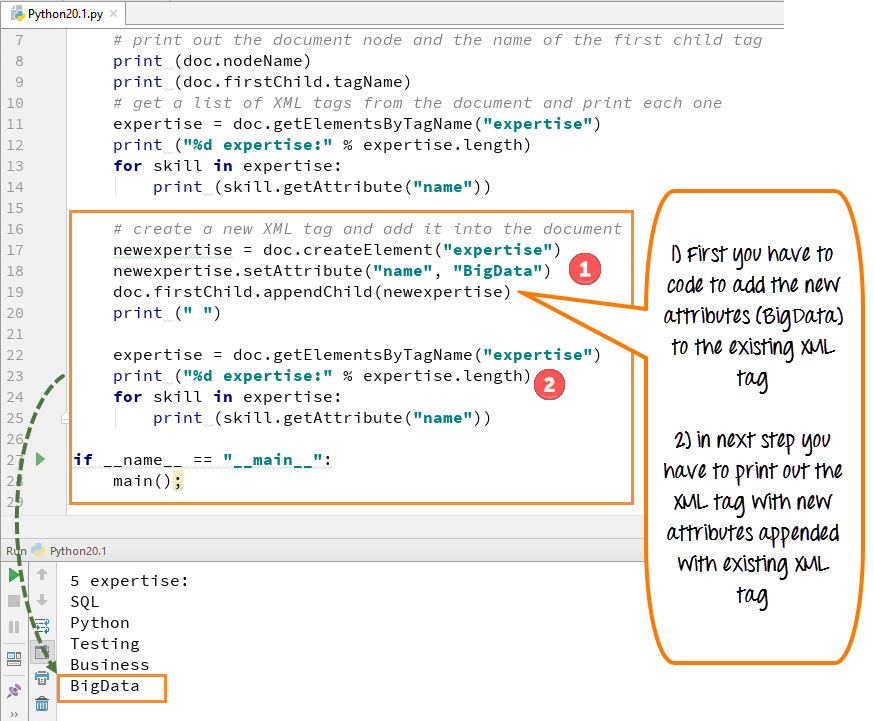
- 要添加新的 XML 标签并将其添加到文档中,我们使用代码“doc.createElement”。
- 这段代码将为我们的新属性“大数据”创建一个新的技能标签。
- 将此技能标签添加到文档的第一个子项(员工)中。
- 运行代码后,新标签“大数据”将与其他专业技能列表一起出现。
XML 解析器示例
Python 2示例
import xml.dom.minidom

def main():
# use the parse() function to load and parse an XML file
   doc = xml.dom.minidom.parse("Myxml.xml");

# print out the document node and the name of the first child tag
   print doc.nodeName
   print doc.firstChild.tagName

# get a list of XML tags from the document and print each one
   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

#Write a new XML tag and add it into the document
   newexpertise = doc.createElement("expertise")
   newexpertise.setAttribute("name", "BigData")
   doc.firstChild.appendChild(newexpertise)
   print " "

   expertise = doc.getElementsByTagName("expertise")
   print "%d expertise:" % expertise.length
   for skill in expertise:
     print skill.getAttribute("name")

if name == "__main__":
  main();
Python 3示例
import xml.dom.minidom

def main():
    # use the parse() function to load and parse an XML file
    doc = xml.dom.minidom.parse("Myxml.xml");

    # print out the document node and the name of the first child tag
    print (doc.nodeName)
    print (doc.firstChild.tagName)
    # get a list of XML tags from the document and print each one
    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

    # Write a new XML tag and add it into the document
    newexpertise = doc.createElement("expertise")
    newexpertise.setAttribute("name", "BigData")
    doc.firstChild.appendChild(newexpertise)
    print (" ")

    expertise = doc.getElementsByTagName("expertise")
    print ("%d expertise:" % expertise.length)
    for skill in expertise:
        print (skill.getAttribute("name"))

if __name__ == "__main__":
    main();
如何使用 ElementTree 解析 XML
ElementTree 是一个用于操作 XML 的 API。ElementTree 提供了一种简便的 XML 文件处理方式。
我们使用以下 XML 文档作为示例数据:
<data>
   <items>
      <item name="expertise1">SQL</item>
      <item name="expertise2">Python</item>
   </items>
</data>
使用 ElementTree 读取 XML:
我们首先需要导入 xml.etree.ElementTree 模块。
import xml.etree.ElementTree as ET
现在让我们获取根元素:
root = tree.getroot()
以下是读取上述 XML 数据的完整代码:
import xml.etree.ElementTree as ET
tree = ET.parse('items.xml')
root = tree.getroot()

# all items data
print('Expertise Data:')

for elem in root:
   for subelem in elem:
      print(subelem.text)
输出:
Expertise Data:
SQL
Python
