
Hadoop Pig 教程:什么是 Apache Pig? Archi结构,示例
 普拉富拉·拉纳戴夫
⚡ 智能摘要
Apache Pig 是一个用于分析 Hadoop 上大型数据集的高级平台,它将 Pig Latin 数据流语言与运行时环境相结合,运行时环境会将每个脚本编译成 MapReduce、Tez 或其他类型的数据。 Spark 自动执行任务。
本教程首先介绍 Apache Pig 的基本概念,然后逐步讲解如何安装它以及如何从头到尾运行一个完整的 Pig Latin 脚本。
什么是阿帕奇猪?
猪是高阶的 编程语言 Pig 非常适合分析大型数据集。它是雅虎公司开发工作的成果。
在 MapReduce 框架中,程序需要被转换成一系列 Map 和 Reduce 阶段。然而,数据分析师并不熟悉这种编程模型。因此,为了弥合这一差距,一种抽象的 MapReduce 框架应运而生。trac名为“猪”的装置建在……之上 Hadoop的.
Apache Pig 让用户能够更专注于分析海量数据集,减少编写 MapReduce 程序的时间。就像猪什么都吃一样,Apache Pig 编程语言旨在处理任何类型的数据。这就是它名字的由来——Pig!下面的项目吉祥物也体现了这一点。

该项目仍在进行中。Apache Pig 0.18.0 于 2025 年 9 月 15 日发布,新增了对 Hadoop 3、Tez 0.10 和 Hive 3 的支持。 Spark 3、HBase 2 和 Python 根据预测,到3年…… Apache Pig 发布页面下面的演练最初是针对较早的 0.12.1 版本编写的,因此有些步骤在当前版本中表现有所不同。
猪 Archi质地
Pig 的架构由两个部分组成:
- 猪拉丁语, 这是一种语言
- 运行时环境, 用于开展猪拉丁语课程。
Pig Latin 程序由一系列操作或转换组成,这些操作或转换应用于输入数据以生成输出。这些操作描述了一个数据流,该数据流由 Hadoop Pig 执行环境转换为可执行表示。本质上,这些转换的结果是一系列…… 映射简化 程序员并不知道的那些工作。因此,从某种意义上说,Hadoop 中的 Pig 让程序员能够专注于数据本身,而不是执行过程。
Pig Latin 是一种相对严谨的语言,它使用数据处理中常见的关键词,例如 Join、Group 和 Filter。下图所示。 traces 是 Grunt shell 中的脚本,经过解析器、优化器和编译器,最终到达执行引擎。

执行模式
Hadoop 中的 Pig 有两种执行模式,下文的安装步骤将使用这两种模式:
- 本地模式: 在这种模式下,Hadoop Pig 语言在单个内存中运行。 JVM 并利用本地文件系统。此模式仅适用于在 Hadoop 中使用 Pig 分析小型数据集。
- MapReduce模式: 在这种模式下,用 Pig Latin 编写的查询会被转换成 MapReduce 作业,并在 Hadoop 集群上运行(集群可以是伪分布式或完全分布式的)。使用完全分布式集群的 MapReduce 模式非常适合在大型数据集上运行 Pig。
这两个是经典的组合。当前版本实际上提供了六种执行类型(或称 exectype),每种执行类型都使用相同的方式选择。 -x 标志,如文档中所述 Pig 0.18.0 入门指南.
| 执行类型 | 命令 | 工作进展 |
|---|---|---|
| 本地 | pig -x 本地 | 针对本地文件系统的单个 JVM |
| Tez 本地 | pig -x tez_local | 使用 Tez 运行时的单个 JVM(实验性) |
| Spark 本地 | pig -x spark_local | 单个 JVM 使用 Spark 运行时(实验性) |
| 映射简化 | pig 或 pig -x mapreduce | 一个带有 HDFS 的 Hadoop 集群;这是默认设置。 |
| TEZ | pig -x tez | 运行 Tez 引擎的 Hadoop 集群 |
| Spark | 猪-x火花 | A SparkYARN 或 Mesos 集群与 HDFS |
Pig Latin 数据类型和 Opera职权范围
编写脚本之前,了解 Pig 可以存储哪些数据以及它可以对这些数据执行哪些操作很有帮助。Pig 的数据模型是完全嵌套的,这使得 Pig 可以读取日志文件和其他关系型表无法读取的松散结构化输入。
Pig Latin 提供两种类型的家庭:
- 标量类型:
int,long,float,double,chararray,bytearray,boolean,datetime,biginteger和bigdecimal后面的示例脚本将每一列都声明为chararray. - 复杂类型: a 元组 是一个有序的字段集合,其行为类似于一行; 袋 是一个无序的元组集合,其行为类似于表格; 地图 是一组键值对,其中键必须是
chararray.
运营商的工作种类不多,其中少数几家几乎负责所有管道的运营:
| Opera器 | 它做什么 |
|---|---|
| 加载/存储 | 从文件系统中读取关系并将结果写回。 |
| FILTER | 仅保留符合条件的元组 |
| 每次…生成 | 逐列工作,创建新字段 |
| 集团/联合集团 | 按键对一个或多个关系进行分组 |
| 注册 | 使用内连接或外连接合并关系 |
| 联合/分裂 | 合并关系,或将一个关系拆分为多个关系 |
| 排序依据 / 唯一值 / 限制 | 对元组进行排序、去重并限制其数量 |
| 转储/描述/解释/举例说明 | 检查结果、模式、执行计划和示例运行 |
四名检查员也都有 Grunt 快捷键,这节省了 typing 调试期间: \d 对于 DUMP, \de 用于描述, \e 用于解释和 \i 举例说明。
硬件需求
Pig 是一个客户端工具。它解析脚本、规划任务并提交作业,但它本身不提供存储或集群,因此必须先有一个可用的 Hadoop 环境。Apache 的要求列表很短。
| 元件 | 需求 | 为什么需要它 |
|---|---|---|
| Hadoop的 | Hadoop 2.x 或 3.x,且已导出 HADOOP_HOME | 提供 HDFS 和执行引擎。如果没有 HADOOP_HOME,Pig 0.18.0 将回退到嵌入式 Hadoop 2.7.3。 |
| Java | Java 1.7 或更高版本,且 JAVA_HOME 设置为安装根目录 | Pig 和 Hadoop 守护进程是 Java 程式 |
| Python (可选) | Python 2.7 | 仅用于流媒体播放 Python 用户自定义函数 |
| 蚂蚁(可选) | 蚂蚁1.8 | 仅在从源代码构建或重新编译 Pig 时需要。 |
除了以上几点,还有两点实际注意事项。首先,所有操作都应该以已拥有主目录的 Linux 用户身份运行。 高密度文件系统 以及向其写入的权限;本教程使用 hduser首先,使用在 Hadoop 设置过程中创建的帐户。其次,在以 MapReduce 模式启动 Pig 之前,请先启动集群,因为如果 NameNode 和 ResourceManager 宕机,Pig 会立即失败。如果 Hadoop 尚未安装,请按照以下步骤操作。 如何安装Hadoop 隐形价值。
如何下载和安装 Pig
现在,在本 Apache Pig 教程中,我们将学习如何下载和安装 Pig:
在开始实际操作之前,请确保已安装 Hadoop。将用户更改为“hduser”(配置 Hadoop 时使用的 ID;您可以切换到您自己的 Hadoop 配置期间使用的用户 ID)。

步骤1) 从以下任一镜像站点下载最新稳定版的 Pig Hadoop:
https://pig.apache.org/releases.html
选择 tar.gz 文件(而不是 src.tar.gz)进行下载,如下所示。

步骤2) 下载完成后,导航到包含下载的tar文件的目录,并将tar文件移动到您想要安装Pig Hadoop的位置。在本例中,我们将移动到/usr/local。

切换到将包含 Pig Hadoop 文件的目录。
cd /usr/local
Extract tar 文件的内容如下所示。
sudo tar -xvf pig-0.12.1.tar.gz

步骤3) 修改 ~/.bashrc 文件,添加与 Pig 相关的环境变量。
使用任意文本编辑器打开 ~/.bashrc 文件,并进行以下修改。
export PIG_HOME=<Installation directory of Pig>
export PATH=$PIG_HOME/bin:$HADOOP_HOME/bin:$PATH

步骤4) 现在,使用以下命令加载此环境配置。
. ~/.bashrc

步骤5) 我们需要重新编译 Pig 以支持 Hadoop 2.2.0。
以下是具体步骤。
进入 Pig 主目录。
cd $PIG_HOME
安装 Ant。
sudo apt-get install ant

注意:下载将开始,下载时间取决于您的网络速度。
重新编译 Pig。
sudo ant clean jar-all -Dhadoopversion=23

请注意,在此重新编译过程中会下载多个组件,因此系统应连接到互联网。
另外,如果此过程卡在某个地方,并且超过 20 分钟后命令提示符没有任何反应,请按 Ctrl + c 并重新运行相同的命令。
就我们而言,需要 20 分钟。

此重新编译步骤属于 0.12.1 版本,当时发布的 jar 包是基于 Hadoop 1 构建的。 -Dhadoopversion=23 该标志将 Ant 构建切换到了 Hadoop 0.23 和 2.x 系列。Apache Pig 0.18.0 提供的二进制文件已经可以在 Hadoop 2.7 及更高版本以及 Hadoop 3 上运行,因此在当前版本中,您通常可以解压 tar 包并直接跳到下面的测试。
步骤6) 使用以下命令测试 Pig 安装
pig -help

Pig 脚本示例
安装好 Pig 之后,本 Apache Pig 教程的其余部分将运行一个完整的脚本。我们将使用 Pig 脚本来查找每个国家/地区的产品销量。
输入:我们的输入数据集是一个CSV文件, 2009 年 XNUMX 月销售额.csv.
步骤1) 启动Hadoop。
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
步骤2) Pig in Big Data 以 MapReduce 模式从 HDFS 获取文件,并将结果存储回 HDFS。
将文件 SalesJan2009.csv(存储在本地文件系统的 ~/input/SalesJan2009.csv)复制到 HDFS(Hadoop 分布式文件系统)主目录。
在这个 Apache Pig 示例中,文件位于名为 input 的文件夹中。如果文件存储在其他位置,请提供该位置的名称。
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/input/SalesJan2009.csv /

确认文件是否已成功复制。
$HADOOP_HOME/bin/hdfs dfs -ls /

步骤3) 猪形配置。
首先,导航到 $PIG_HOME/conf 并保留原始属性文件的副本。
cd $PIG_HOME/conf
sudo cp pig.properties pig.properties.original

使用您选择的文本编辑器打开 pig.properties,并使用 pig.logfile 指定日志文件路径。
sudo gedit pig.properties

日志记录器将使用此文件记录错误。
步骤4) 运行命令“pig”,这将启动 Pig 命令提示符,这是一个用于 Pig 查询的交互式 shell。
pig

步骤5) 在 Grunt 的 Pig 命令提示符中,按顺序执行以下 Pig 命令。
— A. 加载包含数据的文件。
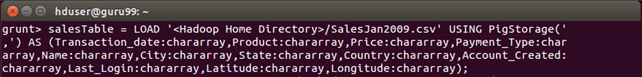
salesTable = LOAD '/SalesJan2009.csv' USING PigStorage(',') AS (Transaction_date:chararray,Product:chararray,Price:chararray,Payment_Type:chararray,Name:chararray,City:chararray,State:chararray,Country:chararray,Account_Created:chararray,Last_Login:chararray,Latitude:chararray,Longitude:chararray);
执行此命令后按 Enter。
— B. 按“国家/地区”字段对数据进行分组。
GroupByCountry = GROUP salesTable BY Country;

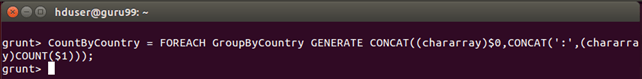
— C. 对于“GroupByCountry”中的每个元组,生成如下形式的结果字符串:国家名称:产品销售数量。
CountByCountry = FOREACH GroupByCountry GENERATE CONCAT((chararray)$0,CONCAT(':',(chararray)COUNT($1)));
执行此命令后按 Enter。
— D. 将数据流的结果存储在 HDFS 上的“pig_output_sales”目录中。
STORE CountByCountry INTO 'pig_output_sales' USING PigStorage('\t');

此命令需要一些时间才能执行完毕。完成后,您应该会看到以下屏幕。

步骤6) 结果可以通过命令行界面查看。
$HADOOP_HOME/bin/hdfs dfs -cat pig_output_sales/part-r-00000

也可以通过网页界面查看结果。
在网页浏览器中打开 http://localhost:50070/。
Hadoop 2 的 NameNode Web UI 端口为 50070。Hadoop 3 将同一页面移至端口 9870,因此如果您的集群运行的是 Hadoop 3,请使用该地址。

现在选择“浏览文件系统”,然后导航到 /user/hduser/pig_output_sales。

打开 part-r-00000 以读取脚本生成的国家/地区和产品数量对。

Apache Pig、Hive 和 MapReduce 的比较
Pig 很少单独进行评估。通常的问题是,一项工作是否属于 Pig 范畴,还是属于其他范畴。 蜂房 或者用手写 MapReduce 程序来实现,因为这三者最终都会成为同一集群上的作业。
| 方面 | MapReduce(Java) | 阿帕奇猪 | 阿帕奇蜂巢 |
|---|---|---|---|
| 接口 | Java API | Pig Latin,一种数据流脚本语言 | 蜂巢QL,一种 SQL 方言 |
| 腹肌水平tracTION | 低 | 中 | 高 |
| 典型用户 | Java 开发人员 | 数据工程师或研究员 | 熟悉 SQL 的分析师 |
| 数据适合 | 任何事,都由人工处理。 | 结构化和半结构化;加载时模式是可选的 | 元数据存储中注册的结构化表 |
| Code 体积 | 大部分线路 | 更少的行 | 查询语句最少 |
| 运行方式 | MapReduce作业 | 编译为 MapReduce、Tez 或 Spark 工作 | 编译为 MapReduce、Tez 或 Spark 工作 |
| 最擅长 | 完全控制和自定义逻辑 | 多步骤 ETL 流水线 | 即席查询和报告 |
实际上,划分很简单。当数据已经像表格一样结构化,而查询语句看起来像 SQL 时,就选择 Hive。当输入数据混乱、管道是一系列转换而非单个查询,或者同一个脚本需要分支和重连接时,就选择 Pig。只有当两者都不符合要求时,才选择 MapReduce。traction 可以表达逻辑,因为行数增长很快。
猪在生态系统中也与其他动物相处融洽。 Sqoop 和 Flume 获取原始数据,使用 Pig 或 Hive 对其进行处理,然后由调度器(例如)进行调度。 Apache Oozie 将这些步骤串联成一个可重复的流程。要了解这些工具的更广泛应用场景,请参阅指南。 大数据 以及综述 大数据工具;如需了解替代手写脚本的商业 ETL 方案,请参阅 拓蓝.
