
贪婪算法示例:什么是贪婪算法、方法和途径
 编辑团队
什么是贪婪算法?
A 贪心算法 递归地根据资源在执行的任何阶段的最大即时可用性来划分一组资源。
用贪婪算法解决问题分为两个阶段:
- 扫描物品清单
- 优化
这两个阶段并行运行,输入数组被逐步分割。
要遵循贪婪算法,掌握递归和上下文切换的基本知识会有所帮助。 trac例如,代码。贪婪算法可以用一对必要条件和充分条件来描述。
两个条件定义了贪婪范式。
- 每一步选择都必须引导问题朝着最佳解决方案发展。
- 问题结构必须在有限数量的贪婪步骤后停止。
有了理论基础,让我们来看看贪婪搜索方法的历史。
贪婪的历史 Algorithms
以下是贪婪算法发展史上的重要里程碑:
- 贪婪算法最初是在 20 世纪 50 年代为图游走算法而提出的。
- 艾德斯格·迪克斯特拉开发了他的最短路径算法,以缩短穿越荷兰首都阿姆斯特丹的路线。
- 在同一时期,Prim 和 Kruskal 开发了优化策略,以最小化加权路径上的路径成本来构建最小生成树。
- 20世纪70年代,美国研究人员Cormen、Leiserson、Rivest和Stein在他们的经典著作中描述了贪婪解的递归子结构。 Introduction to Algorithms 教科书。
- 贪婪搜索范式于 2005 年被美国国家标准与技术研究院 (NIST) 记录收录为一种独特的优化策略。
- 时至今日,诸如开放最短路径优先 (OSPF) 之类的 Web 协议和许多数据包交换协议仍然使用贪婪策略来最大限度地减少网络上的传输时间。
贪婪策略和决策
逻辑简化为每个阶段的二元选择——“贪婪”或“不贪婪”——取决于算法前进的方向。
例如,Dijkstra 算法通过在每一步评估成本函数来识别互联网上的主机。成本函数返回的值决定了下一条路径是“贪婪”路径还是“非贪婪”路径。
简而言之,当算法采取的步骤不是局部最优解时,它就不再贪婪了;贪婪问题在没有进一步贪婪步骤可做时就会停止。
贪婪算法的特点
贪婪算法的重要特征是:
- 资源的有序列表带有成本或价值属性,用于量化系统所受到的约束。
- 该算法在满足时间限制的前提下,尽可能多地获取资源。
- 例如,在活动调度问题中,资源成本以小时为单位进行衡量,并且活动必须按顺序执行。

为什么要采用贪婪算法?
以下是使用贪婪方法的原因:
- 贪婪算法的优缺点使其非常适合用于优化。
- 最显而易见的原因是为了尽快找到可行的解决方案。在下文讨论的活动选择问题中,如果当前活动完成之前有更多活动可以安排,则可以将它们安排在同一时间段内。
- 另一个原因是它根据条件递归地分解问题,无需合并子解。
- 在活动选择问题中,递归划分步骤是通过扫描列表一次并仅考虑符合条件的活动来实现的。
如何解决活动选择问题
在活动调度示例中,每个活动都有开始时间和结束时间,并用一个编号进行索引以便于查找。活动分为两类:
- 考虑的活动: 以此为基准来衡量完成更多剩余活动的能力。
- 剩余活动: 在所考虑的活动之前一个或多个索引处进行的活动。
执行一项活动的成本是其持续时间,计算方法为(完成时间 - 开始时间)。
贪婪程度是指在考虑的活动时间内可以执行的剩余活动的数量。
Archi贪婪方法的结构
步骤1) 从索引 0 开始扫描活动成本列表,索引 0 为考虑的索引。
步骤2) 当考虑的活动结束时,如果还有其他活动可以完成,则寻找这些剩余的活动。
步骤3) 如果无法安排更多活动,则当前剩余的活动将成为下一个考虑的活动。对新的考虑活动重复步骤 1 和步骤 2。如果没有剩余活动,则转到步骤 4。
步骤4) 返回所考虑索引的并集——这些是能够最大化吞吐量的活动索引。

Archi贪婪方法的结构
Code 说明
#include<iostream>
#include<stdio.h>
#include<stdlib.h>

#define MAX_ACTIVITIES 12

代码说明:
- 包含的头文件/类
- 用户可配置活动的最大数量。
using namespace std;

class TIME
{
    public:
    int hours;

    public: TIME()
    {
   	 hours = 0;
    }
};

代码说明:
- 声明流式操作的标准命名空间。
- TIME 类定义
- 一小时时间戳。
- TIME 默认构造函数
- 小时变量。
class Activity
{
    public:
    int index;
    TIME start;
    TIME finish;

    public: Activity()
    {
   	 start = finish = TIME();
    }
};

代码说明:
- Activity 类的定义。
- 共同定义持续时间的多个时间戳。
- 默认构造函数中所有时间戳均初始化为 0。
class Scheduler
{
    public:
    int considered_index,init_index;
    Activity *current_activities = new    Activity[MAX_ACTIVITIES];
    Activity *scheduled;

代码说明:
- 调度程序类定义的第一部分。
- consider_index 是扫描数组的起始点。
- init_index 用于在设置过程中分配随机时间戳。
- 使用 new 运算符动态分配 Activity 对象数组。
- 已安排指针保存着当前的贪婪算法结果。
Scheduler()
{
   	 considered_index = 0;
   	 scheduled = NULL;
...
...
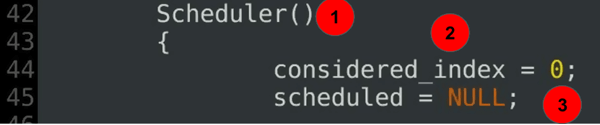
代码说明:
- Scheduler 构造函数——类定义的第 2 部分。
- consider_index 标记当前扫描的开始。
- 贪婪程度在开始时未定义。
for(init_index = 0; init_index < MAX_ACTIVITIES; init_index++) { current_activities[init_index].start.hours = rand() % 12; current_activities[init_index].finish.hours = current_activities[init_index].start.hours + (rand() % 2); printf("\nSTART:%d END %d\n", current_activities[init_index].start.hours ,current_activities[init_index].finish.hours); } … …
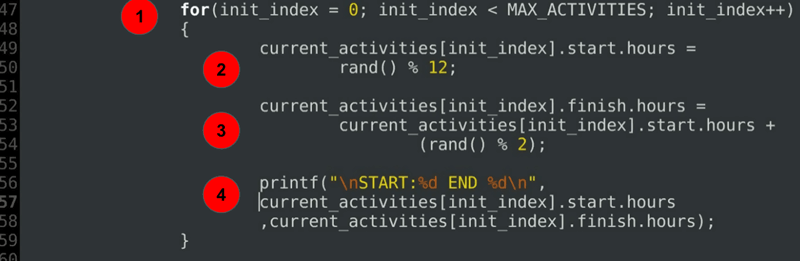
代码说明:
- for 循环初始化每个计划活动的开始时间和结束时间。
- 初始化开始时间。
- 将结束时间初始化为等于或晚于开始时间。
- 调试语句会打印出已分配的持续时间。
	public:
   		 Activity * activity_select(int);
};
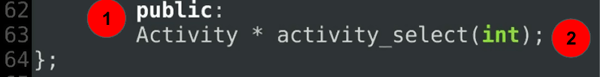
代码说明:
- 第 4 部分——调度器类定义的最后一部分。
- activity_select() 以起始索引为基础,将贪婪任务分解为子问题。
Activity * Scheduler :: activity_select(int considered_index)
{
    this->considered_index = considered_index;
    int greedy_extent = this->considered_index + 1;
…
…

- 作用域解析运算符(::)将函数定义链接到 Scheduler 类。
- consider_index 按值传递,greedy_extent 初始化为紧随其后的索引。
Activity * Scheduler :: activity_select(int considered_index) { while( (greedy_extent < MAX_ACTIVITIES ) && ((this->current_activities[greedy_extent]).start.hours < (this->current_activities[considered_index]).finish.hours )) { printf("\nSchedule start:%d \nfinish%d\n activity:%d\n", (this->current_activities[greedy_extent]).start.hours, (this->current_activities[greedy_extent]).finish.hours, greedy_extent + 1); greedy_extent++; } … ...

代码说明:
- 核心逻辑——贪婪程度上限为 MAX_ACTIVITIES。
- 将当前活动的开始时间与所考虑活动的结束时间进行比较。
- 当条件成立时,会打印一条可选的调试语句。
- 贪婪范围随后会推进到活动数组中的下一个索引。
...
if ( greedy_extent <= MAX_ACTIVITIES )
    {

   	 return activity_select(greedy_extent);
    }
    else
    {
   	 return NULL;
    }
}

代码说明:
- 该条件检查是否所有活动都已涵盖。
- 否则,算法将从当前索引重新开始贪婪搜索——这是一个递归步骤,贪婪地分解问题。
- 如果是,则控制权返回给调用者,没有扩展贪婪的范围。
int main()
{
    Scheduler *activity_sched = new Scheduler();
    activity_sched->scheduled = activity_sched->activity_select(
   				activity_sched->considered_index);
    return 0;
}

代码说明:
- 主函数调用调度器。
- 一个新的 Scheduler 对象被实例化。
- activity_select() 函数会在贪婪任务结束后向调用者返回一个 Activity 指针。
输出:
START:7 END 7

START:9 END 10

START:5 END 6

START:10 END 10

START:9 END 10

Schedule start:5
finish6
 activity:3

Schedule start:9
finish10
 activity:5
贪婪技术的局限性
贪婪算法不适用于需要为每个子问题找到最优解的问题,例如排序问题。
在这种情况下,贪婪算法可能会出错——最坏的情况下,它会产生一个非最优解。
贪婪算法的核心缺点在于,它们在不知道当前贪婪状态之后会发生什么的情况下做出选择。
下图说明了贪婪算法的这一缺点。

在图中所示的贪婪扫描(以树状图表示,数值越高,贪婪程度越高)中,数值为 40 的算法接下来会选择 29,然后结束于 12,总共选择 41。
相比之下,分而治之的策略会先投入 25 个单位,再投入 40 个单位,总共投入 65 个单位,比局部贪婪策略高出 24 个单位。
贪婪的例子 Algorithms
大多数网络算法都依赖于贪婪算法。常见的贪婪算法示例包括:
- Prim 最小生成树算法
- 旅行商问题(近似)
- 图表着色
- Kruskal最小生成树算法
- 迪杰斯特拉最短路径算法
- 图顶点覆盖
- 背包问题
- 带截止日期的工作排序
