
二分查找算法示例
 编辑团队
在学习二分查找之前,我们先来了解一下什么是查找。
什么是搜索?
搜索是一种实用程序,可让用户查找数据库中保存的文档、文件、媒体或任何其他类型的数据。搜索的工作原理很简单,就是将条件与记录匹配并将其显示给用户。这样,最基本的搜索功能就可以正常工作。
什么是二分搜索?
二分查找是一种高级搜索算法,用于从已排序的列表中查找和获取数据。其核心工作原理是将列表中的数据分成两半,直到找到所需值并将其显示在搜索结果中。二分查找通常被称为…… 半区间搜索 或者 对数搜索.
二分查找如何工作?
二分查找的工作方式如下:
- 搜索过程首先定位已排序数据数组的中间元素。
- 之后,将键值与元素进行比较。
- 如果键值小于中间元素,则搜索会分析较大的值与中间元素进行比较和匹配。
- 如果键值大于中间元素,则搜索会分析较小的值与中间元素进行比较和匹配。
二分查找算法(伪代码)
二分查找可以写成一个简短的迭代程序。它维护两个指针,low 和 high,并不断缩小范围,直到找到目标或范围为空为止。
binarySearch(array, target)
    low = 0
    high = length(array) - 1
    while low <= high
        mid = (low + high) / 2      // floor value
        if array[mid] == target
            return mid
        else if array[mid] < target
            low = mid + 1
        else
            high = mid - 1
    return -1              // target not found
该例程在成功时返回目标索引,在目标不存在时返回 -1。由于每次遍历范围减半,因此循环最多运行 log₂(n) 次。
二分查找示例
我们来看一个字典的例子。如果你需要查找某个单词,没有人会按顺序浏览每个单词,而是随机找到最近的单词来搜索所需的单词。
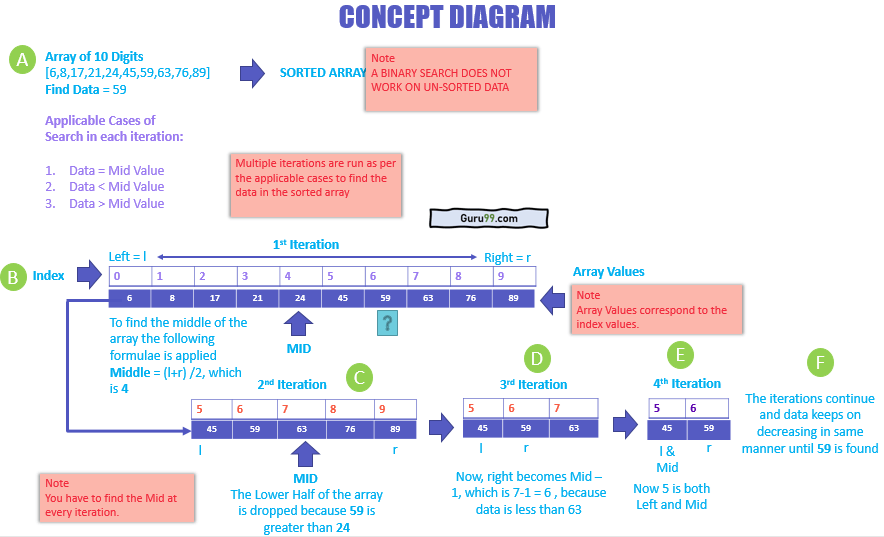
上图说明了以下内容:
- 您有一个 10 位数字的数组,需要找到元素 59。
- 所有元素都用 0 到 9 的索引标记。现在,我们需要计算数组的中间值。为此,取索引最左边和最右边的值,然后将它们除以 2。结果是 4.5,但我们取向下取整的值。因此,中间值是 4。
- 该算法删除了从中间(4)到下限的所有元素,因为 59 大于 24,现在数组只剩下 5 个元素。
- 现在,59 大于 45 且小于 63。中间值是 7。因此,右侧索引值变为中间值减 1,等于 6,左侧索引值保持不变,仍为 5。
- 此时,您知道 59 在 45 之后。因此,左边的索引 5 也成为中间。
- 这些迭代持续到数组减少到只有一个元素,或者要查找的项目成为数组的中间。
例子2
让我们来看下面的例子来理解二分查找的工作原理。

- 您有一个排序好的数组,其值范围是从 2 到 20,您需要找到 18。
- 下限和上限的平均值为 (l + r) / 2 = 4。所查找的值大于中位数 4。
- 小于中间值的数组值将被排除在搜索范围之外,大于中间值 4 的值将被搜索。
- 这是一个循环的划分过程,直到找到实际要搜索的项目。
为什么我们需要二分查找?
以下原因使得二分查找成为更佳的搜索算法选择:
- 无论数据量大小,二分查找对已排序的数据都能高效运行。
- 二进制算法不是按顺序遍历数据进行搜索,而是随机访问数据以查找所需元素。这使搜索周期更短且更准确。
- 二分查找根据排序原则对已排序的数据进行比较,而不是使用相等性比较,后者速度较慢且大多不准确。
- 每次搜索循环结束后,算法都会将数组的大小减半;因此,在下一次迭代中,它将只处理数组的剩余一半。
请学习我们的下一个教程 线性搜索: Python, C++ 例如:.
二分查找与线性查找
二分查找和线性查找是查找集合中值的两种最常用方法。下表突出了它们的区别:
| 方面 | 二进制搜索 | 线性搜寻 |
|---|---|---|
| 数据要求 | 需要已排序的数据 | 适用于已排序或未排序的数据 |
| 付款方式 | 每一步将搜索范围减半 | 按顺序检查每个元素 |
| 时间复杂度 | O(log n) | O(N) |
| 最适合 | 大型、已排序的数据集 | 小型或未分类的数据集 |
简而言之,二分查找在大规模有序数据上速度快得多,而线性查找更简单,并且是数据未排序时的唯一选择。
