
Hướng dẫn Scikit-Learn: Cách cài đặt và ví dụ về Scikit-Learn
 Evelyn Clarke
⚡ Tóm tắt thông minh
Scikit-learn là thư viện mã nguồn mở. Python Thư viện này bao gồm các bước tiền xử lý, phân loại, hồi quy, phân cụm và lựa chọn mô hình, tất cả đều được hỗ trợ bởi một giao diện ước lượng nhất quán duy nhất, giúp cho toàn bộ quy trình học máy trở nên ngắn gọn, dễ đọc và có thể tái tạo được, từ dữ liệu thô đến các dự đoán đã được chấm điểm.
Scikit-learning là gì?
Học hỏi là một nguồn mở Python thư viện cho học máyNó hỗ trợ các thuật toán đã được khẳng định như KNN, gradient boosting, random forest và SVM, và được xây dựng dựa trên nền tảng của... numpy và SciPy. Scikit-learn được sử dụng rộng rãi trong các cuộc thi Kaggle cũng như trong các công ty công nghệ nổi tiếng. Nó bao gồm các bước tiền xử lý, giảm chiều dữ liệu, phân loại, hồi quy, phân cụm và lựa chọn mô hình.
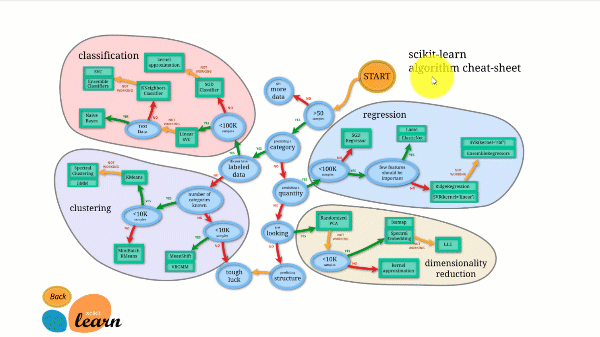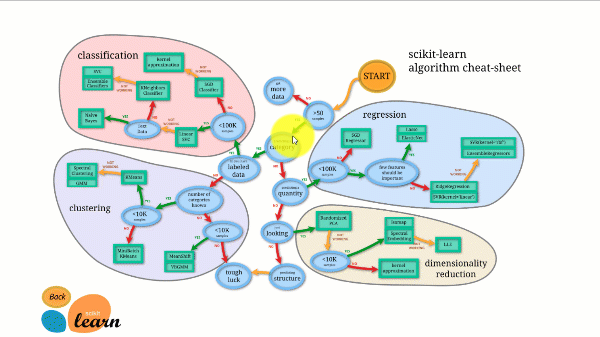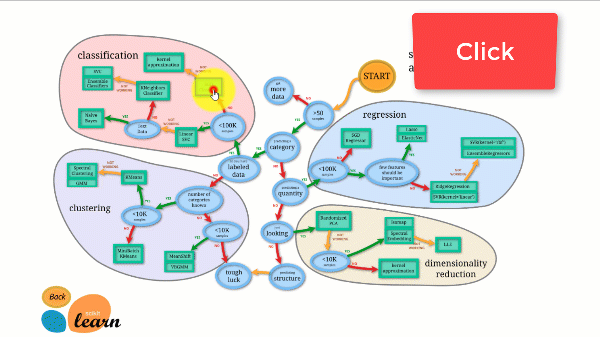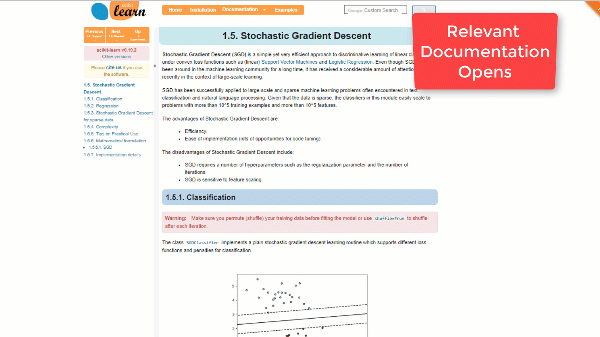
Scikit-learn có một trong những tài liệu hướng dẫn tốt nhất trong số các thư viện mã nguồn mở. Nó thậm chí còn cung cấp một biểu đồ ước lượng tương tác. Lựa chọn công cụ ước tính phù hợpCông cụ này sẽ hướng dẫn bạn từ kích thước tập dữ liệu đến danh sách rút gọn các thuật toán đáng thử.
Hình dưới đây minh họa cách thức hoạt động của Scikit-learn.
Scikit-learn không khó sử dụng và cho kết quả xuất sắc. Tuy nhiên, nó huấn luyện trên CPU: công việc được song song hóa trên các lõi bằng đối số n_jobs thay vì trên GPU. Chạy thuật toán học sâu với nó là khả thi nhưng hiếm khi tối ưu, đặc biệt nếu bạn đã biết cách sử dụng các thư viện khác. TensorFlow.
Cách tải xuống và cài đặt Scikit-learn
Bây giờ trong này Python Hướng dẫn Scikit-learn, bạn sẽ học cách tải xuống và cài đặt Scikit-learn:
Phương án 1: AWS
Scikit-learn có thể được sử dụng trên AWS. Một ảnh Docker đã cài đặt sẵn scikit-learn sẽ giúp tiết kiệm hoàn toàn công sức thiết lập.
Để cài đặt phiên bản dành cho nhà phát triển, hãy chạy lệnh bên dưới. Jupyter:
import sys
!{sys.executable} -m pip install git+git://github.com/scikit-learn/scikit-learn.git
Phương án 2: Mac hoặc Windows sử dụng Anaconda
Để tìm hiểu về cách cài đặt Anaconda, hãy tham khảo tài liệu sau: Hướng dẫn cách tải xuống và cài đặt TensorFlow.
Tại thời điểm viết hướng dẫn này, các nhà phát triển của scikit đã phát hành một phiên bản phát triển khắc phục các sự cố có trong phiên bản hiện tại, vì vậy các bước dưới đây sử dụng bản dựng dành cho nhà phát triển đó. Trên một máy tính mới hiện nay, phiên bản ổn định hiện tại đã bao gồm tất cả các bộ chuyển đổi được sử dụng ở đây, và pip install -U scikit-learn Là đủ.
Cách cài đặt scikit-learn với Môi trường Conda
Nếu bạn đã cài đặt scikit-learn bằng môi trường conda, hãy làm theo các bước bên dưới để cập nhật lên phiên bản 0.20.
Bước 1) Kích hoạt môi trường TensorFlow
source activate hello-tf
Bước 2) Gỡ bỏ scikit-learn bằng lệnh conda.
conda remove scikit-learn
Bước 3) Cài đặt phiên bản dành cho nhà phát triển
Cài đặt phiên bản dành cho nhà phát triển của scikit-learn cùng với các thư viện cần thiết.
conda install -c anaconda git
pip install Cython
pip install h5py
pip install git+git://github.com/scikit-learn/scikit-learn.git
LƯU Ý: Windows người dùng cần Microsoft Hình ảnh C++ 14. Bạn có thể có được nó đây.
Ví dụ về Scikit-Learn với Machine Learning
Hướng dẫn Scikit này được chia thành hai phần:
- Học máy với scikit-learn
- Cách tin cậy mô hình của bạn với LIME
Phần đầu tiên trình bày chi tiết cách xây dựng một pipeline, tạo mô hình và tinh chỉnh các siêu tham số, trong khi phần thứ hai đề cập đến việc giải thích kết quả mô hình.
Bước 1) Nhập dữ liệu
Trong bài hướng dẫn Scikit learn này, bạn sẽ sử dụng bộ dữ liệu điều tra dân số người trưởng thành.
Tệp được đọc trực tiếp từ Kho lưu trữ Học máy UCI trong đoạn mã bên dưới, vì vậy không cần tải xuống thủ công. Nếu bạn quan tâm đến số liệu thống kê mô tả, các công cụ Dive và Overview rất đáng để xem xét. Tham khảo thêm tại... hướng dẫn này Để tìm hiểu thêm về Lặn và Tổng quan.
Bạn nhập tập dữ liệu bằng pandas. Lưu ý rằng bạn cần chuyển đổi các biến liên tục sang định dạng số thực.
Tập dữ liệu này bao gồm tám biến phân loại, được liệt kê trong CATE_FEATURES:
- lớp học nghề
- giáo dục
- hôn nhân
- nghề nghiệp
- mối quan hệ
- cuộc đua
- quan hệ tình dục
- quê hương
Nó cũng bao gồm sáu biến liên tục, được liệt kê trong CONTI_FEATURES:
- tuổi
- fnlwgt
- giáo dục_num
- tăng vốn
- vốn_lỗ
- giờ_tuần
Các danh sách ở đây được điền thủ công để bạn có cái nhìn rõ ràng hơn về các cột đang được sử dụng. Một cách nhanh hơn để lập danh sách các cột phân loại hoặc liên tục là:
## List Categorical
CATE_FEATURES = df_train.iloc[:,:-1].select_dtypes('object').columns
print(CATE_FEATURES)

## List continuous
CONTI_FEATURES =  df_train._get_numeric_data()
print(CONTI_FEATURES)
Đây là mã để nhập dữ liệu:
# Import dataset
import pandas as pd

## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country', 'label']
### Define continuous list
CONTI_FEATURES  = ['age', 'fnlwgt','capital_gain', 'education_num', 'capital_loss', 'hours_week']
### Define categorical list
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']

## Prepare the data
features = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country']

PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"

df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_train[CONTI_FEATURES] =df_train[CONTI_FEATURES].astype('float64')
df_train.describe()
Gọi hàm describe() trên khung sẽ trả về số liệu thống kê tóm tắt cho sáu cột liên tục:
| tuổi | fnlwgt | giáo dục_num | tăng vốn | vốn_lỗ | giờ_tuần | |
|---|---|---|---|---|---|---|
| tính | 32561.000000 | 3.256100e + 04 | 32561.000000 | 32561.000000 | 32561.000000 | 32561.000000 |
| nghĩa là | 38.581647 | 1.897784e + 05 | 10.080679 | 1077.648844 | 87.303830 | 40.437456 |
| tiêu chuẩn | 13.640433 | 1.055500e + 05 | 2.572720 | 7385.292085 | 402.960219 | 12.347429 |
| phút | 17.000000 | 1.228500e + 04 | 1.000000 | 0.000000 | 0.000000 | 1.000000 |
| 25% | 28.000000 | 1.178270e + 05 | 9.000000 | 0.000000 | 0.000000 | 40.000000 |
| 50% | 37.000000 | 1.783560e + 05 | 10.000000 | 0.000000 | 0.000000 | 40.000000 |
| 75% | 48.000000 | 2.370510e + 05 | 12.000000 | 0.000000 | 0.000000 | 45.000000 |
| tối đa | 90.000000 | 1.484705e + 06 | 16.000000 | 99999.000000 | 4356.000000 | 99.000000 |
Bạn có thể kiểm tra số lượng giá trị duy nhất của thuộc tính native_country. Chỉ có một hộ gia đình đến từ Hà Lan. Hộ gia đình đó không cung cấp thông tin nào và sẽ gây ra lỗi trong quá trình huấn luyện.
df_train.native_country.value_counts()
United-States                 29170
Mexico                          643
?                               583
Philippines                     198
Germany                         137
Canada                          121
Puerto-Rico                     114
El-Salvador                     106
India                           100
Cuba                             95
England                          90
Jamaica                          81
South                            80
China                            75
Italy                            73
Dominican-Republic               70
Vietnam                          67
Guatemala                        64
Japan                            62
Poland                           60
Columbia                         59
Taiwan                           51
Haiti                            44
Iran                             43
Portugal                         37
Nicaragua                        34
Peru                             31
France                           29
Greece                           29
Ecuador                          28
Ireland                          24
Hong                             20
Cambodia                         19
Trinadad&Tobago                  19
Thailand                         18
Laos                             18
Yugoslavia                       16
Outlying-US(Guam-USVI-etc)       14
Honduras                         13
Hungary                          13
Scotland                         12
Holand-Netherlands                1
Name: native_country, dtype: int64
Bạn có thể loại bỏ hàng không chứa thông tin này khỏi tập dữ liệu:
## Drop Netherland, because only one row
df_train = df_train[df_train.native_country != "Holand-Netherlands"]
Tiếp theo, bạn lưu trữ vị trí của các đối tượng liên tục trong danh sách. Bạn sẽ cần nó trong bước tiếp theo để xây dựng quy trình.
Đoạn mã bên dưới sẽ lặp qua tất cả các tên cột trong CONTI_FEATURES, đọc từng vị trí (tức là số thứ tự cột) và thêm nó vào một danh sách có tên là conti_features.
## Get the column index of the categorical features
conti_features = []
for i in CONTI_FEATURES:
    position = df_train.columns.get_loc(i)
    conti_features.append(position)
print(conti_features)
[0, 2, 10, 4, 11, 12]
Khối lệnh tiếp theo thực hiện công việc tương tự đối với các biến phân loại.
## Get the column index of the categorical features
categorical_features = []
for i in CATE_FEATURES:
    position = df_train.columns.get_loc(i)
    categorical_features.append(position)
print(categorical_features)
[1, 3, 5, 6, 7, 8, 9, 13]
Bây giờ hãy xem xét chính tập dữ liệu. Mỗi đặc trưng phân loại là một chuỗi ký tự, và mô hình không thể nhận giá trị chuỗi ký tự, vì vậy tập dữ liệu phải được biến đổi bằng các biến giả.
df_train.head(5)
Thực tế, bạn cần một cột cho mỗi nhóm trong mỗi thuộc tính. Trước tiên, hãy chạy đoạn mã bên dưới để tính tổng số cột cần thiết.
print(df_train[CATE_FEATURES].nunique(),
      'There are',sum(df_train[CATE_FEATURES].nunique()), 'groups in the whole dataset')
workclass          9
education         16
marital            7
occupation        15
relationship       6
race               5
sex                2
native_country    41
dtype: int64 There are 101 groups in the whole dataset
Toàn bộ tập dữ liệu chứa 101 nhóm, như đã hiển thị ở trên. Riêng đặc trưng "workclass" đã có chín nhóm. Bạn có thể liệt kê tên các nhóm bằng đoạn mã bên dưới; hàm `unique()` trả về các giá trị khác nhau của mỗi đặc trưng phân loại.
for i in CATE_FEATURES:
    print(df_train[i].unique())
['State-gov' 'Self-emp-not-inc' 'Private' 'Federal-gov' 'Local-gov' '?'
 'Self-emp-inc' 'Without-pay' 'Never-worked']
['Bachelors' 'HS-grad' '11th' 'Masters' '9th' 'Some-college' 'Assoc-acdm'
 'Assoc-voc' '7th-8th' 'Doctorate' 'Prof-school' '5th-6th' '10th'
 '1st-4th' 'Preschool' '12th']
['Never-married' 'Married-civ-spouse' 'Divorced' 'Married-spouse-absent'
 'Separated' 'Married-AF-spouse' 'Widowed']
['Adm-clerical' 'Exec-managerial' 'Handlers-cleaners' 'Prof-specialty'
 'Other-service' 'Sales' 'Craft-repair' 'Transport-moving'
 'Farming-fishing' 'Machine-op-inspct' 'Tech-support' '?'
 'Protective-serv' 'Armed-Forces' 'Priv-house-serv']
['Not-in-family' 'Husband' 'Wife' 'Own-child' 'Unmarried' 'Other-relative']
['White' 'Black' 'Asian-Pac-Islander' 'Amer-Indian-Eskimo' 'Other']
['Male' 'Female']
['United-States' 'Cuba' 'Jamaica' 'India' '?' 'Mexico' 'South'
 'Puerto-Rico' 'Honduras' 'England' 'Canada' 'Germany' 'Iran'
 'Philippines' 'Italy' 'Poland' 'Columbia' 'Cambodia' 'Thailand' 'Ecuador'
 'Laos' 'Taiwan' 'Haiti' 'Portugal' 'Dominican-Republic' 'El-Salvador'
 'France' 'Guatemala' 'China' 'Japan' 'Yugoslavia' 'Peru'
 'Outlying-US(Guam-USVI-etc)' 'Scotland' 'Trinadad&Tobago' 'Greece'
 'Nicaragua' 'Vietnam' 'Hong' 'Ireland' 'Hungary']
Do đó, tập dữ liệu huấn luyện sẽ chứa 101 + 6 cột: các nhóm one-hot cộng với sáu đặc trưng liên tục.
Scikit-learn có thể thực hiện việc chuyển đổi này theo hai bước:
- Chuyển đổi chuỗi ký tự thành ID. "State-gov" trở thành ID 1, "Self-emp-not-inc" trở thành ID 2, v.v. LabelEncoder sẽ thực hiện việc này cho bạn.
- Chuyển vị mỗi ID vào một cột mới. Tập dữ liệu có 101 ID nhóm, vì vậy sẽ có 101 cột thể hiện mọi nhóm đặc trưng phân loại. Scikit-learn cung cấp OneHotEncoder cho thao tác này.
Bước 2) Tạo tập huấn luyện/kiểm tra
Bây giờ tập dữ liệu đã sẵn sàng, hãy chia nó theo tỷ lệ 80/20: 80% cho tập huấn luyện và 20% cho tập kiểm tra.
Bạn có thể sử dụng `train_test_split`. Tham số đầu tiên là dataframe chứa các đặc trưng và tham số thứ hai là nhãn. Bạn thiết lập kích thước của tập dữ liệu kiểm tra bằng `test_size`.
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(df_train[features],
                                                    df_train.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train.head(5)
print(X_train.shape, X_test.shape)
(26048, 14) (6512, 14)
Bước 3) Xây dựng đường ống
Quy trình này giúp việc cung cấp dữ liệu nhất quán cho mô hình dễ dàng hơn. Ý tưởng là đẩy dữ liệu thô qua một đối tượng duy nhất thực hiện mọi thao tác theo đúng trình tự.
Với tập dữ liệu này, bạn cần chuẩn hóa các biến liên tục và chuyển đổi các biến phân loại. Bất kỳ thao tác nào cũng có thể nằm trong một quy trình tự động: các giá trị thiếu có thể được thay thế bằng giá trị trung bình hoặc trung vị, và các biến mới có thể được tạo ra.
Bạn có hai lựa chọn: mã hóa cứng hai quy trình, hoặc xây dựng một pipeline. Mã hóa cứng có thể làm rò rỉ dữ liệu thử nghiệm vào số liệu thống kê đã được hiệu chỉnh và tạo ra sự không nhất quán theo thời gian, vì vậy pipeline là lựa chọn tốt hơn.
from sklearn.preprocessing import StandardScaler, OneHotEncoder, LabelEncoder
from sklearn.compose import ColumnTransformer, make_column_transformer
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LogisticRegression
Quy trình này thực hiện hai thao tác trước khi đưa dữ liệu vào bộ phân loại logistic:
- Chuẩn hóa biến: StandardScaler()
- Chuyển đổi các tính năng phân loại: OneHotEncode(sparse=False)
Bạn thực hiện cả hai bước với hàm make_column_transformer. Khi hướng dẫn này được viết, hàm này chưa có trong phiên bản scikit-learn đã phát hành (0.19), đó là lý do tại sao phiên bản dành cho nhà phát triển được sử dụng; nó đã được tích hợp trong mọi phiên bản ổn định kể từ 0.20.
Hàm `make_column_transformer` khá đơn giản: bạn chỉ cần khai báo các cột cần biến đổi và phép biến đổi cần áp dụng. Để chuẩn hóa các đặc trưng liên tục, bạn truyền vào các tham số sau:
- conti_features, StandardScaler() bên trong make_column_transformer
- conti_features: danh sách các cột liên tục
- StandardScaler: chuẩn hóa các cột đó
Đối tượng OneHotEncoder bên trong hàm make_column_transformer tự động mã hóa các nhãn.
preprocess = make_column_transformer(
    (conti_features, StandardScaler()),
    ### Need to be numeric not string to specify columns name
    (categorical_features, OneHotEncoder(sparse=False))
)
Ghi chú phiên bản: Hai đối số trong khối trên đã được chuyển tiếp. Các bản phát hành hiện tại mong đợi máy biến áp được xử lý trước và các cột được xử lý sau, và thưa thớt đã được đổi tên đầu ra thưa thớt Trong scikit-learn 1.2 và đã bị loại bỏ trong phiên bản 1.4, vì vậy mã nguồn mới hơn có nội dung như sau: OneHotEncoder(sparse_output=False).
Bạn có thể kiểm tra xem pipeline có hoạt động hay không bằng cách sử dụng fit_transform. Kết quả đầu ra phải có kích thước 26048, 107.
preprocess.fit_transform(X_train).shape
(26048, 107)
Bộ chuyển đổi dữ liệu đã sẵn sàng. Bạn tạo pipeline bằng make_pipeline, và sau khi dữ liệu được chuyển đổi, bạn đưa dữ liệu đó vào mô hình hồi quy logistic.
model = make_pipeline(
    preprocess,
    LogisticRegression())
Việc huấn luyện mô hình với scikit-learn rất đơn giản: chỉ cần gọi hàm `fit` trong pipeline. Bạn có thể in độ chính xác bằng phương thức `score`.
model.fit(X_train, y_train)
print("logistic regression score: %f" % model.score(X_test, y_test))
logistic regression score: 0.850891
Cuối cùng, bạn có thể dự đoán các lớp bằng hàm predict_proba, hàm này trả về xác suất của mỗi lớp. Lưu ý rằng tổng của hai xác suất này bằng một.
model.predict_proba(X_test)
array([[0.83576663, 0.16423337],
       [0.94582765, 0.05417235],
       [0.64760587, 0.35239413],
       ...,
       [0.99639252, 0.00360748],
       [0.02072181, 0.97927819],
       [0.56781353, 0.43218647]])
Bước 4) Sử dụng quy trình của chúng tôi trong tìm kiếm dạng lưới
Việc tinh chỉnh các siêu tham số, tức là các giá trị xác định cấu trúc của mô hình, có thể rất tốn thời gian và công sức.
Một cách để đánh giá mô hình là thay đổi kích thước tập dữ liệu huấn luyện và đo lường hiệu suất, lặp lại bài tập mười lần để xem sự phân bố điểm số. Điều đó đòi hỏi rất nhiều công sức thủ công.
Thay vào đó, scikit-learn cung cấp các hàm thực hiện việc điều chỉnh tham số và kiểm định chéo cho bạn.
Xác thực chéo
Kiểm định chéo (cross-validation) nghĩa là trong quá trình huấn luyện, tập dữ liệu huấn luyện được chia thành n phần và mô hình được đánh giá n lần. Nếu cv được đặt là 10, mô hình sẽ được huấn luyện và đánh giá mười lần. Trong mỗi vòng, bộ phân loại được huấn luyện trên chín phần được chọn ngẫu nhiên và phần thứ mười được giữ lại để đánh giá.
Tìm kiếm lưới
Mỗi bộ phân loại đều có các siêu tham số cần điều chỉnh. Bạn có thể thử từng giá trị một hoặc thiết lập một lưới tham số. Tài liệu của scikit-learn liệt kê tất cả các tham số mà bộ phân loại logistic chấp nhận. Để giữ cho quá trình huấn luyện nhanh, ví dụ này chỉ điều chỉnh tham số C, tham số này kiểm soát việc điều chỉnh (regularization). Tham số này phải dương, và giá trị nhỏ sẽ gán trọng số lớn hơn cho bộ điều chỉnh.
Bạn sử dụng đối tượng GridSearchCV, đối tượng này nhận một từ điển chứa các siêu tham số cần điều chỉnh. Liệt kê từng siêu tham số theo sau là các giá trị bạn muốn thử. Để điều chỉnh C, bạn viết:
- 'logisticregression__C': [0.001, 0.01, 0.1, 1.0] — tên tham số được đặt trước bởi tên bộ phân loại viết thường và hai dấu gạch dưới.
Mô hình sẽ thử bốn giá trị khác nhau: 0.001, 0.01, 0.1 và 1. Nó được huấn luyện với 10 fold, tức là cv=10.
from sklearn.model_selection import GridSearchCV
# Construct the parameter grid
param_grid = {
    'logisticregression__C': [0.001, 0.01,0.1, 1.0],
    }
Giờ đây, bạn có thể huấn luyện mô hình bằng GridSearchCV với các tham số grid và cv.
# Train the model
grid_clf = GridSearchCV(model,
                        param_grid,
                        cv=10,
                        iid=False)
grid_clf.fit(X_train, y_train)
Đầu ra:
GridSearchCV(cv=10, error_score='raise-deprecating',
       estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...ty='l2', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False))]),
       fit_params=None, iid=False, n_jobs=1,
       param_grid={'logisticregression__C': [0.001, 0.01, 0.1, 1.0]},
       pre_dispatch='2*n_jobs', refit=True, return_train_score='warn',
       scoring=None, verbose=0)
Ghi chú phiên bản: các Tôi Tham số hiển thị trong kết quả này đã bị loại bỏ trong scikit-learn 0.22 và bị xóa trong 0.24, vì vậy nó chỉ đơn giản là được loại bỏ khỏi lệnh gọi GridSearchCV trong các phiên bản hiện tại.
Để truy cập các tham số tốt nhất, bạn sử dụng best_params_.
grid_clf.best_params_
Đầu ra:
{'logisticregression__C': 1.0}
Sau khi huấn luyện mô hình với bốn giá trị điều chỉnh khác nhau, tham số tối ưu thu được là:
print("best logistic regression from grid search: %f" % grid_clf.best_estimator_.score(X_test, y_test))
hồi quy logistic tốt nhất từ tìm kiếm dạng lưới: 0.850891
Để truy cập các xác suất dự đoán:
grid_clf.best_estimator_.predict_proba(X_test)
array([[0.83576677, 0.16423323],
       [0.9458291 , 0.0541709 ],
       [0.64760416, 0.35239584],
       ...,
       [0.99639224, 0.00360776],
       [0.02072033, 0.97927967],
       [0.56782222, 0.43217778]])
Mô hình XGBoost với scikit-learn
Giờ hãy thử một trong những thuật toán phân loại mạnh nhất trên thị trường. XGBoost là một cải tiến dựa trên thuật toán rừng ngẫu nhiên (random forest). Phần lý thuyết nền tảng của nó nằm ngoài phạm vi bài viết này. Python Hướng dẫn của Scikit-Graphics, nhưng hãy nhớ rằng XGBoost đã giành chiến thắng rất nhiều cuộc thi trên Kaggle. Trên một tập dữ liệu có kích thước trung bình, nó có thể hoạt động tốt như một thuật toán học sâu, hoặc thậm chí tốt hơn.
Bộ phân loại này khó huấn luyện vì nó có số lượng tham số rất lớn. Tất nhiên, bạn có thể sử dụng GridSearchCV để chọn các tham số đó cho mình.
Một lựa chọn tốt hơn ở đây là RandomizedSearchCV. GridSearchCV trở nên chậm khi lưới lớn, vì không gian tìm kiếm tăng lên với mỗi tham số được thêm vào. Thay vào đó, RandomizedSearchCV lấy mẫu ngẫu nhiên các giá trị của từng siêu tham số trong mỗi lần lặp, do đó 1,000 lần lặp sẽ đánh giá 1,000 tổ hợp. Về cơ bản, nó hoạt động tương tự như GridSearchCV.
Bạn cần nhập thư viện xgboost. Nếu thư viện chưa được cài đặt, hãy chạy lệnh pip3 install xgboost hoặc cài đặt nó từ bên trong dự án. Jupyter sổ tay với:
use import sys
!{sys.executable} -m pip install xgboost
Sau đó, nhập bộ phân loại và hai công cụ hỗ trợ tìm kiếm:
import xgboost
from sklearn.model_selection import RandomizedSearchCV
from sklearn.model_selection import StratifiedKFold
Bước tiếp theo trong Scikit này Python Hướng dẫn này nhằm mục đích chỉ định các tham số cần điều chỉnh. Tài liệu chính thức của XGBoost liệt kê tất cả các tham số đó. Vì mục đích của việc này... Python Trong hướng dẫn Sklearn, bạn chỉ chọn hai siêu tham số với hai giá trị cho mỗi siêu tham số, bởi vì XGBoost mất rất nhiều thời gian để huấn luyện và mỗi điểm lưới bổ sung sẽ làm tăng thêm thời gian chờ đợi.
params = {
        'xgbclassifier__gamma': [0.5, 1],
        'xgbclassifier__max_depth': [3, 4]
        }
Sau đó, bạn xây dựng một pipeline mới với bộ phân loại XGBoost và 600 bộ ước lượng. Tham số n_estimators có thể điều chỉnh được, và giá trị cao có thể dẫn đến hiện tượng quá khớp (overfitting). Bạn có thể thử các giá trị khác, nhưng hãy lưu ý rằng quá trình này có thể mất hàng giờ. Tất cả các tham số khác giữ nguyên giá trị mặc định.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1)
)
Bạn có thể cải thiện quá trình kiểm định chéo bằng thuật toán kiểm định chéo Stratified K-Folds. Ở đây chỉ sử dụng ba fold để tăng tốc độ tính toán, nhưng sẽ làm giảm chất lượng; hãy tăng số fold lên 5 hoặc 10 trên máy của bạn để có kết quả tốt hơn. Mô hình được huấn luyện qua bốn lần lặp.
skf = StratifiedKFold(n_splits=3,
                      shuffle = True,
                      random_state = 1001)

random_search = RandomizedSearchCV(model_xgb,
                                   param_distributions=params,
                                   n_iter=4,
                                   scoring='accuracy',
                                   n_jobs=4,
                                   cv=skf.split(X_train, y_train),
                                   verbose=3,
                                   random_state=1001)
Quá trình tìm kiếm ngẫu nhiên đã sẵn sàng, vì vậy bạn có thể huấn luyện mô hình.
#grid_xgb = GridSearchCV(model_xgb, params, cv=10, iid=False)
random_search.fit(X_train, y_train)
Fitting 3 folds for each of 4 candidates, totalling 12 fits
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8759645283888057, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8729701715996775, total= 1.0min
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8706519235199263, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8735460094437406, total= 1.3min
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8722791661868018, total=  57.7s
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8753886905447426, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8697304768486523, total= 1.3min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8740066797189912, total= 1.4min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8707671043538355, total= 1.0min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8729701715996775, total= 1.2min
[Parallel(n_jobs=4)]: Done  10 out of  12 | elapsed:  3.6min remaining:   43.5s
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8736611770125533, total= 1.2min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8692697535130154, total= 1.2min
[Parallel(n_jobs=4)]: Done  12 out of  12 | elapsed:  3.6min finished
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/model_selection/_search.py:737: DeprecationWarning: The default of the `iid` parameter will change from True to False in version 0.22 and will be removed in 0.24. This will change numeric results when test-set sizes are unequal. DeprecationWarning)
RandomizedSearchCV(cv=<generator object _BaseKFold.split at 0x1101eb830>,
          error_score='raise-deprecating',
          estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))]),
          fit_params=None, iid='warn', n_iter=4, n_jobs=4,
          param_distributions={'xgbclassifier__gamma': [0.5, 1], 'xgbclassifier__max_depth': [3, 4]},
          pre_dispatch='2*n_jobs', random_state=1001, refit=True,
          return_train_score='warn', scoring='accuracy', verbose=3)
Như bạn thấy, XGBoost cho kết quả tốt hơn so với phương pháp hồi quy logistic trước đó.
print("Best parameter", random_search.best_params_)
print("best logistic regression from grid search: %f" % random_search.best_estimator_.score(X_test, y_test))
Best parameter {'xgbclassifier__max_depth': 3, 'xgbclassifier__gamma': 0.5}
best logistic regression from grid search: 0.873157
random_search.best_estimator_.predict(X_test)
array(['<=50K', '<=50K', '<=50K', ..., '<=50K', '>50K', '<=50K'], dtype=object)
Tạo DNN với MLPClassifier trong scikit-learn
Cuối cùng, bạn có thể huấn luyện mạng nơ-ron bằng chính scikit-learn. Phương pháp tương tự như đối với bất kỳ bộ phân loại nào khác, và bộ ước lượng là MLPClassifier.
from sklearn.neural_network import MLPClassifier
Mạng lưới bên dưới được định nghĩa như sau:
- Người giải quyết Adam
- Chức năng kích hoạt ReLU
- Alpha = 0.0001
- Số lượng mỗi lô: 150
- Hai lớp ẩn lần lượt có 200 và 100 nơ-ron
model_dnn = make_pipeline(
    preprocess,
    MLPClassifier(solver='adam',
                  alpha=0.0001,
                  activation='relu',
                    batch_size=150,
                    hidden_layer_sizes=(200, 100),
                    random_state=1))
Bạn có thể thay đổi số lượng lớp để cải thiện mô hình.
model_dnn.fit(X_train, y_train)
  print("DNN regression score: %f" % model_dnn.score(X_test, y_test))
Điểm hồi quy DNN: 0.821253
LIME: Hãy tin tưởng vào Mô hình của bạn
Giờ bạn đã có một mô hình tốt, điều bạn cần là một cách để tin tưởng vào nó. Các thuật toán học máy, đặc biệt là rừng ngẫu nhiên và mạng nơ-ron, được biết đến như những mô hình hộp đen: chúng hoạt động, nhưng không ai có thể thấy lý do tại sao.
Ba nhà nghiên cứu đã xây dựng một công cụ cho thấy cách máy tính đưa ra dự đoán. Bài báo của họ có tiêu đề là... “Tại sao tôi nên tin tưởng bạn?”và thuật toán mà họ công bố được gọi là Giải thích mô hình độc lập có thể diễn giải cục bộ (LIME).
Lấy một ví dụ. Đôi khi bạn không biết liệu dự đoán của máy học có đáng tin cậy hay không. Bác sĩ không thể chấp nhận chẩn đoán chỉ vì nó do máy tính đưa ra, và bạn cần biết liệu mô hình có đáng tin cậy trước khi đưa nó vào sử dụng.
Hãy tưởng tượng bạn có thể hiểu lý do tại sao bất kỳ bộ phân loại nào đưa ra dự đoán, ngay cả đối với các mô hình phức tạp như mạng nơ-ron, rừng ngẫu nhiên hoặc SVM với hạt nhân tùy ý. Việc tin tưởng vào một dự đoán trở nên dễ dàng hơn nhiều khi các lý do đằng sau nó được hiển thị rõ ràng, và việc quyết định khi nào không nên tin tưởng vào một mô hình cũng dễ dàng hơn. LIME cho bạn biết những đặc điểm nào đã thúc đẩy quyết định của bộ phân loại.
Chuẩn bị dữ liệu
Có một vài điều bạn cần thay đổi để chạy LIME. PythonĐầu tiên, hãy cài đặt Lime trong terminal bằng lệnh `pip install lime`.
Lime sử dụng đối tượng LimeTabularExplainer để xấp xỉ mô hình cục bộ. Đối tượng này yêu cầu:
- một tập dữ liệu trong numpy định dạng
- Tên của các tính năng: feature_names
- Tên các lớp: class_names
- Chỉ mục của cột của các tính năng phân loại: categorical_features
- Tên của nhóm cho mỗi đặc trưng phân loại: categorical_names
Tạo bộ dữ liệu huấn luyện NumPy.
Bạn có thể sao chép và chuyển đổi df_train từ pandas sang NumPy rất dễ dàng.
df_train.head(5)
# Create numpy data
df_lime = df_train
df_lime.head(3)
Lấy tên lớp
Bạn có thể truy cập nhãn thông qua hàm unique(). Bạn sẽ thấy:
- '<=50K'
- '>50K'
# Get the class name
class_names = df_lime.label.unique()
class_names
array(['<=50K', '>50K'], dtype=object)
Lập chỉ mục các cột thuộc tính phân loại
Hãy sử dụng phương pháp bạn đã học trước đó để lấy tên của từng nhóm. Bạn mã hóa nhãn bằng LabelEncoder và lặp lại thao tác này trên mọi đặc trưng phân loại.
##
import sklearn.preprocessing as preprocessing
categorical_names = {}
for feature in CATE_FEATURES:
    le = preprocessing.LabelEncoder()
    le.fit(df_lime[feature])
    df_lime[feature] = le.transform(df_lime[feature])
    categorical_names[feature] = le.classes_
print(categorical_names)
{'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}

df_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
label              object
dtype: object
Giờ đây, khi tập dữ liệu đã sẵn sàng, bạn có thể xây dựng các tập dữ liệu khác nhau được hiển thị trong các ví dụ Scikit learn bên dưới. Dữ liệu được chuyển đổi bên ngoài quy trình xử lý để tránh lỗi với LIME: tập huấn luyện được truyền cho LimeTabularExplainer phải là một mảng NumPy không chứa chuỗi ký tự, và phương pháp trên đã tạo ra một mảng như vậy.
from sklearn.model_selection import train_test_split
X_train_lime, X_test_lime, y_train_lime, y_test_lime = train_test_split(df_lime[features],
                                                    df_lime.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train_lime.head(5)
Bạn có thể tạo pipeline với các tham số tối ưu được tìm thấy bởi XGBoost.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(max_depth = 3,
                          gamma = 0.5,
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1))

model_xgb.fit(X_train_lime, y_train_lime)
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/preprocessing/_encoders.py:351: FutureWarning: The handling of integer data will change in version 0.22. Currently, the categories are determined based on the range [0, max(values)], while in the future they will be determined based on the unique values.
If you want the future behavior and silence this warning, you can specify "categories='auto'."In case you used a LabelEncoder before this OneHotEncoder to convert the categories to integers, then you can now use the OneHotEncoder directly.
  warnings.warn(msg, FutureWarning)
Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))])
Bạn nhận được một cảnh báo. Cảnh báo giải thích rằng bạn không cần tạo bộ mã hóa nhãn trước khi thực hiện pipeline. Nếu bạn không sử dụng LIME, phương pháp từ phần đầu của hướng dẫn Học máy với Scikit-learn này là phù hợp. Nếu không, hãy giữ nguyên cách tiếp cận này: trước tiên tạo một tập dữ liệu được mã hóa, sau đó áp dụng bộ mã hóa one-hot bên trong pipeline.
print("best logistic regression from grid search: %f" % model_xgb.score(X_test_lime, y_test_lime))
best logistic regression from grid search: 0.873157
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
Trước khi sử dụng LIME, hãy tạo một mảng NumPy chứa các đặc trưng của các hàng bị phân loại sai. Bạn có thể sử dụng danh sách đó sau này để hiểu rõ hơn điều gì đã dẫn đến kết quả phân loại sai.
temp = pd.concat([X_test_lime, y_test_lime], axis= 1)
temp['predicted'] = model_xgb.predict(X_test_lime)
temp['wrong']=  temp['label'] != temp['predicted']
temp = temp.query('wrong==True').drop('wrong', axis=1)
temp= temp.sort_values(by=['label'])
temp.shape
(826, 16)
Tiếp theo, bạn tạo một hàm lambda để lấy dự đoán từ mô hình cho dữ liệu mới. Bạn sẽ cần nó ngay sau đó.
predict_fn = lambda x: model_xgb.predict_proba(x).astype(float)
X_test_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
dtype: object
predict_fn(X_test_lime)
array([[7.96461046e-01, 2.03538969e-01],
       [9.51730132e-01, 4.82698716e-02],
       [7.93448269e-01, 2.06551731e-01],
       ...,
       [9.90314305e-01, 9.68566816e-03],
       [6.45816326e-04, 9.99354184e-01],
       [9.71042812e-01, 2.89571714e-02]])
Bạn chuyển đổi dataframe của pandas thành mảng NumPy.
X_train_lime = X_train_lime.values
X_test_lime = X_test_lime.values
X_test_lime
array([[4.00000e+01, 5.00000e+00, 1.93524e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.70000e+01, 4.00000e+00, 2.16481e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.50000e+01, 4.00000e+00, 2.56263e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       ...,
       [2.80000e+01, 6.00000e+00, 2.11032e+05, ..., 0.00000e+00,
        4.00000e+01, 2.50000e+01],
       [4.40000e+01, 4.00000e+00, 1.67005e+05, ..., 0.00000e+00,
        6.00000e+01, 3.80000e+01],
       [5.30000e+01, 4.00000e+00, 2.57940e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01]])
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
print(features,
      class_names,
      categorical_features,
      categorical_names)
['age', 'workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country'] ['<=50K' '>50K'] [1, 3, 5, 6, 7, 8, 9, 13] {'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}
import lime
import lime.lime_tabular
### Train should be label encoded not one hot encoded
explainer = lime.lime_tabular.LimeTabularExplainer(X_train_lime ,
                                                   feature_names = features,
                                                   class_names=class_names,
                                                   categorical_features=categorical_features,
                                                   categorical_names=categorical_names,
                                                   kernel_width=3)
Bây giờ hãy chọn ngẫu nhiên một hộ gia đình từ tập dữ liệu thử nghiệm và xem cả dự đoán lẫn cách máy tính đưa ra dự đoán đó.
import numpy as np
np.random.seed(1)
i = 100
print(y_test_lime.iloc[i])
>50K
X_test_lime[i]
array([4.20000e+01, 4.00000e+00, 1.76286e+05, 7.00000e+00, 1.20000e+01,
       2.00000e+00, 4.00000e+00, 0.00000e+00, 4.00000e+00, 1.00000e+00,
       0.00000e+00, 0.00000e+00, 4.00000e+01, 3.80000e+01])
Bạn có thể sử dụng công cụ giải thích với `explain_instance` để kiểm tra lý do đằng sau mô hình. Biểu đồ mà nó hiển thị được trình bày bên dưới.
exp = explainer.explain_instance(X_test_lime[i], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

Hệ thống phân loại đã dự đoán chính xác hộ gia đình này: thu nhập thực sự trên 50 đô la.
Điều đầu tiên cần lưu ý là thuật toán phân loại này không thực sự chắc chắn. Nó dự đoán thu nhập trên 50 đô la với xác suất 64%, và con số 64% này chủ yếu dựa vào lợi nhuận từ đầu tư và tình trạng hôn nhân. Màu xanh lam đóng góp tiêu cực vào lớp tích cực, còn đường màu cam đóng góp tích cực.
Hệ thống phân loại tỏ ra lưỡng lự vì lợi nhuận vốn của hộ gia đình này bằng không, trong khi lợi nhuận vốn thường là một chỉ số tốt để dự đoán sự giàu có. Hộ gia đình này cũng làm việc ít hơn 40 giờ mỗi tuần. Tuổi tác, nghề nghiệp và giới tính đều đóng góp tích cực.
Nếu tình trạng hôn nhân là độc thân, bộ phân loại sẽ dự đoán mức thu nhập dưới 50 (0.64 – 0.18 = 0.46).
Bây giờ hãy thử một hộ gia đình khác, một hộ gia đình đã bị phân loại sai. Bảng giải thích cho hộ gia đình đó nằm ngay sau mã số.
temp.head(3)
temp.iloc[1,:-2]
age                  58
workclass             4
fnlwgt            68624
education            11
education_num         9
marital               2
occupation            4
relationship          0
race                  4
sex                   1
capital_gain          0
capital_loss          0
hours_week           45
native_country       38
Name: 20931, dtype: object
i = 1
print('This observation is', temp.iloc[i,-2:])
This observation is label        <=50K
predicted     >50K
Name: 20931, dtype: object
exp = explainer.explain_instance(temp.iloc[1,:-2], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

Hệ thống phân loại dự đoán thu nhập dưới 50, điều này là sai. Hộ gia đình này khá bất thường: không có lãi vốn hay lỗ vốn, người đứng đầu đã ly hôn, gần 60 tuổi và có trình độ học vấn cao, tức là education_num > 12. Theo mô hình tổng thể, hệ thống phân loại xếp hộ gia đình này có thu nhập dưới 50.
Hãy tự mình trải nghiệm LIME và bạn sẽ nhận thấy rất nhiều lỗi rõ ràng từ bộ phân loại. Kho lưu trữ GitHub của tác giả thư viện có thêm tài liệu hướng dẫn về phân loại hình ảnh và văn bản.
Tài liệu tham khảo lệnh Scikit-learn
Dưới đây là danh sách các lệnh hữu ích áp dụng cho scikit-learn phiên bản 0.20 trở lên.
| Nhiệm vụ | Hàm hoặc lớp |
|---|---|
| Tạo tập dữ liệu huấn luyện/kiểm thử | tàu_test_split |
| Xây dựng một đường ống | |
| Chọn các cột và áp dụng phép biến đổi. | tạo_biến_tháp_cột |
| Loại chuyển đổi | |
| Tiêu chuẩn hóa | Tiêu chuẩn |
| Thang đo tối thiểu-tối đa | Bộ chia tỷ lệ tối thiểu |
| Chuẩn hóa | Bộ chuẩn hóa |
| Điền các giá trị bị thiếu | Đơn giản |
| Chuyển đổi phân loại | Bộ mã hóa OneHot |
| Phù hợp và chuyển đổi dữ liệu | fit_transform |
| Làm đường ống | make_pipeline |
| Mô hình cơ bản | |
| Hồi quy logistic | Hậu cần |
| XGBoost | Trình phân loại XGB |
| Mạng thần kinh | Bộ phân loại MLP |
| Tìm kiếm lưới | LướiTìm kiếmCV |
| Tìm kiếm ngẫu nhiên | Tìm kiếm ngẫu nhiênCV |
