
NLTK Tokenize: Токенізатор слів і речень із прикладом
 Евелін Кларк
⚡ Розумний підсумок
NLTK Tokenize розділяє великий текст на менші одиниці, які називаються токенами, що є фундаментальним кроком в обробці природної мови. Інструментарій надає word_tokenize для розбиття речень на слова та sent_tokenize для розділення тексту на окремі речення.
Що таке токенізація?
Токенізація це процес, за допомогою якого велика кількість тексту ділиться на менші частини, які називаються токенами. Ці лексеми дуже корисні для пошуку шаблонів і вважаються базовим кроком для створення коренів і лемматизації. Токенізація також допомагає замінити конфіденційні елементи даних неконфіденційними.
Обробка природної мови використовується для створення програм, таких як класифікація тексту, розумний чат-бот, сентиментальний аналіз, мовний переклад тощо. Для досягнення вищезазначеної мети стає життєво важливим зрозуміти шаблон у тексті.
На даний момент не турбуйтеся про стемінінг і лематизацію, а розглядайте їх як кроки для очищення текстових даних за допомогою NLP (обробка природної мови). Пізніше в підручнику ми обговоримо основне походження та лематизацію. Такі завдання як Класифікація тексту або фільтрація спаму використовує НЛП разом із бібліотеками глибокого навчання, такими як Keras і Тензорний потік.
Набір інструментів природної мови має дуже важливий модуль NLTK токенізувати речення, які додатково складаються з підмодулів
- слово токенізувати
- речення токенізувати
Токенізація слів
Використовуємо метод word_tokenize() поділити речення на слова. Результат токенізації слів можна перетворити на Data Frame для кращого розуміння тексту в програмах машинного навчання. Його також можна надати як вхідні дані для подальших кроків очищення тексту, таких як видалення знаків пунктуації, видалення цифрових символів або основ. Моделі машинного навчання потребують числових даних для навчання та прогнозування. Токенізація слів стає важливою частиною перетворення тексту (рядка) у числові дані. Будь ласка, прочитайте про Сумка слів або CountVectorizer. Будь ласка, зверніться до прикладу слова tokenize NLTK нижче, щоб краще зрозуміти теорію.
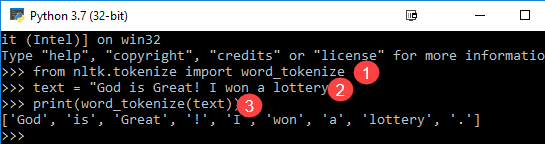
from nltk.tokenize import word_tokenize
text = "God is Great! I won a lottery."
print(word_tokenize(text))

Output: ['God', 'is', 'Great', '!', 'I', 'won', 'a', 'lottery', '.']
Code Пояснення
- модуль word_tokenize імпортовано з бібліотеки NLTK.
- Змінна «текст» ініціалізується двома реченнями.
- Текстова змінна передається в модуль word_tokenize і виводить результат. Цей модуль розбиває кожне слово на знаки пунктуації, які ви бачите у вихідних даних.
Токенізація речень
Підмодуль, доступний для вищезазначеного, це sent_tokenize. Очевидним питанням для вас буде навіщо потрібна токенізація речень, якщо у нас є можливість токенізації слів. Уявіть, що вам потрібно порахувати середнє число слів на речення, як ви будете обчислювати? Для виконання такого завдання вам потрібен токенізатор речень NLTK, а також токенізатор слів NLTK для обчислення співвідношення. Такий результат є важливою характеристикою для машинного навчання, оскільки відповідь буде числовою.
Перегляньте наведений нижче приклад токенізера NLTK, щоб дізнатися, чим токенізація речень відрізняється від токенізації слів.
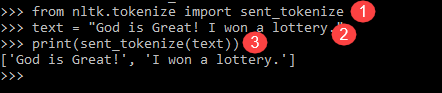
from nltk.tokenize import sent_tokenize
text = "God is Great! I won a lottery."
print(sent_tokenize(text))

Output: ['God is Great!', 'I won a lottery ']
Ми маємо 12 слова і два речення для того самого входу.
Пояснення до програми
- У рядок, подібний до попередньої програми, імпортований модуль sent_tokenize.
- Ми взяли те саме речення. Подальший токенізер речень у модулі NLTK проаналізував ці речення та показав результат. Зрозуміло, що ця функція розриває кожне речення.
Над словом tokenizer Python прикладами є хороші камені налаштувань, щоб зрозуміти механізм токенізації слова та речення.
