
Підручник Scikit-Learn: як встановити та приклади Scikit-Learn
 Евелін Кларк
⚡ Розумний підсумок
Scikit-learn — це програма з відкритим вихідним кодом Python Бібліотека, яка охоплює попередню обробку, класифікацію, регресію, кластеризацію та вибір моделі за єдиним узгодженим інтерфейсом оцінювача, що забезпечує коротке, читабельне та відтворюване виконання повного робочого процесу машинного навчання, від необроблених даних до оцінених прогнозів.
Що таке Scikit-learn?
Scikit-Learn є відкритим кодом Python бібліотека для навчання за допомогою машиниВін підтримує добре відомі алгоритми, такі як KNN, градієнтне підвищення, випадковий ліс та SVM, і побудований на основі... numpy та SciPy. Scikit-learn широко використовується в змаганнях Kaggle, а також у відомих технологічних компаніях. Він охоплює попередню обробку, зменшення розмірності, класифікацію, регресію, кластеризацію та вибір моделі.
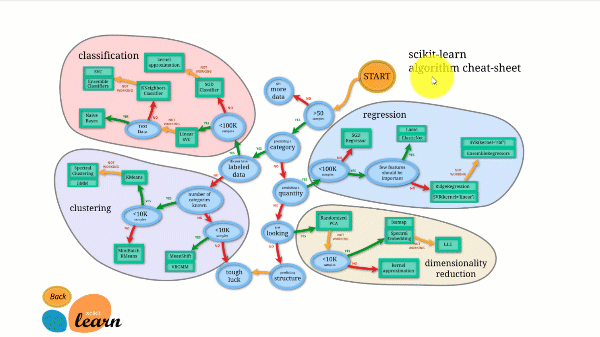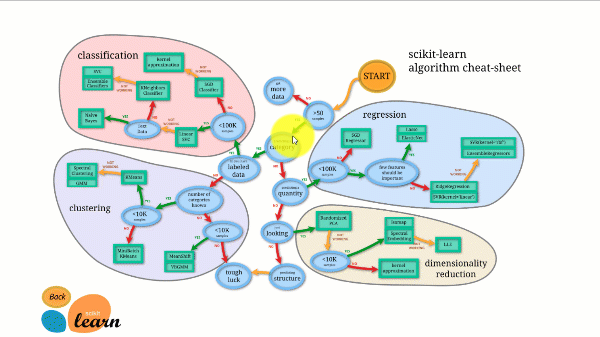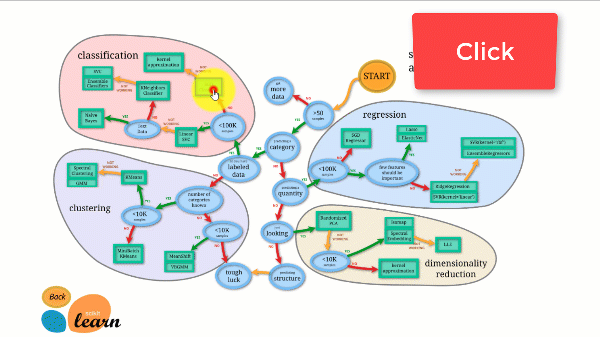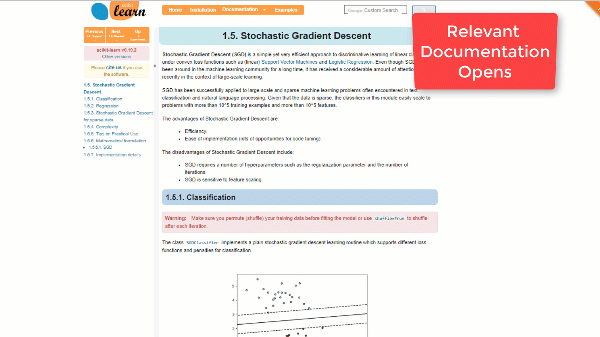
Scikit-learn має одну з найкращих документацій серед усіх бібліотек з відкритим кодом. Вона навіть надає інтерактивну діаграму оцінки, Вибір правильного оцінювача, який проведе вас від розміру вашого набору даних до короткого списку алгоритмів, які варто спробувати.
На малюнку нижче показано, як працює Scikit-learn.
Scikit-learn нескладний у використанні та дає чудові результати. Однак він навчається на процесорі: робота розпаралелюється між ядрами за допомогою аргументу n_jobs, а не на графічному процесорі. Запуск алгоритму глибокого навчання з його допомогою можливий, але рідко буває оптимальним, особливо якщо ви вже знаєте, як ним користуватися. TensorFlow.
Як завантажити та встановити Scikit-learn
Тепер у цьому Python У посібнику зі Scikit-learn ви дізнаєтесь, як завантажити та встановити Scikit-learn:
Варіант 1: AWS
Scikit-learn можна використовувати поверх AWS. Образ Docker із попередньо встановленим scikit-learn повністю позбавляє від необхідності налаштування.
Щоб встановити версію для розробників, виконайте команду нижче всередині Jupyter:
import sys
!{sys.executable} -m pip install git+git://github.com/scikit-learn/scikit-learn.git
Варіант 2: Mac або Windows за допомогою Anaconda
Щоб дізнатися більше про встановлення Anaconda, див. як завантажити та встановити TensorFlow.
На момент написання цього посібника розробники scikit випустили версію для розробників, яка виправила проблеми, присутні в поточному випуску, тому наведені нижче кроки використовують цю збірку для розробників. На новій машині сьогодні поточний стабільний випуск вже містить кожен трансформатор, який тут використовується, і pip install -U scikit-learn достатньо.
Як встановити scikit-learn за допомогою Conda Environment
Якщо ви встановили scikit-learn разом із середовищем conda, виконайте наведені нижче дії, щоб оновити його до версії 0.20.
Крок 1) Активуйте середовище tensorflow
source activate hello-tf
Крок 2) Видаліть scikit-learn за допомогою команди conda
conda remove scikit-learn
Крок 3) Встановіть версію для розробників
Встановіть версію scikit-learn для розробників разом з необхідними бібліотеками.
conda install -c anaconda git
pip install Cython
pip install h5py
pip install git+git://github.com/scikit-learn/scikit-learn.git
ПРИМІТКА: Windows користувачам потрібно Microsoft Візуальний C++ 14. Ви можете це отримати тут.
Приклад Scikit-Learn із машинним навчанням
Цей підручник Scikit розділений на дві частини:
- Машинне навчання за допомогою scikit-learn
- Як довіряти своїй моделі LIME
У першій частині детально описано, як побудувати конвеєр, створити модель та налаштувати гіперпараметри, а в другій частині розглянуто інтерпретацію моделі.
Крок 1) Імпортуйте дані
Під час цього навчального посібника зі Scikit learn ви будете використовувати набір даних перепису дорослого населення.
Файл зчитується безпосередньо з репозиторію машинного навчання UCI в коді нижче, тому ручне завантаження не потрібне. Якщо вас цікавить описова статистика, варто звернути увагу на інструменти Dive та Overview. Див. цей підручник щоб дізнатися більше про занурення та огляд.
Ви імпортуєте набір даних за допомогою pandas. Зверніть увагу, що вам потрібно конвертувати неперервні змінні у формат з плаваючою комою.
Цей набір даних містить вісім категоріальних змінних, перелічених у CATE_FEATURES:
- робочий клас
- освіту
- подружній
- окупація
- відносини
- гонки
- секс
- Батьківщина
Він також включає шість безперервних змінних, перелічених у CONTI_FEATURES:
- вік
- fnlwgt
- номер_освіти
- приріст капіталу
- капітал_збиток
- години_тиждень
Тут списки заповнюються вручну, щоб ви мали чіткіше уявлення про те, які стовпці використовуються. Швидший спосіб створити список категоріальних або безперервних стовпців:
## List Categorical
CATE_FEATURES = df_train.iloc[:,:-1].select_dtypes('object').columns
print(CATE_FEATURES)

## List continuous
CONTI_FEATURES =  df_train._get_numeric_data()
print(CONTI_FEATURES)
Ось код для імпорту даних:
# Import dataset
import pandas as pd

## Define path data
COLUMNS = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country', 'label']
### Define continuous list
CONTI_FEATURES  = ['age', 'fnlwgt','capital_gain', 'education_num', 'capital_loss', 'hours_week']
### Define categorical list
CATE_FEATURES = ['workclass', 'education', 'marital', 'occupation', 'relationship', 'race', 'sex', 'native_country']

## Prepare the data
features = ['age','workclass', 'fnlwgt', 'education', 'education_num', 'marital',
           'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss',
           'hours_week', 'native_country']

PATH = "https://archive.ics.uci.edu/ml/machine-learning-databases/adult/adult.data"

df_train = pd.read_csv(PATH, skipinitialspace=True, names = COLUMNS, index_col=False)
df_train[CONTI_FEATURES] =df_train[CONTI_FEATURES].astype('float64')
df_train.describe()
Виклик describe() для фрейму повертає зведену статистику для шести безперервних стовпців:
| вік | fnlwgt | номер_освіти | приріст капіталу | капітал_збиток | години_тиждень | |
|---|---|---|---|---|---|---|
| вважати | 32561.000000 | 3.256100e + 04 | 32561.000000 | 32561.000000 | 32561.000000 | 32561.000000 |
| значити | 38.581647 | 1.897784e + 05 | 10.080679 | 1077.648844 | 87.303830 | 40.437456 |
| std | 13.640433 | 1.055500e + 05 | 2.572720 | 7385.292085 | 402.960219 | 12.347429 |
| хвилин | 17.000000 | 1.228500e + 04 | 1.000000 | 0.000000 | 0.000000 | 1.000000 |
| 25% | 28.000000 | 1.178270e + 05 | 9.000000 | 0.000000 | 0.000000 | 40.000000 |
| 50% | 37.000000 | 1.783560e + 05 | 10.000000 | 0.000000 | 0.000000 | 40.000000 |
| 75% | 48.000000 | 2.370510e + 05 | 12.000000 | 0.000000 | 0.000000 | 45.000000 |
| Макс | 90.000000 | 1.484705e + 06 | 16.000000 | 99999.000000 | 4356.000000 | 99.000000 |
Ви можете перевірити кількість унікальних значень функції native_country. Лише одне домогосподарство походить з Нідерландів. Це домогосподарство не містить жодної інформації та викличе помилку під час навчання.
df_train.native_country.value_counts()
United-States                 29170
Mexico                          643
?                               583
Philippines                     198
Germany                         137
Canada                          121
Puerto-Rico                     114
El-Salvador                     106
India                           100
Cuba                             95
England                          90
Jamaica                          81
South                            80
China                            75
Italy                            73
Dominican-Republic               70
Vietnam                          67
Guatemala                        64
Japan                            62
Poland                           60
Columbia                         59
Taiwan                           51
Haiti                            44
Iran                             43
Portugal                         37
Nicaragua                        34
Peru                             31
France                           29
Greece                           29
Ecuador                          28
Ireland                          24
Hong                             20
Cambodia                         19
Trinadad&Tobago                  19
Thailand                         18
Laos                             18
Yugoslavia                       16
Outlying-US(Guam-USVI-etc)       14
Honduras                         13
Hungary                          13
Scotland                         12
Holand-Netherlands                1
Name: native_country, dtype: int64
Ви можете виключити цей неінформативний рядок з набору даних:
## Drop Netherland, because only one row
df_train = df_train[df_train.native_country != "Holand-Netherlands"]
Далі ви зберігаєте положення безперервних елементів у списку. Він знадобиться вам на наступному кроці для будівництва трубопроводу.
Наведений нижче код перебирає всі назви стовпців у CONTI_FEATURES, зчитує кожне розташування (тобто номер його стовпця) та додає його до списку під назвою conti_features.
## Get the column index of the categorical features
conti_features = []
for i in CONTI_FEATURES:
    position = df_train.columns.get_loc(i)
    conti_features.append(position)
print(conti_features)
[0, 2, 10, 4, 11, 12]
Наступний блок виконує ту саму роботу для категоріальних змінних.
## Get the column index of the categorical features
categorical_features = []
for i in CATE_FEATURES:
    position = df_train.columns.get_loc(i)
    categorical_features.append(position)
print(categorical_features)
[1, 3, 5, 6, 7, 8, 9, 13]
Тепер розглянемо сам набір даних. Кожна категоріальна ознака є рядком, а моделі не можна передати рядкове значення, тому набір даних потрібно перетворити за допомогою фіктивних змінних.
df_train.head(5)
Фактично, вам потрібен один стовпець для кожної групи в кожному об'єкті. Спочатку запустіть наведений нижче код, щоб обчислити загальну кількість необхідних стовпців.
print(df_train[CATE_FEATURES].nunique(),
      'There are',sum(df_train[CATE_FEATURES].nunique()), 'groups in the whole dataset')
workclass          9
education         16
marital            7
occupation        15
relationship       6
race               5
sex                2
native_country    41
dtype: int64 There are 101 groups in the whole dataset
Весь набір даних містить 101 групу, як показано вище. Тільки ознака робочого класу має дев'ять груп. Ви можете перерахувати назви груп за допомогою коду нижче; unique() повертає унікальні значення кожної категоріальної ознаки.
for i in CATE_FEATURES:
    print(df_train[i].unique())
['State-gov' 'Self-emp-not-inc' 'Private' 'Federal-gov' 'Local-gov' '?'
 'Self-emp-inc' 'Without-pay' 'Never-worked']
['Bachelors' 'HS-grad' '11th' 'Masters' '9th' 'Some-college' 'Assoc-acdm'
 'Assoc-voc' '7th-8th' 'Doctorate' 'Prof-school' '5th-6th' '10th'
 '1st-4th' 'Preschool' '12th']
['Never-married' 'Married-civ-spouse' 'Divorced' 'Married-spouse-absent'
 'Separated' 'Married-AF-spouse' 'Widowed']
['Adm-clerical' 'Exec-managerial' 'Handlers-cleaners' 'Prof-specialty'
 'Other-service' 'Sales' 'Craft-repair' 'Transport-moving'
 'Farming-fishing' 'Machine-op-inspct' 'Tech-support' '?'
 'Protective-serv' 'Armed-Forces' 'Priv-house-serv']
['Not-in-family' 'Husband' 'Wife' 'Own-child' 'Unmarried' 'Other-relative']
['White' 'Black' 'Asian-Pac-Islander' 'Amer-Indian-Eskimo' 'Other']
['Male' 'Female']
['United-States' 'Cuba' 'Jamaica' 'India' '?' 'Mexico' 'South'
 'Puerto-Rico' 'Honduras' 'England' 'Canada' 'Germany' 'Iran'
 'Philippines' 'Italy' 'Poland' 'Columbia' 'Cambodia' 'Thailand' 'Ecuador'
 'Laos' 'Taiwan' 'Haiti' 'Portugal' 'Dominican-Republic' 'El-Salvador'
 'France' 'Guatemala' 'China' 'Japan' 'Yugoslavia' 'Peru'
 'Outlying-US(Guam-USVI-etc)' 'Scotland' 'Trinadad&Tobago' 'Greece'
 'Nicaragua' 'Vietnam' 'Hong' 'Ireland' 'Hungary']
Таким чином, навчальний набір даних міститиме 101 + 6 стовпців: групи з однією активністю плюс шість неперервних ознак.
Scikit-learn може виконати конвертацію у два кроки:
- Перетворіть рядок на ідентифікатор. State-gov стає ID 1, Self-emp-not-inc стає ID 2 і так далі. LabelEncoder зробить це за вас.
- Транспонуйте кожен ідентифікатор у новий стовпець. Набір даних має 101 ідентифікатор групи, тому буде 101 стовпець, що охоплює кожну групу категоріальних ознак. Scikit-learn надає OneHotEncoder для цієї операції.
Крок 2) Створіть навчальний/тестовий набір
Тепер, коли набір даних готовий, розділіть його у співвідношенні 80/20: 80 відсотків для навчального набору та 20 відсотків для тестового набору.
Ви можете використовувати train_test_split. Перший аргумент – це фрейм даних об'єктів, а другий – мітка. Розмір набору тестів встановлюється за допомогою test_size.
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(df_train[features],
                                                    df_train.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train.head(5)
print(X_train.shape, X_test.shape)
(26048, 14) (6512, 14)
Крок 3) Побудуйте трубопровід
Конвеєр спрощує забезпечення моделі узгодженими даними. Ідея полягає в тому, щоб проштовхувати необроблені дані через один об'єкт, який виконує всі операції по порядку.
За допомогою цього набору даних вам потрібно стандартизувати неперервні змінні та перетворити категоріальні. Будь-яка операція може виконуватися всередині конвеєра: відсутні значення можна замінити середнім значенням або медіаною, а також можна створювати нові змінні.
У вас є вибір: жорстко запрограмувати два процеси або побудувати конвеєр. Жорстке запрограмування може призвести до витоку тестових даних у підібрану статистику та створювати невідповідності з часом, тому конвеєр є кращим варіантом.
from sklearn.preprocessing import StandardScaler, OneHotEncoder, LabelEncoder
from sklearn.compose import ColumnTransformer, make_column_transformer
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LogisticRegression
Конвеєр виконує дві операції перед подачею на логістичний класифікатор:
- Стандартизуйте змінну: StandardScaler()
- Перетворення категоріальних ознак: OneHotEncoder(sparse=False)
Ви виконуєте обидва кроки за допомогою make_column_transformer. На момент написання цього посібника цієї функції не було у випущеній версії scikit-learn (0.19), тому використовувалася збірка для розробників; вона постачалася у кожному стабільному випуску, починаючи з версії 0.20.
Функція make_column_transformer проста: ви оголошуєте, які стовпці трансформувати та яке перетворення застосовувати. Щоб стандартизувати безперервні функції, які ви передаєте:
- conti_features, StandardScaler() всередині make_column_transformer
- conti_features: список безперервних стовпців
- StandardScaler: стандартизує ці стовпці
Об'єкт OneHotEncoder всередині make_column_transformer автоматично кодує мітки.
preprocess = make_column_transformer(
    (conti_features, StandardScaler()),
    ### Need to be numeric not string to specify columns name
    (categorical_features, OneHotEncoder(sparse=False))
)
Примітка до версії: Два аргументи у блоці вище переміщено далі. Поточні релізи очікують, що трансформатор буде передано спочатку, а стовпці — потім, і рідкісний перейменовано розріджений_вихід у scikit-learn 1.2 та видалено у 1.4, тому новіший код читається OneHotEncoder(sparse_output=False).
Ви можете перевірити, чи працює конвеєр, за допомогою fit_transform. Вивід повинен мати форму 26048, 107.
preprocess.fit_transform(X_train).shape
(26048, 107)
Трансформатор даних готовий. Ви створюєте конвеєр за допомогою make_pipeline, і після перетворення даних ви передаєте дані в логістичну регресію.
model = make_pipeline(
    preprocess,
    LogisticRegression())
Навчання моделі за допомогою scikit-learn є тривіальним: викликається метод fit у конвеєрі. Ви можете вивести точність за допомогою методу score.
model.fit(X_train, y_train)
print("logistic regression score: %f" % model.score(X_test, y_test))
logistic regression score: 0.850891
Зрештою, ви можете передбачити класи за допомогою predict_proba, яка повертає ймовірність кожного класу. Зверніть увагу, що дві ймовірності в сумі дорівнюють одиниці.
model.predict_proba(X_test)
array([[0.83576663, 0.16423337],
       [0.94582765, 0.05417235],
       [0.64760587, 0.35239413],
       ...,
       [0.99639252, 0.00360748],
       [0.02072181, 0.97927819],
       [0.56781353, 0.43218647]])
Крок 4) Використання нашого конвеєра в пошуку сітки
Налаштування гіперпараметрів, значень, що визначають структуру моделі, може бути нудним та виснажливим процесом.
Один із способів оцінки моделі — змінити розмір навчального набору та виміряти продуктивність, повторивши вправу десять разів, щоб побачити розкид результатів. Це багато ручної роботи.
Натомість, scikit-learn надає функції, які виконують налаштування параметрів та перехресну перевірку за вас.
Перехресна перевірка
Перехресна перевірка означає, що під час навчання навчальний набір розбивається n разів на складки, і модель оцінюється n разів. Якщо cv встановлено на 10, модель навчається та оцінюється десять разів. У кожному раунді класифікатор навчається на дев'яти складках, вибраних випадковим чином, а десятий складок залишається для оцінки.
Пошук у сітці
Кожен класифікатор має гіперпараметри для налаштування. Ви можете пробувати значення по одному або встановити сітку параметрів. У документації scikit-learn перелічені всі параметри, які приймає логістичний класифікатор. Щоб забезпечити швидкість навчання, у цьому прикладі налаштовується лише параметр C, який керує регуляризацією. Він має бути додатним, а мале значення надає більшої ваги регуляризатору.
Ви використовуєте об'єкт GridSearchCV, який приймає словник гіперпараметрів для налаштування. Перелічіть кожен гіперпараметр, а потім значення, які ви хочете спробувати. Щоб налаштувати C, ви пишете:
- 'logisticegression__C': [0.001, 0.01, 0.1, 1.0] — перед назвою параметра йде назва класифікатора у нижньому регістрі та два символи підкреслення.
Модель спробує чотири різні значення: 0.001, 0.01, 0.1 та 1. Вона навчається з 10 складками, тобто cv=10.
from sklearn.model_selection import GridSearchCV
# Construct the parameter grid
param_grid = {
    'logisticregression__C': [0.001, 0.01,0.1, 1.0],
    }
Тепер ви можете навчати модель за допомогою GridSearchCV з параметрами grid та cv.
# Train the model
grid_clf = GridSearchCV(model,
                        param_grid,
                        cv=10,
                        iid=False)
grid_clf.fit(X_train, y_train)
вихід:
GridSearchCV(cv=10, error_score='raise-deprecating',
       estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...ty='l2', random_state=None, solver='liblinear', tol=0.0001,
          verbose=0, warm_start=False))]),
       fit_params=None, iid=False, n_jobs=1,
       param_grid={'logisticregression__C': [0.001, 0.01, 0.1, 1.0]},
       pre_dispatch='2*n_jobs', refit=True, return_train_score='warn',
       scoring=None, verbose=0)
Примітка до версії: ІІД Аргумент, видимий у цьому виводі, був застарілим у scikit-learn версії 0.22 та видалений у версії 0.24, тому його слід просто видалити з виклику GridSearchCV у поточних випусках.
Щоб отримати доступ до найкращих параметрів, ви використовуєте best_params_.
grid_clf.best_params_
вихід:
{'logisticregression__C': 1.0}
Після навчання моделі з чотирма різними значеннями регуляризації оптимальний параметр дає:
print("best logistic regression from grid search: %f" % grid_clf.best_estimator_.score(X_test, y_test))
найкраща логістична регресія з пошуку по сітці: 0.850891
Щоб отримати доступ до прогнозованих ймовірностей:
grid_clf.best_estimator_.predict_proba(X_test)
array([[0.83576677, 0.16423323],
       [0.9458291 , 0.0541709 ],
       [0.64760416, 0.35239584],
       ...,
       [0.99639224, 0.00360776],
       [0.02072033, 0.97927967],
       [0.56782222, 0.43217778]])
Модель XGBoost із scikit-learn
Тепер спробуйте один із найсильніших класифікаторів на ринку. XGBoost — це покращення випадкового лісу з підсиленням градієнта. Його теоретична основа виходить за рамки цієї статті. Python Посібник зі Scikit, але майте на увазі, що XGBoost вигравав безліч змагань Kaggle. На наборі даних середнього розміру він може працювати так само добре, як алгоритм глибокого навчання, або навіть краще.
Класифікатор складно навчати, оскільки він надає велику кількість параметрів. Ви, звичайно, можете використовувати GridSearchCV, щоб вибрати їх для себе.
Кращим варіантом тут є RandomizedSearchCV. GridSearchCV стає повільним, коли сітка велика, оскільки простір пошуку зростає з кожним доданим параметром. Натомість RandomizedSearchCV випадковим чином вибірково вибирає значення кожного гіперпараметра на кожній ітерації, тому 1,000 ітерацій оцінюють 1,000 комбінацій. В іншому він працює дуже схоже на GridSearchCV.
Вам потрібно імпортувати xgboost. Якщо бібліотека не встановлена, запустіть команду pip3 install xgboost або встановіть її зсередини Jupyter блокнот з:
use import sys
!{sys.executable} -m pip install xgboost
Потім імпортуйте класифікатор та два помічники пошуку:
import xgboost
from sklearn.model_selection import RandomizedSearchCV
from sklearn.model_selection import StratifiedKFold
Наступний крок у цьому Scikit Python Посібник полягає у визначенні параметрів для налаштування. В офіційній документації XGBoost перераховані всі параметри. Для цього Python У посібнику зі Sklearn ви обираєте лише два гіперпараметри з двома значеннями кожен, оскільки навчання XGBoost займає багато часу, а кожна додаткова точка сітки збільшує час очікування.
params = {
        'xgbclassifier__gamma': [0.5, 1],
        'xgbclassifier__max_depth': [3, 4]
        }
Потім ви створюєте новий конвеєр з класифікатором XGBoost та 600 оцінками. n_estimators сам по собі налаштовується, і високе значення може призвести до переналаштування. Ви можете спробувати інші значення, але майте на увазі, що це може зайняти години. Кожен інший параметр зберігає своє значення за замовчуванням.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1)
)
Ви можете покращити перехресну перевірку за допомогою перехресного валідатора Stratified K-Folds. Тут використовуються лише три складки для пришвидшення обчислень, але з деяким зниженням якості; збільште це число до 5 або 10 на власній машині для кращих результатів. Модель навчається протягом чотирьох ітерацій.
skf = StratifiedKFold(n_splits=3,
                      shuffle = True,
                      random_state = 1001)

random_search = RandomizedSearchCV(model_xgb,
                                   param_distributions=params,
                                   n_iter=4,
                                   scoring='accuracy',
                                   n_jobs=4,
                                   cv=skf.split(X_train, y_train),
                                   verbose=3,
                                   random_state=1001)
Рандомізований пошук готовий, тож ви можете навчити модель.
#grid_xgb = GridSearchCV(model_xgb, params, cv=10, iid=False)
random_search.fit(X_train, y_train)
Fitting 3 folds for each of 4 candidates, totalling 12 fits
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8759645283888057, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8729701715996775, total= 1.0min
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=0.5, score=0.8706519235199263, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5 ............
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8735460094437406, total= 1.3min
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8722791661868018, total=  57.7s
[CV] xgbclassifier__max_depth=3, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8753886905447426, total= 1.0min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8697304768486523, total= 1.3min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=0.5, score=0.8740066797189912, total= 1.4min
[CV] xgbclassifier__max_depth=4, xgbclassifier__gamma=1 ..............
[CV]  xgbclassifier__max_depth=3, xgbclassifier__gamma=1, score=0.8707671043538355, total= 1.0min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8729701715996775, total= 1.2min
[Parallel(n_jobs=4)]: Done  10 out of  12 | elapsed:  3.6min remaining:   43.5s
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8736611770125533, total= 1.2min
[CV]  xgbclassifier__max_depth=4, xgbclassifier__gamma=1, score=0.8692697535130154, total= 1.2min
[Parallel(n_jobs=4)]: Done  12 out of  12 | elapsed:  3.6min finished
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/model_selection/_search.py:737: DeprecationWarning: The default of the `iid` parameter will change from True to False in version 0.22 and will be removed in 0.24. This will change numeric results when test-set sizes are unequal. DeprecationWarning)
RandomizedSearchCV(cv=<generator object _BaseKFold.split at 0x1101eb830>,
          error_score='raise-deprecating',
          estimator=Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))]),
          fit_params=None, iid='warn', n_iter=4, n_jobs=4,
          param_distributions={'xgbclassifier__gamma': [0.5, 1], 'xgbclassifier__max_depth': [3, 4]},
          pre_dispatch='2*n_jobs', random_state=1001, refit=True,
          return_train_score='warn', scoring='accuracy', verbose=3)
Як бачите, XGBoost має кращі результати, ніж попередня логістична регресія.
print("Best parameter", random_search.best_params_)
print("best logistic regression from grid search: %f" % random_search.best_estimator_.score(X_test, y_test))
Best parameter {'xgbclassifier__max_depth': 3, 'xgbclassifier__gamma': 0.5}
best logistic regression from grid search: 0.873157
random_search.best_estimator_.predict(X_test)
array(['<=50K', '<=50K', '<=50K', ..., '<=50K', '>50K', '<=50K'], dtype=object)
Створіть DNN за допомогою MLPClassifier у scikit-learn
Зрештою, ви можете навчити нейронну мережу за допомогою самого scikit-learn. Метод такий самий, як і для будь-якого іншого класифікатора, а оцінювачем є MLPClassifier.
from sklearn.neural_network import MLPClassifier
Мережа, наведена нижче, визначається за допомогою:
- Адам розгадувач
- Функція активації ReLU
- Альфа = 0.0001
- Розмір партії 150
- Два прихованих шари з 200 і 100 нейронами відповідно
model_dnn = make_pipeline(
    preprocess,
    MLPClassifier(solver='adam',
                  alpha=0.0001,
                  activation='relu',
                    batch_size=150,
                    hidden_layer_sizes=(200, 100),
                    random_state=1))
Ви можете змінити кількість шарів, щоб покращити модель.
model_dnn.fit(X_train, y_train)
  print("DNN regression score: %f" % model_dnn.score(X_test, y_test))
Оцінка регресії DNN: 0.821253
LIME: довіряйте своїй моделі
Тепер, коли у вас є гарна модель, вам потрібен спосіб довіряти їй. Алгоритми машинного навчання, особливо випадкові ліси та нейронні мережі, відомі як моделі чорної скриньки: вони працюють, але ніхто не розуміє, чому.
Троє дослідників створили інструмент, який показує, як комп'ютер досягає прогнозу. Їхня стаття... «Чому я маю тобі довіряти?», а опублікований ними алгоритм називається Локальні інтерпретовані модельно-агностичні пояснення (LIME).
Візьмемо, наприклад, іноді ви не знаєте, чи можна довіряти прогнозу машинного навчання. Лікар не може прийняти діагноз лише тому, що його поставив комп'ютер, і вам потрібно знати, чи є модель надійною, перш ніж запускати її у виробництво.
Уявіть, що ви можете зрозуміти, чому будь-який класифікатор зробив прогноз, навіть для таких складних моделей, як нейронні мережі, випадкові ліси або SVM з довільним ядром. Стає набагато легше довіряти прогнозу, коли причини його існування очевидні, і так само легше вирішити, коли моделі не слід довіряти. LIME показує, які особливості вплинули на рішення класифікатора.
Підготовка даних
Є кілька речей, які потрібно змінити, щоб запустити LIME PythonСпочатку встановіть lime у терміналі за допомогою команди pip install lime.
Lime використовує об'єкт LimeTabularExplainer для локальної апроксимації моделі. Цей об'єкт вимагає:
- набір даних у numpy формат
- Назва об’єктів: назви_об’єктів
- Ім'я класів: class_names
- Індекс стовпця категорійних ознак: категоричні_ознаки
- Назва групи для кожної категоріальної ознаки: categorical_names
Створіть набір поїздів NumPy
Ви можете дуже легко скопіювати та конвертувати df_train з pandas у NumPy.
df_train.head(5)
# Create numpy data
df_lime = df_train
df_lime.head(3)
Отримайте назву класу
Мітка доступна через unique(). Ви повинні побачити:
- '<=50K'
- '>50K'
# Get the class name
class_names = df_lime.label.unique()
class_names
array(['<=50K', '>50K'], dtype=object)
Індексувати стовпці категоріальних ознак
Використайте метод, який ви вивчили раніше, щоб отримати назву кожної групи. Ви кодуєте мітку за допомогою LabelEncoder і повторюєте операцію для кожної категоріальної ознаки.
##
import sklearn.preprocessing as preprocessing
categorical_names = {}
for feature in CATE_FEATURES:
    le = preprocessing.LabelEncoder()
    le.fit(df_lime[feature])
    df_lime[feature] = le.transform(df_lime[feature])
    categorical_names[feature] = le.classes_
print(categorical_names)
{'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}

df_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
label              object
dtype: object
Тепер, коли набір даних готовий, ви можете створити різні набори даних, показані в наведених нижче прикладах навчання Scikit. Тут дані перетворюються поза конвеєром, щоб уникнути помилок з LIME: навчальний набір, переданий до LimeTabularExplainer, має бути масивом NumPy без рядків, а наведений вище метод вже створив один.
from sklearn.model_selection import train_test_split
X_train_lime, X_test_lime, y_train_lime, y_test_lime = train_test_split(df_lime[features],
                                                    df_lime.label,
                                                    test_size = 0.2,
                                                    random_state=0)
X_train_lime.head(5)
Ви можете створити конвеєр з оптимальними параметрами, знайденими XGBoost.
model_xgb = make_pipeline(
    preprocess,
    xgboost.XGBClassifier(max_depth = 3,
                          gamma = 0.5,
                          n_estimators=600,
                          objective='binary:logistic',
                          silent=True,
                          nthread=1))

model_xgb.fit(X_train_lime, y_train_lime)
/Users/Thomas/anaconda3/envs/hello-tf/lib/python3.6/site-packages/sklearn/preprocessing/_encoders.py:351: FutureWarning: The handling of integer data will change in version 0.22. Currently, the categories are determined based on the range [0, max(values)], while in the future they will be determined based on the unique values.
If you want the future behavior and silence this warning, you can specify "categories='auto'."In case you used a LabelEncoder before this OneHotEncoder to convert the categories to integers, then you can now use the OneHotEncoder directly.
  warnings.warn(msg, FutureWarning)
Pipeline(memory=None,
     steps=[('columntransformer', ColumnTransformer(n_jobs=1, remainder='drop', transformer_weights=None,
         transformers=[('standardscaler', StandardScaler(copy=True, with_mean=True, with_std=True), [0, 2, 10, 4, 11, 12]), ('onehotencoder', OneHotEncoder(categorical_features=None, categories=None,...
       reg_alpha=0, reg_lambda=1, scale_pos_weight=1, seed=None,
       silent=True, subsample=1))])
Ви отримаєте попередження. У ньому пояснюється, що вам не потрібно створювати кодувальник міток перед конвеєром. Якщо ви не використовуєте LIME, метод з першої частини цього посібника з машинного навчання за допомогою Scikit-learn підійде. В іншому випадку, дотримуйтесь цього підходу: спочатку створіть закодований набір даних, а потім застосуйте кодувальник one-hot всередині конвеєра.
print("best logistic regression from grid search: %f" % model_xgb.score(X_test_lime, y_test_lime))
best logistic regression from grid search: 0.873157
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
Перш ніж запускати LIME, створіть масив NumPy, який містить ознаки неправильно класифікованих рядків. Ви можете використовувати цей список пізніше, щоб зрозуміти, що ввело класифікатор в оману.
temp = pd.concat([X_test_lime, y_test_lime], axis= 1)
temp['predicted'] = model_xgb.predict(X_test_lime)
temp['wrong']=  temp['label'] != temp['predicted']
temp = temp.query('wrong==True').drop('wrong', axis=1)
temp= temp.sort_values(by=['label'])
temp.shape
(826, 16)
Потім ви створюєте лямбда-функцію, яка отримує прогноз з моделі для нових даних. Вона вам незабаром знадобиться.
predict_fn = lambda x: model_xgb.predict_proba(x).astype(float)
X_test_lime.dtypes
age               float64
workclass           int64
fnlwgt            float64
education           int64
education_num     float64
marital             int64
occupation          int64
relationship        int64
race                int64
sex                 int64
capital_gain      float64
capital_loss      float64
hours_week        float64
native_country      int64
dtype: object
predict_fn(X_test_lime)
array([[7.96461046e-01, 2.03538969e-01],
       [9.51730132e-01, 4.82698716e-02],
       [7.93448269e-01, 2.06551731e-01],
       ...,
       [9.90314305e-01, 9.68566816e-03],
       [6.45816326e-04, 9.99354184e-01],
       [9.71042812e-01, 2.89571714e-02]])
Ви конвертуєте фрейм даних pandas у масив NumPy.
X_train_lime = X_train_lime.values
X_test_lime = X_test_lime.values
X_test_lime
array([[4.00000e+01, 5.00000e+00, 1.93524e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.70000e+01, 4.00000e+00, 2.16481e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       [2.50000e+01, 4.00000e+00, 2.56263e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01],
       ...,
       [2.80000e+01, 6.00000e+00, 2.11032e+05, ..., 0.00000e+00,
        4.00000e+01, 2.50000e+01],
       [4.40000e+01, 4.00000e+00, 1.67005e+05, ..., 0.00000e+00,
        6.00000e+01, 3.80000e+01],
       [5.30000e+01, 4.00000e+00, 2.57940e+05, ..., 0.00000e+00,
        4.00000e+01, 3.80000e+01]])
model_xgb.predict_proba(X_test_lime)
array([[7.9646105e-01, 2.0353897e-01],
       [9.5173013e-01, 4.8269872e-02],
       [7.9344827e-01, 2.0655173e-01],
       ...,
       [9.9031430e-01, 9.6856682e-03],
       [6.4581633e-04, 9.9935418e-01],
       [9.7104281e-01, 2.8957171e-02]], dtype=float32)
print(features,
      class_names,
      categorical_features,
      categorical_names)
['age', 'workclass', 'fnlwgt', 'education', 'education_num', 'marital', 'occupation', 'relationship', 'race', 'sex', 'capital_gain', 'capital_loss', 'hours_week', 'native_country'] ['<=50K' '>50K'] [1, 3, 5, 6, 7, 8, 9, 13] {'workclass': array(['?', 'Federal-gov', 'Local-gov', 'Never-worked', 'Private',
       'Self-emp-inc', 'Self-emp-not-inc', 'State-gov', 'Without-pay'],
      dtype=object), 'education': array(['10th', '11th', '12th', '1st-4th', '5th-6th', '7th-8th', '9th',
       'Assoc-acdm', 'Assoc-voc', 'Bachelors', 'Doctorate', 'HS-grad',
       'Masters', 'Preschool', 'Prof-school', 'Some-college'],
      dtype=object), 'marital': array(['Divorced', 'Married-AF-spouse', 'Married-civ-spouse',
       'Married-spouse-absent', 'Never-married', 'Separated', 'Widowed'],
      dtype=object), 'occupation': array(['?', 'Adm-clerical', 'Armed-Forces', 'Craft-repair',
       'Exec-managerial', 'Farming-fishing', 'Handlers-cleaners',
       'Machine-op-inspct', 'Other-service', 'Priv-house-serv',
       'Prof-specialty', 'Protective-serv', 'Sales', 'Tech-support',
       'Transport-moving'], dtype=object), 'relationship': array(['Husband', 'Not-in-family', 'Other-relative', 'Own-child',
       'Unmarried', 'Wife'], dtype=object), 'race': array(['Amer-Indian-Eskimo', 'Asian-Pac-Islander', 'Black', 'Other',
       'White'], dtype=object), 'sex': array(['Female', 'Male'], dtype=object), 'native_country': array(['?', 'Cambodia', 'Canada', 'China', 'Columbia', 'Cuba',
       'Dominican-Republic', 'Ecuador', 'El-Salvador', 'England',
       'France', 'Germany', 'Greece', 'Guatemala', 'Haiti', 'Honduras',
       'Hong', 'Hungary', 'India', 'Iran', 'Ireland', 'Italy', 'Jamaica',
       'Japan', 'Laos', 'Mexico', 'Nicaragua',
       'Outlying-US(Guam-USVI-etc)', 'Peru', 'Philippines', 'Poland',
       'Portugal', 'Puerto-Rico', 'Scotland', 'South', 'Taiwan',
       'Thailand', 'Trinadad&Tobago', 'United-States', 'Vietnam',
       'Yugoslavia'], dtype=object)}
import lime
import lime.lime_tabular
### Train should be label encoded not one hot encoded
explainer = lime.lime_tabular.LimeTabularExplainer(X_train_lime ,
                                                   feature_names = features,
                                                   class_names=class_names,
                                                   categorical_features=categorical_features,
                                                   categorical_names=categorical_names,
                                                   kernel_width=3)
Тепер виберіть випадкове домогосподарство з тестового набору та перегляньте як прогноз, так і те, як комп'ютер до нього дійшов.
import numpy as np
np.random.seed(1)
i = 100
print(y_test_lime.iloc[i])
>50K
X_test_lime[i]
array([4.20000e+01, 4.00000e+00, 1.76286e+05, 7.00000e+00, 1.20000e+01,
       2.00000e+00, 4.00000e+00, 0.00000e+00, 4.00000e+00, 1.00000e+00,
       0.00000e+00, 0.00000e+00, 4.00000e+01, 3.80000e+01])
Ви можете використовувати пояснювач разом з explain_instance, щоб перевірити логіку моделі. Діаграма, яку він відображає, показана нижче.
exp = explainer.explain_instance(X_test_lime[i], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

Класифікатор правильно передбачив це домогосподарство: дохід справді перевищує 50 тисяч.
Перше, що слід зазначити, це те, що класифікатор не дуже впевнений у собі. Він прогнозує дохід понад 50 тисяч з ймовірністю 64%, і що 64% зумовлені приростом капіталу та сімейним станом. Синій колір негативно впливає на позитивний клас, а помаранчева лінія — позитивно.
Класифікатор вагається, оскільки приріст капіталу цього домогосподарства дорівнює нулю, тоді як приріст капіталу зазвичай є добрим предиктором добробуту. Домогосподарство також працює менше 40 годин на тиждень. Вік, професія та стать – все це позитивно впливає.
Якби сімейний стан був неодруженим, класифікатор передбачив би дохід нижче 50 тисяч (0.64 – 0.18 = 0.46).
Тепер спробуйте інше домогосподарство, яке було класифіковано неправильно. Таблиця пояснення до нього відповідає коду.
temp.head(3)
temp.iloc[1,:-2]
age                  58
workclass             4
fnlwgt            68624
education            11
education_num         9
marital               2
occupation            4
relationship          0
race                  4
sex                   1
capital_gain          0
capital_loss          0
hours_week           45
native_country       38
Name: 20931, dtype: object
i = 1
print('This observation is', temp.iloc[i,-2:])
This observation is label        <=50K
predicted     >50K
Name: 20931, dtype: object
exp = explainer.explain_instance(temp.iloc[1,:-2], predict_fn, num_features=6)
exp.show_in_notebook(show_all=False)

Класифікатор передбачив дохід нижче 50 тисяч, що є неправильним. Це домогосподарство незвичайне: воно не має ні приросту капіталу, ні втрати капіталу, особа розлучена, їй близько 60 років, і вона освічена, тобто education_num > 12. Дотримуючись загальної закономірності, класифікатор розмістив домогосподарство нижче 50 тисяч.
Пограйтеся з LIME самі, і ви помітите безліч очевидних помилок у класифікаторі. Репозиторій GitHub автора бібліотеки містить додаткову документацію щодо класифікації зображень та тексту.
Довідник команд Scikit-learn
Нижче наведено список корисних команд, які застосовуються до scikit-learn версії 0.20 та пізніших.
| Завдання | Функція або клас |
|---|---|
| Створення набору даних для навчання/тесту | train_test_split |
| Побудуйте трубопровід | |
| Виберіть стовпці та застосуйте перетворення | створити_трансформатор_колонки |
| Тип трансформації | |
| Стандартизувати | StandardScaler |
| Масштабування від мінімуму до максимуму | MinMaxScaler |
| Нормалізувати | Нормалізатор |
| Імпутувати відсутні значення | Простий імпутер |
| Перетворення категоричних | OneHotEncoder |
| Припасуйте та трансформуйте дані | fit_transform |
| Зробіть трубопровід | make_pipeline |
| Базова модель | |
| Логістична регресія | Логістична регресія |
| XGBoost | XGBClassifier |
| Нейронна мережа | MLPClassifier |
| Пошук у сітці | GridSearchCV |
| Рандомізований пошук | Рандомізований пошук CV |
