
SAP DS (служби даних) у HANA
 Мейсон Гарсія
⚡ Розумний підсумок
SAP Data Services — це корпоративна ETL-платформа, яка переміщує та очищує дані з різнорідних джерел у SAP HANA. Дизайнер, сервер завдань, механізм, репозиторій та сервер доступу працюють разом для створення, планування та запуску потоків даних.
Що таке SAP Служби даних?
SAP Data Services – це інструмент ETL, який надає єдине рішення корпоративного рівня для інтеграції даних, трансформації, якості даних, профілювання даних та обробки текстових даних з гетерогенного джерела в цільову базу даних або сховище даних.
Застосунки, які називаються завданнями, створюються в Конструкторі, де дані відображаютьсяping та перетворення визначені. Продукт також називають SAP BusinessObjects Data Services, скорочено SAP BODS, і обидві назви описують один і той самий інструмент. SAP Поточний випуск Data Services 4.3; основне обслуговування версії 4.2 завершилося 31 травня 2023 року, тому нові впровадження мають розпочатися з версії 4.3.
У межах SAP ландшафт ХАНА, SAP Служби даних – це варіант, який обирають, коли дані потрібно переформатувати під час надходження, а не копіювати їх у наявному вигляді. У розділах нижче розглядається, що пропонує цей інструмент, як його частини поєднуються між собою та повне робоче навантаження від SAP таблицю ECC у SAP ХАНА.
Особливості SAP Служби даних
Наведені нижче можливості пояснюють, чому SAP Data Services позиціонується як платформа корпоративного рівня, а не як проста утиліта копіювання.
- Він забезпечує високопродуктивні паралельні перетворення.
- Він має комплексні адміністративні інструменти та інструмент звітності.
- Він підтримує кілька користувачів.
- SAP ТІЛА дуже гнучкий із застосунками на основі веб-сервісів.
- Це дозволяє створювати мову сценаріїв з багатим набором функцій.
- SAP Data Services можна інтегрувати з SAP Сервер реплікації LT (SLT) використовуючи технологію на основі тригерів. SLT додає дельта-можливості до кожного SAP або не-SAP вихідна таблиця, яка дозволяє збирати дані про зміни та передавати дельта-дані з вихідної таблиці.
- Перевірка даних за допомогою інформаційних панелей і аудит процесів.
- Інструмент адміністрування з можливостями планування та панелями моніторингу.
- Налагодження, вбудоване профілювання та перегляд даних.
- SAP Служби даних підтримують широкий спектр джерел та цільових даних:
- Будь-яке застосування, наприклад SAP.
- Будь-яка база даних з масовим завантаженням та збором змін у даних.
- Файли: фіксованої ширини, розділені комами, COBOL, XML та перевершувати.
Ці функції забезпечуються невеликим набором встановлюваних компонентів, кожен з яких має окрему роль.
Компоненти SAP Служби даних
SAP Служби даних мають наведені нижче компоненти.
- Дизайнер – Це інструмент розробки, за допомогою якого ми можемо створювати, тестувати та виконувати завдання, що заповнюють сховище даних. Він дозволяє розробнику створювати об’єкти та налаштовувати їх, вибираючи значок на блок-схемі джерела-цілі. Його можна використовувати для створення програми, вказуючи робочі процеси та потоки даних. Щоб відкрити Конструктор служб даних, перейдіть до Меню Пуск -> Усі програми -> SAP Служби даних -> Конструктор служб даних.

- Сервер завдань – Це програма, яка запускає механізм обробки даних та слугує інтерфейсом до механізму та пакету служб даних.
- двигун – Механізм обробки даних виконує окремі завдання, визначені в застосунку.
- Сховище – Репозиторій – це база даних, яка зберігає попередньо визначені об’єкти Дизайнера та об’єкти, визначені користувачем (вихідні та цільові метадані, правила перетворення). Репозиторії бувають двох типів:
- Локальний репозиторій (використовується Дизайнером та Сервером завдань).
- Центральне сховище (використовується для спільного використання об'єктів та контролю версій).
- Сервер доступу – Сервер доступу передає повідомлення між веб-застосунками, сервером завдань служб даних та механізмами.
- адміністратор – Веб-адміністратор забезпечує адміністрування ресурсів служб даних через браузер, детально описано нижче:
- Налаштування, запуск та зупинкаping послуги в режимі реального часу.
- Планування, моніторинг та виконання пакетних завдань.
- Налаштування сервера завдань, сервера доступу та використання репозиторію.
- Керування користувачами.
- Публікація пакетних завдань та сервісів реального часу через веб-сервіси.
- Налаштування та керування адаптерами.
Знання того, що робить кожен компонент, – це лише половина справи. Архітектура нижче показує, як вони взаємодіють під час навантаження.
SAP Служби даних Archiтектура
Архітектура служб даних має такі компоненти:
- Центральне сховище – використовується для налаштування сховища для серверів завдань, управління безпекою, контролю версій та спільного використання об'єктів.
- Конструктор – використовується для створення проекту, завдання, робочого процесу та потоку даних, а також для їх запуску.
- Локальний репозиторій – тут ви можете створювати, змінювати та запускати завдання, робочі процеси та потоки даних.
- Сервер і механізм завдань – він керує завданнями.
- Сервер доступу – він використовується для виконання завдань у режимі реального часу, створених розробниками в репозиторіях.
На зображенні нижче показано служби даних та зв'язки між їх компонентами.

SAP ТІЛА Archiтектура
Дизайнерські деталі вікна
Конструктор – це компонент, на який розробник витрачає найбільше часу, тому його структуру варто вивчити спочатку. Детальний опис кожного розділу Конструктора служб даних наведено нижче:
- Панель інструментів (використовується для Відкрити, Зберегти, Назад, Перевірити, Виконати тощо).
- Площа проекту (містить поточний проект, який включає завдання, робочий процес та потік даних. У службах даних усі сутності є об'єктами).
- Робочий простір (область вікна програми, в якій ми визначаємо, відображаємо та змінюємо об'єкти).
- Локальна бібліотека об'єктів (він містить об'єкти локального репозиторію, такі як перетворення, завдання, робочий процес, потік даних тощо).
- Палітра інструментів (кнопки на палітрі інструментів дозволяють додавати нові об'єкти до робочої області).

Ієрархія об'єктів
На діаграмі нижче показано ієрархічні зв'язки для ключових типів об'єктів у службах даних.

Примітка: У легенді нижче позначено додаткові елементи ієрархії.

Робочі процеси та умови необов'язкові.
Предмети, що використовуються в SAP Детальніше про послуги з обробки даних наведено нижче.
| Об'єкти | Опис |
|---|---|
| Проекти | Проект – це об’єкт найвищого рівня у вікні конструктора. Проекти надають вам спосіб упорядкування інших об’єктів, які ви створюєте в службах даних. Одночасно відкритий лише один проект, де «відкритий» означає «видимий в області проекту». |
| робота | «Завдання» — це найменша одиниця роботи, яку можна незалежно запланувати для виконання. |
| Сценарії | Підмножина рядків у процедурі. |
| Workflow | «Робочий процес» – це об’єднання кількох потоків даних у цілісний потік робіт для всього завдання. Робочий процес є необов’язковим. Робочий процес – це процедура, яка може:
|
| Потік даних | «Потік даних» – це процес, за допомогою якого вихідні дані перетворюються на цільові. Потік даних – це об’єкт повторного використання. Він завжди викликається з робочого процесу або завдання. Він використовується для:
|
| Магазин даних | Логічний канал, який з'єднує служби даних з вихідними та цільовими базами даних. Сховища даних:
|
| Target | Таблиця або файл, у який служби даних завантажують дані з джерела. |
SAP Послуги передачі даних проти SLT проти DXC
SAP Служби даних – це один із кількох надання даних варіанти для SAP HANA, а вибір неправильного варіанту додає витрат, які жодне налаштування не окупає. У таблиці нижче порівнюються три методи на стороні сервера.
| Критерії | SAP Служби даних | SLT | DXC |
|---|---|---|---|
| Затримка | Пакетне або заплановане | Реальний час | Пакет, запланований DataSource |
| Перетворення | Повний ETL, очищення та профілювання | Прості правила фільтрів та полів | Нічого, крім колишньогоtracлогіка тор |
| Джерело | SAP іSAP, файли, програми | SAP іSAP базами даних | SAP Тільки бізнес-люкс |
| Потрібен додатковий сервер | Так, сервер завдань | Зазвичай так | Немає |
| Найкраще підходить для | Якість даних та консолідація з кількох джерел | Operaзвітність про дані в реальному часі | Повторне використання існуючого бізнес-контентуtracторс |
Словом, вибирайте SAP Служби обробки даних, коли дані необхідно очистити, об’єднати або стандартизувати перед їх надходженням. Виберіть SLT, коли звіт має відображати транзакцію в міру її здійснення, та DXC коли перевірений бізнес-контент колишнійtractor вже створює потрібну вам семантику. Для одноразового набору даних без графіка повторення, a завантаження плоского файлу швидше, ніж налаштування будь-якого з трьох.
Як завантажити дані з SAP Використання вихідної таблиці SAP Служби даних
Усе в службах даних є об'єктом. Для кожної вихідної та цільової бази даних потрібне окреме сховище даних.
Повна послідовність завантаження даних з SAP Вихідна таблиця наведена нижче. Кожен крок потім показано детально.
- Створіть сховище даних між джерелом та BODS
- Імпорт метаданих (структур) до BODS
- Налаштування сервера імпорту
- Імпорт метаданих у систему HANA
- Створення сховища даних між BODS та HANA
- Створіть проект
- Створення завдання (пакетне або в режимі реального часу)
- Створіть робочий процес
- Створення потоку даних
- Додавання об'єктів до потоку даних
- Виконайте завдання
- Перевірте попередній перегляд даних у HANA
Крок 1) Створіть сховище даних між SAP джерело та БОДС.
- Щоб завантажити дані з SAP джерело в SAP HANA через SAP Для BODS потрібне сховище даних. Тому спочатку створюємо сховище даних, як показано нижче – Проект -> Новий -> Сховище даних

- З’явиться спливаюче вікно для створення нового сховища даних. Введіть наведені нижче дані:
- Введіть назву сховища даних «ds_ecc».
- Виберіть назву типу сховища даних як «SAP Додатки».
- Введіть ім'я сервера бази даних.
- Введіть ім'я користувача та пароль.
- Натисніть кнопку «Застосувати».
- Натисніть кнопку “OK”.

- Сховище даних буде створено. Перегляньте створене сховище даних, як показано нижче.
- Перейдіть до локальної бібліотеки об'єктів.
- Виберіть вкладку Сховище даних.
- Буде відображено сховище даних «ds_ecc».

Крок 2) Імпорт метаданих (структури) на сервер BODS.
Ми створили сховище даних для ECC до BODS; тепер імпортуємо метадані з ECC до BODS. Щоб імпортувати, виконайте наведені нижче дії.
- Виберіть сховище даних «ds_ecc» та клацніть правою кнопкою миші.
- Виберіть опцію «Імпортувати за іменем».

З’явиться спливаюче вікно для імпорту за назвою. Введіть дані, як зазначено нижче:
- Виберіть Тип як таблиця.
- Введіть назву таблиці для імпорту. Тут ми імпортуємо таблицю KNA1.
- Натисніть кнопку «Імпорт». Таблиця KNA1 з’явиться у вузлі «Таблиця» джерела даних «ds_ecc».

Метадані таблиці будуть імпортовані до сховища даних ds_ecc, як показано нижче.

Крок 3) Налаштуйте сервер імпорту.
Наразі ми імпортували таблицю до сховища даних «ds_ecc», створеного для ECC. SAP З’єднання BODS. Щоб імпортувати дані в SAP ХАНА, нам потрібно налаштувати сервер імпорту.
- Для цього перейдіть до Швидкий перегляд -> Налаштувати сервер імпорту як зазначено нижче.

- З’явиться спливаюче вікно «Вибір системи». Виберіть SAP Система HANA (тут HDB), як показано нижче.

- Натисніть кнопку «Далі». З’явиться ще одне спливаюче вікно для введення облікових даних служб даних. Введіть такі дані:
- SAP Адреса сервера BODS (тут BODS:6400).
- SAP Назва репозиторію BODS (назва репозиторію HANAUSER).
- Джерело даних ODBC (ZTDS_DS).
- Порт за замовчуванням для SAP Сервер BODS (8080).

Натисніть кнопку «Готово».
Крок 4) Імпортуйте метадані в систему HANA.
Сервер імпорту тепер налаштовано, тож метадані можна імпортувати з SAP Сервер BODS.
- Натисніть опцію «Імпорт» у вікні швидкого перегляду.
- З’явиться спливаюче вікно з параметрами імпорту. Виберіть опцію «Вибірковий імпорт метаданих».

Натисніть на кнопку «Далі».
З’явиться спливаюче вікно «Вибірковий імпорт метаданих», у якому ми вибираємо цільову систему.
- Оберіть SAP Система HANA (тут HDB).

Натисніть на кнопку «Далі».
Крок 5) Створіть сховище даних між BODS та HANA.
У BODS потрібне окреме сховище даних для джерела та цільового сховища. Вихідне сховище даних вже існує, тому далі створюється цільове сховище даних між BODS та HANA з назвою «DS_BODS_HANA».
- Перейдіть до проекту -> Створити -> Сховище даних.
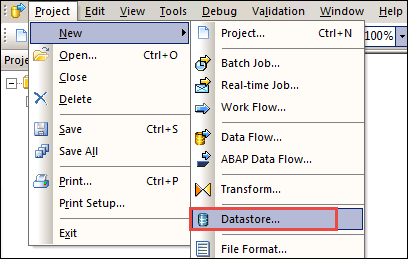
- З’явиться екран для створення нового сховища даних, як показано нижче.
- Введіть назву сховища даних (DS_BODS_HANA).
- Введіть тип сховища даних як База даних.
- Введіть тип бази даних як SAP ХАНА.
- Виберіть версію бази даних.
- Введіть SAP Ім'я сервера бази даних HANA.
- Введіть назву порту для SAP База даних HANA.
- Введіть ім'я користувача та пароль.
- Поставте галочку навпроти пункту «Увімкнути автоматичну передачу даних».

Натисніть кнопку «Застосувати», а потім кнопку «ОК».
Сховище даних «DS_BODS_HANA» буде відображатися на вкладці «Сховище даних» у локальній бібліотеці об’єктів, як показано нижче.

- Тепер ми імпортуємо таблицю до сховища даних «DS_BODS_HANA».
- Виберіть сховище даних «DS_BODS_HANA» та клацніть правою кнопкою миші.
- Виберіть «Імпорт за назвою».

- З’явиться спливаюче вікно для імпорту за назвою, як показано нижче.
- Виберіть Тип як таблиця.
- Введіть назву як KNA1.
- Власник відображатиметься як Hanauser.
- Натисніть кнопку «Імпорт».

Таблицю буде імпортовано до сховища даних «DS_BODS_HANA». Щоб переглянути дані в таблиці, виконайте наведені нижче дії.
- Клацніть на таблиці «KNA1» у сховищі даних «DS_BODS_HANA».
- Дані будуть відображені у табличному форматі.

Крок 6) Визначте проєкт. Проєкт групує та впорядковує пов'язані об'єкти. Проєкт може містити будь-яку кількість завдань, робочих процесів та потоків даних.
- Перейдіть до меню «Проект дизайнера».
- Виберіть опцію «Новий».
- Виберіть опцію «Проект».

З’явиться спливаюче вікно для створення нового проекту, як показано нижче. Введіть назву проекту та натисніть кнопку «Створити». Буде створено папку проекту, у нашому випадку BODS_DHK.

Крок 7) Визначте роботу. Завдання – це об'єкт повторного використання. Воно містить робочі процеси та потоки даних. Завдання можна виконувати вручну або за розкладом. Для виконання процесу BODS завдання має бути визначено.
Ми створюємо завдання з назвою JOB_Customer.
- Виберіть проєкт (BODS_DHK), створений на попередньому кроці, клацніть правою кнопкою миші та виберіть «Нове пакетне завдання».
- Перейменуйте його на «JOB_Customer».

Крок 8) Визначте робочий процес.
- Виберіть завдання «JOB_Customer» в області проекту.
- Натисніть кнопку робочого процесу на палітрі інструментів. Клацніть на порожній області робочого простору. У робочому просторі з’явиться значок робочого процесу.
- Змініть назву робочого процесу на «WF_Customer».

Клацніть назву робочого процесу, і в робочій області з’явиться порожнє подання для робочого процесу.

Крок 9) Визначте потік даних.
- Клацніть на робочому процесі «WF_Customer».
- Натисніть кнопку потоку даних на палітрі інструментів. Клацніть на порожній області робочої області. У робочій області з’явиться значок потоку даних.
- Змініть назву потоку даних на «DF_Customer».
- Потік даних також відображається в області проекту ліворуч, під назвою завдання.

Крок 10) Додайте об'єкти до потоку даних.
Усередині потоку даних ми надаємо інструкції для перетворення вихідних даних у бажану форму для цільової таблиці.
Використовуються три об'єкти:
- Об'єкт для джерела.
- Об’єкт для цільової таблиці.
- Об'єкт для перетворення запиту, який зіставляє стовпці з джерела з цільовим.
Клацніть на потоці даних DF_Customer. З’явиться порожня робоча область, як показано нижче.
- Вкажіть об'єкт для джерела – Перейдіть до сховища даних «ds_ecc», виберіть таблицю KNA1 та перетягніть її на порожній екран потоку даних.
- Вкажіть об'єкт для цілі – Виберіть сховище даних «DS_BODS_HANA» з репозиторію та виберіть таблицю KNA1.
- Перетягніть його на робочу область та виберіть «Створити» Target«опція». Тепер буде дві таблиці, одна вихідна та одна цільова.

- Трансформація запитів – Це інструмент, який використовується для отримання даних на основі схеми введення для певної користувачем умови та для транспортування даних від джерела до цільового об’єкта.
- Виберіть значок «Перетворення запиту» на палітрі інструментів і перетягніть його між вихідним і цільовим об’єктами в робочій області.
- Зв'яжіть об'єкт Query з джерелом.
- Зв'яжіть об'єкт запиту з цільовою таблицею.

Double-натисніть на піктограму запиту, щоб зіставити стовпці з вхідної схеми з вихідною схемою. Зіставленняping з'явиться вікно, в якому ми робимо наступне:
- Вибрано вихідну таблицю KNA1.
- Виберіть усі стовпці з вихідної таблиці, клацніть правою кнопкою миші та виберіть «Зіставити з виводом».
- Цільовий вивід вибрано як Запит, а стовпці будуть зіставлені.

Збережіть та підтвердьте проєкт. Натисніть на значок «Перевірити». З’явиться спливаюче вікно з підтвердженням успішної перевірки.

Крок 11) Виконайте завдання. Щоб виконати завдання, дотримуйтесь наведеного нижче шляху.
- Виберіть піктограму області проекту, щоб відкрити проект, і виберіть створений проект.
- Виберіть завдання та клацніть правою кнопкою миші.
- Виберіть опцію «Виконати», щоб виконати завдання.
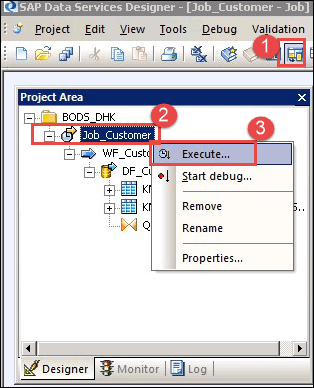
Після виконання завдання відображається вікно журналу завдань, у якому відображаються всі повідомлення щодо завдання. Останнім повідомленням буде «Завдання успішно завершено».

Крок 12) Перевірте та підтвердьте дані у SAP База даних HANA.
- Увійти в SAP через базу даних HANA SAP Студія HANAта виберіть схему HANAUSER.
- Виберіть таблицю KNA1 у вузлі «Таблиця».
- Клацніть правою кнопкою миші на таблиці KNA1 та виберіть «Відкрити попередній перегляд даних».
- Дані KNA1, завантажені процесом BODS, будуть відображені на екрані попереднього перегляду даних.

Збіг кількості рядків у вихідній таблиці та цьому попередньому перегляді підтверджує правильність завантаження, і адміністратор може запланувати повторне виконання завдання.
