
MongoDB Регулярний вираз ($regex) з прикладами
 Стівен Твен
⚡ Розумний підсумок
MongoDB Регулярні вирази виконують зіставлення зі зразком для пошуку рядків у документах, використовуючи оператор $regex, прапорець $options для нечутливості до регістру, прив'язки для точних збігів та роздільники зі сксельною рискою, коли точне значення поля невідоме.
Регулярні вирази використовуються для зіставлення зі зразком, що, по суті, призначене для пошуку рядків у документах.
Іноді під час отримання документів у колекції ви можете не знати точно, яке саме значення поля потрібно шукати. Отже, можна використовувати регулярні вирази, щоб допомогти отримати дані на основі пошукових значень, що відповідають шаблонам.
Використання оператора $regex для зіставлення шаблону
Оператор $regex у MongoDB використовується для пошуку певних рядків у колекції. Наступний приклад показує, як це можна зробити.
Припустимо, що у нас є та сама колекція Employee, яка має назви полів «Employeeid» та «EmployeeName». Також припустимо, що в нашій колекції є такі документи.
| ID працівника | ім'я працівника |
|---|---|
| 22 | Новий Мартін |
| 2 | Мохан |
| 3 | Джо |
| 4 | Мохан Р |
| 100 | Guru99 |
| 6 | Gurang |
Тут, у наведеному нижче коді, ми використали оператор $regex для визначення критеріїв пошуку.

db.Employee.find({EmployeeName : {$regex: "Gu" }}).forEach(printjson)
Code Пояснення:
- Тут ми хочемо знайти всі імена співробітників, які містять символи «Gu». Тому ми вказуємо оператор $regex для визначення критеріїв пошуку «Gu».
- Printjson використовується для кращого друку кожного документа, який повертає запит.
Якщо команда виконана успішно, буде показано наступний результат:
вихід:

Вихідні дані чітко показують, що повертаються ті документи, у яких ім’я працівника містить символи «Gu».
Припустимо, що ваша колекція містить такі документи, а також додатковий документ, у якому ім'я співробітника вказано як «Guru999”. Якщо ви ввели критерії пошуку як «Guru99”, він також поверне документ, який мав «Guru999”. Але припустимо, що ми цього не хочемо, а хочемо повернути документ лише з кодом “Guru99”. Тоді ми можемо зробити це за допомогою точного зіставлення зі зразком. Щоб виконати точне зіставлення зі зразком, ми використовуватимемо символи ^ та $. Ми додамо символ ^ на початок рядка та $ у кінець рядка.
| ID працівника | ім'я працівника |
|---|---|
| 22 | Новий Мартін |
| 2 | Мохан |
| 3 | Джо |
| 4 | Мохан Р |
| 100 | Guru99 |
| 6 | Gurang |
| 8 | Guru999 |
Наступний приклад показує, як це можна зробити.
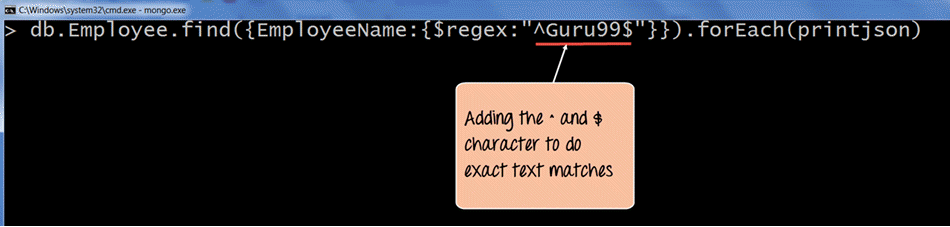
db.Employee.find({EmployeeName : {$regex: "^Guru99$"}}).forEach(printjson)
Code Пояснення:
- Тут, у критеріях пошуку, ми використовуємо символи ^ та $. Символ ^ використовується, щоб переконатися, що рядок починається з певного символу, а $ використовується, щоб переконатися, що рядок закінчується певним символом. Таким чином, коли код виконується, він отримає лише рядок з назвою «Guru99 ".
- Printjson використовується для кращого друку кожного документа, який повертає запит.
Якщо команда виконана успішно, буде показано наступний результат:
вихід:
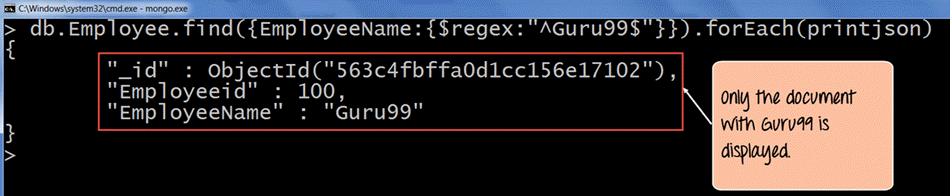
У виводі чітко видно, що рядок «GuruОтримано 99 дюймів.
Зіставлення шаблону з $options
Під час використання оператора $regex також можна надати додаткові опції, використовуючи $параметри ключове слово. Наприклад, припустімо, що ви хочете знайти всі документи, у імені співробітника яких є «Gu», незалежно від того, чи враховується регістр чи не враховується. Якщо такий результат бажаний, то нам потрібно використовувати $параметри з параметром нечутливості до регістру.
Наступний приклад показує, як це можна зробити.
Припустимо, що у нас є та сама колекція Employee, яка має назви полів «Employeeid» та «EmployeeName».
Також припустимо, що в нашій колекції є такі документи.
| ID працівника | ім'я працівника |
|---|---|
| 22 | Новий Мартін |
| 2 | Мохан |
| 3 | Джо |
| 4 | Мохан Р |
| 100 | Guru99 |
| 6 | Gurang |
| 7 | ГУРУ99 |
Тепер, якщо ми виконаємо той самий запит, що й у попередній темі, ми ніколи не побачимо документ із «GURU99» у результаті. Щоб гарантувати його появу в результуючому наборі, нам потрібно додати параметр «i» для $options.
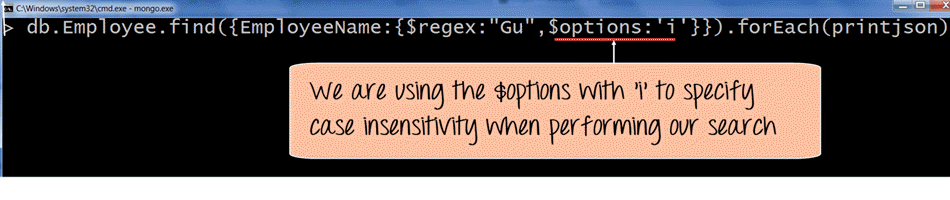
db.Employee.find({EmployeeName:{$regex: "Gu",$options:'i'}}).forEach(printjson)
Code Пояснення:
- Параметр $options з параметром 'i' (що означає нечутливість до регістру) вказує, що пошук буде виконуватися незалежно від того, чи знайдено літери 'Gu' у нижньому чи верхньому регістрі.
Якщо команда виконана успішно, буде показано наступний результат:
вихід:
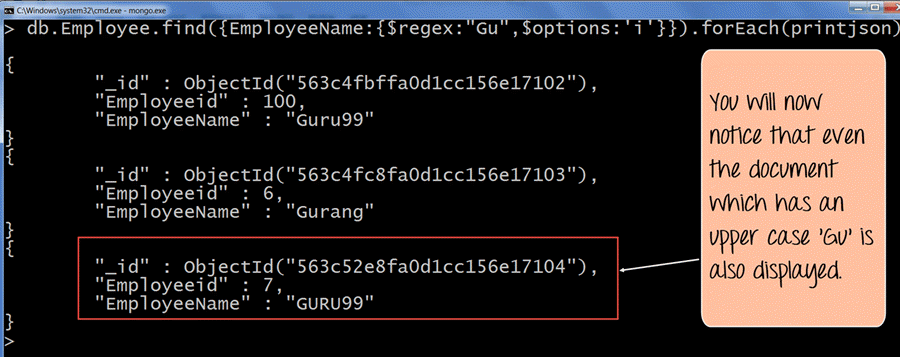
- Вивід чітко показує, що навіть якщо один документ містить велику літеру «Gu», він все одно відображається в результуючому наборі.
Зіставлення шаблону без оператора регулярного виразу
Також можна виконувати зіставлення зі зразком без оператора $regex. Наступний приклад показує, як це можна зробити.
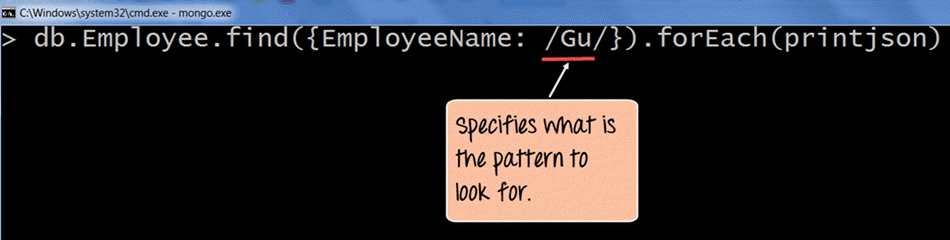
db.Employee.find({EmployeeName: /Gu/}).forEach(printjson)
Code Пояснення:
- Роздільники «//» по суті означають, що вони вказують критерії пошуку в межах цих роздільників. Отже, ми вказуємо /Gu/, щоб знову знайти ті документи, які містять «Gu» в імені співробітника.
Якщо команда виконана успішно, буде показано наступний результат:
вихід:
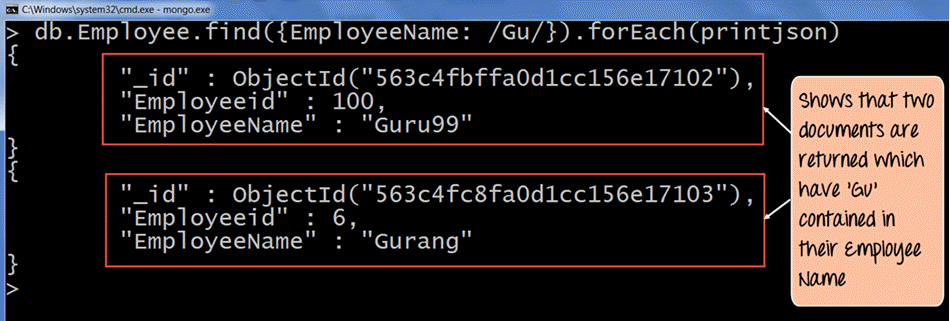
Вихідні дані чітко показують, що повертаються ті документи, у яких ім’я працівника містить символи «Gu».
Отримання останніх 'n' документів із колекції
Існують різні способи отримати останні n документів у колекції.
Давайте розглянемо один із способів, виконавши наступні кроки.
Наступний приклад показує, як це можна зробити.
Припустимо, що у нас є та сама колекція Employee, яка має назви полів «Employeeid» та «EmployeeName».
Також припустимо, що в нашій колекції є такі документи:
| ID працівника | ім'я працівника |
|---|---|
| 22 | Новий Мартін |
| 2 | Мохан |
| 3 | Джо |
| 4 | Мохан Р |
| 100 | Guru99 |
| 6 | Gurang |
| 7 | ГУРУ99 |
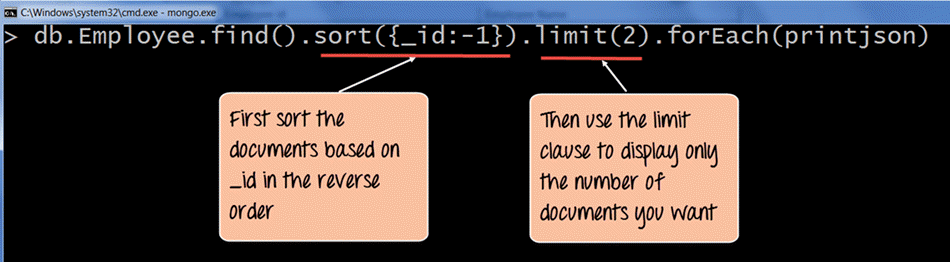
db.Employee.find().sort({_id:-1}).limit(2).forEach(printjson)
Code Пояснення:
- Під час запиту документів використовуйте функцію sort для сортування записів у зворотному порядку на основі значення поля _id у колекції. -1 по суті вказує на сортування документів у зворотному порядку або порядку спадання, щоб останній документ став першим документом, який буде відображено.
- Потім використовуйте блок limit, щоб просто відобразити потрібну кількість записів. Тут ми встановили блок limit (2), тому він вибере два останні документи.
Якщо команда виконана успішно, буде показано наступний результат:
вихід:
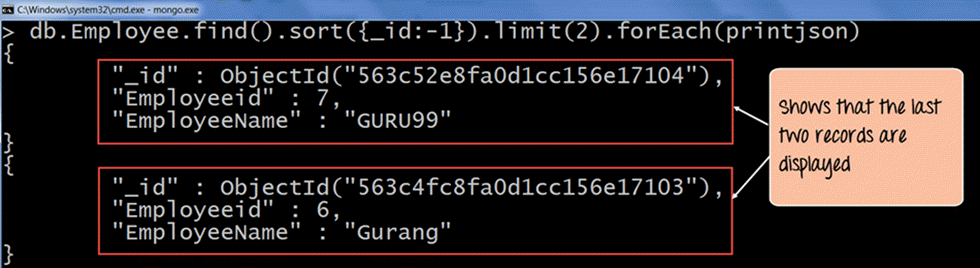
Вихідні дані чітко показують, що відображаються останні два документи в колекції. Отже, ми чітко показали, що для отримання останніх 'n' документів у колекції ми можемо спочатку відсортувати документи в порядку спадання, а потім використати обмеження, щоб повернути 'n' кількість необхідних документів.
Примітка:: Якщо пошук виконується в рядку, який перевищує, наприклад, 38,000 XNUMX символів, він не відображатиме правильні результати.
