
Що таке тестування відновлення? з прикладом
 Томас Гамільтон
⚡ Розумний підсумок
Тестування відновлення перевіряє, чи може програмне забезпечення відновити нормальну роботу після збою, падіння мережі або апаратного збою, шляхом відновлення системи до відомого справного стану та повторної обробки транзакцій до моменту збою.
Що таке тестування відновлення?
Тестування відновлення – це метод тестування програмного забезпечення, який перевіряє здатність програмного забезпечення відновлюватися після збоїв, таких як збої програмного або апаратного забезпечення та збої мережі. Метою тестування відновлення є визначення того, чи можна продовжувати роботу програмного забезпечення після катастрофи або втрати цілісності. Тестування відновлення включає повернення програмного забезпечення до стану, коли цілісність була відомою, та повторну обробку транзакцій до точки збою.
У програмній інженерії тестування на відновлюваність є типом нефункціональне тестування — він охоплює аспекти, не пов’язані з певною функцією чи дією користувача, такі як масштабованість або безпека. Його виконують професійні тестувальники, а достатні резервні копії даних зберігаються в безпечних місцях заздалегідь.
Приклад тестування відновлення
Два сценарії демонструють цю техніку в найпростішому вигляді. У кожному з них навмисно виникає збій, а потім спостерігається за роботою програми під час її відновлення.
- Перебої в мережі: Поки програма отримує дані з мережі, від’єднайте з’єднувальний кабель. Через деякий час під’єднайте його знову та проаналізуйте здатність програми продовжувати отримувати дані з моменту розриву з’єднання.
- Відновлення сеансу: Перезавантажте систему, коли браузер має певну кількість відкритих сеансів, і перевірте, чи браузер відновлює всі з них.
На ілюстрації нижче та сама ідея викладена у візуальній формі.
Час відновлення залежить від:
- Кількість точок перезапуску
- Обсяг даних, що зберігаються в додатку
- Підготовка та навички людей, які проводять заходи з відновлення, а також інструменти, доступні для відновлення
Коли трапляється кілька збоїв, тестування відновлення слід проводити структуровано, а не одночасно — спочатку для одного сегмента, а потім для іншого.
Життєвий цикл процесу відновлення
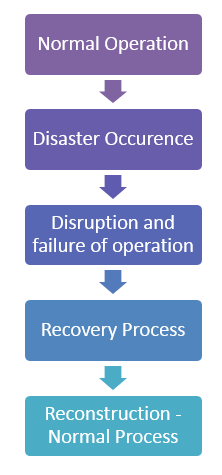
Перш ніж розробляти тестові випадки, корисно побачити, де втручається тест відновлення. Життєвий цикл процесу відновлення складається з п'яти кроків:
- Нормальна робота
- Виникнення катастрофи
- Зрив і зрив операції
- Усунення катастрофи через процес відновлення
- Реконструкція всіх процесів та інформації, повернення всієї системи до нормального режиму роботи
Наведена нижче блок-схема послідовно показує ці п'ять етапів.
Давайте детально обговоримо ці п'ять кроків:
- Нормальна експлуатація. Система апаратного, програмного та мікропрограмного забезпечення, інтегрована для досягнення спільної мети, виконує свою розроблену роботу без перебоїв протягом встановленого періоду часу.
- Виникнення стихійного лиха. Перебої можуть виникнути через несправність програмного забезпечення з таких причин, як несправність, ініційована введенням даних, збій, спричинений апаратним збоєм, або пошкодження внаслідок пожежі, крадіжки чи страйку.
- Зрив та невдача. Це найболючіша фаза, яка призводить до бізнес-втрат, розриву стосунків, втрачених можливостей, втрати людино-годин і, незмінно, фінансових втрат та втрат репутації. План аварійного відновлення мінімізує цей етап.
- Ліквідація наслідків стихійних лих. Якщо резервний план та процеси зменшення ризиків вже існують, відновлення коштує набагато менше часу та зусиль. Призначена команда, в якій роль кожної людини визначена заздалегідь, встановлює відповідальність та запобігає тривалому періоду перебоїв у роботі.
- Реконструкція. Це може включати кілька сеансів роботи для відновлення всіх папок разом із файлами конфігурації. Для правильного відновлення потрібна належна документація та визначений процес реконструкції.
Стратегія відновлення
Команда відновлення повинна мати власну стратегію отримання важливого коду та даних для повернення до нормального режиму роботи. Ця стратегія є унікальною для кожної організації, ґрунтується на критичності систем, з якими вона працює, а для критичних систем вона зводиться до набору варіантів:
- Одна резервна копія або декілька
- Кілька резервних копій в одному місці або в різних місцях
- Резервне копіювання онлайн або резервне копіювання офлайн
- Резервне копіювання запускається автоматично згідно з політикою або вручну
- Незалежна команда реставраторів або команда розробників, яка виконує роботу
Кожен вибір має певний фактор витрат, а кілька резервних копій можуть споживати більше фізичних ресурсів або вимагати незалежної команди. Залежність також має значення: компанії піддаються ризикам через код і дані, які вони зберігають у одного постачальника, і великомасштабне AWS Збої неодноразово призводили до одночасної зупинки роботи відомих споживчих служб. У таких випадках вирішальне значення має можливість незалежного відновлення.
Як виконати тестування відновлення
Стратегія визначена, наступне питання полягає в тому, як налаштовано сам тест. Під час проведення тестування відновлення слід враховувати наступні моменти.
- Створіть тестовий стенд максимально наближеним до реальних умов розгортання: інтерфейс, протокол, прошивка, апаратне та програмне забезпечення повинні відповідати виробничим умовам.
- Хоча вичерпне тестування може зайняти багато часу та бути дорогим, все ж слід виконати ідентичну конфігурацію та повну перевірку.
- Якщо можливо, протестуйте на обладнанні, на яке буде зрештою відновлено дані, особливо якщо відновлення відбувається на машину, відмінну від тієї, на якій було створено резервну копію.
- Деякі системи резервного копіювання очікують, що жорсткий диск має точно такий самий розмір, як той, з якого було зроблено резервну копію.
- Керування застарілістю: технології накопичувачів швидко розвиваються, і старий накопичувач може бути несумісним з новим. Відновлення до віртуальна машина допомагає, оскільки програмне забезпечення для віртуалізації може імітувати існуюче обладнання, включаючи розміри дисків.
- Системи онлайн-резервного копіювання не є винятком для тестування. Більшість постачальників захищають користувачів від проблем із носіями даних завдяки відмовостійкому сховищу, тому збої виникають пізно.
- Хоча системи онлайн-резервного копіювання надзвичайно надійні, сторону відновлення необхідно протестувати, щоб підтвердити відсутність проблем з отриманням, безпекою чи шифруванням.
Оскільки відновлення відбувається від початку до кінця, ці пробіжки зазвичай плануються паралельно тестування системи а не на рівні одиниці/одиниці.
Процедура тестування після реставрації
Відновлення даних – це лише половина справи; відновлену копію все ще потрібно довести, що вона придатна для використання. Більшість великих корпорацій мають незалежних аудиторів, які періодично проводять перевірки відновлення. Підтримка та тестування комплексного плану аварійного відновлення є дорогими, тому менші організації часто покладаються на резервні копії та зовнішнє сховище.
Після відновлення папок і файлів наступні перевірки підтверджують їх правильність відновлення:
- Перейменуйте пошкоджену папку документів, щоб відновлену копію не можна було сплутати з нею.
- Порахуйте файли у відновлених папках та зіставте цю кількість з кількістю файлів у вихідній папці.
- Відкрийте кілька файлів у програмі, яка їх зазвичай використовує, і переконайтеся, що дані можна переглядати та оновлювати як завжди.
- Відкрийте кілька файлів різних типів — зображення, MP3та документи, деякі великі, а деякі малі.
- Використовуйте утиліти порівняння файлів і каталогів, які більшість операційні системи забезпечити.
