
Як замінити відсутні значення (NA) у R: na.omit & na.rm
 Евелін Кларк
⚡ Розумний підсумок
Заміна відсутніх значень у R охоплює виявлення значень NA, видалення неповних рядків за допомогою na.omit() та імпутування їх із середнім значенням або медіаною за допомогою mutate(). У цьому покроковому посібнику використовується набір даних Titanic, де age та fare містять відсутні спостереження.
Що таке відсутні значення в R?
Відсутні значення з'являються, коли спостереження не має записаного значення в стовпці або коли нечисловий заповнювач знаходиться там, де мало бути число. Їх необхідно видалити або замінити перед будь-яким обчисленням, оскільки більшість функцій R повертають NA в момент появи такого значення.
У цьому посібнику показано, як обробляти відсутні значення за допомогою бібліотеки dplyr, яка є частиною екосистеми tidyverse для аналізу даних.
Перший крок — це завжди з'ясувати, скільки значень відсутнє і де.
Як виявити та підрахувати відсутні значення в R
Перш ніж вирішувати, що робити з відсутніми значеннями, вам потрібно знати, скільки їх і де вони знаходяться. R пропонує чотири перевірки, від однієї відповіді «так» або «ні» до повного підрахунку по стовпцях.
# 1. Is there any NA at all?
anyNA(df_titanic)

# 2. How many in total?
sum(is.na(df_titanic))

# 3. How many per column, the most useful view
colSums(is.na(df_titanic))

# 4. Percentage missing per column
round(colMeans(is.na(df_titanic)) * 100, 1)
На практиці краще використовувати colSums(). Він повертає іменований вектор з одним значенням підрахунку на стовпець, що одразу показує, чи змінній бракує кількох значень, чи вона здебільшого порожня.
Підрахунок повних рядків. complete.cases() повертає TRUE для рядків без пропущених значень, що заздалегідь повідомляє, скільки даних na.omit() відкине:
sum(complete.cases(df_titanic))       # rows that would survive
sum(!complete.cases(df_titanic))      # rows that would be dropped
Попередження щодо заповнювачів. R розпізнає лише NA. Набори даних часто кодують відсутні значення як порожній рядок, пробіл, «N/A», «-» або контрольне число, таке як -99 або 999. Вони непомітно проходять усі вищезазначені перевірки. Конвертуйте їх під час імпорту, щоб решта робочого процесу поводилася правильно:
df <- read.csv(PATH, na.strings = c("", " ", "NA", "N/A", "-", "-99"))
Завжди скануйте діапазон кожного числового стовпця після імпорту. Вік -99 або вартість проїзду 9999 набагато небезпечніші, ніж чесна нумерологічна анонімність (NA), оскільки жодна функція не попередить вас про це.
Типи відсутніх даних: MCAR, MAR та MNAR
Чому значення відсутнє, визначає, чи безпечне його імпутування. Статистики розпізнають три механізми.
- MCAR, зниклий зовсім випадковим чином. Ймовірність пропуску не пов'язана ні з чим, спостережуваним чи ні, наприклад, з датчиком, який виходить з ладу у випадкові моменти. Падінняping або імпутування цих рядків не вносить упередженості, лише втрату точності.
- MAR, випадково відсутній. Ймовірність залежить від інших спостережуваних змінних, але не від самого відсутнього значення. Якщо вік пасажирів старшого віку був менш ймовірним, то вік вважається MAR, враховуючи інші стовпці. Імпутація, яка використовує ці стовпці, добре з цим справляється.
- MNAR, відсутній не випадково. Ймовірність залежить від самого неспостережуваного значення, наприклад, відмова високооплачуваних осіб вказати свій дохід. Жоден метод імпутації не може вирішити це лише на основі даних, а сама відсутність містить інформацію, яку варто записати у стовпці прапорців.
Імпутація середнього значення, як вона використовується в цьому посібнику, є виправданою лише за MCAR та простим MAR. Навіть тоді вона має відому ціну: заповнення кожного пропуску однаковим числом зменшує дисперсію стовпця та послаблює його кореляцію з усім іншим. Для серйозної роботи використовуйте метод на основі моделі, такий як пакет mices, і завжди залишайте стовпець з прапорцем, який позначає, які значення були імпутовані.
мутувати()
mutate() – це dplyr дієслово, яке створює нову змінну або перезаписує існуючу, що робить його природним інструментом для створення очищеної копії стовпця.
Ми будемо продовжувати у двох частинах. Ми навчимося:
- виключити відсутні значення з кадру даних
- приписуйте відсутні значення середнім і медіаною
Дієслово mutate() дуже просте у використанні. Ми можемо створити нову змінну за таким синтаксисом:
mutate(df, name_variable_1 = condition, ...)
arguments:
-df: Data frame used to create a new variable
-name_variable_1: Name and the formula to create the new variable
-...: No limit constraint. Possibility to create more than one variable inside mutate()
Виключити відсутні значення (Н/Д)
na.omit() — це базова функція R, а не дієслово dplyr, але вона все одно чітко передає дані. Вона видаляє кожен рядок, що містить принаймні одне NA. Це найшвидший варіант і рідко буває найкращим, оскільки одне відсутнє значення відкидає все спостереження.
Щоб вирішити проблему відсутніх спостережень, ми використаємо титанічний набір даних. У цьому наборі даних ми маємо доступ до інформації про пасажирів на борту під час трагедії. Цей набір даних містить багато NA, про які потрібно подбати.
Завантажте CSV-файл з інтернету, а потім перелічіть стовпці, що містять NA:
PATH <- "https://raw.githubusercontent.com/guru99-edu/R-Programming/master/test.csv"
df_titanic <- read.csv(PATH, sep = ",")
# Return the column names containing missing observations
list_na <- colnames(df_titanic)[ apply(df_titanic, 2, anyNA) ]
list_na
вихід:
## [1] "age" "fare"
Тут,
colnames(df_titanic)[apply(df_titanic, 2, anyNA)]
повертає назви стовпців, які містять принаймні одне відсутнє значення.
У стовпцях вік і тариф відсутні значення.
Ми можемо відкинути їх за допомогою na.omit().
library(dplyr)
# Exclude the missing observations
df_titanic_drop <-df_titanic %>%
na.omit()
dim(df_titanic_drop)
вихід:
## [1] 1045 13
Новий набір даних містить 1045 рядків порівняно з 1309 у вихідному наборі даних.
Встановіть відсутні дані за допомогою середнього значення та медіани
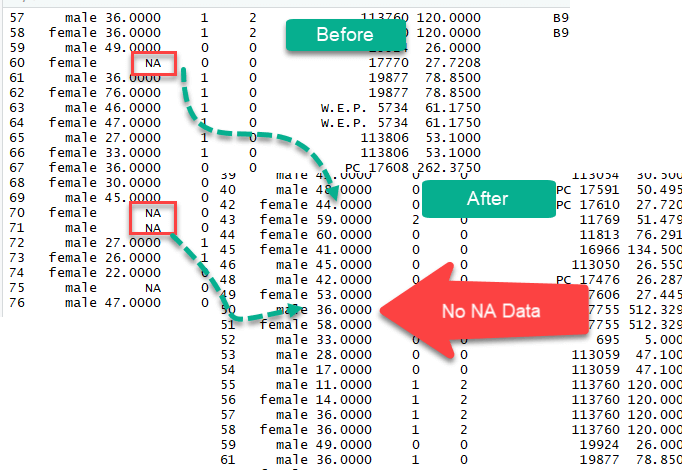
Ви також можете імпутувати, тобто заповнити відсутні значення середнім значенням або медіаною. Гарною практикою є створення двох окремих змінних для середнього значення та медіани. Після створення ми можемо замінити відсутні значення новоствореними змінними.
Ми використаємо метод apply для обчислення середнього значення стовпця з NA. Давайте розглянемо приклад
Крок 1) Раніше в підручнику ми зберігали назву стовпця з відсутніми значеннями в списку під назвою list_na. Ми будемо використовувати цей список
Крок 2) Обчисліть середнє значення з аргументом na.rm = TRUE. Цей аргумент є обов'язковим, оскільки у стовпцях відсутні дані, і це вказує R ігнорувати їх.
# Create mean
average_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      mean,
      na.rm =  TRUE)
average_missing
Code Пояснення:
Ми передаємо 4 аргументи в методі apply.
- df: df_titanic[,colnames(df_titanic) %in% list_na]. Цей код поверне назву стовпця з об’єкта list_na (тобто «вік» і «тариф»).
- 2: обчисліть функцію за стовпцями
- середнє: обчисліть середнє значення
- na.rm = TRUE: ігнорувати відсутні значення
вихід:
##      age     fare
## 29.88113 33.29548
Ми успішно створили середнє значення стовпців, які містять відсутні спостереження. Ці два значення будуть використані для заміни відсутніх спостережень.
Крок 3) Замініть значення NA
Дієслово mutate з бібліотеки dplyr корисне для створення нової змінної. Ми не обов’язково хочемо змінити вихідний стовпець, щоб створити нову змінну без NA. mutate простий у використанні, ми просто вибираємо ім’я змінної та визначаємо, як створити цю змінну. Ось повний код
# Create a new variable with the mean and median
df_titanic_replace <- df_titanic %>%
   mutate(replace_mean_age  = ifelse(is.na(age), average_missing[1], age),
   replace_mean_fare = ifelse(is.na(fare), average_missing[2], fare))
Code Пояснення:
Ми створюємо дві змінні, replace_mean_age і replace_mean_fare наступним чином:
- replace_mean_age = ifelse(is.na(age), average_missing[1], age)
- replace_mean_fare = ifelse(is.na(тариф), середній_відсутній[2],тариф)
Якщо в стовпці вік відсутні значення, замініть його першим елементом average_missing (середнє значення віку), інакше збережіть вихідні значення. Та сама логіка щодо вартості проїзду
sum(is.na(df_titanic_replace$age))
вихід:
## [1] 263
Після заміни новий стовпець взагалі не містить відсутніх значень:
sum(is.na(df_titanic_replace$replace_mean_age))
вихід:
## [1] 0
У початковому стовпці віку міститься 263 відсутні значення, тоді як у новому стовпці replace_mean_age кожне з них заповнено середнім віком.
Крок 4) Ми також можемо замінити відсутні спостереження медіаною.
median_missing <- apply(df_titanic[,colnames(df_titanic) %in% list_na],
      2,
      median,
      na.rm =  TRUE)
df_titanic_replace <- df_titanic %>%
            mutate(replace_median_age  = ifelse(is.na(age), median_missing[1], age),
            replace_median_fare = ifelse(is.na(fare), median_missing[2], fare))
head(df_titanic_replace)
вихід:

Крок 5) На великому наборі даних покроковий метод стає нудним. sapply() згортає всю процедуру в один оператор, ціною того, що імпутовані значення ніколи не бачаться.
sapply не створює a кадр даних, тож ми можемо обернути функцію sapply() у data.frame(), щоб створити об’єкт кадру даних.
# Quick code to replace missing values with the mean
df_titanic_impute_mean <- data.frame(
    sapply(
        df_titanic,
        function(x) ifelse(is.na(x),
            mean(x, na.rm = TRUE),
            x)))
Сучасна імпутація за допомогою replace_na() та across()
Підходи apply() та sapply(), описані вище, все ще працюють, але tidyr та dplyr тепер виражають ті самі операції безпечніше та зрозуміліше.
replace_na() для фіксованих значень. tidyr::replace_na() приймає іменований список стовпців та їх заміни:
library(tidyr)

df_titanic %>%
    replace_na(list(age = 29.88, fare = 33.30))
across() для кожного числового стовпця. Це пряма, типобезпечна заміна однорядкової функції sapply(), і на відміну від sapply() вона ніколи не торкається стовпців символів або факторів:
library(dplyr)

# Mean-impute every numeric column
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), mean(.x, na.rm = TRUE), .x)))

# Median-impute instead
df_titanic %>%
    mutate(across(where(is.numeric),
                  ~ ifelse(is.na(.x), median(.x, na.rm = TRUE), .x)))
⚠️ Чому скорочення sapply() є ризикованим: Однорядковий приклад sapply() виконується за кожен стовпець, включаючи символьні та факторні. Виклик mean() для цих стовпців повертає NA з попередженням, а sapply() потім перетворює весь результат на символьний. Версія across(where(is.numeric), …) вище повністю уникає цього.
coalesce() для резервних стовпців. Коли другий стовпець може надати відсутнє значення, coalesce() повертає перший невідсутній запис серед своїх аргументів:
df %>% mutate(age_final = coalesce(age, age_estimated, 0))
Записуйте, що ви змінили. Додайте прапорець перед імпутацією, щоб будь-яка пізніша модель могла навчитися з того факту, що значення було відсутнє:
df_titanic %>%
    mutate(age_was_missing = is.na(age),
           age = ifelse(is.na(age), mean(age, na.rm = TRUE), age))
Обробка відсутніх значень у R: Довідник методів
У цьому посібнику розглянуто три підходи:
- Виключіть усі відсутні спостереження
- Врахувати середнє значення
- Врахувати медіану
У таблиці нижче підсумовано виявлення та видалення:
| Library | Мета | Code |
|---|---|---|
| база | Перелічіть відсутні спостереження |
colnames(df)[apply(df, 2, anyNA)] |
| база | Видалити кожен рядок, що містить NA |
na.omit(df) |
Врахування середнього значення або медіани можна виконати двома способами
- Використання застосувати
- Використання сапплі
| Метод | Деталі | Переваги | Недоліки |
|---|---|---|---|
| Крок за кроком із застосуванням | Перевірити стовпці з відсутніми, обчислити середнє/медіану, зберегти значення, замінити на mutate() | Ви можете побачити імпутоване середнє значення або медіану | Більший час виконання. Може бути повільним із великим набором даних |
| Швидкий спосіб із застосуванням | Використовуйте sapply() і data.frame() для автоматичного пошуку та заміни відсутніх значень на середнє/медіане | Короткий код і швидко | Імпутовані значення ніколи не відображаються |
