
K-означає ClusterПрограмування на R з прикладом
 Евелін Кларк
⚡ Розумний підсумок
K-засоби ClusterВ R групуються спостереження шляхом мінімізації відстані між кожною точкою та її центроїдом кластера. Цей покроковий посібник стандартизує набір даних computer-prices, анімує алгоритм, знаходить оптимальне k за допомогою методу ліктя та зчитує кластери за допомогою теплової карти.

Що таке Cluster аналіз?
Cluster аналіз належить непідконтрольне навчання. Кластер — це група даних, які мають схожі характеристики. Можна сказати, що кластерний аналіз – це більше відкриття, ніж прогноз. Машина шукає подібність даних. Наприклад, ви можете використовувати кластерний аналіз для такої програми:
- Сегментація клієнтів: пошук подібності між групами клієнтів
- Кластеризація фондового ринку: групування акцій на основі продуктивності
- Зменшення розмірності набору даних за допомогою групиping спостереження з подібними значеннями
Clusterаналіз не надто складний у реалізації, він є значущим і дієвим для бізнесу.
Найразючіша відмінність між навчанням під контролем і без нього полягає в результатах. Неконтрольоване навчання створює нову змінну, мітку, тоді як контрольоване навчання передбачає результат. Машина допомагає практикуючому в пошуках міток даних на основі тісного зв’язку. Використовувати групи та давати їм назву залежить від аналітика.
Давайте наведемо приклад, щоб зрозуміти концепцію кластеризації. Для простоти ми працюємо у двох вимірах. У вас є дані про загальні витрати клієнтів і їхній вік. Щоб покращити рекламу, маркетингова команда хоче надсилати своїм клієнтам більш цілеспрямовані електронні листи.
На наступному графіку ви відобразите загальні витрати та вік клієнтів.
library(ggplot2)
df <- data.frame(age = c(18, 21, 22, 24, 26, 26, 27, 30, 31, 35, 39, 40, 41, 42, 44, 46, 47, 48, 49, 54),
    spend = c(10, 11, 22, 15, 12, 13, 14, 33, 39, 37, 44, 27, 29, 20, 28, 21, 30, 31, 23, 24)
)
ggplot(df, aes(x = age, y = spend)) +
    geom_point()

У цьому місці видно візерунок
- У нижньому лівому куті ви можете побачити молодих людей із нижчою купівельною спроможністю
- Вище середнього означає людей, які мають роботу, на яку вони можуть дозволити витратити більше
- Нарешті, літні люди з меншим бюджетом.

На малюнку вище ви групуєте спостереження вручну та визначаєте кожну з трьох груп. Цей приклад дещо простий і дуже наочний. Якщо до набору даних додаються нові спостереження, ви можете позначити їх у кружечках. Ви визначаєте коло на основі нашого судження. Замість цього можна використовувати машинне навчання об’єктивно групувати дані.
У цьому посібнику ви дізнаєтеся, як використовувати k-означає алгоритм.
Алгоритм K-середніх
K-середні – це найпоширеніший метод кластеризації. Алгоритм бере свій початок у 1950-х роках і з того часу багато разів удосконалювався.
Алгоритм намагається знайти групи шляхом мінімізації відстані між спостереженнями, що називається локальний оптимальний рішення. Відстані вимірюються на основі координат спостережень. Наприклад, у двовимірному просторі координати – це просто x та y.
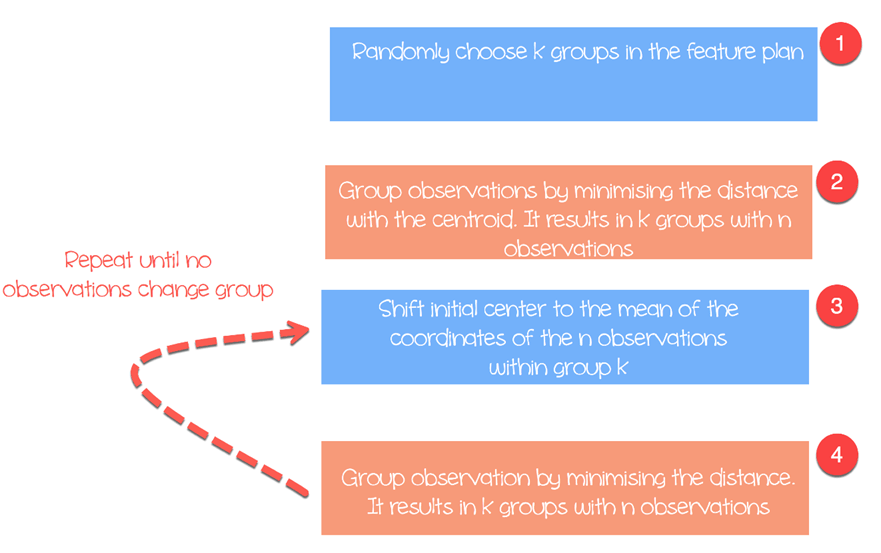
Алгоритм роботи наступний:
- Крок 1: Випадковим чином вибрати k початкових центроїдів у просторі ознак
- Крок 2: Призначте кожне спостереження найближчому центру кластера, центроїдЦе створює k груп
- Крок 3: Shift початковий центроїд до середнього значення координат у групі.
- Крок 4: Мінімізуйте відстань відповідно до нових центроїдів. Створюються нові межі. Таким чином, спостереження будуть переходити від однієї групи до іншої
- Повторюйте, доки жодне спостереження не змінить групи
K-середні зазвичай вимірюють евклідову відстань між двома спостереженнями x та y:

Доступні й інші вимірювання, такі як відстань Манхеттена або Мінковського. Зауважте, що K-середнє повертає різні групи щоразу, коли ви запускаєте алгоритм. Нагадаємо, що перші початкові припущення є випадковими, і обчислюйте відстані, доки алгоритм не досягне однорідності всередині груп. Тобто, k-середнє дуже чутливе до першого вибору, і якщо кількість спостережень і груп не мала, майже неможливо отримати однакову кластеризацію.
Вибір кількості кластерів
Ще однією складністю, що виникає з k-середнім, є вибір кількості кластерів. Ви можете встановити високе значення k, тобто велику кількість груп, щоб покращити однорідність всередині групи, але ви ризикуєте переобладнання дані. Надмірне налаштування означає, що продуктивність різко падає на нових даних, оскільки модель запам'ятала шум у цьому конкретному зразку, а не основний патерн.
Кількість кластерів залежить від характеру набору даних, галузі, бізнесу тощо. Однак існує емпіричне правило вибору відповідної кількості кластерів:

де n – кількість спостережень у наборі даних.
На практиці варто витратити час на пошук значення k, яке найкраще відповідає потребам бізнесу.
Ми будемо використовувати набір даних Prices of Personal Computers для виконання аналізу кластеризації. Цей набір даних містить 6259 спостережень і 10 ознак. Набір даних враховує ціни з 1993 по 1995 роки 486 персональних комп'ютерів у США. Серед змінних – це ціна, швидкість, оперативна пам’ять, екран, компакт-диск.
Ви будете діяти наступним чином:
- Дати імпорту
- Тренуйте модель
- Оцініть модель
Дати імпорту
K-середні не підходять для факторних змінних, оскільки вони працюють з відстанями, а дискретні мітки не мають значущої відстані між собою. Видаліть три категоріальні стовпці (cd, multi, premium) разом з індексом рядка X. Цей набір даних не містить пропущених значень.
library(dplyr)
PATH <-"https://raw.githubusercontent.com/guru99-edu/R-Programming/master/computers.csv"
df <- read.csv(PATH) %>%
select(-c(X, cd, multi, premium))
glimpse(df)
Вихід
## Observations: 6,259
## Variables: 7
## $ price <int> 1499, 1795, 1595, 1849, 3295, 3695, 1720, 1995, 2225, 2...
## $ speed <int> 25, 33, 25, 25, 33, 66, 25, 50, 50, 50, 33, 66, 50, 25, ...
## $ hd <int> 80, 85, 170, 170, 340, 340, 170, 85, 210, 210, 170, 210...
## $ ram <int> 4, 2, 4, 8, 16, 16, 4, 2, 8, 4, 8, 8, 4, 8, 8, 4, 2, 4, ...
## $ screen <int> 14, 14, 15, 14, 14, 14, 14, 14, 14, 15, 15, 14, 14, 14, ...
## $ ads <int> 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, ...
## $ trend  <int> 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1...
Зі зведеної статистики видно, що дані мають великі значення. Гарною практикою перед будь-яким методом на основі відстані є стандартизація даних, щоб кожна змінна мала середнє значення нуля та стандартне відхилення одиниціБез нього ціна, значення якої обчислюються тисячами, домінувала б у розрахунку відстані, а розмір екрана майже нічого не враховував би.
summary(df)
вихід:
##      price          speed              hd              ram
##  Min.   : 949   Min.   : 25.00   Min.   :  80.0   Min.   : 2.000
##  1st Qu.:1794   1st Qu.: 33.00   1st Qu.: 214.0   1st Qu.: 4.000
##  Median :2144   Median : 50.00   Median : 340.0   Median : 8.000
##  Mean   :2220   Mean   : 52.01   Mean   : 416.6   Mean   : 8.287
##  3rd Qu.:2595   3rd Qu.: 66.00   3rd Qu.: 528.0   3rd Qu.: 8.000
##  Max.   :5399   Max.   :100.00   Max.   :2100.0   Max.   :32.000
##      screen           ads            trend
##  Min.   :14.00   Min.   : 39.0   Min.   : 1.00
##  1st Qu.:14.00   1st Qu.:162.5   1st Qu.:10.00
##  Median :14.00   Median :246.0   Median :16.00
##  Mean   :14.61   Mean   :221.3   Mean   :15.93
##  3rd Qu.:15.00   3rd Qu.:275.0   3rd Qu.:21.50
##  Max.   :17.00   Max.   :339.0   Max.   :35.00
Ви масштабуєте змінні за допомогою функції scale() бібліотеки dplyr. Трансформація зменшує вплив викидів і дозволяє порівнювати окреме спостереження із середнім. Якщо стандартизоване значення (або z-оцінка) є високим, ви можете бути впевнені, що це спостереження справді перевищує середнє значення (великий z-показник означає, що ця точка далека від середнього значення за стандартним відхиленням. Z-показник, що дорівнює два, означає, що значення є стандартним 2 відхилення від середнього. Зауважте, що z-показник відповідає розподілу Гауса та є симетричним відносно середнього.
# Note: speed is deliberately left out of the scaled data frame
rescale_df <- df %>%
    mutate(price_scal = scale(price),
    hd_scal = scale(hd),
    ram_scal = scale(ram),
    screen_scal = scale(screen),
    ads_scal = scale(ads),
    trend_scal = scale(trend)) %>%
select(-c(price, speed, hd, ram, screen, ads, trend))
R base має функцію для запуску алгоритму k середнього. Основна функція k mean:
kmeans(df, k)
arguments:
-df: dataset used to run the algorithm
-k: Number of clusters
Тренуйте модель
На рисунку три ви детально описали, як працює алгоритм. Ви можете спостерігати за кожним кроком графічно за допомогою пакета анімації, написаного Іхуей Сє, який також створив knitr для R Markdown. Пакет не знаходиться в каналах conda, тому встановіть його з CRAN:
install.packages("animation")
Після завантаження бібліотеки ви додаєте .ani після kmeans і R накреслить усі кроки. Для ілюстрації, ви виконуєте лише алгоритм із перемасштабованими змінними hd і ram із трьома кластерами.
set.seed(2345)
library(animation)
kmeans.ani(rescale_df[2:3], 3)
Code Пояснення
- kmeans.ani(rescale_df[2:3], 3): виберіть стовпці 2 і 3 набору даних rescale_df і запустіть алгоритм із значеннями k 3. Побудуйте анімацію.


Ви можете інтерпретувати анімацію наступним чином:
- Крок 1: R навмання обирає три точки
- Крок 2: обчисліть евклідову відстань і намалюйте кластери. У вас є один кластер зеленого кольору внизу ліворуч, один великий кластер чорного кольору праворуч і червоний кластер між ними.
- Крок 3: Обчисліть центроїд, тобто середнє значення кластерів
- Повторюйте, доки дані не змінять кластер
Алгоритм сходився після семи ітерацій. Ви можете запустити алгоритм k-середнього в нашому наборі даних із п’ятьма кластерами та назвати його pc_cluster.
pc_cluster <-kmeans(rescale_df, 5)
Список pc_cluster містить сім корисних елементів:
- pc_cluster$cluster: Кластер, призначений кожному спостереженню
- pc_cluster$centers: центри кластерів
- pc_cluster$totss: загальна сума квадратів
- pc_cluster$withinss: В межах суми квадратів, одне значення на кластер
- pc_cluster$tot.withinss: Сума wininss
- pc_cluster$betweenss: Загальна сума квадратів мінус внутрішня сума квадратів
- pc_cluster$size: кількість спостережень у кожному кластері
Ви будете використовувати суму внутрішньої суми квадратів (тобто tot.withinss), щоб обчислити оптимальну кількість кластерів k. Знаходження k справді є серйозним завданням.
Як знайти оптимальне k за допомогою методу ліктя
Один із методів вибору найкращого k називається ліктьовий метод. Цей метод використовує однорідність усередині групи або неоднорідність усередині групи для оцінки мінливості. Іншими словами, вас цікавить відсоток дисперсії, пояснений кожним кластером. Ви можете очікувати, що мінливість збільшиться зі збільшенням кількості кластерів, інакше гетерогенність зменшиться. Наше завдання полягає в тому, щоб знайти k, яке перевищує спадну віддачу. Додавання нового кластера не покращує мінливість даних, оскільки залишається дуже мало інформації для пояснення.
У цьому посібнику ми знаходимо цю точку за допомогою міри неоднорідності. Загальна сума квадратів у межах кластерів є tot.withinss у списку, який повертає kmean().
Ви можете побудувати ліктьовий графік і знайти оптимальне k таким чином:
- Крок 1: Створіть функцію для обчислення загальної суми квадратів у кластерах
- Крок 2: Запустіть алгоритм для діапазону значень k
- Крок 3: Створіть фрейм даних із результатами алгоритму
- Крок 4: Побудуйте результати
Крок 1) Побудуйте функцію для обчислення загальної суми квадратів у кластерах
Ви створюєте функцію, яка запускає алгоритм k-середніх і зберігає загальну суму квадратів у кластерах
kmean_withinss <- function(k) {
    cluster <- kmeans(rescale_df, k)
    return (cluster$tot.withinss)
}
Code Пояснення
- function(k): Установіть кількість аргументів у функції
- kmeans(rescale_df, k): Запустити алгоритм для цього значення k
- return(cluster$tot.withinss): зберігати загальну суму квадратів у кластерах
Перевірте функцію з k, що дорівнює 2.
вихід:
## Try with 2 cluster
kmean_withinss(2)
вихід:
## [1] 27087.07
Крок 2) Виконайте алгоритм n разів
Ви будете використовувати функцію sapply(), щоб запустити алгоритм у діапазоні k. Ця техніка швидша, ніж створення циклу та збереження значення.
# Set maximum cluster
max_k <-20
# Run algorithm over a range of k
wss <- sapply(2:max_k, kmean_withinss)
Code Пояснення
- max_k <- 20: Встановити максимальне значення k на 20
- sapply(2:max_k, kmean_withinss): запустіть функцію kmean_withinss() у діапазоні 2:max_k, тобто від 2 до 20.
Крок 3) Створіть кадр даних із результатами алгоритму
Після написання та тестування функції, запустіть її в діапазоні від 2 до 20 та збережіть кожне значення tot.withinss.
# Create a data frame to plot the graph
elbow <-data.frame(2:max_k, wss)
Code Пояснення
- data.frame(2:max_k, wss): Створення кадру даних із виходом алгоритму, що зберігається в wss
Крок 4) Побудуйте результати
Ви будуєте графік, щоб візуалізувати, де знаходиться точка ліктя
# Plot the graph with gglop
ggplot(elbow, aes(x = X2.max_k, y = wss)) +
    geom_point() +
    geom_line() +
    scale_x_continuous(breaks = seq(1, 20, by = 1))

На графіку можна побачити оптимальне k дорівнює семи, де крива починає мати спадну віддачу.
Отримавши наше оптимальне k, ви повторно запускаєте алгоритм, коли k дорівнює 7, і оцінюєте кластери.
Вивчення кластерів
pc_cluster_2 <-kmeans(rescale_df, 7)
Як згадувалося раніше, ви можете отримати доступ до решти цікавої інформації зі списку, який повертає kmean().
pc_cluster_2$cluster
pc_cluster_2$centers
pc_cluster_2$size
Оцінювання є суб'єктивним і залежить від того, для чого призначені кластери. Мета полягає в тому, щоб згрупувати комп'ютери зі схожими характеристиками. Експерт у предметній області міг би зробити це вручну, але процес був би повільним і схильним до помилок. K-means виконує групування.ping об'єктивно та залишає експерту інтерпретувати та називати результат.
Для попередньої оцінки ви можете перевірити розмір кластерів.
pc_cluster_2$size
вихід:
## [1] 608 1596 1231 580 1003 699 542
Найбільший кластер, номер 2, містить 1,596 спостережень, тоді як найменший, номер 7, містить лише 542 комп'ютери. Можливо, було б добре забезпечити однорідність між кластерами, якщо ні, може знадобитися менш ретельна підготовка даних.
Центральний компонент дає змогу глибше розглянути дані. Рядки позначають нумерацію кластера, а стовпці – змінні, що використовуються алгоритмом. Значення – це середній бал кожного кластера для цікавого стовпця. Стандартизація спрощує інтерпретацію. Додатні значення вказують на те, що z-показник для даного кластера перевищує загальне середнє значення. Наприклад, кластер 4 має найвищу середню ціну (price_scal = 1.09), тоді як кластер 5 має найнижчу (-0.82).
center <-pc_cluster_2$centers
center
вихід:
##   price_scal    hd_scal     ram_scal screen_scal   ads_scal trend_scal
## 1 -0.6372457 -0.7097995 -0.691520682  -0.4401632  0.6780366 -0.3379751
## 2 -0.1323863  0.6299541  0.004786730   2.6419582 -0.8894946  1.2673184
## 3  0.8745816  0.2574164  0.513105797  -0.2003237  0.6734261 -0.3300536
## 4  1.0912296 -0.2401936  0.006526723   2.6419582  0.4704301 -0.4132057
## 5 -0.8155183  0.2814882 -0.307621003  -0.3205176 -0.9052979  1.2177279
## 6  0.8830191  2.1019454  2.168706085   0.4492922 -0.9035248  1.2069855
## 7  0.2215678 -0.7132577 -0.318050275  -0.3878782 -1.3206229 -1.5490909
Ви можете створити теплову карту за допомогою ggplot, щоб допомогти нам підкреслити різницю між категоріями.
Стандартні кольори ggplot потрібно змінити за допомогою бібліотеки RColorBrewer. Ви можете використовувати conda бібліотека і код для запуску в терміналі:
conda install -c r r-rcolorbrewer
Щоб створити теплову карту, виконайте три кроки:
- Побудуйте фрейм даних із значеннями центру та створіть змінну з номером кластера
- Змініть форму даних за допомогою функції gather() бібліотеки tidyr. Ви хочете перетворити дані з широких на довгі.
- Створіть палітру кольорів за допомогою кольоруRampФункція Palette().
Крок 1) Побудуйте фрейм даних
Давайте створимо набір даних зміни форми
library(tidyr)

# create dataset with the cluster number

cluster <- c(1: 7)
center_df <- data.frame(cluster, center)

# Reshape the data

center_reshape <- gather(center_df, features, values, price_scal: trend_scal)
head(center_reshape)
вихід:
##   cluster   features     values
## 1       1 price_scal -0.6372457
## 2       2 price_scal -0.1323863
## 3       3 price_scal  0.8745816
## 4       4 price_scal  1.0912296
## 5       5 price_scal -0.8155183
## 6       6 price_scal  0.8830191
Крок 2) Створіть кольорову палітру
Наведений нижче код створює палітру кольорів, що використовуються тепловою картою.
library(RColorBrewer)
# Create the palette
hm.palette <-colorRampPalette(rev(brewer.pal(10, 'RdYlGn')),space='Lab')
Крок 3) Візуалізуйте
Ви можете побудувати графік і побачити, як виглядають кластери.
# Plot the heat map
ggplot(data = center_reshape, aes(x = features, y = cluster, fill = values)) +
    scale_y_continuous(breaks = seq(1, 7, by = 1)) +
    geom_tile() +
    coord_equal() +
    scale_fill_gradientn(colours = hm.palette(90)) +
    theme_classic()

Як отримати відтворювані результати K-середніх за допомогою set.seed() та nstart
У посібнику зазначається, що k-середніх повертає різні групи під час кожного запуску. Це не примха, це проблема з двома стандартними виправленнями, і жодне з них не використовується у наведених вище прикладах.
1. Зафіксуйте початкову точку за допомогою set.seed(). Початкові центроїди вибираються випадковим чином, тому один і той самий виклик щоразу створює різні кластери. Встановлення початкового значення робить весь аналіз відтворюваним:
set.seed(123)
pc_cluster_2 <- kmeans(rescale_df, 7)
2. Виконайте кілька запусків і збережіть найкращий результат за допомогою nstart. Один випадковий запуск може сходитися до поганого локального оптимуму. Аргумент nstart запускає алгоритм багато разів з різних випадкових запусків і повертає той, що має найменшу суму в межах суми квадратів:
set.seed(123)
pc_cluster_2 <- kmeans(rescale_df, centers = 7, nstart = 25)
Двадцять п'ять запусків – це звичайна рекомендація, яка коштує дуже мало на наборі даних такого розміру. Без неї сама крива ліктя стає нестабільною, оскільки кожна точка на графіку походить від одного невдалого або вдалого початку. Тому функцію kmean_withinss(), визначену раніше, слід записати так:
kmean_withinss <- function(k) {
    cluster <- kmeans(rescale_df, centers = k, nstart = 25)
    return (cluster$tot.withinss)
}
3. Підвищте значення iter.max, якщо алгоритм видає попередження. Якщо R повідомляє «не зійшовся за 10 ітерацій», передайте iter.max = 50, щоб надати йому більше місця.
K-середніх проти ієрархічних Clusterв R
K-середні – не єдиний доступний метод кластеризації, і вибір зазвичай зводиться до розміру даних та того, чи знаєте ви вже, скільки груп вам потрібно.
| Критерії | K-засоби | Ієрархічна |
|---|---|---|
| Кількість кластерів | Потрібно вибрати заздалегідь | Вибрано після, шляхом розрізання дендрограми |
| Стабільність результатів | Змінюється залежно від випадкового початку | Детермінований |
| масштабованість | Обробляє дуже великі набори даних | Проблеми з виконанням понад кілька тисяч рядків |
| Cluster формувати | Припускає приблизно сферичні групи подібного розміру | Більш гнучкий |
| Вихід | Плоский набір етикеток | Дендрограма, що показує вкладену структуру |
| функція R | kmeans(df, k) | hclust(dist(df)) |
# Hierarchical alternative on the same scaled data
hc <- hclust(dist(rescale_df), method = "ward.D2")
plot(hc)
groups <- cutree(hc, k = 7)
З 6,259 спостереженнями, ієрархічна кластеризація має побудувати матрицю відстаней приблизно з 19.6 мільйона пар, тому k-середніх є практичним вибором для цього набору даних. Зауважте також, що k-середніх припускає кластери подібного розміру та приблизно сферичної форми; якщо це припущення не спрацьовує, DBSCAN обробляє неправильні форми та ідентифікує викиди, замість того, щоб примусово об'єднувати кожну точку в групу.
K-засоби Clusterінг у R: Довідник функцій
Кожна функція, що використовується в цьому посібнику, перелічена нижче:
| пакет | Мета | функція | аргументація |
|---|---|---|---|
| база | Тренувати k-середнє | kmeans() | df, k |
| Кластер доступу | kmeans()$cluster | ||
| Cluster центри | kmeans()$centers | ||
| Cluster розміри | kmeans()$size | ||
| Сума в межах суми квадратів | kmeans()$tot.withinss | Використовується методом ліктя | |
| Між сумою квадратів | kmeans()$betweens | ||
| база | Відтворюваний пробіг | set.seed() | насіннєва цінність |
| база | Стабілізувати результат | kmeans(df, k, nstart = 25) | нстарт |
