
Що таке Data Mart у Data Warehouse? Типи та приклад
 Девід Картер
⚡ Розумний підсумок
Проектування сховищ даних надає одному відділу цільову підмножину інформації зі сховища даних, охоплюючи три типи сховищ даних, п'ять фаз від проектування до управління та найкращі практики, що забезпечують швидку, безпечну та економічно ефективну доставку.
Вітрина даних надає аналітичну силу сховище даних для однієї команди. Зосереджуючись на одній предметній області, це дозволяє відділу швидко аналізувати власні дані, не чекаючи на виконання робочих навантажень усього підприємства. У розділах нижче пояснюється, що таке сховище даних, чому організації його використовують, три доступні типи, а також як його впровадити та керувати ним.
Що таке Data Mart?
Вітрина даних зосереджена на одній функціональній області організації та містить підмножину даних, що зберігаються в Інформаційне сховищеЦе скорочена версія сховища даних, призначена для використання певним відділом, підрозділом або групою користувачів, наприклад, відділом маркетингу, продажів, кадрів або фінансів.
Оскільки сховище даних виконує одну функцію, воно зазвичай контролюється одним відділом в організації. Такий фокус дозволяє вузько визначити його сферу діяльності та чітко визначити його власника.
Сховища даних також отримують дані лише з кількох джерел, на відміну від сховища даних, яке інтегрує багато. Як результат, сховища даних мають невеликий розмір і набагато гнучкіші, ніж повноцінне сховище даних.
Навіщо нам Data Mart?
Організації покладаються на сховища даних з кількох практичних причин:
- Вітрина даних покращує час відгуку користувачів, зменшуючи обсяг даних, які вони запитують.
- Він забезпечує легкий доступ до часто запитуваних даних.
- Впровадження вітрина даних простіша та дешевша, ніж корпоративне сховище даних.
- Це гнучко: коли модель змінюється, менший кіоск даних можна швидко перебудувати.
- Сховище даних визначається одним експертом у предметній області, тоді як сховище даних визначається міждисциплінарною командою, тому сховище даних більш відкрите до змін.
- Дані розділені, що дозволяє дуже детально контролювати привілеї доступу.
- Дані можна сегментувати та зберігати на різних апаратних або програмних платформах.
Коротше кажучи, оскільки сховище даних обробляє менший, чітко визначений фрагмент даних, його швидше створити, дешевше експлуатувати та легше захистити, ніж корпоративне сховище даних.
Однак, не всі сховища даних побудовані однаково. Джерело, з якого береться сховище даних, визначає, з яким із трьох типів ви працюєте.
Типи Data Mart
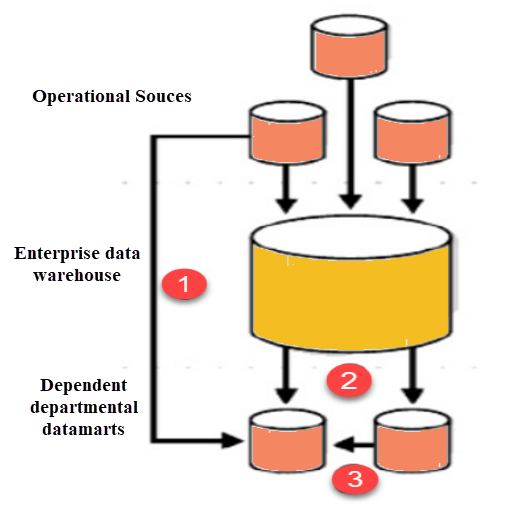
Існує три основні типи вітрин даних, які відрізняються за джерелом отримання даних:
- Залежно: Залежні сховища даних отримують дані безпосередньо з операційних джерел, зовнішніх джерел або з обох.
- Незалежний: Незалежний кіоск даних створюється без центрального сховища даних.
- Гібрид: Гібридний дата-март може отримувати дані зі сховищ даних або операційних систем.
Залежна база даних
Залежний сховище даних отримує дані організації з одного сховища даних, що надає йому перевагу централізації. Якщо вам потрібно створити один або кілька фізичних сховищ даних, ви налаштовуєте їх як залежні сховища даних.
Залежну сховище даних можна побудувати двома способами: один, коли користувачі отримують доступ як до сховища даних, так і до сховища даних залежно від потреби, і інший, коли доступ обмежений лише до сховища даних. Другий підхід не є оптимальним, оскільки він може призвести до «сховища даних» — даних, які починаються зі спільного джерела, але потім викидаються та значною мірою не використовуються.

Незалежний ринок даних
Незалежний дата-март створюється без центрального сховища даних. Такий тип дата-марту є ідеальним варіантом для невеликих груп в організації.
Незалежний сховище даних не має жодного зв'язку з корпоративним сховищем даних чи будь-яким іншим сховищем даних. Його дані завантажуються та аналізуються самостійно. Такий підхід суперечить основній причині створення сховища даних: узгодженому, централізованому сховищу корпоративних даних, яке можуть аналізувати багато користувачів з різними інтересами.

Hybrid Data Mart
Гібридний сховище даних поєднує вхідні дані з джерел поза межами сховища даних. Це допомагає, коли потрібна спеціальна інтеграція, наприклад, після додавання нової групи або продукту до організації.
Він добре підходить для середовищ з кількома базами даних і пропонує швидке впровадження з мінімальними зусиллями на очищення даних. Гібридний дата-март також підтримує великі структури сховищ і добре працює для менших, орієнтованих на дані програм.
Етапи впровадження Datamart

Впровадження сховища даних – це корисний, але детальний процес. Він проходить п’ять фаз: проектування, створення, заповнення, доступ та управління, кожен з яких описано нижче.
Проектування
Проектування – це перший етап впровадження сховища даних. Воно охоплює кожне завдання, від початкового запиту на сховище даних до збору вимог, і завершується логічним та фізичним проектуванням сховища даних.
Етап проектування включає наступні завдання:
- Збір бізнес-вимог та технічних вимог і визначення джерел даних.
- Вибір відповідної підмножини даних.
- Проектування логічної та фізичної структури вітрини даних.
Дані можна розділити на основі таких критеріїв:
- Дата
- Бізнес-одиниця або функціональна одиниця
- Географія
- Будь-яка комбінація вищезазначеного
Дані можна розділити на рівні програми або СУБД, хоча розділення на рівні програми рекомендується, оскільки це дозволяє використовувати різну модель даних щороку, враховуючи зміни бізнес-середовища. Більшість вітрин даних побудовані на... розмірна модель, наприклад, зіркоподібну схему, для забезпечення швидкості запитів.
Які продукти та технології вам потрібні?
На цьому етапі буде достатньо простої ручки та паперу. Інструменти, які допомагають створювати UML або діаграми «сутність-зв’язок», також можуть додавати метадані до ваших логічних та фізичних проектів.
Будівництво
Конструювання – це другий етап впровадження. Він включає створення фізичної бази даних та логічних структур.
Цей крок включає наступне завдання:
- Реалізація фізичної бази даних, розробленої на попередньому етапі, наприклад, створення об'єктів схеми, таких як таблиці, індекси та представлення.
Які продукти та технології вам потрібні?
Для створення сховища даних вам потрібна реляційна система керування базами даних (РСБД). РСБД надає кілька функцій, необхідних для успіху сховища даних:
- Керування сховищем: РСУБД зберігає та керує даними, дозволяючи створювати, додавати та видаляти записи.
- Швидкий доступ до даних: За допомогою SQL-запиту ви можете легко отримати дані на основі певних умов або фільтрів.
- Захист даних: СУБД може відновлюватися після системних збоїв, таких як відключення живлення, та відновлювати дані з резервних копій, якщо диск виходить з ладу.
- Багатокористувацька підтримка: Він пропонує одночасний доступ, тому кілька користувачів можуть читати та змінювати дані, не перезаписуючи зміни один одного.
- Безпека: Він регулює, які користувачі мають доступ до яких об'єктів та які операції вони можуть виконувати.
Заселення
На третьому етапі дані заповнюються в сховище даних.
Етап заповнення включає наступні завдання:
- картаping вихідних даних до цільових даних.
- Extracперевірка вихідних даних.
- Очищення та перетворення даних.
- Завантаження даних у сховище даних.
- Створення та зберігання метаданих.
Які продукти та технології вам потрібні?
Ви виконуєте ці завдання за допомогою ETL (наприклад,tract, перетворення, завантаження). Він перевіряє джерела даних, виконує зіставлення джерела з цільовим об'єктомping, а потім extracts, перетворює, очищує та завантажує дані до сховища даних.
Під час обробки інструмент також створює метадані — такі деталі, як походження даних, їх актуальність, внесені зміни та застосований рівень узагальнення.
Доступ до
Доступ – це четвертий крок, який передбачає використання даних: запити до даних, створення звітів і діаграм, а також їх публікація. Кінцеві користувачі надсилають запити та переглядають результати, часто через OLAP інструментів.
Етап доступу включає такі завдання:
- Налаштування меташару, який перетворює структури бази даних та назви об'єктів у бізнес-терміни, щоб користувачі без технічних знань могли легко отримати доступ до сховища даних.
- Налаштування та підтримка структур баз даних.
- Налаштування API та інтерфейсів, якщо потрібно.
Які продукти та технології вам потрібні?
Ви можете отримати доступ до сховища даних за допомогою командного рядка або графічного інтерфейсу. Графічний інтерфейс зазвичай є кращим, оскільки він легко генерує графіки та є зручнішим для користувача, ніж командний рядок.
управління
Керування – це завершальний етап процесу впровадження сховища даних. Використовуючи графічний інтерфейс або командний рядок, команди виконують поточні завдання управління, такі як:
- Постійне керування доступом користувачів.
- Оптимізація та точне налаштування системи для кращої продуктивності.
- Додавання та керування новими даними в сховищі даних.
- Планування сценаріїв відновлення для збереження доступності системи у разі її збою.
- Відновлення після збоїв апаратного та програмного забезпечення зі збереженням даних.
Найкращі практики для впровадження вітрин даних
Дотримуйтесь цих найкращих практик протягом усього процесу впровадження кіоску даних:
- Структуруйте джерело сховища даних за відділами.
- Вимірюйте цикл впровадження тижнями, а не місяцями чи роками.
- Залучайте всіх зацікавлених сторін до етапу планування та проектування, оскільки впровадження сховища даних може бути складним.
- Точно сплануйте бюджет на обладнання, програмне забезпечення, мережу та впровадження сховища даних.
- Навіть коли сховище даних використовує спільне обладнання, йому може знадобитися різне програмне забезпечення для обробки запитів користувачів; оцініть додаткову обчислювальну потужність та обсяг пам’яті, необхідні для швидкого реагування.
- Коли сховище даних знаходиться в іншому місці, ніж сховище даних, забезпечте достатню пропускну здатність мережі для переміщення необхідних обсягів даних.
- Бюджет на час завантаження, який зростає зі збільшенням складності перетворень.
Переваги та недоліки Data Mart
Як і будь-який вибір архітектури, сховище даних має очевидні переваги, але водночас має й деякі недоліки.
Переваги
- Вітрина даних містить підмножину даних усієї організації, які є цінними для певної групи користувачів.
- Це економічно ефективна альтернатива сховищу даних, створення якого може бути дорогим.
- Вітрина даних забезпечує швидший доступ до даних.
- Він простий у використанні, оскільки розроблений з урахуванням конкретних потреб своїх користувачів, що може пришвидшити бізнес-процеси.
- Вітрина даних потребує менше часу на впровадження, ніж сховище даних, оскільки ви зосереджуєтеся лише на підмножині даних.
- Він містить історичні дані, які допомагають аналітикам виявляти тенденції.
Недоліки
- Іноді підприємства створюють занадто багато розрізнених, непов'язаних між собою сховищ даних, які стає важко підтримувати.
- Сховище даних не може забезпечити аналіз даних усієї компанії, оскільки його набір даних обмежений.
