
PyTorch Örneklerle Aktarım Öğrenme Eğitimi
 Editoryal Takım
⚡ Akıllı Özet
Transfer öğrenme, büyük bir veri kümesi üzerinde önceden eğitilmiş bir ağı yeniden kullanarak, yeni ve ilgili bir görevin çok daha az etiketli görüntü ve orijinal eğitim süresinin çok daha kısa bir bölümüyle çözülmesini sağlar.
Transfer Öğrenme Nedir?
Transfer Öğrenimi Eğitilmiş bir modeli kullanarak ilgili başka bir görevi çözme tekniğidir. Makine öğrenmesi Belirli bir problemi çözerken edinilen bilgiyi depolayan ve aynı bilgiyi farklı ancak ilgili başka bir problemi çözmek için kullanan bir araştırma yöntemidir. Bu, daha önce öğrenilen görevden toplanan bilgilerin yeniden kullanılmasıyla verimliliği artırır.
Bir ağın sıfırdan eğitilmesi çok büyük miktarda veri gerektirdiğinden, başka bir ağ modelinin ağırlıklarını yeniden kullanmak yaygındır. Eğitim süresini azaltmak için, mevcut bir ağı ve ağırlıklarını alıp son katmanı kendi probleminizi çözecek şekilde değiştirirsiniz. Avantajı, bu son katmanın küçük bir veri kümesiyle eğitilebilmesidir.
Herhangi bir Py yazmadan önceTorKod, probleminizin Transfer Öğrenme ailesine ait olduğunu bilmenize yardımcı olur, çünkü bu, ne kadar etiketli veriye ihtiyacınız olduğunu belirler.
Transfer Öğrenme Türleri
Araştırma literatürü bu tekniği üç gruba ayırıyor. Hangi grubun size uygun olduğu, kullandığınız çerçeveye değil, sorunun hangi tarafının etiketlendiğine bağlıdır.
| Menşei | Kaynak etki alanı | Target domain | Tipik kullanım |
|---|---|---|---|
| tümevarımsal | Etiketli | Etiketlendi, ama farklı bir görev | Bir ImageNet omurgasını iki sınıflı Alien vs. Predator problemine yeniden yönlendirmek |
| Transdüktif | Etiketli | Etiketlenmemiş, aynı görev, farklı veri dağılımı | Alan uyarlaması, örneğin bir modelin stüdyo fotoğraflarından telefon fotoğraflarına taşınması gibi. |
| denetimsiz | Etiketsiz | Etiketsiz | ClusterHer kaydı etiketlemenin pratik olmadığı durumlarda etiketleme veya boyut indirgeme işlemleri. |
Bu eğitimde oluşturulan örnek, tümevarımsal transfer öğrenmesidir. VGG19, etiketlenmiş ImageNet bilgisiyle birlikte gelir ve daha önce hiç karşılaşmadığı etiketlenmiş iki sınıflı bir probleme yönlendirilir.
Özellik Extraction vs Fine-Tuning
Önceden eğitilmiş bir ağ seçildikten sonra, onu uyarlamanın iki yolu vardır. Aradaki fark, öğrenmeye devam etmesine izin verdiğiniz katman sayısındadır.
| Görünüş | Özellik örneğitracyon | İnce ayar |
|---|---|---|
| Eğitim veren katmanlar | Yalnızca değiştirilen sınıflandırıcı | Sınıflandırıcı artı bazı veya tüm evrişimsel bloklar |
| backbone üzerinde _grad gerektirir | Yanlış | Blokların güncellenmesi doğru. |
| Gerekli veriler | Sınıf başına genellikle birkaç yüz görselden oluşan küçük gruplar. | Daha büyük, genellikle binlerce |
| Eğitim maliyeti | En düşük ayar, bir işlemci üzerinde çalışır. | Daha yüksek değerlerde, bir GPU'ya sahip olmak daha değerli hale gelir. |
| Tipik doğruluk | Kaynak ve hedef görseller birbirine benzediğinde iyidir. | İki alan farklı olduğunda genellikle daha iyidir. |
Aşağıdaki adımlar, ex özelliğini kullanmaktadır.tracBurada: her VGG19 parametresi dondurulur ve yalnızca yeni son Doğrusal katman öğrenir. İnce ayara geçmek küçük bir değişikliktir; güncellemek istediğiniz bloklarda requires_grad ayarını True olarak bırakmak ve ödünç alınan ağırlıkların yok edilmemesi için öğrenme oranını düşürmek yeterlidir.
Veri Kümesi Yükleniyor
Python ile Transfer Öğrenmeyi kullanmaya başlamadan önceTorÖncelikle kullanacağınız veri setini anlamanız gerekiyor. Bu Transfer Learning Py örneğinde,TorÖrneğin, yaklaşık 700 görüntüden bir uzaylı ve bir yırtıcıyı sınıflandıracaksınız. Bu teknik için, eğitim için gerçekten büyük miktarda veriye ihtiyacınız yok. Veri setini şuradan indirebilirsiniz: Kaggle: Alien vs. Predator.
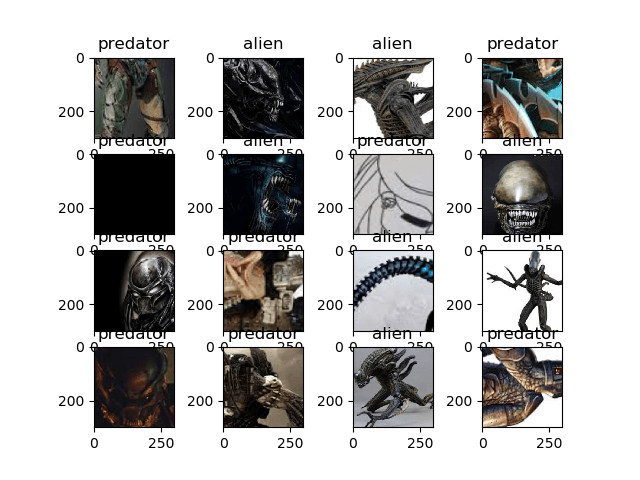
Koleksiyon bilerek küçük tutulmuştur ve içerdiği resimlerden bir örnek aşağıda gösterilmiştir.

Kaynak: Alien vs yırtıcı hayvan Kaggle
Sırada bu Py'deTorBu Transfer Öğrenme eğitiminde, Python kullanarak Transfer Öğrenmeyi nasıl uygulayacağınızı öğreneceksiniz.Toradım adım.
Transfer Öğrenme Nasıl Kullanılır?
İşte Python kullanarak derin öğrenme için transfer öğrenme yönteminin adım adım nasıl uygulanacağına dair bir süreç.Torch:
Adım 1) Verileri Yükleyin
İlk adım, verileri yüklemek ve görüntülere ağın gereksinimlerine uygun hale getirmek için bazı dönüşümler uygulamaktır.
Verileri torchvision.datasets adlı klasörden yükleyeceksiniz. Modül, verileri eğitim ve doğrulama kümelerine ayırmak için klasör üzerinde yineleme yapar. Burada kullanılan dönüşüm işlem hattı, görüntüleri merkezden kırpar, bir tensöre dönüştürür ve normalleştirir. Derin Öğrenme.
from __future__ import print_function, division
import os
import time
import torch
import torchvision
from torchvision import datasets, models, transforms
import torch.optim as optim
import numpy as np
import matplotlib.pyplot as plt

data_dir = "alien_pred"
input_shape = 224
mean = [0.5, 0.5, 0.5]
std = [0.5, 0.5, 0.5]

#data transformation
data_transforms = {
   'train': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
   'validation': transforms.Compose([
       transforms.CenterCrop(input_shape),
       transforms.ToTensor(),
       transforms.Normalize(mean, std)
   ]),
}

image_datasets = {
   x: datasets.ImageFolder(
       os.path.join(data_dir, x),
       transform=data_transforms[x]
   )
   for x in ['train', 'validation']
}

dataloaders = {
   x: torch.utils.data.DataLoader(
       image_datasets[x], batch_size=32,
       shuffle=True, num_workers=4
   )
   for x in ['train', 'validation']
}

dataset_sizes = {x: len(image_datasets[x]) for x in ['train', 'validation']}

print(dataset_sizes)
class_names = image_datasets['train'].classes

device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")
Şimdi veri setini görselleştirelim. Görselleştirme adımı, eğitim verisi yükleyicisinden bir sonraki görüntü ve etiket grubunu alır ve bunları Matplotlib ile görüntüler.
images, labels = next(iter(dataloaders['train']))

rows = 4
columns = 4
fig=plt.figure()
for i in range(16):
   fig.add_subplot(rows, columns, i+1)
   plt.title(class_names[labels[i]])
   img = images[i].numpy().transpose((1, 2, 0))
   img = std * img + mean
   plt.imshow(img)
plt.show()
Bu kod parçasını çalıştırdığınızda, her biri yükleyicinin döndürdüğü sınıf adıyla adlandırılmış dörtlü bir eğitim resimleri ızgarası çizilir.
Adım 2) Modeli Tanımlayın
Bu Derin Öğrenme sürecinde, torchvision modülünden VGG19'u kullanacaksınız.
Torchvision.models kullanarak önceden eğitilmiş ağırlıkları etkinleştirilmiş vgg19'u yükleyeceksiniz. Ardından, katmanları eğitilemez hale getirmek için donduracaksınız. Daha sonra, son katmanı, burada 2 sınıf anlamına gelen probleme uyan bir Doğrusal katmanla değiştireceksiniz. Kayıp fonksiyonu olarak CrossEntropyLoss, optimizasyon algoritması olarak ise 0.001 öğrenme oranı ve 0.9 momentum ile SGD kullanılacaktır, aşağıdaki Py kodunda gösterildiği gibi.Torch Transfer Öğrenme örneği.
## Load the model based on VGG19
vgg_based = torchvision.models.vgg19(pretrained=True)

## freeze the layers
for param in vgg_based.parameters():
   param.requires_grad = False

# Modify the last layer
number_features = vgg_based.classifier[6].in_features
features = list(vgg_based.classifier.children())[:-1] # Remove last layer
features.extend([torch.nn.Linear(number_features, len(class_names))])
vgg_based.classifier = torch.nn.Sequential(*features)

vgg_based = vgg_based.to(device)

print(vgg_based)

criterion = torch.nn.CrossEntropyLoss()
optimizer_ft = optim.SGD(vgg_based.parameters(), lr=0.001, momentum=0.9)
Sürüm notu: the önceden eğitilmiş=Doğru Bu argüman hala geçerli ancak torchvision 0.13 sürümünden beri yerini başka bir şeye bırakmıştır. ağırlıklar argüman, bu nedenle yeni kurulumlar şunu bekliyor: torchvision.models.vgg19(weights=VGG19_Weights.DEFAULT) Aksi takdirde bir kullanım dışı bırakma uyarısı yazdırın. Her iki form da aynı ImageNet ağırlıklarını yükler.
Çıkış modeli yapısı
Modelin yazdırılması, tam VGG19 grafiğini döndürür. Değişimin işe yaradığını doğrulamak için sınıflandırıcı bloğunun son satırını okuyun: artık 1,000 ImageNet sınıfı yerine 2 çıktı üretiyor.
VGG(
  (features): Sequential(
	(0): Conv2d(3, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(1): ReLU(inplace)
	(2): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(3): ReLU(inplace)
	(4): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(5): Conv2d(64, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(6): ReLU(inplace)
	(7): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(8): ReLU(inplace)
	(9): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(10): Conv2d(128, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(11): ReLU(inplace)
	(12): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(13): ReLU(inplace)
	(14): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(15): ReLU(inplace)
	(16): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(17): ReLU(inplace)
	(18): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(19): Conv2d(256, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(20): ReLU(inplace)
	(21): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(22): ReLU(inplace)
	(23): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(24): ReLU(inplace)
	(25): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(26): ReLU(inplace)
	(27): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
	(28): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(29): ReLU(inplace)
	(30): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(31): ReLU(inplace)
	(32): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(33): ReLU(inplace)
	(34): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
	(35): ReLU(inplace)
	(36): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
  )
  (classifier): Sequential(
	(0): Linear(in_features=25088, out_features=4096, bias=True)
	(1): ReLU(inplace)
	(2): Dropout(p=0.5)
	(3): Linear(in_features=4096, out_features=4096, bias=True)
	(4): ReLU(inplace)
	(5): Dropout(p=0.5)
	(6): Linear(in_features=4096, out_features=2, bias=True)
  )
)
Adım 3) Modeli Eğitin ve Test Edin
Bu fonksiyonların bazılarını kullanacağız. PyTorch Eğitimi modelimizi eğitmemize ve değerlendirmemize yardımcı olmak için.
def train_model(model, criterion, optimizer, num_epochs=25):
   since = time.time()

   for epoch in range(num_epochs):
       print('Epoch {}/{}'.format(epoch, num_epochs - 1))
       print('-' * 10)

       #set model to trainable
       # model.train()

       train_loss = 0

       # Iterate over data.
       for i, data in enumerate(dataloaders['train']):
           inputs , labels = data
           inputs = inputs.to(device)
           labels = labels.to(device)

           optimizer.zero_grad()

           with torch.set_grad_enabled(True):
               outputs  = model(inputs)
               loss = criterion(outputs, labels)

           loss.backward()
           optimizer.step()

           train_loss += loss.item() * inputs.size(0)

           print('{} Loss: {:.4f}'.format(
               'train', train_loss / dataset_sizes['train']))

   time_elapsed = time.time() - since
   print('Training complete in {:.0f}m {:.0f}s'.format(
       time_elapsed // 60, time_elapsed % 60))

   return model

def visualize_model(model, num_images=6):
   was_training = model.training
   model.eval()
   images_so_far = 0
   fig = plt.figure()

   with torch.no_grad():
       for i, (inputs, labels) in enumerate(dataloaders['validation']):
           inputs = inputs.to(device)
           labels = labels.to(device)

           outputs = model(inputs)
           _, preds = torch.max(outputs, 1)

           for j in range(inputs.size()[0]):
               images_so_far += 1
               ax = plt.subplot(num_images//2, 2, images_so_far)
               ax.axis('off')
               ax.set_title('predicted: {} truth: {}'.format(class_names[preds[j]], class_names[labels[j]]))
               img = inputs.cpu().data[j].numpy().transpose((1, 2, 0))
               img = std * img + mean
               ax.imshow(img)

               if images_so_far == num_images:
                   model.train(mode=was_training)
                   return
       model.train(mode=was_training)
Son olarak, Python'da Transfer Öğrenme konusunda bu yazıyı tamamladık.TorÖrneğin, eğitim sürecini 25 epoch sayısı ile başlatın ve ardından ağı değerlendirin. Her eğitim adımında model girdiyi alır ve çıktıyı tahmin eder. Tahmin, kayıp değerini hesaplamak için kritere iletilir, geri yayılım gradyanları hesaplar ve optimize edici, otomatik gradyan hesaplamasıyla ağırlıkları günceller.
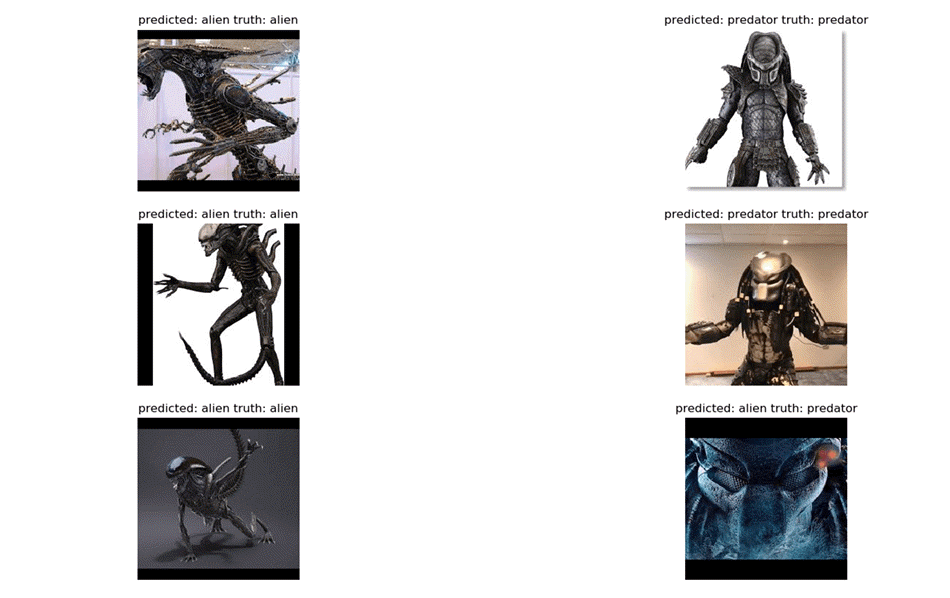
Görselleştirme fonksiyonunda, eğitilmiş ağ, etiketleri tahmin etmek için bir grup görüntüyle test edilir ve sonuç Matplotlib ile çizilir.
vgg_based = train_model(vgg_based, criterion, optimizer_ft, num_epochs=25)

visualize_model(vgg_based)

plt.show()
Adım 4) Sonuçlar
Bu çalıştırma için bildirilen doğruluk oranı %92'dir. Eğitim sonunda yazdırılan günlük, son iki epoch'taki çalışma kaybını ve toplam eğitim süresini göstermektedir.
Epoch 23/24
----------
train Loss: 0.0044
train Loss: 0.0078
train Loss: 0.0141
train Loss: 0.0221
train Loss: 0.0306
train Loss: 0.0336
train Loss: 0.0442
train Loss: 0.0482
train Loss: 0.0557
train Loss: 0.0643
train Loss: 0.0763
train Loss: 0.0779
train Loss: 0.0843
train Loss: 0.0910
train Loss: 0.0990
train Loss: 0.1063
train Loss: 0.1133
train Loss: 0.1220
train Loss: 0.1344
train Loss: 0.1382
train Loss: 0.1429
train Loss: 0.1500
Epoch 24/24
----------
train Loss: 0.0076
train Loss: 0.0115
train Loss: 0.0185
train Loss: 0.0277
train Loss: 0.0345
train Loss: 0.0420
train Loss: 0.0450
train Loss: 0.0490
train Loss: 0.0644
train Loss: 0.0755
train Loss: 0.0813
train Loss: 0.0868
train Loss: 0.0916
train Loss: 0.0980
train Loss: 0.1008
train Loss: 0.1101
train Loss: 0.1176
train Loss: 0.1282
train Loss: 0.1323
train Loss: 0.1397
train Loss: 0.1436
train Loss: 0.1467
Training complete in 2m 47s
Modelin tahminleri daha sonra aşağıda gösterildiği gibi Matplotlib ile görselleştirilir.
Aktarım Öğrenmesinde Sık Yapılan Hatalar ve Bunların Nasıl Düzeltileceği
Transfer öğrenme senaryolarındaki hataların çoğu matematiksel olmaktan ziyade mekaniktir. Yukarıdaki kodun çalışmasını engelleyen hatalar ve her birinin anlamı aşağıda açıklanmıştır.
- Son katmanda boyut uyumsuzluğu: Değiştirilen Doğrusal katman, orijinal sınıflandırıcı tarafından bildirilen in_features'ı kabul etmeli ve tam olarak len(class_names) kadar çıktı üretmelidir. 2. Adımdaki gibi modeli yazdırmak, her iki sayıyı da doğrulamanın en hızlı yoludur.
- Omurga hiçbir zaman donmadı: `requires_grad` değeri `True` olarak bırakılırsa, her VGG19 parametresi güncellenir ve işlemci üzerinde çalışma hızı çok düşer. Sınıflandırıcı değiştirilmeden önce bu değeri `False` olarak ayarlayın.
- Normalizasyon uyumsuzluğu: Dönüşümlerde kullanılan ortalama ve standart sapma değerleri, eğitim ve çıkarım zamanlarında aynı olmalıdır; aksi takdirde tahminler görünür bir neden olmaksızın sapma gösterir.
- Kullanımdan kaldırılmış ağırlıklar argümanı: Torchvision 0.13 ve sonraki sürümlerinde, pretrained=True bir kullanım dışı bırakma uyarısı verir ve weights enum'u tercih edilir.
- num_workers on Windows ve defterler: num_workers=4 olan bir DataLoader'ın giriş noktasının korunması gerekir, bu nedenle num_workers=0 olarak ayarlayın. Python Bu durum, bir oluşturma veya serileştirme hatasına neden olur.
- Eğitim modunda değerlendirme: Dropout ve BatchNorm'un belirleyici bir şekilde davranması için puanlama işleminden önce model.eval() çağrısını yapın ve sonrasında model.train() ile eski haline geri dönün.
