
Python ile Seq2seq (Diziden Diziye) ModeliTorch
 Editoryal Takım
⚡ Akıllı Özet
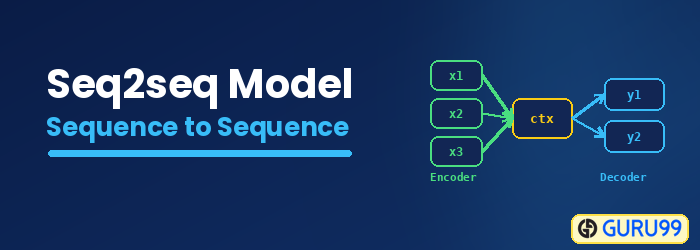
Seq2Seq, girdi dizisini iki tekrarlayan sinir ağı kullanarak çıktı dizisine eşleyen bir kodlayıcı-kod çözücü mimarisidir ve girdi ve çıktı uzunluklarının farklı olduğu makine çevirisi ve diğer doğal dil işleme görevlerine güç sağlar.
NLP nedir?
Doğal Dil İşleme (NLP), yapay zekanın popüler dallarından biridir ve bilgisayarların insanların doğal dillerini anlamalarına, onlarla etkileşim kurmalarına veya onlara yanıt vermelerine yardımcı olur. NLP, bu teknolojinin arkasındaki itici güçtür. Google Translate diğer dilleri anlamamıza yardımcı olur.
Seq2Seq nedir?
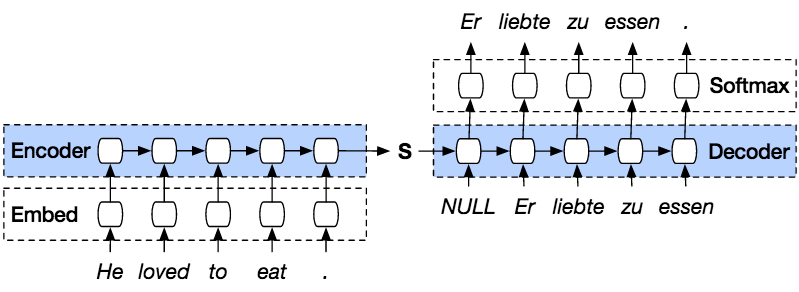
Sıra2Seq bir dizi girişini bir etiket ve dikkat değeriyle bir dizi çıkışıyla eşleştiren, kodlayıcı-kod çözücü tabanlı bir makine çevirisi ve dil işleme yöntemidir. Buradaki fikir, özel bir belirteçle birlikte çalışacak 2 RNN kullanmak ve önceki diziden sonraki durum dizisini tahmin etmeye çalışmaktır.
Önceki diziden dizi nasıl tahmin edilir
Py kullanarak önceki diziden yeni bir dizi tahmin etme adımları şunlardır:Torch.
Adım 1) Verilerimizi Yükleme
Veri kümemiz için şuradan bir veri kümesi kullanacaksınız: Sekmeyle ayrılmış İki Dilli Cümle Çiftleri. Burada İngilizce'den Endonezce'ye veri kümesini kullanacağım. İstediğiniz herhangi bir şeyi seçebilirsiniz ancak koddaki dosya adını ve dizini değiştirmeyi unutmayın.
from __future__ import unicode_literals, print_function, division
import torch
import torch.nn as nn
import torch.optim as optim
import torch.nn.functional as F

import numpy as np
import pandas as pd

import os
import re
import random

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
Adım 2) Veri Hazırlama
Veri setini doğrudan kullanamazsınız. Cümleleri kelimelere ayırmanız ve One-Hot Vektörüne dönüştürmeniz gerekir. Her kelime, bir sözlük oluşturmak için Lang sınıfında benzersiz bir şekilde indekslenecektir. Lang sınıfı her cümleyi saklayacak ve addSentence ile kelime kelime ayıracaktır. Ardından, Sıra-Sıra modelleri için bilinmeyen her kelimeyi indeksleyerek bir sözlük oluşturacaktır.
SOS_token = 0
EOS_token = 1
MAX_LENGTH = 20

#initialize Lang Class
class Lang:
   def __init__(self):
       #initialize containers to hold the words and corresponding index
       self.word2index = {}
       self.word2count = {}
       self.index2word = {0: "SOS", 1: "EOS"}
       self.n_words = 2  # Count SOS and EOS

#split a sentence into words and add it to the container
   def addSentence(self, sentence):
       for word in sentence.split(' '):
           self.addWord(word)

#If the word is not in the container, the word will be added to it, else, update the word counter
   def addWord(self, word):
       if word not in self.word2index:
           self.word2index[word] = self.n_words
           self.word2count[word] = 1
           self.index2word[self.n_words] = word
           self.n_words += 1
       else:
           self.word2count[word] += 1
Lang sınıfı, sözlük oluşturmamıza yardımcı olacak bir sınıftır. Her dil için, her cümle kelimelere ayrılacak ve ardından konteynere eklenecektir. Her konteyner, kelimeleri uygun dizinde saklayacak, kelimeyi sayacak ve kelimenin dizinini ekleyecektir; böylece bir kelimenin dizinini bulmak veya dizininden bir kelime bulmak için kullanabiliriz.
Verilerimiz TAB ile ayrıldığı için kullanmanız gerekir pandalar Veri yükleyicimiz olarak Pandas'ı kullanacağız. Pandas, verilerimizi bir DataFrame olarak okuyacak ve kaynak ve hedef cümlelere ayıracaktır. Her cümle için, onu küçük harfe dönüştürecek, tüm anlamsız karakterleri kaldıracak, Unicode'dan ASCII'ye çevirecek ve cümleleri her kelimeyi içerecek şekilde böleceksiniz.
#Normalize every sentence
def normalize_sentence(df, lang):
   sentence = df[lang].str.lower()
   sentence = sentence.str.replace('[^A-Za-z\s]+', '')
   sentence = sentence.str.normalize('NFD')
   sentence = sentence.str.encode('ascii', errors='ignore').str.decode('utf-8')
   return sentence

def read_sentence(df, lang1, lang2):
   sentence1 = normalize_sentence(df, lang1)
   sentence2 = normalize_sentence(df, lang2)
   return sentence1, sentence2

def read_file(loc, lang1, lang2):
   df = pd.read_csv(loc, delimiter='\t', header=None, names=[lang1, lang2])
   return df

def process_data(lang1,lang2):
   df = read_file('text/%s-%s.txt' % (lang1, lang2), lang1, lang2)
   print("Read %s sentence pairs" % len(df))
   sentence1, sentence2 = read_sentence(df, lang1, lang2)

   source = Lang()
   target = Lang()
   pairs = []
   for i in range(len(df)):
       if len(sentence1[i].split(' ')) < MAX_LENGTH and len(sentence2[i].split(' ')) < MAX_LENGTH:
           full = [sentence1[i], sentence2[i]]
           source.addSentence(sentence1[i])
           target.addSentence(sentence2[i])
           pairs.append(full)

   return source, target, pairs
Kullanacağınız bir diğer faydalı işlev ise çiftleri Tensor'lara dönüştürmektir. Bu çok önemlidir çünkü ağımız yalnızca Tensor tipi verileri okur. Ayrıca, cümlenin her sonunda, ağa girişin bittiğini bildiren bir belirteç bulunacağı için de önemlidir. Cümledeki her kelime için, sözlükteki ilgili kelimenin indeksini alacak ve cümlenin sonuna bir belirteç ekleyecektir.
def indexesFromSentence(lang, sentence):
   return [lang.word2index[word] for word in sentence.split(' ')]

def tensorFromSentence(lang, sentence):
   indexes = indexesFromSentence(lang, sentence)
   indexes.append(EOS_token)
   return torch.tensor(indexes, dtype=torch.long, device=device).view(-1, 1)

def tensorsFromPair(input_lang, output_lang, pair):
   input_tensor = tensorFromSentence(input_lang, pair[0])
   target_tensor = tensorFromSentence(output_lang, pair[1])
   return (input_tensor, target_tensor)
Seq2Seq Modeli

PyTorch Seq2seq modeli, Python kullanan bir model türüdür.TorModelin üzerinde bir kodlayıcı ve kod çözücü bulunur. Kodlayıcı, cümleyi kelime kelime bir kelime dağarcığı indeksine veya indeksli bilinen kelimelere kodlar ve kod çözücü, girdiyi sırayla çözerek kodlanmış girdinin çıktısını tahmin eder ve mümkünse son girdiyi bir sonraki girdi olarak kullanmaya çalışır. Bu yöntemle, bir cümle oluşturmak için bir sonraki girdiyi tahmin etmek de mümkündür. Her cümleye, dizinin sonunu işaretlemek için bir belirteç atanır. Tahminin sonunda, çıktının sonunu işaretlemek için de bir belirteç bulunur. Dolayısıyla, kodlayıcıdan kod çözücüye çıktıyı tahmin etmek için bir durum aktarılır.

Kodlayıcı, giriş cümlesini kelime kelime sırayla kodlayacak ve sonunda cümlenin sonunu işaretleyecek bir belirteç oluşturacaktır. Kodlayıcı, bir Gömme katmanı ve bir GRU katmanından oluşur. Gömme katmanı, girişimizin sabit boyutlu bir kelime sözlüğüne gömülmesini depolayan bir arama tablosudur. Bu, bir GRU katmanına iletilecektir. GRU katmanı, çok katmanlı bir yapıdan oluşan bir Kapılı Tekrarlayan Birimdir. RNN bu sıralı girişi hesaplayacaktır. Bu katman bir öncekinden gizli durumu hesaplayacak ve sıfırlamayı, güncellemeyi ve yeni kapıları güncelleyecektir.

Kod çözücü, kodlayıcının çıkışından gelen girişi çözer. Bir sonraki çıkışı tahmin etmeye ve mümkünse onu bir sonraki giriş olarak kullanmaya çalışır. Kod çözücü, bir Gömme katmanı, bir GRU katmanı ve bir Doğrusal katmandan oluşur. Gömme katmanı, çıkış için bir arama tablosu oluşturur ve tahmin edilen çıkış durumunu hesaplamak için bunu bir GRU katmanına iletir. Bundan sonra, Doğrusal katman, tahmin edilen çıkışın gerçek değerini belirlemek için aktivasyon fonksiyonunu hesaplamaya yardımcı olur.
class Encoder(nn.Module):
   def __init__(self, input_dim, hidden_dim, embbed_dim, num_layers):
       super(Encoder, self).__init__()

       #set the encoder input dimesion , embbed dimesion, hidden dimesion, and number of layers
       self.input_dim = input_dim
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.num_layers = num_layers

       #initialize the embedding layer with input and embbed dimention
       self.embedding = nn.Embedding(input_dim, self.embbed_dim)
       #intialize the GRU to take the input dimetion of embbed, and output dimention of hidden and
       #set the number of gru layers
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)

   def forward(self, src):
       embedded = self.embedding(src).view(1,1,-1)
       outputs, hidden = self.gru(embedded)
       return outputs, hidden

class Decoder(nn.Module):
   def __init__(self, output_dim, hidden_dim, embbed_dim, num_layers):
       super(Decoder, self).__init__()

#set the encoder output dimension, embed dimension, hidden dimension, and number of layers
       self.embbed_dim = embbed_dim
       self.hidden_dim = hidden_dim
       self.output_dim = output_dim
       self.num_layers = num_layers

# initialize every layer with the appropriate dimension. For the decoder layer, it will consist of an embedding, GRU, a Linear layer and a Log softmax activation function.
       self.embedding = nn.Embedding(output_dim, self.embbed_dim)
       self.gru = nn.GRU(self.embbed_dim, self.hidden_dim, num_layers=self.num_layers)
       self.out = nn.Linear(self.hidden_dim, output_dim)
       self.softmax = nn.LogSoftmax(dim=1)

   def forward(self, input, hidden):
# reshape the input to (1, batch_size)
       input = input.view(1, -1)
       embedded = F.relu(self.embedding(input))
       output, hidden = self.gru(embedded, hidden)
       prediction = self.softmax(self.out(output[0]))
       return prediction, hidden

class Seq2Seq(nn.Module):
   def __init__(self, encoder, decoder, device, MAX_LENGTH=MAX_LENGTH):
       super().__init__()

#initialize the encoder and decoder
       self.encoder = encoder
       self.decoder = decoder
       self.device = device

   def forward(self, source, target, teacher_forcing_ratio=0.5):
       input_length = source.size(0) #get the input length (number of words in sentence)
       batch_size = target.shape[1]
       target_length = target.shape[0]
       vocab_size = self.decoder.output_dim

#initialize a variable to hold the predicted outputs
       outputs = torch.zeros(target_length, batch_size, vocab_size).to(self.device)

#encode every word in a sentence
       for i in range(input_length):
           encoder_output, encoder_hidden = self.encoder(source[i])

#use the encoder's hidden layer as the decoder hidden
       decoder_hidden = encoder_hidden.to(device)

#add a token before the first predicted word
       decoder_input = torch.tensor([SOS_token], device=device)  # SOS

#topk is used to get the top K value over a list
#predict the output word from the current target word. If we enable the teaching force, then the next decoder input is the next word, else, use the decoder output highest value.
       for t in range(target_length):
           decoder_output, decoder_hidden = self.decoder(decoder_input, decoder_hidden)
           outputs[t] = decoder_output
           teacher_force = random.random() < teacher_forcing_ratio
           topv, topi = decoder_output.topk(1)
           input = (target[t] if teacher_force else topi)
           if(teacher_force == False and input.item() == EOS_token):
               break

       return outputs
Adım 3) Modeli Eğitmek
Seq2seq modellerindeki eğitim süreci, her bir cümle çiftini dil indekslerinden Tensor'lara dönüştürmekle başlar. Sıralıdan sıralıya modelimiz, optimizasyon algoritması olarak SGD'yi ve kayıpları hesaplamak için NLLLoss fonksiyonunu kullanacaktır. Eğitim süreci, doğru çıktıyı tahmin etmek için modele bir cümle çifti beslemekle başlar. Her adımda, modelden gelen çıktı, kayıpları bulmak ve parametreleri güncellemek için gerçek kelimelerle hesaplanacaktır. Dolayısıyla, 75000 iterasyon kullanacağınız için, sıralıdan sıralıya modelimiz veri setimizden 75000 rastgele çift üretecektir.
teacher_forcing_ratio = 0.5

def clacModel(model, input_tensor, target_tensor, model_optimizer, criterion):
   model_optimizer.zero_grad()

   input_length = input_tensor.size(0)
   loss = 0
   epoch_loss = 0
   # print(input_tensor.shape)

   output = model(input_tensor, target_tensor)

   num_iter = output.size(0)
   print(num_iter)

#calculate the loss from a predicted sentence with the expected result
   for ot in range(num_iter):
       loss += criterion(output[ot], target_tensor[ot])

   loss.backward()
   model_optimizer.step()
   epoch_loss = loss.item() / num_iter

   return epoch_loss

def trainModel(model, source, target, pairs, num_iteration=20000):
   model.train()

   optimizer = optim.SGD(model.parameters(), lr=0.01)
   criterion = nn.NLLLoss()
   total_loss_iterations = 0

   training_pairs = [tensorsFromPair(source, target, random.choice(pairs))
                     for i in range(num_iteration)]

   for iter in range(1, num_iteration+1):
       training_pair = training_pairs[iter - 1]
       input_tensor = training_pair[0]
       target_tensor = training_pair[1]

       loss = clacModel(model, input_tensor, target_tensor, optimizer, criterion)

       total_loss_iterations += loss

       if iter % 5000 == 0:
           avarage_loss= total_loss_iterations / 5000
           total_loss_iterations = 0
           print('%d %.4f' % (iter, avarage_loss))

   torch.save(model.state_dict(), 'mytraining.pt')
   return model
Adım 4) Modeli Test Edin
Seq2seq Py'nin değerlendirme süreciTorBurada amaç, model çıktısını kontrol etmektir. Her bir sıralı-sıralı model çifti modele beslenecek ve tahmin edilen kelimeler üretilecektir. Bundan sonra, doğru indeksi bulmak için her çıktıda en yüksek değere bakacaksınız. Ve sonunda, model tahminimizin gerçek cümleyle nasıl eşleştiğini görmek için bunu karşılaştıracaksınız.
def evaluate(model, input_lang, output_lang, sentences, max_length=MAX_LENGTH): with torch.no_grad(): input_tensor = tensorFromSentence(input_lang, sentences[0]) output_tensor = tensorFromSentence(output_lang, sentences[1]) decoded_words = [] output = model(input_tensor, output_tensor) # print(output_tensor) for ot in range(output.size(0)): topv, topi = output[ot].topk(1) # print(topi) if topi[0].item() == EOS_token: decoded_words.append('' ) break else: decoded_words.append(output_lang.index2word[topi[0].item()]) return decoded_words def evaluateRandomly(model, source, target, pairs, n=10): for i in range(n): pair = random.choice(pairs) print('source {}'.format(pair[0])) print('target {}'.format(pair[1])) output_words = evaluate(model, source, target, pair) output_sentence = ' '.join(output_words) print('predicted {}'.format(output_sentence))
Şimdi, 75000 yineleme sayısı, 1 RNN katmanı ve 512 gizli katman boyutu ile Seq to Seq kullanarak eğitime başlayalım.
lang1 = 'eng'
lang2 = 'ind'
source, target, pairs = process_data(lang1, lang2)

randomize = random.choice(pairs)
print('random sentence {}'.format(randomize))

#print number of words
input_size = source.n_words
output_size = target.n_words
print('Input : {} Output : {}'.format(input_size, output_size))

embed_size = 256
hidden_size = 512
num_layers = 1
num_iteration = 100000

#create encoder-decoder model
encoder = Encoder(input_size, hidden_size, embed_size, num_layers)
decoder = Decoder(output_size, hidden_size, embed_size, num_layers)

model = Seq2Seq(encoder, decoder, device).to(device)

#print model
print(encoder)
print(decoder)

model = trainModel(model, source, target, pairs, num_iteration)
evaluateRandomly(model, source, target, pairs)
Gördüğünüz gibi, tahmin ettiğimiz cümle pek iyi eşleşmedi, bu nedenle daha yüksek doğruluk elde etmek için, çok daha fazla veriyle eğitim almanız ve Sıradan diziye öğrenmeyi kullanarak daha fazla yineleme ve katman sayısı eklemeye çalışmanız gerekir.
random sentence ['tom is finishing his work', 'tom sedang menyelesaikan pekerjaannya']
Input : 3551 Output : 4253
Encoder(
  (embedding): Embedding(3551, 256)
  (gru): GRU(256, 512)
)
Decoder(
  (embedding): Embedding(4253, 256)
  (gru): GRU(256, 512)
  (out): Linear(in_features=512, out_features=4253, bias=True)
  (softmax): LogSoftmax()
)
5000 4.0906
10000 3.9129
15000 3.8171
20000 3.8369
25000 3.8199
30000 3.7957
75000 3.7044
