
MongoDB Örneklerle Düzenli İfade ($regex)
 Stephen Twain
⚡ Akıllı Özet
MongoDB Düzenli ifadeler, belgeler içindeki dizeleri bulmak için kalıp eşleştirme işlemi gerçekleştirir; bu işlemde $regex operatörü, büyük/küçük harf duyarsızlığı için $options bayrağı, tam eşleşmeler için çapa işaretleri ve tam alan değeri bilinmediğinde eğik çizgi sınırlayıcıları kullanılır.
Düzenli ifadeler, temelde belgeler içindeki metin dizilerini bulmak için kullanılan kalıp eşleştirme işleminde kullanılır.
Bazen bir koleksiyondaki belgeleri alırken tam olarak hangi Alan değerinin aranacağını bilemeyebilirsiniz. Bu nedenle, desen eşleştirme arama değerlerine dayalı olarak verilerin alınmasına yardımcı olmak için normal ifadeler kullanılabilir.
Desen eşleştirme için $regex operatörünü kullanma
$regex operatörü MongoDB koleksiyondaki belirli dizeleri aramak için kullanılır. Aşağıdaki örnek bunun nasıl yapılabileceğini gösterir.
Aynı Çalışan koleksiyonuna sahip olduğumuzu ve bu koleksiyonun "Employeeid" ve "EmployeeName" alan adlarına sahip olduğunu varsayalım. Ayrıca koleksiyonumuzda aşağıdaki belgelerin bulunduğunu da varsayalım.
| Çalışan kimliği | İşçi adı |
|---|---|
| 22 | YeniMartin |
| 2 | mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
Aşağıdaki kodda arama kriterlerini belirtmek için $regex operatörünü kullandık.

db.Employee.find({EmployeeName : {$regex: "Gu" }}).forEach(printjson)
Code Açıklama:
- Burada, içinde 'Gu' karakterleri bulunan tüm çalışan isimlerini bulmak istiyoruz. Bu nedenle, arama kriteri olarak 'Gu'yu tanımlamak için $regex operatörünü kullanıyoruz.
- Printjson, sorgu tarafından döndürülen her belgeyi daha iyi bir şekilde yazdırmak için kullanılıyor.
Komut başarıyla yürütülürse, aşağıdaki Çıktı gösterilecektir:
Çıktı:

Çıktı, Çalışan Adının 'Gu' karakterlerini içerdiği belgelerin döndürüldüğünü açıkça göstermektedir.
Diyelim ki koleksiyonunuzda aşağıdaki belgeler var ve bunlara ek olarak, Çalışan Adı'nın "Guru999”. Arama kriterlerini “Guru99”, ayrıca “Guru999”. Ama diyelim ki bunu istemiyoruz ve sadece belgeyi “Guru99”. Bunu tam desen eşleştirme ile yapabiliriz. Tam desen eşleştirme yapmak için ^ ve $ karakterlerini kullanacağız. ^ karakterini dizenin başına, $ karakterini ise dizenin sonuna ekleyeceğiz.
| Çalışan kimliği | İşçi adı |
|---|---|
| 22 | YeniMartin |
| 2 | mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
| 8 | Guru999 |
Aşağıdaki örnek bunun nasıl yapılabileceğini göstermektedir.
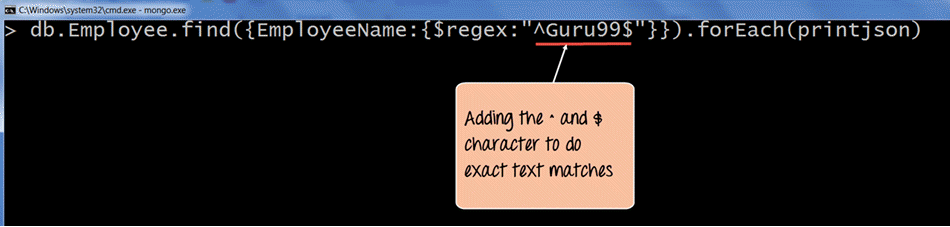
db.Employee.find({EmployeeName : {$regex: "^Guru99$"}}).forEach(printjson)
Code Açıklama:
- Arama kriterlerinde ^ ve $ karakterlerini kullanıyoruz. ^ karakteri, dizenin belirli bir karakterle başlamasını sağlamak için, $ karakteri ise dizenin belirli bir karakterle bitmesini sağlamak için kullanılır. Bu nedenle kod çalıştırıldığında yalnızca " " adlı dizeyi getirecektir.Guru99. "
- Printjson, sorgu tarafından döndürülen her belgeyi daha iyi bir şekilde yazdırmak için kullanılıyor.
Komut başarıyla yürütülürse, aşağıdaki Çıktı gösterilecektir:
Çıktı:
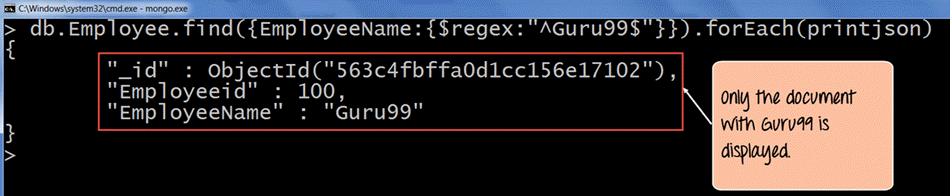
Çıktıda, " dizesinin açıkça görülebildiği anlaşılıyor.Guru99” değeri getirildi.
$options ile Desen Eşleştirme
$regex operatörünü kullanırken, ek seçenekler de belirtebilirsiniz. $ seçenekleri anahtar kelime. Örneğin, Çalışan Adında 'Gu' geçen tüm belgeleri, büyük/küçük harfe duyarlı veya duyarsız olmasına bakılmaksızın bulmak istediğinizi varsayalım. Böyle bir sonuç isteniyorsa, o zaman kullanmamız gerekir. $ seçenekleri Büyük/küçük harf duyarsızlığı parametresiyle.
Aşağıdaki örnek bunun nasıl yapılabileceğini göstermektedir.
Aynı Çalışan koleksiyonuna sahip olduğumuzu ve bu koleksiyonun "Employeeid" ve "EmployeeName" alan adlarına sahip olduğunu varsayalım.
Ayrıca, koleksiyonumuzda aşağıdaki belgelerin bulunduğunu varsayalım.
| Çalışan kimliği | İşçi adı |
|---|---|
| 22 | YeniMartin |
| 2 | mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
| 7 | GURU99 |
Şimdi, önceki konuda olduğu gibi aynı sorguyu çalıştırırsak, sonuçlarda "GURU99" içeren belgeyi asla göremeyiz. Bunun sonuç kümesinde yer almasını sağlamak için, $options "i" parametresini eklememiz gerekiyor.
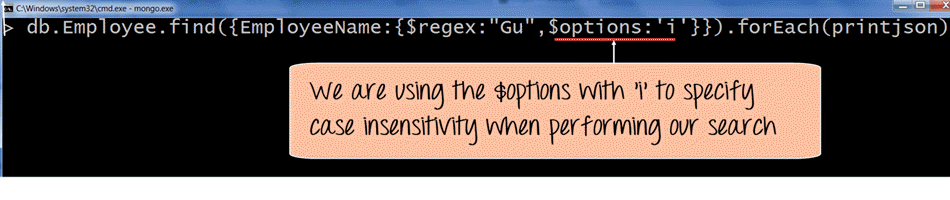
db.Employee.find({EmployeeName:{$regex: "Gu",$options:'i'}}).forEach(printjson)
Code Açıklama:
- 'i' parametresiyle (büyük/küçük harf duyarlılığı yok anlamına gelir) kullanılan '$options' ifadesi, 'Gu' harflerini küçük veya büyük harfle bulsak da aramayı gerçekleştirmek istediğimizi belirtir.
Komut başarıyla yürütülürse, aşağıdaki Çıktı gösterilecektir:
Çıktı:
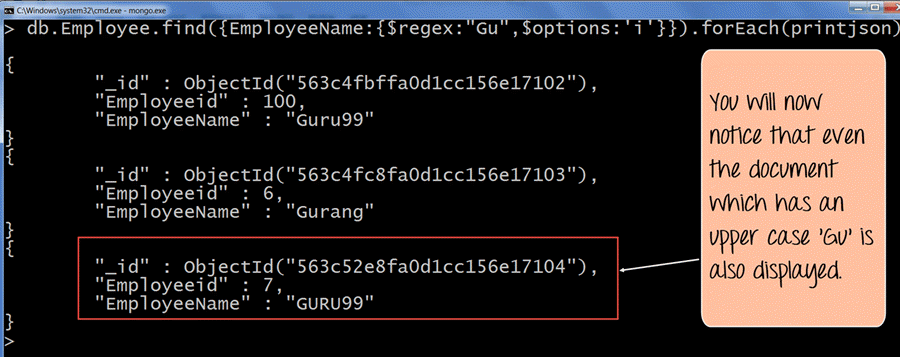
- Çıktı açıkça gösteriyor ki, bir belgede 'Gu' büyük harfle yazılmış olsa bile, belge yine de sonuç kümesinde görüntüleniyor.
Regex operatörü olmadan desen eşleştirme
$regex operatörü olmadan da desen eşleştirme yapılabilir. Aşağıdaki örnek bunun nasıl yapılabileceğini göstermektedir.
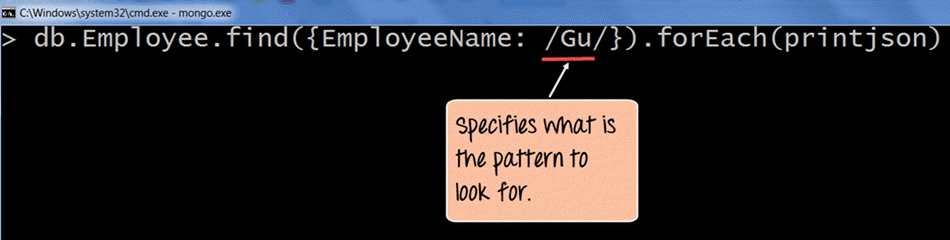
db.Employee.find({EmployeeName: /Gu/}).forEach(printjson)
Code Açıklama:
- “//” ayırıcıları temelde arama kriterlerinizi bu ayırıcılar içinde belirtmek anlamına gelir. Bu nedenle, EmployeeName'lerinde 'Gu' bulunan belgeleri bulmak için /Gu/ ifadesini belirtiyoruz.
Komut başarıyla yürütülürse, aşağıdaki Çıktı gösterilecektir:
Çıktı:
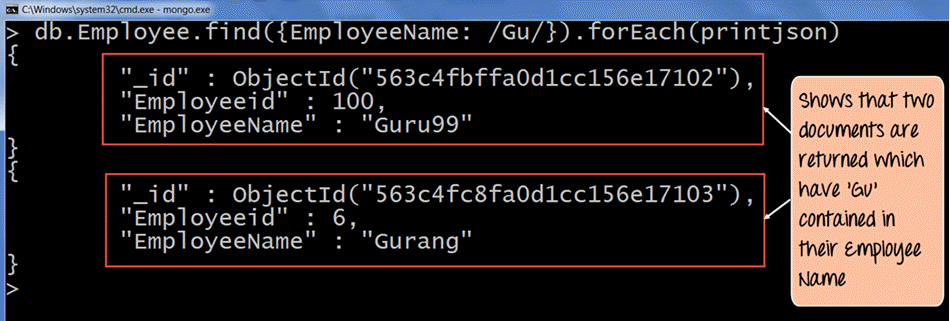
Çıktı, Çalışan Adının 'Gu' karakterlerini içerdiği belgelerin döndürüldüğünü açıkça göstermektedir.
Bir koleksiyondan son 'n' belge getiriliyor
Bir koleksiyondaki son n belgeyi almanın çeşitli yolları vardır.
Şimdi aşağıdaki adımlar aracılığıyla yöntemlerden birine bakalım.
Aşağıdaki örnek bunun nasıl yapılabileceğini göstermektedir.
Aynı Çalışan koleksiyonuna sahip olduğumuzu ve bu koleksiyonun "Employeeid" ve "EmployeeName" alan adlarına sahip olduğunu varsayalım.
Ayrıca, koleksiyonumuzda aşağıdaki belgelerin bulunduğunu varsayalım:
| Çalışan kimliği | İşçi adı |
|---|---|
| 22 | YeniMartin |
| 2 | mohan |
| 3 | Joe |
| 4 | MohanR |
| 100 | Guru99 |
| 6 | Gurang |
| 7 | GURU99 |
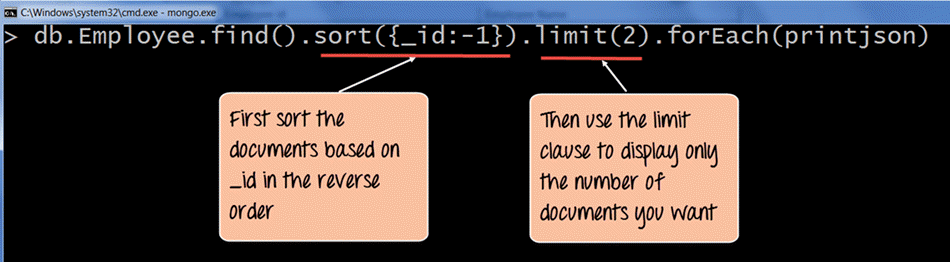
db.Employee.find().sort({_id:-1}).limit(2).forEach(printjson)
Code Açıklama:
- Belgeleri sorgularken, koleksiyondaki _id alan değerine göre kayıtları ters sırada sıralamak için sıralama işlevini kullanın. -1 değeri temel olarak belgeleri ters sırada veya azalan sırada sıralayarak son belgenin ilk görüntülenen belge olmasını sağlar.
- Ardından, yalnızca istediğiniz kayıt sayısını görüntülemek için limit maddesini kullanın. Burada limit maddesini (2) ayarladık, bu nedenle son iki belgeyi getirecektir.
Komut başarıyla yürütülürse, aşağıdaki Çıktı gösterilecektir:
Çıktı:
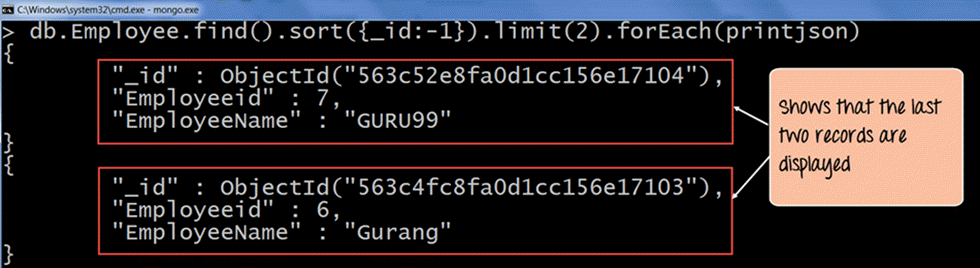
Çıktı, koleksiyondaki son iki belgenin görüntülendiğini açıkça göstermektedir. Dolayısıyla, koleksiyondaki son 'n' belgeyi getirmek için önce belgeleri azalan düzende sıralayabileceğimizi ve ardından gereken 'n' sayıda belgeyi döndürmek için limit maddesini kullanabileceğimizi açıkça gösterdik.
not: Arama 38,000 karakterden daha uzun bir dize üzerinde yapılırsa doğru sonuçlar görüntülenmez.
