
K-anlamı ClusterÖrneklerle R Programlamada Öğrenme
 Editoryal Takım
⚡ Akıllı Özet
K-anlamına gelir ClusterR'de gruplandırma, her nokta ile küme merkezi arasındaki mesafeyi en aza indirerek gözlemleri gruplandırır. Bu adım adım kılavuz, bilgisayar fiyatları veri setini standartlaştırır, algoritmayı canlandırır, dirsek yöntemiyle en uygun k değerini bulur ve kümeleri bir ısı haritası aracılığıyla okur.

Nedir? Cluster analiz?
Cluster analiz şunlara aittir: denetimsiz öğrenme. Küme, benzer özellikleri paylaşan bir veri grubudur. Kümeleme analizinin bir tahminden çok keşifle ilgili olduğunu söyleyebiliriz. Makine verilerde benzerlik arar. Örneğin, küme analizini aşağıdaki uygulama için kullanabilirsiniz:
- Müşteri segmentasyonu: Müşteri grupları arasındaki benzerliği arar
- Hisse Senedi Piyasası kümelemesi: Performanslara dayalı grup hisse senedi
- Bir veri kümesinin boyutunu gruplandırarak azaltmakping benzer değerlere sahip gözlemler
ClusterAnalizin uygulanması çok zor değildir ve iş dünyası için hem anlamlı hem de uygulanabilirdir.
Denetimli ve denetimsiz öğrenme arasındaki en çarpıcı fark sonuçlarda yatmaktadır. Denetimsiz öğrenme, etiket adı verilen yeni bir değişken yaratırken, denetimli öğrenme bir sonucu tahmin eder. Makine, uygulayıcıya verileri yakın ilişkiye dayalı olarak etiketleme arayışında yardımcı olur. Gruplardan faydalanmak ve onlara isim vermek analistin sorumluluğundadır.
Kümeleme kavramını anlamak için bir örnek yapalım. Basitleştirmek adına iki boyutta çalışıyoruz. Müşterilerin toplam harcamaları ve yaşları hakkında verileriniz var. Pazarlama ekibi, reklamcılığı iyileştirmek için müşterilerine daha hedefli e-postalar göndermek istiyor.
Aşağıdaki grafikte toplam harcamayı ve müşterilerin yaşını gösteriyorsunuz.
library(ggplot2)
df <- data.frame(age = c(18, 21, 22, 24, 26, 26, 27, 30, 31, 35, 39, 40, 41, 42, 44, 46, 47, 48, 49, 54),
    spend = c(10, 11, 22, 15, 12, 13, 14, 33, 39, 37, 44, 27, 29, 20, 28, 21, 30, 31, 23, 24)
)
ggplot(df, aes(x = age, y = spend)) +
    geom_point()

Bu noktada bir desen görülebilir
- Sol altta satın alma gücü daha düşük olan gençleri görüyorsunuz
- Üst-orta, daha fazla harcama yapabilecekleri bir işi olan insanları yansıtır
- Son olarak, daha düşük bütçeli yaşlı insanlar.

Yukarıdaki şekilde gözlemleri elle gruplandırıyorsunuz ve üç grubun her birini tanımlıyorsunuz. Bu örnek biraz basit ve son derece görseldir. Veri setine yeni gözlemler eklenirse bunları dairelerin içinde etiketleyebilirsiniz. Çemberi bizim yargılarımıza göre tanımlarsınız. Bunun yerine şunları kullanabilirsiniz: Makine öğrenmesi Verileri objektif olarak gruplandırmak.
Bu eğitimde, nasıl kullanılacağını öğreneceksiniz k-ortalamalar algoritması.
K-Ortalama Algoritması
K-means, en yaygın kullanılan kümeleme yöntemidir. Algoritma 1950'lere dayanmaktadır ve o zamandan beri birçok kez geliştirilmiştir.
Algoritma, gözlemler arasındaki mesafeyi en aza indirerek grupları bulmaya çalışır. yerel optimal Çözümler. Mesafeler, gözlemlerin koordinatlarına göre ölçülür. Örneğin, iki boyutlu bir uzayda koordinatlar basitçe x ve y'dir.
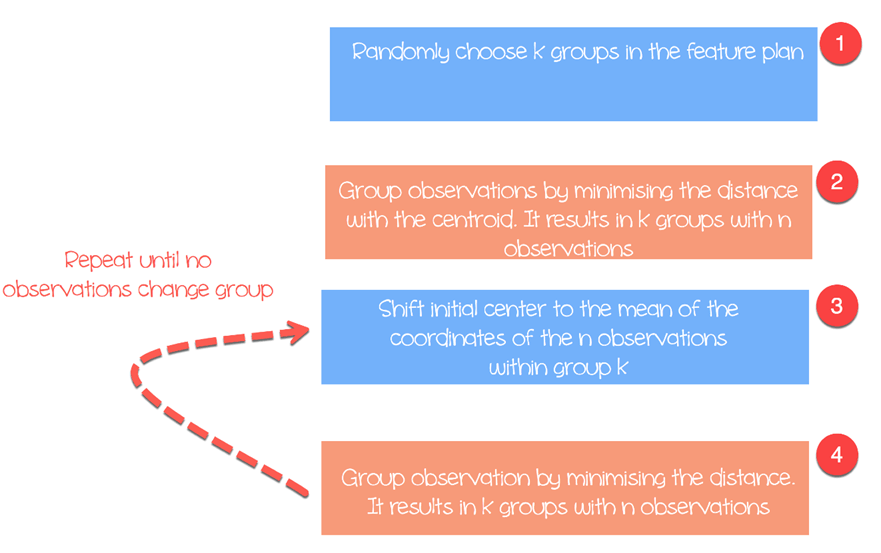
Algoritma şu şekilde çalışır:
- Adım 1: Özellik uzayında rastgele k adet başlangıç merkez noktası seçin.
- Adım 2: Her gözlemi en yakın küme merkezine atayın, ağırlık merkeziBu, k grup üretir.
- 3 Adım: Shift başlangıç ağırlık merkezinin bir grup içindeki koordinatların ortalamasına oranı.
- Adım 4: Yeni ağırlık merkezlerine göre mesafeyi en aza indirin. Yeni sınırlar yaratılıyor. Böylece gözlemler bir gruptan diğerine geçecek
- Hiçbir gözlem grubu değiştirmeyene kadar tekrarlayın
K-means algoritması normalde iki gözlem x ve y arasındaki Öklid mesafesini ölçer:

Manhattan veya Minkowski mesafesi gibi başka ölçümler de mevcuttur. K-ortalama algoritmasının her çalıştırıldığında farklı gruplar döndürdüğünü unutmayın. İlk tahminlerin rastgele olduğunu ve algoritma gruplar içinde homojenliğe ulaşana kadar mesafelerin hesaplandığını hatırlayın. Yani, k-ortalama algoritması ilk seçime çok duyarlıdır ve gözlem ve grup sayısı az olmadıkça aynı kümelemeyi elde etmek neredeyse imkansızdır.
Küme sayısının seçilmesi
K-ortalama algoritmasıyla karşılaşılan bir diğer zorluk ise küme sayısının seçimidir. Grup içi homojenliği artırmak için yüksek bir k değeri, yani çok sayıda grup belirleyebilirsiniz, ancak bu durum risk oluşturur. aşırı oturma Verilere aşırı uyum, modelin altta yatan örüntü yerine bu özel örnekteki gürültüyü ezberlemesi nedeniyle yeni verilerde performansın keskin bir şekilde düşmesi anlamına gelir.
Kümelerin sayısı veri setinin niteliğine, sektöre, işletmeye vb. bağlıdır. Ancak uygun sayıda kümeyi seçmek için genel bir kural vardır:

Burada n, veri kümesindeki gözlem sayısıdır.
Pratikte, işletme ihtiyacına en uygun k değerini bulmak için zaman ayırmak faydalı olacaktır.
Kümeleme analizimizi gerçekleştirmek için Kişisel Bilgisayar Fiyatları veri setini kullanacağız. Bu veri seti 6259 gözlem ve 10 özellik içermektedir. Veri seti, ABD'deki 1993 kişisel bilgisayarın 1995'ten 486'e kadar olan fiyatını gözlemliyor. Değişkenler arasında fiyat, hız, ram, ekran ve cd yer alır.
Aşağıdaki gibi ilerleyeceksin:
- Tarihleri içe aktar
- Modeli eğitin
- Modeli değerlendirin
Tarihleri içe aktar
K-means algoritması mesafeler üzerinden çalıştığı ve ayrık etiketler arasında anlamlı bir mesafe olmadığı için faktör değişkenleri için uygun değildir. Üç kategorik sütunu (cd, multi, premium) ve satır indeksi X'i silin. Bu veri setinde eksik değer bulunmamaktadır.
library(dplyr)
PATH <-"https://raw.githubusercontent.com/guru99-edu/R-Programming/master/computers.csv"
df <- read.csv(PATH) %>%
select(-c(X, cd, multi, premium))
glimpse(df)
Çıktı
## Observations: 6,259
## Variables: 7
## $ price <int> 1499, 1795, 1595, 1849, 3295, 3695, 1720, 1995, 2225, 2...
## $ speed <int> 25, 33, 25, 25, 33, 66, 25, 50, 50, 50, 33, 66, 50, 25, ...
## $ hd <int> 80, 85, 170, 170, 340, 340, 170, 85, 210, 210, 170, 210...
## $ ram <int> 4, 2, 4, 8, 16, 16, 4, 2, 8, 4, 8, 8, 4, 8, 8, 4, 2, 4, ...
## $ screen <int> 14, 14, 15, 14, 14, 14, 14, 14, 14, 15, 15, 14, 14, 14, ...
## $ ads <int> 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, 94, ...
## $ trend  <int> 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1...
Özet istatistiklerden, verilerin büyük değerlere sahip olduğunu görebilirsiniz. Mesafe tabanlı herhangi bir yöntemden önce iyi bir uygulama, her değişkenin belirli bir değere sahip olması için verileri standartlaştırmaktır. sıfırın ortalaması ve birin standart sapmasıOnsuz, binlerce lirayı bulan fiyat, mesafe hesaplamasında belirleyici faktör olurdu ve ekran boyutu neredeyse hiçbir önem taşımazdı.
summary(df)
Çıktı:
##      price          speed              hd              ram
##  Min.   : 949   Min.   : 25.00   Min.   :  80.0   Min.   : 2.000
##  1st Qu.:1794   1st Qu.: 33.00   1st Qu.: 214.0   1st Qu.: 4.000
##  Median :2144   Median : 50.00   Median : 340.0   Median : 8.000
##  Mean   :2220   Mean   : 52.01   Mean   : 416.6   Mean   : 8.287
##  3rd Qu.:2595   3rd Qu.: 66.00   3rd Qu.: 528.0   3rd Qu.: 8.000
##  Max.   :5399   Max.   :100.00   Max.   :2100.0   Max.   :32.000
##      screen           ads            trend
##  Min.   :14.00   Min.   : 39.0   Min.   : 1.00
##  1st Qu.:14.00   1st Qu.:162.5   1st Qu.:10.00
##  Median :14.00   Median :246.0   Median :16.00
##  Mean   :14.61   Mean   :221.3   Mean   :15.93
##  3rd Qu.:15.00   3rd Qu.:275.0   3rd Qu.:21.50
##  Max.   :17.00   Max.   :339.0   Max.   :35.00
Değişkenleri dplyr kitaplığının Scale() işleviyle yeniden ölçeklendirirsiniz. Dönüşüm, aykırı değerlerin etkisini azaltır ve tek bir gözlemin ortalamayla karşılaştırılmasına olanak tanır. Eğer standartlaştırılmış bir değer (veya Z-puanı) yüksekse, bu gözlemin gerçekten ortalamanın üzerinde olduğundan emin olabilirsiniz (büyük bir z-puanı, bu noktanın standart sapma açısından ortalamadan uzak olduğunu gösterir. İkilik bir z-puanı, değerin 2 standart olduğunu gösterir) ortalamadan sapmalar Z-skoru Gauss dağılımını takip eder ve ortalama etrafında simetriktir.
# Note: speed is deliberately left out of the scaled data frame
rescale_df <- df %>%
    mutate(price_scal = scale(price),
    hd_scal = scale(hd),
    ram_scal = scale(ram),
    screen_scal = scale(screen),
    ads_scal = scale(ads),
    trend_scal = scale(trend)) %>%
select(-c(price, speed, hd, ram, screen, ads, trend))
R tabanı, k ortalama algoritmasını çalıştıracak bir işleve sahiptir. K ortalamanın temel işlevi:
kmeans(df, k)
arguments:
-df: dataset used to run the algorithm
-k: Number of clusters
Modeli eğitin
Şekil üçte, algoritmanın nasıl çalıştığını ayrıntılı olarak anlattınız. Yihui Xie tarafından yazılan ve R Markdown için knitr'ı da geliştiren animasyon paketiyle her adımı grafiksel olarak izleyebilirsiniz. Paket conda kanallarında bulunmadığı için CRAN'dan yükleyin:
install.packages("animation")
Kütüphaneyi yükledikten sonra kmeans'ın sonuna .ani'yi eklersiniz ve R tüm adımları planlayacaktır. Örnekleme amacıyla, algoritmayı yalnızca yeniden ölçeklendirilmiş hd ve ram değişkenleriyle üç kümeyle çalıştırırsınız.
set.seed(2345)
library(animation)
kmeans.ani(rescale_df[2:3], 3)
Code açıklama
- kmeans.ani(rescale_df[2:3], 3): rescale_df veri kümesinin 2 ve 3 numaralı sütunlarını seçin ve algoritmayı 3'e k kümeyle çalıştırın. Animasyonu çizin.


Animasyonu şu şekilde yorumlayabilirsiniz:
- Adım 1: R rastgele üç nokta seçer
- Adım 2: Öklid uzaklığını hesaplayın ve kümeleri çizin. Sol altta yeşil renkli bir kümeniz, sağda siyah renkli büyük bir kümeniz ve bunların arasında da kırmızı renkli bir kümeniz var.
- Adım 3: Ağırlık merkezini, yani kümelerin ortalamasını hesaplayın
- Hiçbir veri kümesini değiştirmeyene kadar tekrarlayın
Algoritma yedi yinelemeden sonra birleşti. Veri setimizde k-mean algoritmasını beş küme ile çalıştırabilir ve buna pc_cluster adını verebilirsiniz.
pc_cluster <-kmeans(rescale_df, 5)
pc_cluster listesi yedi kullanışlı öğe içerir:
- pc_cluster$cluster: Her bir gözleme atanan küme
- pc_cluster$centers: Küme merkezleri
- pc_cluster$totss: Karelerin toplam toplamı
- pc_cluster$withinss: Kareler toplamı içinde, küme başına bir değer
- pc_cluster$tot.withinss: withinss'in toplamı
- pc_cluster$betweenss: Toplam kareler toplamı eksi küme içi kareler toplamı
- pc_cluster$size: Her küme içindeki gözlem sayısı
Optimum k küme sayısını hesaplamak için karelerin toplamının toplamını (yani tot.withinss) kullanacaksınız. K'yı bulmak gerçekten önemli bir iştir.
Dirsek Yöntemiyle En Uygun k Değerini Nasıl Bulabilirsiniz?
En iyi k'yi seçmek için kullanılan tekniklerden birine denir. dirsek yöntemi. Bu yöntem, değişkenliği değerlendirmek için grup içi homojenliği veya grup içi heterojenliği kullanır. Başka bir deyişle, her kümenin açıkladığı varyans yüzdesiyle ilgileniyorsunuz. Küme sayısı arttıkça değişkenliğin artmasını, alternatif olarak heterojenliğin azalmasını bekleyebilirsiniz. Bizim görevimiz azalan getirilerin ötesindeki k'yi bulmaktır. Yeni bir küme eklemek verilerdeki değişkenliği iyileştirmez çünkü açıklanacak çok az bilgi kalır.
Bu eğitimde, bu noktayı heterojenlik ölçüsünü kullanarak buluyoruz. Kümeler içindeki toplam kareler toplamı, kmean() tarafından döndürülen listedeki tot.withinss'dir.
Dirsek grafiğini oluşturabilir ve optimum k'yı aşağıdaki gibi bulabilirsiniz:
- Adım 1: Kümeler içindeki toplam kareler toplamını hesaplamak için bir fonksiyon oluşturun
- Adım 2: Algoritmayı bir k değer aralığı üzerinde çalıştırın.
- Adım 3: Algoritmanın sonuçlarıyla bir veri çerçevesi oluşturun
- Adım 4: Sonuçları çizin
) 1 Adım Kümeler içindeki toplam kareler toplamını hesaplamak için bir fonksiyon oluşturun
K-ortalama algoritmasını çalıştıran ve kümeler içindeki toplamı kareler toplamı olarak depolayan işlevi yaratırsınız
kmean_withinss <- function(k) {
    cluster <- kmeans(rescale_df, k)
    return (cluster$tot.withinss)
}
Code açıklama
- fonksiyon(k): Fonksiyondaki argümanların sayısını ayarlayın
- kmeans(rescale_df, k): Algoritmayı bu k değeri için çalıştır
- return(cluster$tot.withinss): Kümeler içindeki karelerin toplamını depolar
Fonksiyonu k'nin 2'ye eşit olduğu durumda test edin.
Çıktı:
## Try with 2 cluster
kmean_withinss(2)
Çıktı:
## [1] 27087.07
) 2 Adım Algoritmayı n kez çalıştır
Algoritmayı k aralığında çalıştırmak için sapply() fonksiyonunu kullanacaksınız. Bu teknik bir döngü oluşturup değeri saklamaktan daha hızlıdır.
# Set maximum cluster
max_k <-20
# Run algorithm over a range of k
wss <- sapply(2:max_k, kmean_withinss)
Code açıklama
- max_k <- 20: k'nin maksimum değerini 20 olarak ayarlayın.
- sapply(2:max_k, kmean_withinss): kmean_withinss() fonksiyonunu 2:max_k, yani 2 ila 20 aralığında çalıştırın.
) 3 Adım Algoritmanın sonuçlarıyla bir veri çerçevesi oluşturun
Fonksiyonu yazıp test ettikten sonra, 2 ile 20 arasındaki aralıkta çalıştırın ve her tot.withinss değerini saklayın.
# Create a data frame to plot the graph
elbow <-data.frame(2:max_k, wss)
Code açıklama
- data.frame(2:max_k, wss): wss'deki algoritma deposunun çıktısıyla bir veri çerçevesi oluşturun
) 4 Adım Sonuçları çizin
Dirsek noktasının nerede olduğunu görselleştirmek için grafiği çizersiniz
# Plot the graph with gglop
ggplot(elbow, aes(x = X2.max_k, y = wss)) +
    geom_point() +
    geom_line() +
    scale_x_continuous(breaks = seq(1, 20, by = 1))

Grafikten, eğrinin azalan bir getiri elde etmeye başladığı optimal k'nın yedi olduğunu görebilirsiniz.
Optimum k değerimizi elde ettikten sonra algoritmayı k eşittir 7 ile yeniden çalıştırır ve kümeleri değerlendirirsiniz.
Kümeleri incelemek
pc_cluster_2 <-kmeans(rescale_df, 7)
Daha önce de belirttiğimiz gibi, geri kalan ilginç bilgilere kmean() tarafından döndürülen listeden ulaşabilirsiniz.
pc_cluster_2$cluster
pc_cluster_2$centers
pc_cluster_2$size
Değerlendirme özneldir ve kümelerin ne amaçla kullanıldığına bağlıdır. Buradaki amaç, benzer özelliklere sahip bilgisayarları gruplandırmaktır. Bir alan uzmanı bunu elle yapabilir, ancak süreç yavaş ve hataya açık olur. K-means, gruplandırmayı otomatik olarak yapar.ping Nesnel bir şekilde değerlendirir ve sonucu yorumlayıp adlandırmayı uzmana bırakır.
Ön değerlendirme olarak kümelerin büyüklüklerini inceleyebilirsiniz.
pc_cluster_2$size
Çıktı:
## [1] 608 1596 1231 580 1003 699 542
En büyük küme olan 2 numaralı küme 1,596 gözlem içerirken, en küçük küme olan 7 numaralı küme yalnızca 542 bilgisayar içermektedir. Kümeler arasında homojenlik olması iyi olabilir; aksi takdirde daha ince bir veri hazırlığı gerekebilir.
Merkez bileşeniyle verilere daha derinlemesine bakabilirsiniz. Satırlar kümenin numaralandırılmasını, sütunlar ise algoritma tarafından kullanılan değişkenleri ifade eder. Değerler, ilgili sütun için her kümenin ortalama puanıdır. Standardizasyon yorumlamayı kolaylaştırır. Pozitif değerler, belirli bir küme için z-skorunun genel ortalamanın üzerinde olduğunu gösterir. Örneğin, 4. küme en yüksek ortalama fiyata (price_scal = 1.09) sahipken, 5. küme en düşük ortalama fiyata (-0.82) sahiptir.
center <-pc_cluster_2$centers
center
Çıktı:
##   price_scal    hd_scal     ram_scal screen_scal   ads_scal trend_scal
## 1 -0.6372457 -0.7097995 -0.691520682  -0.4401632  0.6780366 -0.3379751
## 2 -0.1323863  0.6299541  0.004786730   2.6419582 -0.8894946  1.2673184
## 3  0.8745816  0.2574164  0.513105797  -0.2003237  0.6734261 -0.3300536
## 4  1.0912296 -0.2401936  0.006526723   2.6419582  0.4704301 -0.4132057
## 5 -0.8155183  0.2814882 -0.307621003  -0.3205176 -0.9052979  1.2177279
## 6  0.8830191  2.1019454  2.168706085   0.4492922 -0.9035248  1.2069855
## 7  0.2215678 -0.7132577 -0.318050275  -0.3878782 -1.3206229 -1.5490909
Kategoriler arasındaki farkı vurgulamamıza yardımcı olması için ggplot ile bir ısı haritası oluşturabilirsiniz.
Ggplot'un varsayılan renklerinin RColorBrewer kitaplığıyla değiştirilmesi gerekir. Conda'yı kullanabilirsiniz kütüphane ve terminalde başlatılacak kod:
conda install -c r r-rcolorbrewer
Isı haritası oluşturmak için üç adımda ilerlersiniz:
- Merkezin değerleriyle bir veri çerçevesi oluşturun ve küme numarasıyla bir değişken oluşturun
- Verileri tidyr kütüphanesinin toplama() işleviyle yeniden şekillendirin. Verileri genişten uzuna dönüştürmek istiyorsunuz.
- Renklerle renk paleti oluşturunRampPalet() işlevi
) 1 Adım Bir veri çerçevesi oluşturun
Yeniden şekillendirme veri kümesini oluşturalım
library(tidyr)

# create dataset with the cluster number

cluster <- c(1: 7)
center_df <- data.frame(cluster, center)

# Reshape the data

center_reshape <- gather(center_df, features, values, price_scal: trend_scal)
head(center_reshape)
Çıktı:
##   cluster   features     values
## 1       1 price_scal -0.6372457
## 2       2 price_scal -0.1323863
## 3       3 price_scal  0.8745816
## 4       4 price_scal  1.0912296
## 5       5 price_scal -0.8155183
## 6       6 price_scal  0.8830191
) 2 Adım Renk paletini oluşturun
Aşağıdaki kod, ısı haritası tarafından kullanılan renk paletini oluşturur.
library(RColorBrewer)
# Create the palette
hm.palette <-colorRampPalette(rev(brewer.pal(10, 'RdYlGn')),space='Lab')
Adım 3) Görselleştirin
Grafiği çizebilir ve kümelerin neye benzediğini görebilirsiniz.
# Plot the heat map
ggplot(data = center_reshape, aes(x = features, y = cluster, fill = values)) +
    scale_y_continuous(breaks = seq(1, 7, by = 1)) +
    geom_tile() +
    coord_equal() +
    scale_fill_gradientn(colours = hm.palette(90)) +
    theme_classic()

set.seed() ve nstart kullanarak tekrarlanabilir K-Means sonuçları nasıl elde edilir?
Öğretici notlarda k-means algoritmasının her çalıştırmada farklı gruplar döndürdüğü belirtiliyor. Bu, katlanılması gereken bir tuhaflık değil, iki standart çözümü olan bir sorundur ve yukarıdaki örneklerde bu çözümlerden hiçbiri kullanılmamıştır.
1. Başlangıç noktasını set.seed() ile sabitleyin. Başlangıç merkez noktaları rastgele seçilir, bu nedenle aynı çağrı her seferinde farklı kümeler üretir. Bir başlangıç değeri belirlemek, tüm analizin tekrarlanabilir olmasını sağlar:
set.seed(123)
pc_cluster_2 <- kmeans(rescale_df, 7)
2. Birkaç çalıştırma yapın ve en iyisini nstart ile kaydedin. Tek bir rastgele başlangıç noktası, zayıf bir yerel optimuma yakınsayabilir. `nstart` argümanı, algoritmayı farklı rastgele başlangıç noktalarından o kadar kez çalıştırır ve kareler toplamı içinde en düşük toplam değere sahip olanı döndürür:
set.seed(123)
pc_cluster_2 <- kmeans(rescale_df, centers = 7, nstart = 25)
Genellikle önerilen 25 başlangıç, bu büyüklükteki bir veri kümesi için çok az maliyetlidir. Bu olmadan, dirsek eğrisi kendi başına kararsız hale gelir, çünkü grafikteki her nokta tek bir şanssız veya şanslı başlangıçtan gelir. Bu nedenle, daha önce tanımlanan kmean_withinss() fonksiyonu şu şekilde yazılmalıdır:
kmean_withinss <- function(k) {
    cluster <- kmeans(rescale_df, centers = k, nstart = 25)
    return (cluster$tot.withinss)
}
3. Algoritma uyarı verirse iter.max değerini yükseltin. Eğer R "10 yinelemede yakınsama sağlanmadı" şeklinde bir hata mesajı veriyorsa, daha fazla alan sağlamak için iter.max = 50 değerini geçirin.
K-Means ve Hiyerarşik Algoritma ClusterR'de
K-means, mevcut tek kümeleme yöntemi değildir ve seçim genellikle verilerin boyutuna ve kaç grup istediğinizi önceden bilip bilmediğinize bağlıdır.
| Kriterler | K-anlamına gelir | Hiyerarşik |
|---|---|---|
| Küme sayısı | Önceden seçilmelidir. | Dendrogramın kesilmesiyle seçildi. |
| Sonuç istikrarı | Rastgele başlangıca göre değişir | deterministik |
| ölçeklenebilirlik | Çok büyük veri kümelerini işleyebilir. | Birkaç bin satırın ötesindeki mücadeleler |
| Cluster şekil | Yaklaşık olarak küresel ve benzer büyüklükte gruplar varsayılır. | Daha esnek |
| Çıktı | Düz bir etiket seti | İç içe geçmiş yapıyı gösteren bir dendrogram |
| R işlevi | kmeans(df, k) | hclust(dist(df)) |
# Hierarchical alternative on the same scaled data
hc <- hclust(dist(rescale_df), method = "ward.D2")
plot(hc)
groups <- cutree(hc, k = 7)
6,259 gözlemle, hiyerarşik kümeleme yaklaşık 19.6 milyon çiftlik bir mesafe matrisi oluşturmak zorundadır; bu nedenle k-means bu veri seti için pratik bir seçimdir. Ayrıca, k-means'in benzer büyüklükte ve kabaca küresel şekilli kümeler varsaydığını da belirtmek gerekir; bu varsayımın başarısız olduğu durumlarda, DBSCAN düzensiz şekilleri ele alır ve her noktayı bir gruba zorlamak yerine aykırı değerleri belirler.
K-anlamına gelir ClusterR'de ing: Fonksiyon Referansı
Bu eğitimde kullanılan tüm fonksiyonlar aşağıda listelenmiştir:
| paket | Hedef | İşlev | Tartışma |
|---|---|---|---|
| baz | Tren k-ortalaması | kmanlamına gelir() | df, k |
| Kümeye erişim | kmeans()$küme | ||
| Cluster merkezleri | kmeans()$centers | ||
| Cluster boyutları | kmeans()$size | ||
| Kareler toplamı içindeki toplam | kmeans()$tot.withinss | Dirsek yöntemiyle kullanılır | |
| Karelerin toplamı arasında | kmeans()$betweenss | ||
| baz | Tekrarlanabilir çalışma | set.seed() | tohum değeri |
| baz | Sonucu istikrara kavuşturun | kmeans(df, k, nstart = 25) | nstart |
