
R Veri Çerçevesi: Nasıl Oluşturulur, Eklenir, Seçilir ve Alt Kümelenir
 Evelyn Clarke
⚡ Akıllı Özet
R Veri Çerçevesi, farklı türdeki sütunları eşit uzunlukta depolar; bu da onu analiz için standart dikdörtgen yapı haline getirir. Köşeli parantezler satırları ve sütunları dilimler, dolar işareti bir sütuna ulaşır ve subset() koşula göre filtreleme yapar.
Veri Çerçevesi Nedir?
A veri çerçevesi Bir matris, eşit uzunluktaki vektörlerin listesidir. Bir matris yalnızca bir tür veri içerirken, bir veri çerçevesi farklı veri türlerini (sayısal, karakter, faktör vb.) kabul eder.
Bu tanım, veri çerçevesini R'da sürekli karşılaşacağınız iki komşu arasına yerleştirir. matris dikdörtgen şeklindedir ancak tek tiptir ve bir liste Çoklu tipli ancak düzensizdir. Veri çerçevesi her birinden bir özellik ödünç alır.
| Structure | Sütun tipleri | Eleman uzunlukları | Tipik kullanım |
|---|---|---|---|
| vektör | Sadece bir tür | Tek dizi | Bir değişken |
| Matris | Sadece bir tür | Dikdörtgen biçiminde | Sayısal cebir |
| Liste | Çeşitli türlerin herhangi bir karışımı | Öğeye göre farklılık gösterebilir. | Keyfi koleksiyonlar |
| Veri çerçevesi | Çeşitli türlerin herhangi bir karışımı | Her sütun eşit uzunlukta. | Tablo analizi |
Veri çerçevesi aslında temelinde bir liste olduğundan, listelerde kullanılan erişim yöntemleri burada da çalışır; bu nedenle dolar işareti bu eğitimde daha sonra tekrar karşımıza çıkar.
Veri Çerçevesi Nasıl Oluşturulur
İçinde bir veri çerçevesi oluşturabiliriz R a, b, c ve d değişkenlerini data.frame() fonksiyonuna geçirerek veri çerçevesi oluşturabilir ve names() fonksiyonu ile sütunlara isim verebiliriz; bunun için her değişkenin adını belirtmeniz yeterlidir.
data.frame(df, stringsAsFactors = TRUE)
Argümanlar:
- df: Veri çerçevesi olarak dönüştürülecek bir matris veya birleştirilecek değişkenler koleksiyonu olabilir
- stringsAsFactorsKarakter vektörlerinin faktör sütunlarına dönüşüp dönüşmeyeceğini kontrol eder. Fabrika ayarlarındaki varsayılan değer eski sürümlerde TRUE idi ve R 4.0.0'dan beri FALSE'tur, bu nedenle davranış önemliyse bunu açıkça belirtin.
Aynı uzunluktaki dört değişkeni birleştirerek ilk veri setimiz için R'de bir veri çerçevesi oluşturabiliriz.
# Create a, b, c, d variables
a <- c(10,20,30,40)
b <- c('book', 'pen', 'textbook', 'pencil_case')
c <- c(TRUE,FALSE,TRUE,FALSE)
d <- c(2.5, 8, 10, 7)
# Join the variables to create a data frame
df <- data.frame(a,b,c,d)
df
Çıktı:
##     a         b     c     d
## 1  10        book  TRUE   2.5
## 2  20         pen  FALSE  8.0
## 3  30    textbook  TRUE   10.0
## 4  40 pencil_case  FALSE  7.0
Her vektör bir sütun, her vektördeki dört değer ise dört satır oldu. Argümanların isimsiz olduğunu, dolayısıyla R'nin sütun başlıklarını değişken adlarından türettiğini unutmayın.
Sütun başlıklarının değişkenlerle aynı ada sahip olduğunu görebiliriz. R'deki sütun adını işlev adlarıyla () değiştirebiliriz. Aşağıdaki R create dataframe örneğini kontrol edin:
# Name the data frame
names(df) <- c('ID', 'items', 'store', 'price')
df
Çıktı:
##   ID       items store price
## 1 10        book  TRUE   2.5
## 2 20         pen FALSE   8.0
## 3 30    textbook  TRUE  10.0
## 4 40 pencil_case FALSE   7.0
names() fonksiyonuna atama yapmak her başlığı aynı anda değiştirir, bu nedenle değiştirme vektöründe sütun başına tam olarak bir giriş bulunmalıdır. Bunun yerine tek bir sütunu yeniden adlandırmak için, names vektörünü names(df)[2] <- 'product' şeklinde indeksleyin.
# Print the structure
str(df)
Çıktı:
## 'data.frame':    4 obs. of  4 variables:
##  $ ID   : num  10 20 30 40
##  $ items: Factor w/ 4 levels "book","pen","pencil_case",..: 1 2 4 3
##  $ store: logi  TRUE FALSE TRUE FALSE
##  $ price: num  2.5 8 10 7
Sürüm notu. Yukarıdaki çıktı, data.frame() fonksiyonunun varsayılan olarak karakter vektörlerini faktörlere dönüştürdüğü 4.0.0'dan daha eski bir R sürümünde üretilmiştir; bu nedenle items, dört seviyeli bir Faktör olarak raporlanmaktadır. Temel R dokümantasyonu, bu fabrika çıkışı varsayılan ayarı kaydetmektedir. R 4.0.0 için stringsAsFactors = FALSE olarak değiştirildi.Aynı kodu mevcut bir sürümde çalıştırdığınızda öğeler düz karakter sütunu olarak kalır ve str() bunun yerine chr yazdırır. Yazdırılan çıktıyı yeniden üretmek için data.frame() çağrısına stringsAsFactors = TRUE ekleyin veya okuyun. faktör eğitimi Faktörlerin gerçekten istendiği zamanlar için.
Veri Çerçevesini Dilimle
Çerçeve oluşturulduktan sonraki görev, parçalarını geri çıkarmaktır. Dilimleme, bunu yapmanın temel R yöntemidir ve vektörlerle aynı köşeli parantezleri kullanır, ancak tek bir konum yerine iki konum kullanır.
Bir veri çerçevesinin değerlerini dilimlemek mümkündür. Döndürülecek satır ve sütunları, veri çerçevesinin adından önce gelen parantezler içinde seçeriz.
Bir veri çerçevesi satır ve sütunlardan oluşur, df[A, B]. A satırları, B ise sütunları temsil ediyor. Satırları ve/veya sütunları belirterek dilimleyebiliriz.
Aşağıdaki 1 numaralı resimde, sol kısım şunu temsil etmektedir: satırlar ve doğru kısım sütunlar. : sembolünün şu anlama geldiğini unutmayın: için. Örneğin, 1:3, 1'den değerleri seçmeyi amaçlar için 3.

Aşağıdaki şemada, veri çerçevesinin farklı bölümlerine nasıl erişileceği gösterilmektedir:
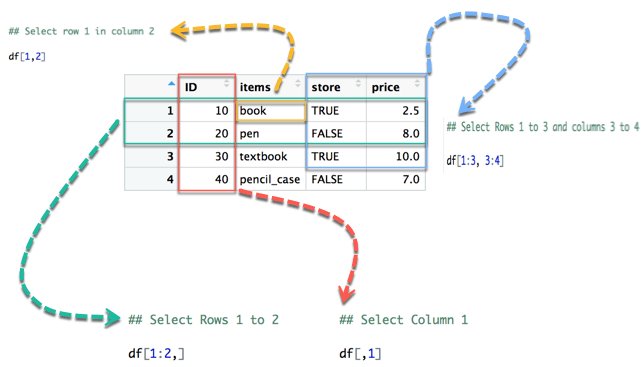
- Sarı ok şunu seçer: sıra içinde 1 sütun 2
- Yeşil ok şunu seçer: satır 1 için 2
- Kırmızı ok şunu seçer: sütun 1
- Mavi ok şunu seçer: satır 1 - 3 ve sütunlar 3 için 4
Sol kısmı boş bırakırsak R'nin seçeceğini unutmayın. tüm satırlar. Benzer şekilde, eğer sağ kısmı boş bırakırsak, R şunu seçecektir: tüm sütunlar.
Kodu konsolda çalıştırabiliriz:
## Select row 1 in column 2
df[1,2]
Çıktı:
## [1] book
## Levels: book pen pencil_case textbook
Levels satırı, bu oturumda items'ın bir faktör olmasından dolayı görünür. R 4.0.0 ve sonraki sürümlerde aynı çağrı, Levels satırı olmadan yalnızca "book" dizesini yazdırır.
## Select Rows 1 to 2
df[1:2,]
Çıktı:
##   ID items store price
## 1 10  book  TRUE   2.5
## 2 20   pen FALSE   8.0
## Select Columns 1
df[,1]
Çıktı:
## [1] 10 20 30 40
df[,1] ile tek bir sütun seçmek, çerçeve sarmalayıcısını kaldırır ve düz bir vektör döndürür. Bunun yerine tek sütunlu bir veri çerçevesine ihtiyaç duyulduğunda, df[, 1, drop = FALSE] şeklinde drop = FALSE ekleyin.
## Select Rows 1 to 3 and columns 3 to 4
df[1:3, 3:4]
Çıktı:
##   store price
## 1  TRUE   2.5
## 2 FALSE   8.0
## 3  TRUE  10.0
Sütunları isimleriyle seçmek de mümkündür. Örneğin, aşağıdaki kodda olduğu gibi.tracİki sütun içerir: Kimlik ve mağaza.
# Slice with columns name
df[, c('ID', 'store')]
Çıktı:
##   ID store
## 1 10  TRUE
## 2 20 FALSE
## 3 30  TRUE
## 4 40 FALSE
Üretim kodunda isimler, pozisyonlardan daha güvenlidir çünkü bir sütun eklemek veya yeniden sıralamak, df[, 3]'ün neye işaret ettiğini sessizce değiştirirken, df[, 'store'] aynı veriye işaret etmeye devam eder.
Veri Çerçevesine Sütun Ekleme
Ayrıca bir veri çerçevesine sütun ekleyebilirsiniz. Yeni değişkeni adlandırmak ve R'da bir veri çerçevesine sütun eklemek için $ sembolünü kullanmanız gerekir.
# Create a new vector
quantity <- c(10, 35, 40, 5)

# Add `quantity` to the `df` data frame
df$quantity <- quantity
df
Çıktı:
##   ID       items store price quantity
## 1 10        book  TRUE   2.5       10
## 2 20         pen FALSE   8.0       35
## 3 30    textbook  TRUE  10.0       40
## 4 40 pencil_case FALSE   7.0        5
Not: Vektördeki eleman sayısı, veri çerçevesindeki eleman sayısına eşit olmalıdır. R'de veri çerçevesine sütun eklemek için aşağıdaki ifadeyi çalıştırın.
quantity <- c(10, 35, 40)
# Add `quantity` to the `df` data frame
df$quantity <- quantity
Hata veriyor:
Error in `lt;-.data.frame`(`*tmp*`, quantity, value = c(10, 35, 40))
replacement has 3 rows, data has 4
Mesaj, veri çerçeveleri için değiştirme operatörünü adlandırır ve her iki sayıyı da belirtir, böylece tam olarak neyi düzeltmeniz gerektiğini söyler. R, yalnızca uzunluğu satır sayısını eşit olarak böldüğünde bir değiştirmeyi yeniden kullanır; bu nedenle df$currency <- 'EUR' gibi 1 uzunluğundaki bir değer kabul edilirken, dört satıra karşı 3 uzunluğundaki bir vektör reddedilir. cbind() aynı şekilde bir sütun ekler ve rbind() ise satır eklemek için bunun karşılığıdır.
Veri Çerçevesinin Sütununu Seçin
Bazen, bir veri çerçevesinin bir sütununu ileride kullanmak üzere saklamamız veya bir sütun üzerinde işlem yapmamız gerekebilir. Veri çerçevesinden sütunu seçmek için "$" işaretini kullanabiliriz.
# Select the column ID
df$ID
Çıktı:
## [1] 1 2 3 4
Bu çıktıyı dikkatlice okuyun. ID, c(10, 20, 30, 40) vektöründen oluşturulmuştur, bu nedenle canlı bir konsol burada 10 20 30 40 yazdırır; yukarıda gösterilen 1 2 3 4, depolanan değerler değil, satır konumlarıdır. Satırın başındaki [1], o satırdaki ilk öğenin indeksidir, verinin bir parçası değildir.
Üç yol aynı sütuna ulaşır: df$ID, df[['ID']] ve df[, 'ID']. Dolar işareti kısmi eşleştirme yapar, bu nedenle df$I yine de ID'yi bulur; bu konsolda kullanışlıdır ancak kaydedilmiş bir betikte risklidir.
Bir Veri Çerçevesini Alt Kümeleme
Önceki bölümde koşulsuz bir sütunun tamamını seçtik. Bu mümkün alt küme belirli bir koşulun doğru olup olmadığına bağlıdır.
subset() fonksiyonunu kullanıyoruz.
subset(x, condition)
arguments:
- x: data frame used to perform the subset
- condition: define the conditional statement
Sadece fiyatı 5'in üzerinde olan ürünleri iade etmek istiyoruz, bu yüzden şöyle yapabiliriz:
# Select price above 5
subset(df, subset = price > 5)
Çıktı:
ID       items store price
2 20         pen FALSE     8
3 30    textbook  TRUE    10
4 40 pencil_case FALSE     7
2, 3 ve 4 numaralı satır etiketleri, df'den aktarılan orijinal satır adlarıdır; bu sayede ilk satırın filtrelendiğini anlayabilirsiniz. subset() işlevi, aynı anda sütun seçmek için bir select argümanı da kabul eder ve eşdeğer köşeli parantez biçimi df[df$price > 5, ] şeklindedir. Köşeli parantez biçimi, koşulun eksik olduğu NA satırlarını korurken, subset() bunları siler, bu nedenle ikisi her zaman birbirinin yerine kullanılamaz.
