
Hadoop MapReduce Örneği: İlk Java ile program Code
 Prafulla Ranadive
⚡ Akıllı Özet
Hadoop MapReduce programları üç şekilde yazılır. Java Derlenen, bir jar dosyasına paketlenen ve ülke bazında satışları saymak için kümeye gönderilen sınıflar, bir eşleyici, bir indirgeyici ve bir sürücü.
Bu eğitimde Hadoop'u MapReduce Örnekleriyle kullanmayı öğreneceksiniz. Kullanılan giriş verileri: SatışOcak2009.csvBu, ürün adı, fiyat, ödeme şekli, müşterinin şehri ve ülkesi gibi satışla ilgili bilgileri içerir. Amaç, her ülkede satılan ürün sayısını bulmaktır.
İlk Hadoop MapReduce Programı
Şimdi bunda MapReduce öğreticisi, ilkimizi yaratacağız Java MapReduce programı:
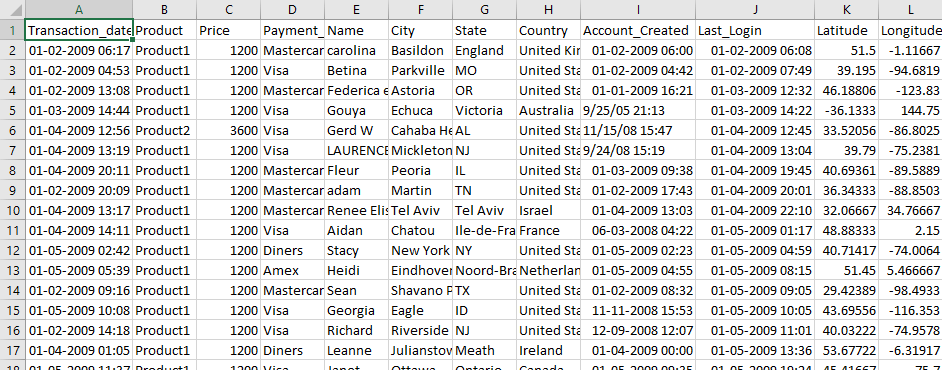
Aşağıdaki ekran görüntüsünde, her satırın bir işlemi temsil ettiği ve ülkenin virgülle ayrılmış sekizinci sütunda yer aldığı ham SatışOcak2009 verileri gösterilmektedir.
Hadoop'un kurulu olduğundan emin olun. Asıl işleme başlamadan önce, kullanıcıyı 'hduser' olarak değiştirin (bu, Hadoop yapılandırması sırasında kullanılan kimliktir - kendi Hadoop yapılandırmanız sırasında kullandığınız kullanıcı kimliğine geçebilirsiniz).
su - hduser_
Aşağıda gösterildiği gibi, komut istemi hduser hesabına dönüşüyor.

Adım 1) Proje dizinini ve kaynak dosyalarını oluşturun.
Aşağıdaki MapReduce örneğinde gösterildiği gibi MapReduceTutorial adında yeni bir dizin oluşturun.
sudo mkdir MapReduceTutorial

İzin verin
sudo chmod -R 777 MapReduceTutorial

Üçünü oluşturun Java MapReduceTutorial içindeki kaynak dosyalarına bakın. Üçünün de eski sürümü kullandığını unutmayın. org.apache.hadoop.mapred Hadoop 3.x ile birlikte gelen API.
SalesMapper.java
package SalesCountry;

import java.io.IOException;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesMapper extends MapReduceBase implements Mapper <LongWritable, Text, Text, IntWritable> {
	private final static IntWritable one = new IntWritable(1);

	public void map(LongWritable key, Text value, OutputCollector <Text, IntWritable> output, Reporter reporter) throws IOException {

		String valueString = value.toString();
		String[] SingleCountryData = valueString.split(",");
		output.collect(new Text(SingleCountryData[7]), one);
	}
}
SalesCountryReducer.java
package SalesCountry;

import java.io.IOException;
import java.util.*;

import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapred.*;

public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {

	public void reduce(Text t_key, Iterator<IntWritable> values, OutputCollector<Text,IntWritable> output, Reporter reporter) throws IOException {
		Text key = t_key;
		int frequencyForCountry = 0;
		while (values.hasNext()) {
			// replace type of value with the actual type of our value
			IntWritable value = (IntWritable) values.next();
			frequencyForCountry += value.get();

		}
		output.collect(key, new IntWritable(frequencyForCountry));
	}
}
SalesCountryDriver.java
package SalesCountry;

import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.*;
import org.apache.hadoop.mapred.*;

public class SalesCountryDriver {
    public static void main(String[] args) {
        JobClient my_client = new JobClient();
        // Create a configuration object for the job
        JobConf job_conf = new JobConf(SalesCountryDriver.class);

        // Set a name of the Job
        job_conf.setJobName("SalePerCountry");

        // Specify data type of output key and value
        job_conf.setOutputKeyClass(Text.class);
        job_conf.setOutputValueClass(IntWritable.class);

        // Specify names of Mapper and Reducer Class
        job_conf.setMapperClass(SalesCountry.SalesMapper.class);
        job_conf.setReducerClass(SalesCountry.SalesCountryReducer.class);

        // Specify formats of the data type of Input and output
        job_conf.setInputFormat(TextInputFormat.class);
        job_conf.setOutputFormat(TextOutputFormat.class);

        // Set input and output directories using command line arguments,
        //arg[0] = name of input directory on HDFS, and arg[1] =  name of output directory to be created to store the output file.

        FileInputFormat.setInputPaths(job_conf, new Path(args[0]));
        FileOutputFormat.setOutputPath(job_conf, new Path(args[1]));

        my_client.setConf(job_conf);
        try {
            // Run the job
            JobClient.runJob(job_conf);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
Arşiv, burada gösterildiği gibi aynı üç kaynak dosyasına genişliyor.
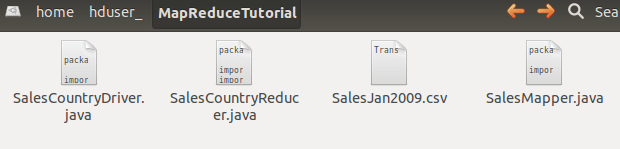
Tüm bu dosyaların dosya izinlerini kontrol edin

'Okuma' izinleri eksikse, bunları verin:

Adım 2) Hadoop sınıf yolunu dışa aktarın
Aşağıdaki Hadoop örneğinde gösterildiği gibi sınıf yolunu dışa aktarın.
export CLASSPATH="$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-core-2.2.0.jar:$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-common-2.2.0.jar:$HADOOP_HOME/share/hadoop/common/hadoop-common-2.2.0.jar:~/MapReduceTutorial/SalesCountry/*:$HADOOP_HOME/lib/*"
Dışa aktarılan sınıf yolu komut isteminde geri yansıtılır.

Adım 3) Derleyin Java Dosyaları
Derleyin Java Bu dosyalar Final-MapReduceHandsOn dizininde bulunmaktadır. Sınıf dosyaları ise paket dizinine yerleştirilecektir.
javac -d . SalesMapper.java SalesCountryReducer.java SalesCountryDriver.java
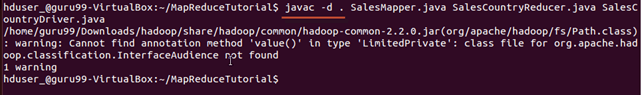
Bu uyarı güvenle göz ardı edilebilir; yalnızca mapred API'sinin kullanım dışı bırakıldığını bildirmektedir.
Bu derleme, geçerli dizinde belirtilen paket adıyla adlandırılmış bir dizin oluşturacaktır. Java Kaynak dosyayı (bizim durumumuzda SalesCountry) bulun ve derlenmiş tüm sınıf dosyalarını içine yerleştirin.

Adım 4) Bildirim dosyasını oluşturun
Manifest.txt adında yeni bir dosya oluşturun.
sudo gedit Manifest.txt
Şu satırı ekleyin:
Main-Class: SalesCountry.SalesCountryDriver

SalesCountry.SalesCountryDriver, ana sınıfın adıdır. Lütfen bu satırın sonunda Enter tuşuna basmanız gerektiğini unutmayın.
Adım 5) Sınıfları bir kavanoza paketleyin.
Jar dosyası oluştur
jar cfm ProductSalePerCountry.jar Manifest.txt SalesCountry/*.class

Jar dosyasının oluşturulduğunu kontrol edin

Adım 6) Hadoop'u Başlatın
Hadoop'u başlat
$HADOOP_HOME/sbin/start-dfs.sh
$HADOOP_HOME/sbin/start-yarn.sh
Adım 7) Giriş dosyasını HDFS'ye kopyalayın.
SalesJan2009.csv dosyasını ~/inputMapReduce klasörüne kopyalayın.
Şimdi aşağıdaki komutu kullanarak ~/inputMapReduce dosyasını HDFS'ye kopyalayın.
$HADOOP_HOME/bin/hdfs dfs -copyFromLocal ~/inputMapReduce /
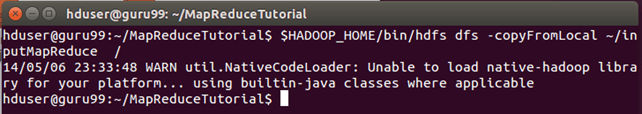
Bu uyarıyı rahatlıkla göz ardı edebiliriz.
Bir dosyanın gerçekten kopyalanıp kopyalanmadığını doğrulayın.
$HADOOP_HOME/bin/hdfs dfs -ls /inputMapReduce

Adım 8) MapReduce işini çalıştırın
MapReduce işini çalıştır
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales

Bu, üzerinde mapreduce_output_sales adında bir çıktı dizini oluşturacaktır. HDFS. Bu dizinin içeriği ülkelere göre ürün satışlarını içeren bir dosya olacaktır.
Adım 9) Sonuçları okuyun
Sonuç, komut arayüzü üzerinden şu şekilde görülebilir:
$HADOOP_HOME/bin/hdfs dfs -cat /mapreduce_output_sales/part-00000
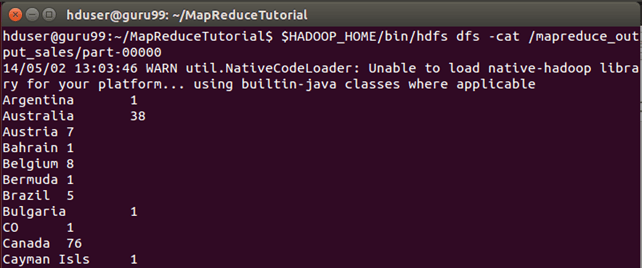
Sonuçlar ayrıca bir web arayüzü aracılığıyla da görülebilir.
Açılış http://localhost:50070/ Bir web tarayıcısında. Hadoop 3.x'te NameNode web arayüzü port numarasına taşındı. 9870, öyleyse kullan http://localhost:9870/ orada yerine.

Şimdi 'Dosya sistemine göz at' seçeneğini seçin ve /mapreduce_output_sales klasörüne gidin.

part-r-00000'i açın

SalesMapper Sınıfının Açıklaması
İşin baştan sona yürütülmesiyle birlikte, sonraki üç bölümde her bir sınıfın aslında ne yaptığı ayrıntılı olarak ele alınacaktır.
Bu bölümde, SalesMapper sınıfının uygulanmasını anlayacağız.
1. Öncelikle sınıfımız için bir paket adı belirtiyoruz. Paketimizin adı SalesCountry. Derleme çıktısı olan SalesMapper.class dosyasının bu paket adıyla adlandırılmış bir dizine kaydedileceğini lütfen unutmayın: SalesCountry.
Bunu takiben kütüphane paketlerini içe aktarıyoruz.
Aşağıdaki ekran görüntüsü SalesMapper sınıfının bir uygulamasını göstermektedir.

Örnek Code Açıklama:
1. SalesMapper Sınıf Tanımı-
public class SalesMapper extends MapReduceBase implements Mapper<LongWritable, Text, Text, IntWritable> {
Her eşleyici sınıfı, MapReduceBase sınıfından türetilmeli ve Mapper arayüzünü uygulamalıdır.
2. 'Harita' fonksiyonunun tanımlanması-
public void map(LongWritable key,
         Text value,
OutputCollector<Text, IntWritable> output,
Reporter reporter) throws IOException
Mapper sınıfının ana kısmı, dört argüman alan 'map()' metodudur.
'map()' metoduna yapılan her çağrıda, bir anahtar-değer çifti (bu kodda 'key' ve 'value') iletilir.
'map()' metodu, argüman olarak aldığı giriş metnini bölerek başlar. Her satırı alanlara ayırır.
String valueString = value.toString();
String[] SingleCountryData = valueString.split(",");
Burada ',' ayırıcı olarak kullanılmıştır.
Bundan sonra, 'SingleCountryData' dizisinin 7. indeksindeki kayıt ve '1' değeri kullanılarak bir çift oluşturulur.
output.collect(new Text(SingleCountryData[7]), one);
Ülke verilerine ihtiyacımız olduğu ve bu verilerin 'SingleCountryData' dizisinde 7. dizinde yer aldığı için 7. dizindeki kaydı seçiyoruz.
Lütfen girdi verilerimizin aşağıdaki formatta olduğunu unutmayın (Ülke 7. sırada, başlangıç noktası 0 olmak üzere):
Transaction_date,Product,Price,Payment_Type,Name,City,State,Country,Account_Created,Last_Login,Latitude,Longitude
Eşleyici (mapper) çıktısı yine bir anahtar-değer çiftidir ve 'OutputCollector'ın 'collect()' yöntemi kullanılarak oluşturulur.
SalesCountryReducer Sınıfının Açıklaması
Bu bölümde, SalesCountryReducer sınıfının uygulanmasını anlayacağız.
1. Öncelikle sınıfımız için bir paket adı belirtiyoruz. Paketimizin adı SalesCountry. Derleme çıktısı olan SalesCountryReducer.class dosyasının, bu paket adıyla adlandırılmış bir dizine kaydedileceğini lütfen unutmayın: SalesCountry.
Bunu takiben kütüphane paketlerini içe aktarıyoruz.
Aşağıdaki ekran görüntüsü, SalesCountryReducer sınıfının bir uygulamasını göstermektedir.
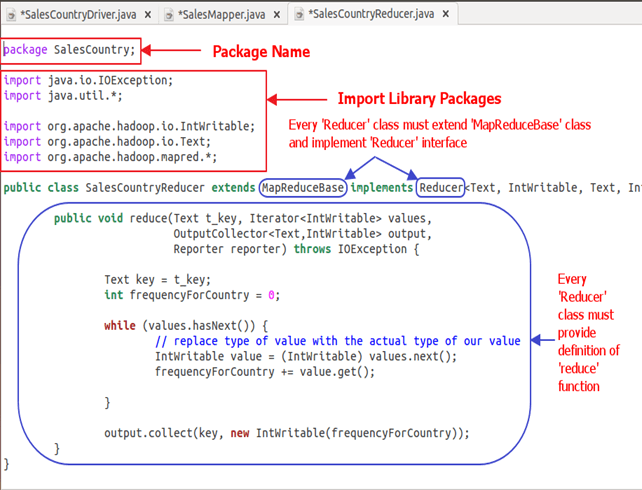
Code Açıklama:
1. SalesCountryReducer Sınıfı Tanımı-
public class SalesCountryReducer extends MapReduceBase implements Reducer<Text, IntWritable, Text, IntWritable> {
Burada, 'Text' ve 'IntWritable' olmak üzere ilk iki veri türü, indirgeyiciye giren anahtar-değer çiftinin veri türüdür.
Eşleyici (mapper) çıktısı şu biçimdedir: , Bu eşleyici çıktısı, indirgeyiciye girdi olarak verilir. Bu nedenle, veri türüyle uyumlu olması için burada Text ve IntWritable veri türleri kullanılmıştır.
Son iki veri türü olan 'Text' ve 'IntWritable', indirgeyici tarafından anahtar-değer çifti şeklinde üretilen çıktının veri türüdür.
Her indirgeyici sınıf, MapReduceBase sınıfından türetilmeli ve Reducer arayüzünü uygulamalıdır.
2. 'Azaltma' fonksiyonunun tanımlanması-
public void reduce( Text t_key,
             Iterator<IntWritable> values,
             OutputCollector<Text,IntWritable> output,
             Reporter reporter) throws IOException {
`reduce()` metoduna girdi olarak, birden fazla değerden oluşan bir liste içeren bir anahtar verilir.
Örneğin bizim durumumuzda şöyle olacak:
, , , , , .
Bu, indirgeyiciye şu şekilde verilir:
Dolayısıyla, bu biçimdeki argümanları kabul etmek için öncelikle Metin ve Yineleyici olmak üzere iki veri türü kullanılır. Metin, anahtar ve yineleyici veri türüdür. Bu, ilgili anahtar için değerlerin listesinin veri türüdür.
Sonraki argüman OutputCollector türündedir. Bu, indirgeyici fazın çıktısını toplar.
`reduce()` metodu, anahtar değeri kopyalayarak ve frekans sayısını 0'a ayarlayarak başlar.
Text key = t_key;int frequencyForCountry = 0;
Ardından, 'while' döngüsünü kullanarak, anahtarla ilişkili değerler listesinde döngü oluşturuyoruz ve tüm değerleri toplayarak nihai frekansı hesaplıyoruz.
 while (values.hasNext()) {
            // replace type of value with the actual type of our value
            IntWritable value = (IntWritable) values.next();
            frequencyForCountry += value.get();

        }
Şimdi, sonucu anahtar ve elde edilen frekans sayısı şeklinde çıktı toplayıcıya iletiyoruz.
Aşağıdaki kod bunu yapar-
output.collect(key, new IntWritable(frequencyForCountry));
SalesCountryDriver Sınıfının Açıklaması
Bu bölümde, SalesCountryDriver sınıfının uygulanmasını anlayacağız.
1. Öncelikle sınıfımız için bir paket adı belirtiyoruz. Paketimizin adı SalesCountry. Derleme çıktısı olan SalesCountryDriver.class dosyasının bu paket adıyla adlandırılmış bir dizine kaydedileceğini lütfen unutmayın: SalesCountry.
Burada, kütüphane paketlerini içe aktarmak için paket adını ve ardından kodu belirten bir satır bulunmaktadır.

2. Yeni bir istemci işi, yapılandırma nesnesi oluşturacak ve Eşleştirici ve Düşürücü sınıflarının tanıtımını yapacak bir sürücü sınıfı tanımlayın.
Sürücü sınıfı, MapReduce işimizin çalışacak şekilde ayarlanmasından sorumludur. Hadoop'unBu sınıfta, iş adını, giriş/çıkış veri türünü ve eşleyici (mapper) ve indirgeyici (reducer) sınıflarının adlarını belirtiriz.

3. Aşağıdaki kod parçacığında, sırasıyla giriş veri kümesini tüketmek ve çıktı üretmek için kullanılan giriş ve çıkış dizinlerini ayarladık.
arg[0] ve arg[1], MapReduce uygulamalı eğitiminde verilen bir komutla birlikte iletilen komut satırı argümanlarıdır, yani;
$HADOOP_HOME/bin/hadoop jar ProductSalePerCountry.jar /inputMapReduce /mapreduce_output_sales
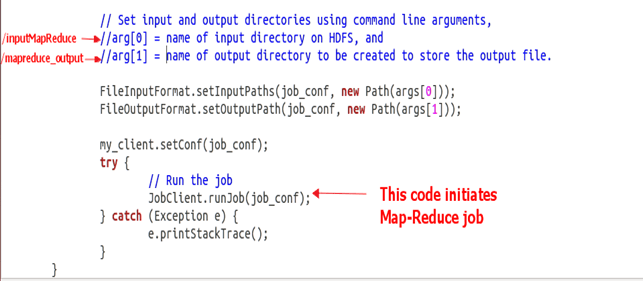
4. İşimizi tetikleyin
Aşağıdaki kod MapReduce işinin yürütülmesini başlatır:
try {
    // Run the job
    JobClient.runJob(job_conf);
} catch (Exception e) {
    e.printStackTrace();
}
