
10 เว็บสแครปฟรีที่ดีที่สุดping เครื่องมือ (2026)
 ทีมบรรณาธิการ
การเปิดเผยข้อมูล: Guruเว็บไซต์ 99 ได้รับการสนับสนุนจากผู้อ่าน เราอาจได้รับค่าคอมมิชชั่นเมื่อคุณซื้อผ่านลิงก์ในหน้านี้ อ่านเพิ่ม
เว็บสแครปping เครื่องมือต่างๆ สามารถช่วยประหยัดเวลาได้หลายชั่วโมง แต่การเลือกที่ไม่ถูกต้องมักจะส่งผลให้ได้ข้อมูลที่ไม่สมบูรณ์ บล็อก IP สิ้นเปลืองเครดิต ซ่อนข้อจำกัดที่สำคัญ และทำให้ผู้เริ่มต้นใช้งานติดอยู่ในแดชบอร์ดที่สับสน ตัวเลือกที่ไม่เสถียรหรือการแสดงผลที่ไม่สม่ำเสมออาจทำให้รายงานเสียหายโดยไม่มีการแจ้งเตือนล่วงหน้า ผู้อ่านมักเปรียบเทียบค่าเผื่อในหัวข้อข่าวโดยมองข้ามต้นทุนการร้องขอ Javaการสนับสนุนสคริปต์ การเก็บรักษาข้อมูล และการควบคุมการปฏิบัติตามข้อกำหนด การตรวจสอบที่ชัดเจนยิ่งขึ้นจะทำให้เห็นข้อดีข้อเสียเหล่านั้น ช่วยจับคู่ขั้นตอนการทำงานแต่ละขั้นตอนกับบริการที่เหมาะสม และเปลี่ยนรายชื่อตัวเลือกที่ไม่แน่นอนให้กลายเป็นขั้นตอนต่อไปที่จัดการได้ง่ายขึ้น
ฉันใช้เวลามากกว่า 55 ชั่วโมงในการค้นคว้าเครื่องมือมากกว่า 18 รายการ ตรวจสอบหน้าผลิตภัณฑ์อย่างเป็นทางการ ข้อจำกัดในการเข้าถึง ขั้นตอนการทำงาน และรูปแบบการรีวิวที่เกิดขึ้นซ้ำๆ การวิจัยเชิงลึกของฉันได้คัดเลือกเครื่องมือ Web Scraper ฟรีที่ดีที่สุด 10 รายการping ตัวเลือกเครื่องมือพร้อมคุณสมบัติ ข้อดีข้อเสีย และรายละเอียดแผนปัจจุบัน คู่มือนี้แยกแผนใช้งานฟรีถาวรออกจากเครดิตทดลองใช้และการทดสอบแบบชำระเงิน เพื่อให้คุณสามารถดำเนินการต่อได้ด้วยความคาดหวังที่ชัดเจนยิ่งขึ้น อ่านเพิ่มเติม ...
Oxylabs เป็นแพลตฟอร์มรวบรวมข้อมูลข่าวกรองทางเว็บชั้นนำของตลาด โดยขับเคลื่อนด้วยมาตรฐานทางธุรกิจ จริยธรรม และการปฏิบัติตามข้อกำหนดสูงสุด ช่วยให้บริษัทต่างๆ ทั่วโลกสามารถปลดล็อกข้อมูลเชิงลึกที่ขับเคลื่อนด้วยข้อมูลได้ นอกจากนี้ยังมีกลไกการลองซ้ำอัตโนมัติที่ช่วยจัดการและหลีกเลี่ยงการบล็อก IP
เว็บไซต์ค้นหาข้อมูลฟรีที่ดีที่สุดping ซอฟต์แวร์และเครื่องมือ
| ชื่อ | ที่ดีที่สุดสำหรับ | Key Features | ใช้งานง่าย | ทดลองฟรี | ลิงค์ |
|---|---|---|---|---|---|
???? Oxylabs |
ตัวอย่างข้อมูลขนาดใหญ่tracการ | อัตราความสำเร็จสูง การกำหนดเป้าหมายทางภูมิศาสตร์ ข้อมูลที่มีโครงสร้าง | ปานกลาง | ไม่จำกัด | เรียนรู้เพิ่มเติม |
 👍 เดโคโด |
การขูดข้อมูลขั้นสูงping โซลูชัน | การหมุนเวียน IP อัตราความสำเร็จสูง การจัดการพร็อกซี | สะดวกสบาย | ทดลองใช้ฟรี 7 วัน | เรียนรู้เพิ่มเติม |
 👍 โนดมาเวน |
บริการพร็อกซีสำหรับที่อยู่อาศัยและมือถือระดับพรีเมียมping | ตัวกรองคุณภาพ IP, เซสชันคงที่ 7 วัน, ครอบคลุมกว่า 190 ประเทศ | สะดวกสบาย | 750MB ในราคา 3.50 ดอลลาร์ | เรียนรู้เพิ่มเติม |
 Webshare |
เครือข่ายพร็อกซีราคาประหยัดสำหรับการสแครปping | IP มากกว่า 80 ล้านรายการ, การกำหนดเป้าหมายตามภูมิศาสตร์, การหมุนเวียน IP | สะดวกสบาย | พร็อกซีฟรี 10 รายการ | เรียนรู้เพิ่มเติม |
 Apify |
นักพัฒนาและผู้ที่ชื่นชอบระบบอัตโนมัติ | ข้อมูลขั้นสูงtracการเรียกใช้ API | ปานกลาง | แผนพื้นฐานฟรีตลอดชีพ | เรียนรู้เพิ่มเติม |
1) Oxylabs
Oxylabs ให้บริการเว็บแบบจัดการ Scraper API สำหรับทีมที่รวบรวมข้อมูลสาธารณะจากเว็บไซต์ที่เข้าถึงยาก API นี้จัดการการกำหนดเส้นทางพร็อกซี การแสดงผลในเบราว์เซอร์ การลองใหม่ และการส่งข้อมูลแบบมีโครงสร้างผ่าน API เดียว ทีมตรวจสอบข้อมูลค้าปลีกสามารถขอหน้าสินค้าในภาษาต่างๆ ได้โดยไม่ต้องดูแลเบราว์เซอร์หลายตัวแยกต่างหาก
แดชบอร์ดของระบบนี้เน้นที่การใช้งาน คำขอ และการควบคุมตัวแยกวิเคราะห์ การค้นหาแบบกลุ่มและการกำหนดเวลาช่วยสนับสนุนงานที่เกิดขึ้นซ้ำๆ ในขณะที่ OxyCopilot ช่วยสร้างคำขอ บริการนี้เหมาะกับปริมาณงานในระดับการผลิตมากกว่าโครงการแบบครั้งเดียว โดยเฉพาะอย่างยิ่งเมื่อการส่งมอบที่คาดการณ์ได้มีความสำคัญมากกว่าการควบคุมกระบวนการทำงานping โครงสร้างพื้นฐานในระดับขนาดใหญ่
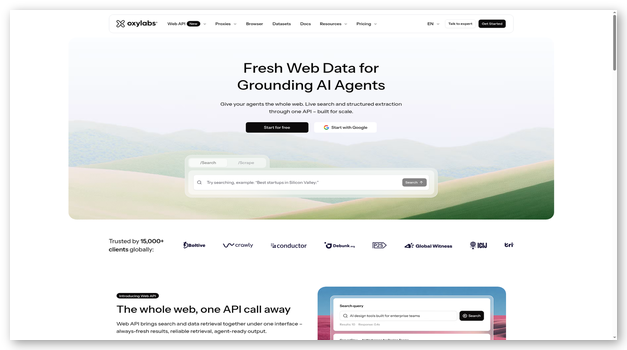
สิ่งอำนวยความสะดวก:
- คำขอที่ได้รับการจัดการ: API จะส่งต่อคำขอผ่านโครงสร้างพื้นฐานที่เหมาะสมและลองใหม่อีกครั้งเมื่อคำขอถูกบล็อก ทีมงานจะได้รับคำตอบที่ใช้งานได้โดยไม่ต้องดูแลรายการพร็อกซีขนาดใหญ่หรือตัวประมวลผลเบราว์เซอร์
- เบราว์เซอร์แบบไม่มีหัว: การโหลดการแสดงผลของเบราว์เซอร์ Javaหน้าเว็บที่มีสคริปต์จำนวนมากก่อน extracสิ่งนี้ช่วยรองรับรายการสินค้าแบบไดนามิก หน้าเว็บท่องเที่ยวแบบโต้ตอบ และเนื้อหาอื่นๆ ที่ไม่มีใน HTML แบบดั้งเดิม
- ตัวแยกวิเคราะห์แบบกำหนดเอง: กฎการแยกวิเคราะห์แบบกำหนดเองจะแปลงหน้าเว็บที่รองรับให้เป็นฟิลด์ที่มีโครงสร้าง นักวิเคราะห์จึงใช้เวลาน้อยลงในการทำความสะอาดมาร์กอัปก่อนที่จะโหลดผลลัพธ์ลงในฐานข้อมูลหรือรายงาน
- แบบสอบถามแบบกลุ่ม: กลุ่มการส่งแบบกลุ่มมีเป้าหมายจำนวนมาก URLรวมทุกอย่างไว้ในขั้นตอนการทำงานเดียว ช่วยลดภาระงานด้านการประสานงานเมื่อทีมต่างๆ ตรวจสอบราคา สินค้าคงคลัง ผลการค้นหา หรือรายการสินค้า
- จัดตารางเวลา: งานที่กำหนดเวลาไว้จะเรียกใช้ชุดข้อมูลซ้ำๆ ในช่วงเวลาที่กำหนด ซึ่งช่วยให้ทีมสามารถอัปเดตชุดข้อมูลได้โดยไม่ต้องพึ่งบริการ cron แยกต่างหากสำหรับแต่ละโปรเจกต์
- การกำหนดเป้าหมายตามภูมิศาสตร์: พารามิเตอร์ตำแหน่งที่ตั้งจะขอข้อมูลจากตลาดที่เลือกไว้ นักวิจัยสามารถเปรียบเทียบราคา ความพร้อมใช้งาน หรือผลการค้นหาในแต่ละภูมิภาคผ่านการเชื่อมต่อ API เดียวกันได้
- ข้อกำหนดการใช้งาน: หน้าแดชบอร์ดแสดงผลลัพธ์การใช้งานและกิจกรรมการร้องขอ ทีมต่างๆ สามารถ tracปริมาณ k ก่อนถึงขีดจำกัดกลายเป็นเรื่องไม่คาดคิดระหว่างการดำเนินการรวบรวมข้อมูลการผลิต
ข้อดี
จุดด้อย
???? วิธีการรับ Oxylabs ฟรี?
- เปิด Oxylabs เว็บ Scraper หน้าแสดงราคา API
- สร้างบัญชีและเลือกทดลองใช้งานฟรีโดยไม่ต้องเพิ่มบัตรเครดิต
- การทดลองนี้รวมถึงผลลัพธ์มากถึง 2,000 รายการสำหรับการคัดกรองที่ได้รับการสนับสนุนping เวิร์กโฟลว์
ทดลองใช้งานฟรี พร้อมผลลัพธ์สูงสุด 2,000 รายการ
2) เดโคโด
เดโคโด ผสานโครงสร้างพื้นฐานพร็อกซีเข้ากับเว็บสแครปping API นี้สร้างขึ้นสำหรับนักพัฒนา นักวิเคราะห์ และเวิร์กโฟลว์ AI มีเอนด์พอยต์สำหรับการดึงข้อมูล ค้นหา สร้างแผนที่ และรวบรวมข้อมูล ครอบคลุมตั้งแต่หน้าเว็บเดียวไปจนถึงการค้นหาหลายหน้า เทมเพลตสำเร็จรูปจะส่งคืนข้อมูลที่มีโครงสร้างสำหรับเป้าหมายทั่วไปโดยไม่จำเป็นต้องใช้ตัวแยกวิเคราะห์แบบกำหนดเอง
หน้าแดชบอร์ดแสดงคีย์ API การตั้งค่าคำขอ การใช้งาน และตัวเลือกผลลัพธ์ Javaการเรนเดอร์สคริปต์และการเลือกพร็อกซีแบบจัดการช่วยรับมือกับหน้าเว็บที่ซับซ้อนขึ้น ในขณะที่เอาต์พุต Markdown รองรับไปป์ไลน์โมเดลภาษา แผนใช้งานฟรีถาวรทำให้ Decodo มีประโยชน์สำหรับการสร้างต้นแบบก่อนที่ทีมจะตัดสินใจรองรับปริมาณคำขอที่สูงขึ้นอย่างน่าเชื่อถือ
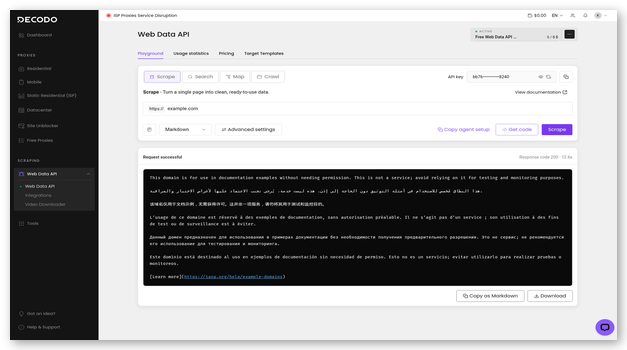
สิ่งอำนวยความสะดวก:
- จุดสิ้นสุดทั้งสี่จุด: ปลายทางสำหรับการขูดข้อมูล ค้นหา สร้างแผนที่ และรวบรวมข้อมูล ครอบคลุมขอบเขตที่เน้นเฉพาะเจาะจงtracการค้นหาและระบุตำแหน่งเว็บไซต์ นักพัฒนาสามารถจัดการงานข้อมูลหลายอย่างไว้ภายใต้คีย์ API เดียวได้
- แม่แบบที่เตรียมไว้: เทมเพลตที่ได้รับการดูแลรักษามากกว่า 100 รายการ ครอบคลุมเว็บไซต์และประเภทข้อมูลทั่วไป ช่วยลดงานการเลือกข้อมูลและเร่งความเร็วโครงการทดสอบแนวคิดเบื้องต้น
- Javaการแสดงผลสคริปต์: การเรนเดอร์แบบเลือกได้จะโหลดเนื้อหาแบบไดนามิกก่อนส่งมอบ ทีมงานสามารถรวบรวมข้อมูลจากหน้าเว็บที่เรนเดอร์บนฝั่งไคลเอนต์ได้โดยไม่ต้องใช้งานคลัสเตอร์เบราว์เซอร์แบบไร้ส่วนหัวของตนเอง
- ผลผลิตที่ยืดหยุ่น: การตอบกลับสามารถรวมถึงข้อมูล HTML, Markdown, JSON, CSV, PNG หรือ XHR (หากรองรับ) แต่ละเวิร์กโฟลว์สามารถเลือกรูปแบบที่พร้อมสำหรับการวิเคราะห์ได้
- การจัดการพร็อกซี: ระบบเลือกพร็อกซีและป้องกันบอทในตัวช่วยลดงานการหมุนเวียนพร็อกซีด้วยตนเอง คำขอสามารถเข้าถึงหน้าเว็บที่มีข้อมูลทางภูมิศาสตร์ได้ ในขณะที่ API จัดการการตัดสินใจด้านโครงสร้างพื้นฐาน
- การเชื่อมต่อ AI: MCP และช่องทางการผสานรวมอื่นๆ นำข้อมูลเว็บปัจจุบันเข้าสู่เครื่องมือ AI ที่รองรับ ซึ่งเหมาะสำหรับนักวิจัยและเวิร์กโฟลว์การค้นหาที่ต้องการแหล่งข้อมูลแบบเรียลไทม์
- การควบคุมคำขอ: ข้อจำกัดด้านอัตราการใช้งานและปริมาณการใช้งานทั้งหมดจะปรากฏอยู่ในแต่ละแพ็กเกจ ทีมงานสามารถกำหนดขนาดโครงการโดยพิจารณาจากปริมาณการรวบรวมข้อมูลแทนที่จะคาดเดาจากแบนด์วิดท์เพียงอย่างเดียว
ข้อดี
จุดด้อย
???? จะรับ Decodo ฟรีได้อย่างไร?
- เยี่ยมชมเว็บไซต์ Decodo's Web Scraping หน้าแสดงราคา API
- สร้างบัญชีฟรีและคัดลอกข้อมูลรับรอง API ที่สร้างขึ้น
- แพ็กเกจฟรีรองรับการรวบรวมข้อมูล 5,000 ครั้ง หรือดึงข้อมูลจากหน้าเว็บ 10,000 หน้าต่อเดือน
แพ็กเกจฟรี ใช้งานได้สูงสุด 10,000 หน้า
3) โหนดมาเวน
โหนดมาเวน เป็นแพลตฟอร์มพร็อกซีสำหรับการขูดข้อมูลping ทีมที่เป็นเจ้าของอดีตอยู่แล้วtracรหัสการใช้งานหรือการทำงานอัตโนมัติของเบราว์เซอร์ ตัวเลือกสำหรับที่อยู่อาศัย มือถือ และ ISP รองรับการเชื่อมต่อ HTTP และ SOCKS5 ครอบคลุมพื้นที่ทางภูมิศาสตร์กว้างขวาง ตัวกรองคุณภาพ IP จะตรวจสอบที่อยู่ก่อนการกำหนดเพื่อลดความล้มเหลวที่หลีกเลี่ยงได้
แดชบอร์ดจะเน้นที่ปริมาณการรับส่งข้อมูล ข้อมูลประจำตัว การกำหนดเป้าหมาย และการตั้งค่าการหมุนเวียน มากกว่าชุดข้อมูลที่แยกวิเคราะห์แล้ว เซสชันแบบคงที่เหมาะสำหรับความต่อเนื่องของบัญชีหรือสถานที่ ในขณะที่การหมุนเวียนต่อคำขอเหมาะสำหรับการรวบรวมข้อมูลในวงกว้าง NodeMaven ทำงานได้ดีที่สุดเมื่อคุณภาพของพร็อกซีและการควบคุมเซสชันมีความสำคัญมากกว่าการรวบรวมข้อมูลสำเร็จรูปping API
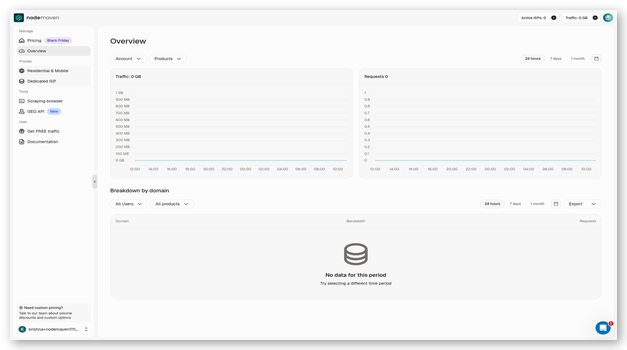
สิ่งอำนวยความสะดวก:
- ตัวกรองคุณภาพ: ตัวกรองคุณภาพ IP จะตรวจสอบที่อยู่ที่มีอยู่ก่อนที่จะกำหนดให้กับผู้ใช้ กลุ่มที่อยู่ IP ที่สะอาดกว่าสามารถลดการลองใหม่ที่สูญเปล่าและ CA ได้PTCการขัดจังหวะของระบบ HA ระหว่างการเก็บข้อมูลเป็นเวลานาน
- ประเภทพร็อกซี: พร็อกซีสำหรับที่อยู่อาศัย มือถือ และ ISP จะอยู่ภายใต้บัญชีเดียวกัน ทีมงานสามารถจับคู่ชื่อเสียง ความเสถียร และต้นทุนให้กับแต่ละพร็อกซีได้ping เป้า
- ปุ่มควบคุมการหมุน: การเชื่อมต่อสามารถสลับไปมาระหว่างคำขอต่างๆ หรือคงอยู่ได้นานในเซสชันที่ยาวนาน ซึ่งรองรับทั้งการรวบรวมข้อมูลขนาดใหญ่และเวิร์กโฟลว์ที่ต้องการข้อมูลประจำตัวที่สม่ำเสมอ
- การกำหนดเป้าหมายตามภูมิศาสตร์: การควบคุมโดยประเทศ เมือง และผู้ให้บริการอินเทอร์เน็ต ช่วยจำกัดตำแหน่งทางออก นักวิจัยสามารถรวบรวมข้อมูลราคา โฆษณา ผลการค้นหา หรือข้อมูลความพร้อมใช้งานในระดับท้องถิ่นได้
- การสนับสนุนโปรโตคอล: การรองรับ HTTP และ SOCKS5 สามารถใช้งานร่วมกับสคริปต์และเครื่องมืออัตโนมัติทั่วไปได้ โปรแกรมรวบรวมข้อมูลที่มีอยู่สามารถเชื่อมต่อได้โดยไม่ต้องเปลี่ยนแปลงการตั้งค่าเดิมtracตรรกะเชิงทฤษฎี
- การจราจรติดขัด: ปริมาณการใช้งานที่ไม่ได้ใช้สามารถโอนไปยังรอบการเรียกเก็บเงินถัดไปได้ภายใต้แผนปัจจุบัน ซึ่งจะช่วยให้โครงการที่มีตารางการเรียกเก็บเงินรายเดือนไม่สม่ำเสมอสามารถรักษาปริมาณการใช้งานที่ซื้อไว้ได้
- แดชบอร์ดแสดงการใช้งาน: รายละเอียดปริมาณการใช้งานและการเชื่อมต่อจะปรากฏในแดชบอร์ดบัญชี ทีมสามารถตรวจสอบปริมาณการใช้งานและปรับการหมุนเวียนก่อนที่การใช้งานจะหมดโควต้า
ข้อดี
จุดด้อย
???? จะดาวน์โหลด NodeMaven มาใช้ฟรีได้อย่างไร?
- เข้าไปที่หน้าแสดงราคาของ NodeMaven แล้วสร้างบัญชีผู้ใช้
- เลือกทดลองใช้งานสำหรับการเข้าถึงพร็อกซีที่บ้านและบนมือถือ
- แพ็กเกจทดลองใช้แบบเสียค่าใช้จ่ายมีราคา 3.50 ดอลลาร์สหรัฐ และรวมแบนด์วิดท์ 750 เมกะไบต์
ทดลองใช้ฟรี 750 MB ในราคา 3.50 ดอลลาร์
4) Webshare
Webshare ให้บริการการเชื่อมต่อพร็อกซีศูนย์ข้อมูล ที่อยู่อาศัย และ ISP สำหรับสคริปต์ โปรแกรมรวบรวมข้อมูล และการทำงานอัตโนมัติของเบราว์เซอร์ แผนบริการฟรีถาวรให้สิทธิ์โครงการขนาดเล็กใช้งานพร็อกซีศูนย์ข้อมูลได้ 10 ตัว และปริมาณแบนด์วิดท์รายเดือน ผู้ใช้สามารถยืนยันตัวตนผ่านข้อมูลประจำตัวหรือที่อยู่ IP ที่ได้รับอนุมัติ
หน้าแดชบอร์ดแสดงรายการพร็อกซี รายละเอียดการเชื่อมต่อ การใช้งาน และการเข้าถึง API ในที่เดียว ตัวควบคุมการหมุนเวียนช่วยกระจายคำขอ ในขณะที่ตัวกรองตำแหน่งช่วยสนับสนุนการรวบรวมข้อมูลตามภูมิภาค Webshare เหมาะสำหรับผู้เรียนและงานที่ไม่ซับซ้อนซึ่งต้องการการเข้าถึงพร็อกซีที่เชื่อถือได้ แม้ว่าจะไม่สามารถทดแทนตัวแยกวิเคราะห์หรือการคัดลอกข้อมูลทั้งหมดได้ก็ตามping เวิร์กโฟลว์
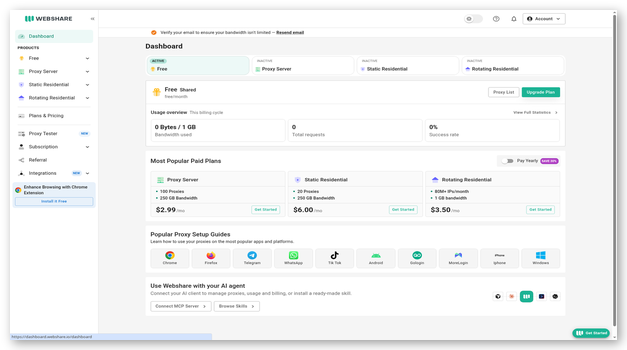
สิ่งอำนวยความสะดวก:
- พร็อกซีฟรี: แพ็กเกจฟรีถาวรประกอบด้วยพร็อกซีศูนย์ข้อมูล 10 ตัว และปริมาณการใช้งานรายเดือน 1 GB สามารถทดลองใช้งานขนาดเล็กได้อย่างต่อเนื่องโดยไม่มีระยะเวลาทดลองใช้หมดอายุ
- ตัวเลือกตัวแทน: ตัวเลือกแบบชำระเงินครอบคลุมการเชื่อมต่อศูนย์ข้อมูล ที่อยู่อาศัย และผู้ให้บริการอินเทอร์เน็ต ทีมสามารถเลือกกลุ่มการเชื่อมต่อตามระดับความยาก ความเสถียร และงบประมาณที่ต้องการได้
- การหมุน: การหมุนเวียนปลายทางจะเปลี่ยนที่อยู่โดยอัตโนมัติสำหรับแผนบริการที่รองรับ ซึ่งจะช่วยลดการบำรุงรักษาลิสต์พร็อกซีด้วยตนเองสำหรับชุดคำขอขนาดใหญ่หรือคำขอที่มีการใช้งานซ้ำบ่อยครั้ง
- การควบคุมตามภูมิศาสตร์: ตัวกรองตามสถานที่ตั้งช่วยจัดเส้นทางการร้องขอไปยังประเทศหรือภูมิภาคที่เกี่ยวข้อง นักวิจัยตลาดสามารถเปรียบเทียบเนื้อหาที่ปรับให้เข้ากับแต่ละท้องถิ่นโดยใช้ขั้นตอนการเชื่อมต่อเดียวกันได้
- การเข้าถึง API: API นี้แสดงรายละเอียดพร็อกซีและการดำเนินการบัญชีสำหรับการทำงานอัตโนมัติ นักพัฒนาสามารถกำหนดค่าหรือเรียกใช้การเชื่อมต่อได้โดยไม่ต้องคัดลอกรายการจากแดชบอร์ด
- รับรองความถูกต้อง: การระบุชื่อผู้ใช้และการอนุญาตด้วยที่อยู่ IP รองรับรูปแบบการใช้งานที่หลากหลาย ทีมงานสามารถรักษาความปลอดภัยในการเข้าถึงเซิร์ฟเวอร์ แล็ปท็อป หรือสแครปบุ๊คแบบกระจายได้ping แรงงาน
- การใช้ tracกษัตริย์: ตัวชี้วัดบนแดชบอร์ดแสดงแบนด์วิดท์และกิจกรรมของพร็อกซี ผู้ใช้สามารถตรวจจับขีดจำกัดที่ใกล้เข้ามาได้ก่อนที่โปรแกรมรวบรวมข้อมูลจะหยุดทำงานระหว่างการรวบรวมข้อมูลที่สำคัญ
ข้อดี
จุดด้อย
???? วิธีการรับ Webshare ฟรี?
- จุดเปิด Webshare และลงทะเบียนบัญชีฟรีโดยไม่ต้องใช้บัตร
- เข้าไปดูรายชื่อพร็อกซีเพื่อดูรายละเอียดการเชื่อมต่อที่ได้รับมอบหมาย
- แพ็กเกจฟรีประกอบด้วยพร็อกซีศูนย์ข้อมูล 10 ตัว และอินเทอร์เน็ต 1 GB ต่อเดือน
พร็อกซีฟรี 10 ตัว และแรม 1 GB ต่อเดือน
5) Apify
Apify Crawlee เป็นแพลตฟอร์มบนคลาวด์สำหรับเรียกใช้โปรแกรมดึงข้อมูล (Scraper) ที่สามารถนำกลับมาใช้ซ้ำได้ เรียกว่า Actors โดยมี Store สาธารณะที่ครอบคลุมเว็บไซต์ทั่วไป ในขณะที่นักพัฒนาสามารถสร้าง Actors แบบกำหนดเองได้ด้วย Crawlee หรือเครื่องมืออื่นๆ ที่รองรับ การกำหนดเวลา ชุดข้อมูล คิว และ Webhooks จะเปลี่ยนการทำงานแต่ละครั้งให้เป็นเวิร์กโฟลว์ข้อมูลที่ทำซ้ำได้
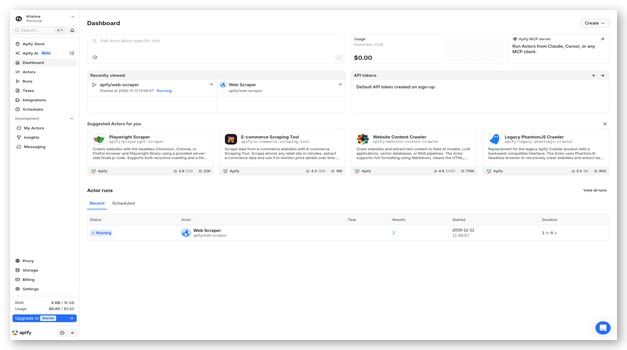
หน้าจอคอนโซลแสดงข้อมูลขาเข้า บันทึกการทำงาน พื้นที่จัดเก็บ ค่าใช้จ่าย และผลลัพธ์สำหรับแต่ละ Actor ทีมสามารถส่งออกบันทึกหรือเชื่อมต่อผ่าน API ได้ Apify แพลตฟอร์มนี้มีความยืดหยุ่นสูง แม้ว่าคุณภาพในตลาดและค่าใช้จ่ายในการใช้งานจะแตกต่างกันไป เหมาะสำหรับผู้ใช้ที่ต้องการทั้งโปรแกรมดึงข้อมูลสำเร็จรูปและแพลตฟอร์มการทำงานอัตโนมัติที่สามารถตั้งโปรแกรมได้
สิ่งอำนวยความสะดวก:
- ร้านค้าของนักแสดง: ร้านค้าแห่งนี้มีตัวดึงข้อมูลสำเร็จรูปสำหรับเว็บไซต์และงานทั่วไปมากมาย ผู้ใช้สามารถเริ่มต้นใช้งาน Actor ที่มีอยู่แล้วแทนที่จะเขียนโค้ดตัวดึงข้อมูลแต่ละตัวใหม่ทั้งหมด
- นักแสดงที่กำหนดเอง: นักพัฒนาสามารถบรรจุโค้ดที่สร้างขึ้นเองได้ping ตรรกะในรูปแบบของ Actor ที่สามารถนำกลับมาใช้ซ้ำได้ การกำหนดเวอร์ชันของอินพุตและการสร้างทำให้เวิร์กโฟลว์เดียวกันสามารถเรียกใช้ซ้ำได้ง่ายขึ้น
- กำหนดการ: ตารางเวลาในตัวจะเรียกใช้งาน Actor ในเวลาหรือช่วงเวลาที่เลือกไว้ การตรวจสอบราคา รายการ หรือเนื้อหาที่เกิดขึ้นซ้ำๆ สามารถทำงานได้โดยไม่ต้องใช้ตัวกำหนดเวลาภายนอก
- การจัดเก็บข้อมูล: ชุดข้อมูล ที่เก็บข้อมูลแบบคีย์-ค่า และคิวคำขอจะจัดระเบียบผลลัพธ์และสถานะการรวบรวมข้อมูล การทำงานแต่ละครั้งจะเก็บรักษาบันทึกไว้เพื่อให้สามารถเข้าถึงได้สำหรับการส่งออกหรือการประมวลผลในขั้นตอนถัดไป
- integrations: API, เว็บฮุค และตัวเชื่อมต่อจะส่งผลลัพธ์ไปยังระบบอื่นๆ ทีมสามารถเรียกใช้งานขั้นตอนต่อไปได้หลังจากที่การทำงานสำเร็จหรือล้มเหลว
- ตัวเลือกพร็อกซี: แพลตฟอร์มนี้มีบริการพร็อกซีทั้งแบบดาต้าเซ็นเตอร์และแบบที่อยู่อาศัย ผู้ใช้งานสามารถสลับการเชื่อมต่อได้โดยไม่ต้องมีผู้ให้บริการพร็อกซีที่จัดการแยกต่างหาก
- ดำเนินการตรวจสอบ: บันทึกการทำงาน สถานะ การใช้งานทรัพยากร และค่าใช้จ่ายจะปรากฏขึ้นสำหรับการทำงานแต่ละครั้ง นักพัฒนาสามารถวินิจฉัยข้อผิดพลาดและประเมินทรัพยากรที่งานที่เกิดขึ้นซ้ำๆ ใช้ได้
ข้อดี
จุดด้อย
???? วิธีการรับ Apify ฟรี?
- เยี่ยมชมร้านค้า Apifyเข้าไปที่หน้าแสดงราคาของเว็บไซต์ และเลือกแพ็กเกจฟรี
- สร้างบัญชีโดยไม่ต้องป้อนข้อมูลบัตรชำระเงิน
- แพ็กเกจจะต่ออายุโดยอัตโนมัติพร้อมเครดิตรายเดือน 5 ดอลลาร์ และสามารถใช้งานพร้อมกันได้ 5 ครั้ง
เครดิตฟรี 5 ดอลลาร์ต่อเดือน
6) Novada
Novada กลุ่ม ก Scraper API, Web Unblocker และ Browser API อยู่ภายใต้เครดิตเดียว Scraper API จะส่งคืนเรคอร์ดที่มีโครงสร้างสำหรับเป้าหมายที่รองรับ ในขณะที่ Browser API จะจัดการข้อมูลแบบโต้ตอบ Javaสร้างสคริปต์หน้าเว็บผ่านโปรโตคอลการทำงานอัตโนมัติที่คุ้นเคย การควบคุมป้องกันบอทแบบจัดการได้ช่วยลดภาระงานด้านโครงสร้างพื้นฐาน
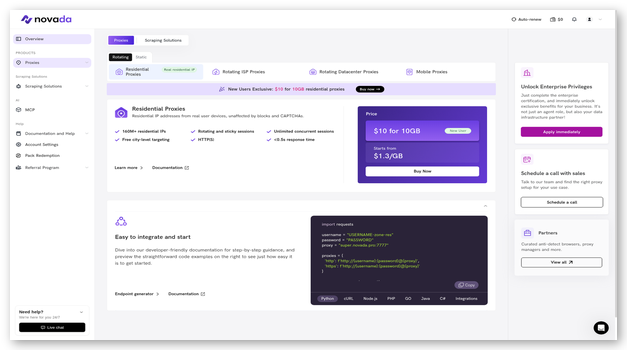
แผงควบคุมของมัน tracการใช้งานผลิตภัณฑ์ ks, โดเมน, เครดิต และคำขอพร้อมกัน การเรียกเก็บเงินแบบรวมศูนย์ช่วยให้ทีมสามารถสลับวิธีการได้โดยไม่ต้องสมัครสมาชิกแยกต่างหาก Novada มีประโยชน์สำหรับตัวอย่างผสมtracการใช้งานตามความต้องการ แต่การเข้าใช้งานช่วงทดลองใช้ต้องได้รับการอนุมัติจากการแชร์แคมเปญและการสนับสนุน เครดิตที่ซื้อจะหมดอายุหลังจากระยะเวลาที่ระบุไว้
สิ่งอำนวยความสะดวก:
- Scraper ไฟ: การขอ Scraper API ส่งคืนข้อมูลที่ทำความสะอาดแล้วสำหรับเป้าหมายการค้นหา การค้า และโซเชียลมีเดียที่รองรับ ทีมงานสามารถข้ามขั้นตอนการวิเคราะห์ HTML ส่วนใหญ่ไปได้
- ตัวปลดบล็อกเว็บ: Web Unblocker ส่งคืนหน้าเว็บแบบดิบๆ พร้อมจัดการกับอุปสรรคการเข้าถึงทั่วไป เหมาะสำหรับทีมที่ต้องการรักษาตรรกะการวิเคราะห์ข้อมูลของตนเองไว้
- API ของเบราว์เซอร์: เบราว์เซอร์บนคลาวด์รองรับการเชื่อมต่อแบบ Puppeteer และ Playwright นักพัฒนาสามารถแสดงผลหน้าเว็บ คลิกองค์ประกอบ เลื่อน และจับภาพเนื้อหาแบบโต้ตอบที่ซับซ้อนได้
- เครดิตรวม: เครื่องชั่งหนึ่งเครื่องครอบคลุมเศษวัสดุpingรวมถึงการปลดบล็อก และผลิตภัณฑ์เบราว์เซอร์ ทีมสามารถเปลี่ยนวิธีการได้โดยไม่ต้องซื้อโควต้าแยกต่างหากสำหรับแต่ละบริการ
- การเรียกเก็บเงินเมื่อสำเร็จ: Novada จะหักเครดิตเมื่อคำขอส่งข้อมูลกลับมาตามกฎที่เผยแพร่ไว้ คำขอจากแพลตฟอร์มที่ล้มเหลวจะไม่หักยอดคงเหลือดังกล่าว
- เอาท์พุตแบบมีโครงสร้าง: เทมเพลตที่รองรับจะให้ข้อมูลในรูปแบบ JSON หรือ CSV แทนที่จะเป็นข้อมูลมาร์กอัปดิบ นักวิเคราะห์สามารถโหลดผลลัพธ์ลงในรายงานได้โดยไม่ต้องทำการแก้ไขมากนัก
- การควบคุมการทำงานพร้อมกัน: ระดับแผนการใช้งานจะกำหนดความสามารถในการร้องขอแบบขนานสำหรับแต่ละผลิตภัณฑ์ ทีมสามารถเลือกโควต้าที่เหมาะสมกับปริมาณการใช้งานของโปรแกรมรวบรวมข้อมูลและเวลาตอบสนองที่คาดหวังได้
ข้อดี
จุดด้อย
???? วิธีการรับ Novaได้ฟรีไหม?
- สร้าง Novaสร้างบัญชี da และเปิดหน้าแคมเปญทดลองใช้ฟรี
- แชร์แคมเปญนี้กับสามกลุ่ม จากนั้นส่งภาพหน้าจอให้ฝ่ายสนับสนุน
- หลังจากได้รับการอนุมัติแล้ว Novada เพิ่มเครดิต 15 ดอลลาร์สำหรับพร็อกซีและสแครปping tools.
เครดิตทดลองใช้ 15 ดอลลาร์
7) Bright Data
Bright Data นำเสนอเว็บที่สร้างไว้ล่วงหน้า Scraper API, Scraping เบราว์เซอร์ Scraper สตูดิโอ, พร็อกซี และชุดข้อมูล ทีมสามารถเลือกบันทึกที่มีโครงสร้างหรือควบคุมเบราว์เซอร์ระยะไกลด้วย Playwright และ Puppeteer การจัดการการเข้าถึงในตัวจะจัดการการหมุนเวียน ลายนิ้วมือของเบราว์เซอร์ และการตรวจสอบสิทธิ์การเข้าถึง
แผงควบคุมแยกส่วนผลิตภัณฑ์ ข้อมูลประจำตัว การใช้งาน ตัวเก็บรวบรวม และการตั้งค่าการส่งมอบ API ที่สร้างไว้ล่วงหน้าช่วยลดการบำรุงรักษาบนเป้าหมายที่รองรับ ในขณะที่การเข้าถึงผ่านเบราว์เซอร์จะจัดการการโต้ตอบแบบกำหนดเอง Bright Data เหมาะสำหรับโครงการขนาดใหญ่ที่ต้องการการครอบคลุมและการสนับสนุนที่กว้างขวาง แคตตาล็อกผลิตภัณฑ์ขนาดใหญ่และตัวเลือกสำหรับองค์กรอาจดูมากเกินไปสำหรับการใช้งานส่วนบุคคลทั่วไปping.
สิ่งอำนวยความสะดวก:
- Scraper APIs: API ที่สร้างไว้ล่วงหน้าจะส่งคืนข้อมูลที่มีโครงสร้างสำหรับเว็บไซต์และหมวดหมู่ที่รองรับ ทีมงานจึงไม่ต้องดูแลรักษาตัวเลือกและตรรกะของเบราว์เซอร์สำหรับทุกการเปลี่ยนแปลงเป้าหมาย
- สคราping เบราว์เซอร์: เบราว์เซอร์ที่โฮสต์จะเชื่อมต่อผ่าน Playwright หรือ Puppeteer นักพัฒนาสามารถเรียกใช้งานได้ Javaเขียนสคริปต์และทำให้การโต้ตอบเป็นไปโดยอัตโนมัติในขณะที่ Bright Data จัดการโครงสร้างพื้นฐานการเข้าถึง
- Scraper สตูดิโอ: เครื่องมือในสตูดิโอช่วยในการสร้างและใช้งานตัวเก็บรวบรวมข้อมูลแบบกำหนดเอง ตัวเลือกแบบภาพและแบบใช้ AI ช่วยลดเวลาในการตั้งค่าสำหรับเป้าหมายที่ไม่มี API ที่เตรียมไว้
- เครือข่ายพร็อกซี: บริการพร็อกซีแบบบูรณาการครอบคลุมประเภทการเชื่อมต่อและตำแหน่งที่ตั้งที่หลากหลาย เวิร์กโฟลว์สามารถกำหนดเส้นทางการรับส่งข้อมูลได้โดยไม่ต้องย้ายข้อมูลประจำตัวระหว่างผู้ให้บริการหลายราย
- ตัวเลือกการจัดส่ง: ข้อมูลที่รวบรวมได้สามารถส่งผ่าน API, Webhook หรือปลายทางบนคลาวด์ที่รองรับได้ ทีมงานสามารถป้อนข้อมูลไปยังคลังข้อมูลและไปป์ไลน์การวิเคราะห์ที่มีอยู่หลังจากแต่ละรอบการทำงาน
- การควบคุมการใช้จ่าย: ตัวเลือกการชำระเงินตามการใช้งานและวงเงินรายเดือนช่วยจัดการการใช้พลังงาน มุมมองการใช้งานบนแดชบอร์ดแสดงให้เห็นว่าอุปกรณ์เก็บข้อมูลส่งผลกระทบต่องบประมาณโครงการอย่างไร
- บันทึกข้อมูลฟรี: เว็บ Scraper แพ็กเกจ API ฟรี ครอบคลุม 5,000 รายการต่อเดือน ไม่จำเป็นต้องใช้บัตรชำระเงินในการเริ่มต้นใช้งานแพ็กเกจนี้
ข้อดี
จุดด้อย
???? วิธีการรับ Bright Data ฟรี?
- จุดเปิด Bright Dataเว็บของ Scraper หน้าแสดงราคา API
- เลือก "เริ่มต้นใช้งานฟรี" และลงทะเบียนโดยไม่ต้องใส่หมายเลขบัตรชำระเงิน
- แพ็กเกจฟรีมีเว็บเบราว์เซอร์ให้ใช้งาน 5,000 เว็บ Scraper API บันทึกข้อมูลทุกเดือน
เยี่ยมชมร้านค้า Bright Data >>
มีฐานข้อมูลฟรี 5,000 รายการต่อเดือน
8) PrivateProxy
PrivateProxy ให้บริการแพ็กเกจพร็อกซีแบบคงที่และแบบหมุนเวียนสำหรับสคริปต์และการทำงานอัตโนมัติของเบราว์เซอร์ การทดลองใช้แบบคงที่สำหรับที่อยู่ IP ในบ้านและศูนย์ข้อมูลช่วยให้ผู้ใช้ทดสอบที่อยู่หนึ่งแห่งก่อนตัดสินใจใช้งานจริง ในขณะที่แผนแบบหมุนเวียนที่ต้องชำระเงินจะครอบคลุมปริมาณการใช้งานตามคำขอหรือตามแบนด์วิดท์ การเชื่อมต่อรองรับรูปแบบการตรวจสอบสิทธิ์ทั่วไป
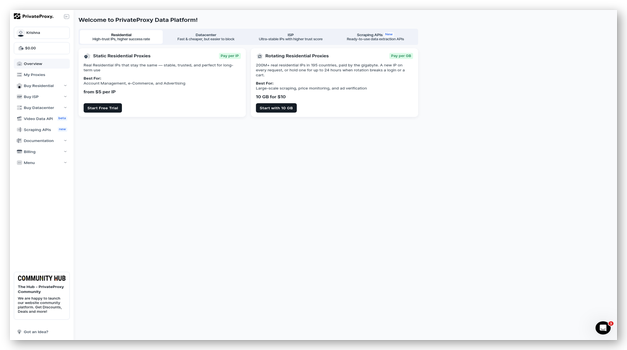
ส่วนบัญชีผู้ใช้จะเน้นที่แพ็กเกจ สถานที่ ข้อมูลประจำตัว การใช้งาน และสถานะการสมัครสมาชิก ตัวเลือกแบบคงที่เหมาะสำหรับงานที่ต้องการที่อยู่สม่ำเสมอ ในขณะที่บริการแบบหมุนเวียนเหมาะสำหรับงานรวบรวมข้อมูลในวงกว้างกว่า PrivateProxy เป็นส่วนประกอบโครงสร้างพื้นฐานมากกว่าจะเป็นโปรแกรมดึงข้อมูลโดยสมบูรณ์ ดังนั้นทีมงานจึงต้องจัดหาส่วนประกอบอื่นๆ เพิ่มเติมtracตรรกะการดำเนินการ การลองใหม่ การจัดเก็บ และการตรวจสอบความถูกต้องของข้อมูล
สิ่งอำนวยความสะดวก:
- พร็อกซีแบบคงที่: ตัวเลือกศูนย์ข้อมูลและผู้ให้บริการอินเทอร์เน็ตแบบคงที่ จะใช้ที่อยู่เดียวตลอดระยะเวลาการสมัครใช้งาน เหมาะสำหรับเซสชันที่ต้องการความต่อเนื่องหรือการเข้าถึงที่ได้รับอนุญาต
- การเข้าออกแบบหมุนเวียน: การหมุนเวียนแพ็กเกจจะเปลี่ยนที่อยู่ระหว่างการร้องขอหรือเซสชันต่างๆ ซึ่งสามารถกระจายปริมาณการใช้งานของโปรแกรมรวบรวมข้อมูลได้โดยไม่ต้องดูแลรายการพร็อกซีในเครื่องแยกต่างหาก
- ตัวเลือกการทดลอง: แพ็กเกจแบบคงที่บางรายการมีบริการทดลองใช้ฟรี 2 วัน โดยต้องยืนยันบัตรเครดิต ส่วนแพ็กเกจทดลองใช้แบบหมุนเวียนจะคิดราคาโปรโมชั่นในรอบแรก
- รับรองความถูกต้อง: การตรวจสอบสิทธิ์ด้วยชื่อผู้ใช้และที่อยู่ IP รองรับการใช้งานเซิร์ฟเวอร์ทั่วไป ทีมงานสามารถเลือกวิธีการที่เหมาะสมที่สุดกับสภาพแวดล้อมของโปรแกรมรวบรวมข้อมูลได้
- การเลือกสถานที่: แพ็กเกจที่มีให้เลือกนั้นมีตัวเลือกภูมิภาคให้เลือกในระหว่างการสั่งซื้อ ผู้ใช้สามารถเลือกตำแหน่งที่ตั้งของพร็อกซีให้ตรงกับตลาดหรือเว็บไซต์ที่กำลังศึกษาได้
- การควบคุมการสมัครสมาชิก: หน้าแดชบอร์ดแสดงแพ็กเกจที่ใช้งานอยู่และสถานะการต่ออายุ ผู้ใช้ทดลองใช้สามารถยกเลิกก่อนการต่ออายุเพื่อหลีกเลี่ยงค่าบริการรายเดือนที่แสดงไว้
- การสนับสนุนโปรโตคอล: การเชื่อมต่อ HTTP, HTTPS และ SOCKS ครอบคลุมการเก็บข้อมูลหลายประเภทping ไลบรารีและเบราว์เซอร์ เครื่องมือที่มีอยู่สามารถเชื่อมต่อได้โดยไม่ต้องใช้ซอฟต์แวร์เฉพาะของผู้จำหน่ายtracSDK ของ tion
ข้อดี
จุดด้อย
???? วิธีการรับ PrivateProxy ฟรี?
- จุดเปิด PrivateProxyเข้าไปที่หน้าช่วยเหลือของเว็บไซต์ และเลือกเวอร์ชันทดลองใช้งานแบบคงที่ที่เหมาะสม
- เลือกรายละเอียดสถานที่และเพิ่มบัตรเพื่อยืนยันตัวตน
- การทดลองใช้ฟรีมีระยะเวลาสองวันและจะต่ออายุโดยอัตโนมัติหากไม่ยกเลิกทันที
เยี่ยมชมร้านค้า PrivateProxy >>
ทดลองใช้ฟรี 2 วัน
9) ScraperAPI
ScraperAPI ช่วยให้นักพัฒนาสามารถดึงข้อมูลหน้าเว็บผ่านกลุ่มพร็อกซีที่ได้รับการจัดการได้จากจุดเชื่อมต่อเดียว โดยจะจัดการการหมุนเวียนที่อยู่ การลองใหม่โดยอัตโนมัติ และ CA (Certificate Authority)PTCHA, การกำหนดเป้าหมายตามภูมิศาสตร์ และตัวเลือกเพิ่มเติม Javaการเรนเดอร์สคริปต์ ปลายทางที่มีโครงสร้างครอบคลุมเป้าหมายทางการค้าและการค้นหาที่เลือกไว้ ในขณะที่ API แบบอะซิงโครนัสรองรับชุดคำขอขนาดใหญ่ขึ้น
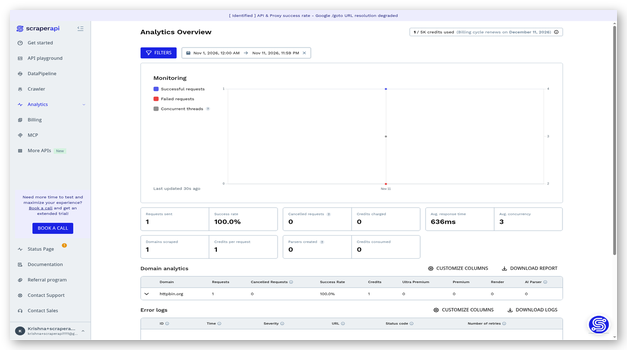
หน้าแดชบอร์ดแสดงข้อมูลรับรอง API การใช้เครดิต การทำงานพร้อมกัน และการวิเคราะห์คำขอ DataPipeline เพิ่มฟังก์ชันการกำหนดเวลาและการส่งมอบโดยไม่ต้องใช้บริการรวบรวมข้อมูลแยกต่างหาก ScraperAPI เหมาะสำหรับทีมที่ทราบอยู่แล้วว่าต้องขอข้อมูลจากหน้าเว็บใดบ้าง แต่ต้องการหลีกเลี่ยงการใช้พร็อกซี ค่าใช้จ่ายเครดิตจะแตกต่างกันไปตามเป้าหมายและคุณสมบัติที่เปิดใช้งาน
สิ่งอำนวยความสะดวก:
- จุดสิ้นสุดเดียว: คำขอ API มาตรฐานจะส่งไปยังเป้าหมาย URL และรหัสยืนยันตัวตน ScraperAPI จัดการการเลือกพร็อกซีและส่งคืนการตอบสนองของหน้าเว็บที่ได้
- การลองใหม่อัตโนมัติ: การพยายามเชื่อมต่อที่ล้มเหลวหรือถูกบล็อกสามารถลองใหม่ได้โดยใช้การเชื่อมต่ออื่น ซึ่งจะช่วยลดตรรกะการลองใหม่แบบกำหนดเองภายในส่วนติดต่อผู้ใช้ (scraper)ping แอพลิเคชัน
- Javaการแสดงผลสคริปต์: การเรนเดอร์เสริมจะโหลดเนื้อหาฝั่งไคลเอ็นต์ก่อนที่จะส่งการตอบกลับ หน้าผลิตภัณฑ์แบบไดนามิกและอินเทอร์เฟซแอปพลิเคชันสามารถเข้าถึงได้ผ่าน API เดียวกัน
- ข้อมูลที่มีโครงสร้าง: เอนด์พอยต์เฉพาะจะส่งคืนเรคอร์ดที่แยกวิเคราะห์แล้วสำหรับเป้าหมายที่รองรับ ทีมงานสามารถหลีกเลี่ยงการดูแลรักษาตัวเลือกสำหรับหน้าผลิตภัณฑ์ การค้นหา และรายการทั่วไปได้
- DataPipeline: DataPipeline จะกำหนดตารางการรวบรวมข้อมูลและส่งไฟล์ที่เสร็จสมบูรณ์ไปยังปลายทางที่รองรับ นักวิเคราะห์สามารถดำเนินการงานที่เกิดขึ้นซ้ำๆ ได้โดยไม่ต้องสร้างเลเยอร์การจัดการแบบครบวงจร
- เครื่องมือประเมินต้นทุน: เครื่องมือบนแดชบอร์ดช่วยประมาณการการใช้เครดิตสำหรับ URL และชุดพารามิเตอร์ สิ่งนี้ช่วยให้ทีมต่างๆ สามารถเปรียบเทียบค่าใช้จ่ายในการเรนเดอร์ พร็อกซีระดับพรีเมียม และการบายพาสได้
- ค่าเบี้ยเลี้ยงฟรี: แพ็กเกจฟรีที่เผยแพร่ประกอบด้วยเครดิต API 1,000 หน่วย และการเชื่อมต่อพร้อมกัน 5 ครั้ง ผู้ใช้สามารถทดสอบการร้องขอมาตรฐานก่อนเลือกใช้แพ็กเกจแบบชำระเงินได้
ข้อดี
จุดด้อย
???? วิธีการรับ ScraperAPI ฟรี?
- เยี่ยมชมร้านค้า ScraperAPIเข้าไปที่หน้าแสดงราคาและสร้างบัญชีฟรี
- คัดลอกคีย์ API แล้วทดสอบการส่งคำขอมาตรฐาน
- แพ็กเกจฟรีประกอบด้วยเครดิต 1,000 หน่วย และสามารถเชื่อมต่อพร้อมกันได้ 5 เครื่องต่อเดือน
เครดิตฟรี 1,000 เครดิตต่อเดือน
10) ScrapingBee
ScrapingBee เป็น API สำหรับรวบรวมหน้าเว็บที่ต้องใช้เบราว์เซอร์ พร็อกซี หรือการควบคุมตำแหน่งที่ตั้ง Javaการเรนเดอร์สคริปต์จะโหลดเนื้อหาแบบโต้ตอบ ในขณะที่การเชื่อมต่อแบบคลาสสิก พรีเมียม และแบบซ่อนเร้น จะจัดการกับระดับความยากของเป้าหมายที่แตกต่างกัน API การจับภาพหน้าจอและการค้นหาช่วยขยายการใช้งานบัญชีเดียวกันให้มากกว่าการดึงข้อมูล HTML
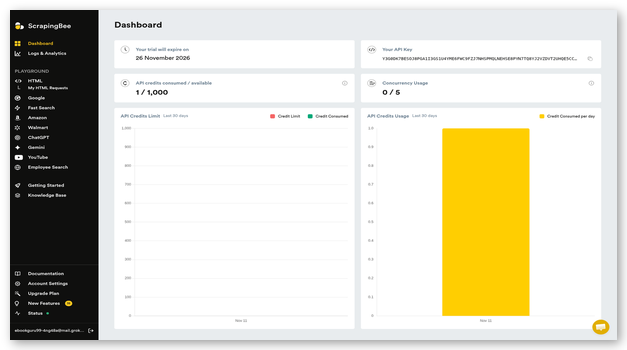
แดชบอร์ดประกอบด้วยคีย์ API, ตัวสร้างคำขอ, การประมาณเครดิต และประวัติการใช้งาน นักพัฒนาสามารถเพิ่มส่วนหัวแบบกำหนดเองได้ Javaสร้างสคริปต์สถานการณ์สำหรับการคลิกและการเลื่อนหน้าจอ โดยใช้ AItraction รองรับคำแนะนำฟิลด์ที่เป็นภาษาที่เข้าใจง่าย ScrapingBee สามารถเข้าถึงได้ง่ายสำหรับผู้ใช้ API แม้ว่าตัวเลือกที่เปิดใช้งานอาจเปลี่ยนแปลงต้นทุนเครดิตอย่างมากก็ตาม
สิ่งอำนวยความสะดวก:
- API HTML: HTML API ส่งคืนเนื้อหาหน้าเว็บที่แสดงผลแล้วหรือยังไม่แสดงผลผ่านทางเอนด์พอยต์เดียว นักพัฒนาสามารถควบคุมระดับพร็อกซี ตำแหน่ง ส่วนหัว และพฤติกรรมของเบราว์เซอร์ได้
- สถานการณ์การใช้งาน JS: แผ่นกระดาษ Javaสถานการณ์จำลองในสคริปต์สามารถคลิก เลื่อน รอ หรือโต้ตอบก่อนที่จะบันทึกได้ ซึ่งรองรับหน้าเว็บที่เนื้อหาจะปรากฏขึ้นหลังจากผู้ใช้ดำเนินการบางอย่างเท่านั้น
- ระดับพร็อกซี: เส้นทางแบบคลาสสิก พรีเมียม และแบบลับ ใช้สำหรับจัดการกับระดับการปิดกั้นที่แตกต่างกัน ทีมสามารถเริ่มต้นด้วยการเข้าถึงที่มีต้นทุนต่ำกว่า และค่อยๆ เพิ่มระดับการเข้าถึงเมื่อจำเป็นเท่านั้น
- AI extracชั่น: คำถามและตัวอย่างที่เข้าใจง่ายtracกฎการกำหนดโครงสร้างจะระบุฟิลด์ที่ร้องขอ ซึ่งจะช่วยลดภาระงานของตัวเลือกเมื่อทีมต้องการผลลัพธ์ที่มีโครงสร้างอย่างรวดเร็วจากการเปลี่ยนหน้า
- API ภาพหน้าจอ: คำขอจับภาพหน้าจอจะบันทึกทั้งหน้าเว็บหรือเฉพาะบางส่วน ทีมตรวจสอบสามารถจัดเก็บหลักฐานภาพควบคู่ไปกับข้อมูลอื่นๆ ได้tracค่าที่แก้ไขแล้วและบันทึกการเปลี่ยนแปลง
- เครื่องมือสร้างคำขอ: เครื่องมือสร้างแดชบอร์ดจะสร้างโค้ดและแสดงต้นทุนเครดิตโดยประมาณ นักพัฒนาสามารถตรวจสอบพารามิเตอร์ก่อนเพิ่มลงในแอปพลิเคชันได้
- เครดิตฟรี: ทุกบัญชีใหม่จะได้รับเครดิต API 1,000 หน่วย โดยไม่ต้องใช้บัตรชำระเงิน เครดิตนี้ใช้สำหรับการทดลองใช้งานเท่านั้น และจะไม่ต่ออายุโดยอัตโนมัติเหมือนช่วงทดลองใช้งาน
ข้อดี
จุดด้อย
???? วิธีการรับ ScrapingBee ฟรี?
- จุดเปิด ScrapingBee และลงทะเบียนบัญชีใหม่โดยไม่ต้องใช้บัตร
- ใช้เครื่องมือสร้างคำขอในแดชบอร์ดเพื่อสร้างการโทรทดสอบ
- บัญชีผู้ใช้ใหม่แต่ละบัญชีจะได้รับเครดิต API ฟรี 1,000 หน่วยสำหรับการทดลองใช้งาน
เยี่ยมชมร้านค้า ScrapingBee >>
รับเครดิตสมัครสมาชิกฟรี 1,000 หน่วย
ตารางเปรียบเทียบคุณสมบัติของโปรแกรมค้นหาเว็บชั้นนำping เครื่องมือ
เราเลือกเว็บสแครปบุ๊กฟรีที่ดีที่สุดได้อย่างไรping เครื่องมือ?

At Guru99เรามุ่งมั่นที่จะให้ข้อมูลที่ถูกต้อง เกี่ยวข้อง และเป็นกลาง เพื่อช่วยให้ผู้ใช้ตัดสินใจได้อย่างถูกต้อง กระบวนการแก้ไขของเรามุ่งเน้นไปที่การนำเสนอแหล่งข้อมูลที่ให้ข้อมูลและเชื่อถือได้ โดยรับรองว่าเนื้อหาจะน่าเชื่อถือและไว้วางใจได้ ตรวจสอบและรีวิวเว็บสแครปบุ๊คที่ดีที่สุดกว่า 18 รายการping เครื่องมือรวมถึงตัวเลือกฟรีและแบบชำระเงิน เราได้รวบรวมตัวเลือกที่ครอบคลุมโดยพิจารณาจากคุณลักษณะ ข้อดี ข้อเสีย และราคา คู่มือนี้จะช่วยให้คุณเข้าใจเครื่องมือแต่ละอย่างอย่างละเอียด ช่วยให้คุณเลือกเครื่องมือที่ดีที่สุดสำหรับความต้องการของคุณได้ เราจะเน้นที่ปัจจัยต่อไปนี้ในขณะที่พิจารณาเครื่องมือโดยพิจารณาจากฟังก์ชันการทำงาน ความสะดวกในการใช้งาน และความคล่องตัว
- ใช้งานง่าย: เราเลือกเครื่องมือตามอินเทอร์เฟซที่เป็นมิตรกับผู้ใช้ ช่วยให้ผู้เริ่มต้นและผู้เชี่ยวชาญสามารถรวบรวมข้อมูลได้อย่างราบรื่น
- ประสิทธิภาพ: ผู้เชี่ยวชาญในทีมของเราให้ความสำคัญกับเครื่องมือที่ได้รับการปรับให้เหมาะสมกับประสิทธิภาพ เพื่อให้มั่นใจได้ว่าการดึงข้อมูลจะรวดเร็วและแม่นยำtracนโยบายที่ไม่ยอมประนีประนอม
- การรักษาความปลอดภัย: เรามั่นใจว่าได้คัดเลือกเครื่องมือที่มีคุณลักษณะด้านความปลอดภัยที่แข็งแกร่งเพื่อปกป้องข้อมูลที่ละเอียดอ่อนและรักษาความเป็นส่วนตัว
- ปรับตัว: เราเลือกใช้เครื่องมือโดยพิจารณาจากความสามารถในการจัดการเว็บไซต์ที่หลากหลายและตัวอย่างต่างๆtracสามารถจัดการข้อมูลในรูปแบบต่างๆ ได้อย่างง่ายดาย
- การสนับสนุนชุมชน: ทีมงานของเราพิจารณาเครื่องมือที่มีชุมชนที่ใช้งานอยู่และการสนับสนุนลูกค้าที่เชื่อถือได้เพื่อแก้ไขปัญหาได้อย่างมีประสิทธิภาพ
- ความยืดหยุ่น: เราเลือกเครื่องมือที่สามารถปรับแต่งได้ เพื่อให้มั่นใจว่าตรงตามความต้องการเฉพาะของผู้ใช้และโครงการที่แตกต่างกัน
เว็บสแครปคืออะไรping เครื่องมือนี้ และมันทำงานอย่างไร?
การขูดข้อมูลบนเว็บping เครื่องมือจะร้องขอหน้าเว็บ อ่านเนื้อหา และแสดงผลtracแปลงฟิลด์ที่เลือกของ ts ให้เป็นรูปแบบที่มีโครงสร้าง เครื่องมือบางอย่างแยกวิเคราะห์ HTML โดยตรง ในขณะที่บางเครื่องมือใช้เบราว์เซอร์เพื่อประมวลผล Javaสคริปต์สามารถโหลดก่อนได้ API ที่จัดการแล้วจะหมุนเวียนพร็อกซี ลองส่งคำขอที่ถูกบล็อกซ้ำ และส่งคืนผลลัพธ์ผ่านปลายทางเดียว ขั้นตอนการทำงานมักจะเริ่มต้นด้วย URL และอดีตtracกฎการประมวลผลข้อมูลจะสิ้นสุดลงด้วยการบันทึกข้อมูลในรูปแบบ JSON, CSV หรือฐานข้อมูล ผู้เริ่มต้นควรตัดสินใจก่อนว่าต้องการหน้าเว็บ ฟิลด์ที่มีโครงสร้าง ภาพหน้าจอ หรือการตรวจสอบซ้ำหรือไม่ การเลือกนั้นจะเป็นตัวกำหนดประเภทของเครื่องมือที่เหมาะสม
รูปแบบการเข้าถึงฟรีแบบใดที่เหมาะกับเว็บสแครปบุ๊คของคุณping โครงการ?
การเข้าถึงฟรีอาจหมายถึงโควต้ารายเดือนถาวร เครดิตสำหรับการสมัครใช้งานครั้งเดียว การทดลองใช้แบบจำกัดเวลา หรือการประเมินผลแบบเสียค่าใช้จ่าย รูปแบบเหล่านี้ไม่สามารถใช้แทนกันได้ แผนแบบต่ออายุอัตโนมัติเหมาะสำหรับงานขนาดเล็กที่เกิดขึ้นซ้ำๆ เครดิตแบบครั้งเดียวเหมาะสำหรับการทดสอบการผสานรวม การทดลองใช้แบบจำกัดเวลาช่วยให้ประเมินการสนับสนุนและเป้าหมายที่ยากได้อย่างรวดเร็ว การทดลองใช้แบบเสียค่าใช้จ่ายมักให้ปริมาณการใช้งานพร็อกซีที่มีคุณภาพสูงกว่าระดับฟรี ตรวจสอบว่าจำเป็นต้องใช้บัตรหรือไม่ อะไรใช้เครดิต และความจุที่ไม่ได้ใช้จะหมดอายุหรือไม่ ตัวเลือกที่ดีที่สุดคือตัวเลือกที่ตรงกับความถี่ในการร้องขอ ความยากของเป้าหมาย และความอดทนของคุณในการสร้างใหม่ในภายหลัง
คุณควรพิจารณาคุณสมบัติใดบ้างในการเลือกใช้เครื่องมือดึงข้อมูลจากเว็บไซต์ping เครื่องมือ?
คุณสมบัติที่มีประโยชน์นั้นขึ้นอยู่กับลักษณะงาน ดังนั้นควรเริ่มต้นด้วยเป้าหมายและผลลัพธ์ที่ต้องการ การตรวจสอบเหล่านี้ครอบคลุมการตัดสินใจซื้อหลักๆ ดังนี้:
- การแสดงผล: Javaการรองรับสคริปต์มีความสำคัญเมื่อข้อมูลที่ต้องการปรากฏขึ้นหลังจากผลลัพธ์ HTML เริ่มต้น
- การควบคุมการเข้าถึง: การหมุนเวียนพร็อกซี เซสชัน และการกำหนดเป้าหมายตามตำแหน่งที่ตั้ง จะเป็นตัวกำหนดว่าคำขอจะเข้าถึงหน้าเว็บระดับภูมิภาคหรือหน้าเว็บที่ได้รับการป้องกันหรือไม่
- Output: รูปแบบไฟล์ JSON, CSV, Markdown, ภาพหน้าจอ และ HTML ดิบ ตอบสนองความต้องการด้านการวิเคราะห์และการรวบรวมหลักฐานที่แตกต่างกัน
- Operaชั่น: การตั้งเวลา การลองใหม่ การบันทึก การแจ้งเตือน และวงเงินใช้จ่าย ช่วยให้สามารถตรวจสอบและควบคุมงานที่เกิดขึ้นซ้ำๆ ได้
- สนับสนุน: เอกสารที่ชัดเจนและการตอบสนองที่รวดเร็วจะช่วยลดเวลาหยุดทำงานเมื่อเป้าหมายหรือกฎการร้องขอเปลี่ยนแปลง
ขูดอย่างไรping API แตกต่างจากพร็อกซีและเครื่องมือของเบราว์เซอร์อย่างไร?
สคราping API จัดการคำขอ การลองใหม่ และการแสดงผลอยู่เบื้องหลังเอนด์พอยต์เดียว เหมาะสำหรับทีมที่ต้องการผลลัพธ์โดยไม่ต้องจัดการโครงสร้างพื้นฐานเครือข่าย บริการพร็อกซีทำหน้าที่เพียงแค่ส่งต่อทราฟฟิก ดังนั้นผู้ใช้ยังคงต้องการโปรแกรมรวบรวมข้อมูล โปรแกรมวิเคราะห์ข้อมูล พื้นที่จัดเก็บ และการจัดการข้อผิดพลาด เครื่องมือในเบราว์เซอร์ทำงาน Javaเขียนสคริปต์และจำลองการกระทำต่างๆ เช่น การคลิกหรือการเลื่อน พวกมันจัดการกับหน้าเว็บแบบโต้ตอบได้ แต่ใช้ทรัพยากรการประมวลผลมากกว่า ระบบการผลิตหลายระบบผสมผสานวิธีการเหล่านี้เข้าด้วยกัน พร็อกซีสามารถรองรับโปรแกรมรวบรวมข้อมูลแบบกำหนดเอง ในขณะที่เบราว์เซอร์แบบจัดการจะจัดการกับหน้าเว็บที่ซับซ้อน เลือกวิธีการที่ซับซ้อนน้อยที่สุดที่สามารถส่งคืนข้อมูลที่ต้องการได้อย่างน่าเชื่อถือ
AI จะช่วยปรับปรุงการดึงข้อมูลจากเว็บได้อย่างไรping เวิร์กโฟลว์?
AI สามารถแปลคำขอภาคสนามที่เป็นภาษาธรรมดาให้เป็นข้อความได้tracAI สามารถควบคุมกฎการกำหนดค่า ปรับค่าที่ไม่เป็นระเบียบให้เป็นมาตรฐาน และสร้าง JSON หรือ Markdown ที่สะอาดกว่า นอกจากนี้ยังช่วยแก้ไขตัวเลือกเมื่อเค้าโครงหน้าเว็บเปลี่ยนแปลง ความสามารถเหล่านี้ช่วยลดเวลาในการตั้งค่า โดยเฉพาะอย่างยิ่งสำหรับต้นแบบและการวิจัย อย่างไรก็ตาม ความสามารถเหล่านี้ไม่ได้ขจัดความจำเป็นในการตรวจสอบความถูกต้อง โมเดลอาจติดป้ายกำกับฟิลด์ผิดพลาด พลาดการแบ่งหน้าแบบซ่อน หรือรวมค่าที่ไม่เกี่ยวข้องกัน ทีมควรเปรียบเทียบตัวอย่างกับหน้าต้นฉบับและตรวจสอบการเปลี่ยนแปลงเมื่อเวลาผ่านไป AI ทำงานได้ดีที่สุดในฐานะผู้ช่วยในการจัดการคำขอที่ควบคุมได้ โครงสร้างข้อมูลที่ชัดเจน และการตรวจสอบคุณภาพที่ทำซ้ำได้
เว็บสแครปทำได้อย่างไรping เครื่องมือต่างๆ เชื่อมต่อกับเวิร์กโฟลว์ข้อมูลหรือไม่?
เว็บสแครปping โดยทั่วไปแล้ว เครื่องมือต่างๆ จะเชื่อมต่อกันผ่าน REST API, SDK, เว็บฮุค, พื้นที่จัดเก็บข้อมูลบนคลาวด์ หรือแพลตฟอร์มการทำงานอัตโนมัติ งานที่กำหนดเวลาไว้จะรวบรวมหน้าเว็บ บันทึกข้อมูลลงในชุดข้อมูล และส่งเว็บฮุคแจ้งว่างานเสร็จสมบูรณ์ จากนั้นบริการอื่นสามารถตรวจสอบความถูกต้อง แปลง หรือโหลดข้อมูลลงในคลังข้อมูลได้ เวิร์กโฟลว์ AI ใช้เอาต์พุต MCP หรือ Markdown มากขึ้นเรื่อยๆ เพื่อส่งหน้าเว็บปัจจุบันให้กับตัวแทนวิจัย การบูรณาการควรมีสถานะการทำงาน เวลา และข้อผิดพลาดด้วย หากไม่มีบริบทเหล่านั้น ระบบปลายทางจะไม่สามารถแยกแยะข้อมูลใหม่จากชุดข้อมูลที่ไม่สมบูรณ์หรือล้มเหลวได้
เว็บสแครปคืออะไรping ถูกกฎหมายและปลอดภัยหรือไม่?
เว็บสแครปping อาจถูกต้องตามกฎหมาย แต่ความถูกต้องตามกฎหมายขึ้นอยู่กับข้อมูล วิธีการเข้าถึง เขตอำนาจศาล และวัตถุประสงค์การใช้งาน โครงการที่รับผิดชอบควรบันทึกการตรวจสอบเหล่านี้ไว้:
- การเข้าถึงสาธารณะ: เก็บรวบรวมเฉพาะข้อมูลที่สามารถเข้าถึงได้โดยชอบด้วยกฎหมายและเกี่ยวข้องกับวัตถุประสงค์ทางธุรกิจหรือการวิจัยที่กำหนดไว้เท่านั้น
- กฎของเว็บไซต์: Revดูข้อกำหนดในการให้บริการ คำแนะนำเกี่ยวกับหุ่นยนต์ ข้อตกลงtracตรวจสอบข้อจำกัดที่แท้จริงและกฎหมายท้องถิ่นที่เกี่ยวข้องก่อนเก็บรวบรวมข้อมูล
- ข้อมูลส่วนบุคคล: ลดปริมาณการรวบรวมข้อมูลให้น้อยที่สุด รักษาความปลอดภัยของเอกสารที่เก็บรักษาไว้ และปฏิบัติตามข้อกำหนดด้านความเป็นส่วนตัวสำหรับข้อมูลที่สามารถระบุตัวตนได้
- ร้องขอการโหลด: ใช้ค่าบริการที่เหมาะสมและการแคชข้อมูล เพื่อไม่ให้การเข้าชมอัตโนมัติไปรบกวนเว็บไซต์เป้าหมาย
- การตรวจสอบทางกฎหมาย: ควรขอคำแนะนำจากผู้เชี่ยวชาญเมื่อโครงการเกี่ยวข้องกับข้อมูลที่ละเอียดอ่อน บัญชี การตรวจสอบสิทธิ์ หรือข้อจำกัดที่ไม่ชัดเจน
คุณจะป้องกันการขโมยข้อมูลบนเว็บได้อย่างไรping คุณภาพของข้อมูล?
คุณภาพของข้อมูลเริ่มต้นด้วยโครงสร้างข้อมูลที่ชัดเจนและหน้าทดสอบที่เป็นตัวแทน ตรวจสอบประเภทฟิลด์ ค่าที่จำเป็น การแบ่งหน้า ข้อมูลซ้ำ และเวลาประทับก่อนที่จะขยายขนาด บันทึกตัวอย่างข้อมูลดิบขนาดเล็กไว้ข้างๆ บันทึกที่แยกวิเคราะห์แล้ว เพื่อให้ข้อผิดพลาดคงอยู่ traceable. ตรวจสอบจำนวนระเบียนและอัตราฟิลด์ที่ขาดหายไปในแต่ละรอบการทำงาน การเปลี่ยนแปลงเค้าโครงมักสร้างผลลัพธ์ที่ดูเหมือนถูกต้องแต่ไม่ถูกต้อง ซึ่งยากต่อการตรวจจับมากกว่าคำขอที่ล้มเหลว เวอร์ชัน extracปฏิบัติตามกฎและเปรียบเทียบตัวอย่างหลังจากการเปลี่ยนแปลงทุกครั้ง สำหรับชุดข้อมูลที่สำคัญ ให้เพิ่มการตรวจสอบอิสระกับแหล่งข้อมูลที่เชื่อถือได้ก่อนที่จะเผยแพร่ข้อสรุป
เว็บสแครปทำได้อย่างไรping ต้นทุนเปลี่ยนแปลงไปตามขนาดของโครงการหรือไม่?
ค่าใช้จ่ายจะเพิ่มขึ้นตามปริมาณคำขอ จำนวนหน้าที่แสดงผล พร็อกซีระดับพรีเมียม การทำงานพร้อมกัน พื้นที่จัดเก็บ และการสนับสนุน หนึ่ง URL อาจใช้เครดิตหลายหน่วยเมื่อ Javaสคริปต์ การกำหนดเป้าหมายตามตำแหน่ง หรือการข้ามขั้นตอนขั้นสูงถูกเปิดใช้งานแล้ว ความพยายามที่ล้มเหลวอาจไม่เสียค่าใช้จ่ายสำหรับ API บางตัว แต่อาจมีค่าใช้จ่ายสำหรับ API อื่นๆ คำนวณต้นทุนจากตัวอย่างที่เป็นตัวแทน ไม่ใช่จากจำนวนคำขอเพียงอย่างเดียว รวมเวลาของฝ่ายวิศวกรรมสำหรับการบำรุงรักษาและการตรวจสอบตัวแยกวิเคราะห์ API ที่ได้รับการจัดการอาจมีค่าใช้จ่ายต่อผลลัพธ์สูงกว่า แต่ช่วยลดภาระงานด้านการปฏิบัติการ กำหนดวงเงินการใช้จ่าย ตรวจสอบการใช้งานตามเป้าหมาย และแยกการทดลองออกจากข้อมูลประจำตัวสำหรับการใช้งานจริง
ปัญหาอะไรบ้างที่ทำให้เว็บใช้งานไม่ได้ Scraperสาเหตุที่ทำให้เกิดความล้มเหลว และจะแก้ไขได้อย่างไร?
Scraperโดยปกติแล้วการทดสอบจะล้มเหลวเนื่องจากพฤติกรรมของหน้าเว็บ กฎการเข้าถึง หรืออื่นๆtracข้อสมมติฐานในการแก้ไขเปลี่ยนแปลงไปแล้ว การแก้ไขแต่ละครั้งควรพิจารณาถึงสาเหตุที่พบเห็น แทนที่จะลองใหม่โดยไม่รู้สาเหตุ
- ปัญหา: หน้าเว็บแสดงผล HTML ว่างเปล่าเนื่องจากเนื้อหาโหลดผ่านขั้นตอนก่อนหน้า Javaสคริปต์หลังจากคำตอบแรก
วิธีการแก้: ผู้ปฏิบัติงานควรเปิดใช้งานการแสดงผลของเบราว์เซอร์และรอให้ตัวเลือกมีความเสถียรเสียก่อนจึงจะดำเนินการต่อได้tracกรอกข้อมูลในช่องที่ร้องขอ - ปัญหา: การร้องขอซ้ำๆ จะกระตุ้น CAPTCHA, การจำกัดอัตรา หรือการบล็อกชั่วคราวระหว่างการรวบรวมข้อมูลขนาดใหญ่
วิธีการแก้: ทีมควรลดความเร็วในการส่งคำขอ หมุนเวียนใช้พร็อกซีที่เหมาะสม ใช้เซสชันซ้ำอย่างระมัดระวัง และปฏิบัติตามกฎการเข้าถึงของเว็บไซต์ - ปัญหา: หน้าเว็บที่ได้รับการออกแบบใหม่จะย้ายตำแหน่งช่องกรอกข้อมูล และสร้างค่าว่างหรือค่าที่ไม่ตรงกันโดยไม่แจ้งให้ทราบล่วงหน้า
วิธีการแก้: ผู้ดูแลระบบควรกำหนดเวอร์ชันของตัวเลือก เก็บรักษาตัวอย่างดิบ และแจ้งเตือนเมื่อการกรอกข้อมูลในช่องที่จำเป็นลดลงต่ำกว่าเกณฑ์ที่ตกลงกันไว้ - ปัญหา: การแบ่งหน้าจะหยุดลงก่อนกำหนด ทำให้สินค้า ความคิดเห็น หรือรายการอื่นๆ ที่อยู่ถัดไปถูกละเลยไปจากชุดข้อมูลสุดท้าย
วิธีการแก้: นักพัฒนาควรทดสอบตรรกะของหน้าถัดไป บันทึกจำนวนหน้า และเปรียบเทียบยอดรวมที่รวบรวมได้กับตัวบ่งชี้แหล่งที่มาที่มองเห็นได้ - ปัญหา: การใช้เครดิตเพิ่มขึ้นอย่างไม่คาดคิดเมื่อเปิดใช้งานการแสดงผล เส้นทางพิเศษ หรือเป้าหมายที่ยากลำบาก
วิธีการแก้: เจ้าของโครงการควรประเมินคำขอจากตัวแทนก่อน กำหนดวงเงินใช้จ่าย และแยกเป้าหมายที่มีค่าใช้จ่ายสูงออกเป็นขั้นตอนการทำงานที่ต้องติดตามอย่างใกล้ชิด - ปัญหา: ซ้ำ URLการลองใหม่ซ้ำๆ จะสร้างบันทึกที่ซ้ำกัน ซึ่งส่งผลต่อการนับและการวิเคราะห์ในขั้นตอนต่อไป
วิธีการแก้: ไปป์ไลน์ควรจัดสรรคีย์บันทึกที่เสถียรและปรับให้เป็นมาตรฐาน URLและทำการลบข้อมูลซ้ำซ้อนก่อนที่ข้อมูลจะถูกบันทึกในรายงานหรือจัดเก็บ
เทรนด์ใดที่จะกำหนดทิศทางการรวบรวมข้อมูลบนเว็บping เครื่องมือต่อไป?
เว็บสแครปping แพลตฟอร์มต่างๆ กำลังมุ่งไปสู่การใช้งานที่ควบคุมด้วย AItracการเชื่อมต่อตัวแทน และโครงสร้างพื้นฐานของเบราว์เซอร์ที่ยืดหยุ่นยิ่งขึ้น โครงสร้างข้อมูลแบบภาษาธรรมดาช่วยลดระยะเวลาในการตั้งค่า ในขณะที่การผสานรวม MCP ช่วยให้ตัวแทนวิจัยสามารถร้องขอหน้าปัจจุบันผ่านเครื่องมือที่ควบคุมได้ ผู้ขายยังรวมการรวบรวมข้อมูลเข้าด้วยกันอีกด้วยpingการค้นหา การรวบรวมข้อมูล และการกระทำของเบราว์เซอร์ที่อยู่เบื้องหลังบัญชีที่ใช้ร่วมกัน การปฏิบัติตามกฎระเบียบและการสืบย้อนแหล่งที่มาของข้อมูลจะได้รับความสนใจมากขึ้น เนื่องจากระบบการรวบรวมข้อมูลอัตโนมัติจะนำไปสู่การตัดสินใจทางธุรกิจ แนวโน้มที่เป็นประโยชน์คือการตรวจสอบที่มากขึ้น: ทีมงานต้องการทราบต้นทุนการร้องขอที่ชัดเจน การประทับเวลาของแหล่งที่มา เป็นต้นtracเวอร์ชันต่างๆ และสาเหตุของความล้มเหลว ระบบอัตโนมัติที่ดีขึ้นควรทำให้การควบคุมเหล่านั้นง่ายขึ้น ไม่ใช่ซ่อนมันไว้
คำตัดสิน
ฉันได้ตรวจสอบรายชื่อตัวเลือกโดยพิจารณาจากข้อจำกัดในการเข้าถึง ความลึกของเวิร์กโฟลว์ และความต้องการในการขยายขนาด ตัวเลือกสามตัวเลือกนี้เหมาะสมที่สุดสำหรับงานที่แตกต่างกันping จำเป็น
- Oxylabs: ฉันชอบเว็บที่มีการจัดการของมัน Scraper API สำหรับเป้าหมายที่ซับซ้อน การส่งมอบที่มีโครงสร้าง และการควบคุมการผลิตโดยไม่ต้องดูแลโครงสร้างพื้นฐานของเบราว์เซอร์และพร็อกซีแยกต่างหาก
- เดโคโด: จากการตรวจสอบของผม ผมจัดให้เป็นอันดับแรกเนื่องจากมีการเข้าถึง API ฟรีที่ใช้งานง่าย และมีเทมเพลตสำเร็จรูปให้ใช้ Javaการเรนเดอร์สคริปต์ และผลลัพธ์ที่เหมาะสมสำหรับเวิร์กโฟลว์ด้านข้อมูลหรือปัญญาประดิษฐ์ (AI)
- โหนดมาเวน: ฉันเลือกใช้สำหรับทีมที่มี scra อยู่แล้วping โค้ดและต้องการการกำหนดเป้าหมายตำแหน่งโดยละเอียด การควบคุมการหมุน และที่อยู่พร็อกซีที่ผ่านการคัดกรอง
