
การเรียนรู้ของเครื่องแบบไม่มีผู้ดูแล: Algorithmsประเภทและตัวอย่าง
 เอเวลิน คลาร์ก
⚡ สรุปอย่างชาญฉลาด
การเรียนรู้แบบไม่มีผู้กำกับดูแล (Unsupervised Learning) เป็นเทคนิคการเรียนรู้ของเครื่องจักรที่ทำงานกับข้อมูลที่ไม่มีป้ายกำกับ โดยปล่อยให้แบบจำลองค้นพบโครงสร้างด้วยตนเองผ่านการจัดกลุ่ม กฎความสัมพันธ์ และการลดมิติ แทนที่จะอาศัยคำตอบที่ให้ไว้ล่วงหน้า
Unsupervised Learning คืออะไร?
การเรียนรู้แบบไม่มีผู้กำกับดูแล (Unsupervised Learning) เป็นเทคนิคการเรียนรู้ของเครื่องจักรที่ผู้ใช้ไม่จำเป็นต้องกำกับดูแลแบบจำลอง แต่จะปล่อยให้แบบจำลองทำงานด้วยตนเองเพื่อค้นหารูปแบบและข้อมูลที่ก่อนหน้านี้ไม่เคยตรวจพบ โดยส่วนใหญ่จะใช้กับข้อมูลที่ไม่มีป้ายกำกับ
การเรียนรู้ที่ไม่มีผู้ดูแล Algorithms
การเรียนรู้ที่ไม่มีผู้ดูแล Algorithms ช่วยให้ผู้ใช้สามารถดำเนินการประมวลผลที่ซับซ้อนมากขึ้นได้เมื่อเทียบกับ การเรียนรู้ภายใต้การดูแลอย่างไรก็ตาม การเรียนรู้แบบไม่มีผู้กำกับดูแลอาจคาดเดาได้ยากกว่าวิธีการที่ฝึกฝนโดยใช้คำตอบที่ทราบแล้ว อัลกอริทึมการเรียนรู้แบบไม่มีผู้กำกับดูแล ได้แก่ การจัดกลุ่ม การตรวจจับความผิดปกติ การลดมิติ และโครงข่ายประสาทเทียมแบบจัดระเบียบตนเอง
ตัวอย่างการเรียนรู้ของเครื่องแบบไม่มีผู้ดูแล
ลองยกตัวอย่างการเรียนรู้แบบไม่ใช้การกำกับดูแล (Unsupervised Learning) สำหรับเด็กทารกและสุนัขที่เลี้ยงไว้ในครอบครัว ภาพแรกแสดงให้เห็นสัตว์เลี้ยงที่เด็กทารกรู้จักอยู่แล้ว
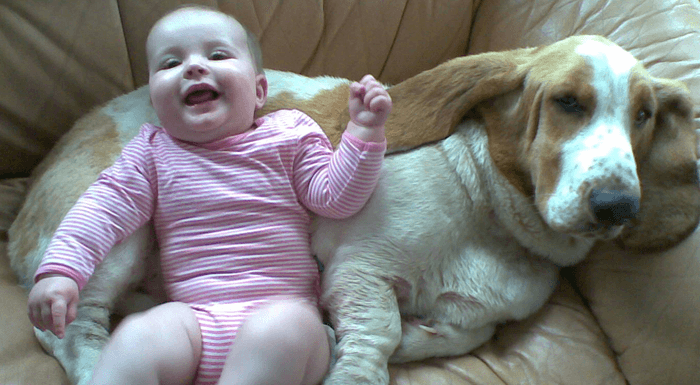
เธอรู้จักและจำพวกสุนัขตัวนี้ได้ ไม่กี่สัปดาห์ต่อมา เพื่อนของครอบครัวคนหนึ่งพาสุนัขมาด้วยและพยายามเล่นกับเด็กทารก สุนัขตัวที่สองที่ไม่คุ้นเคยนั้นปรากฏอยู่ในภาพด้านล่าง
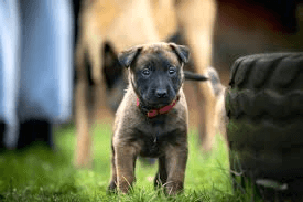
เด็กทารกไม่เคยเห็นสุนัขตัวนี้มาก่อน แต่เธอจำได้ว่าลักษณะหลายอย่าง (หู 2 ข้าง ตา การเดิน 4 ขา) คล้ายกับสุนัขเลี้ยงของเธอ เธอระบุว่าสัตว์ตัวใหม่นี้คือสุนัข นี่คือการเรียนรู้แบบไม่มีผู้กำกับดูแล ซึ่งคุณไม่ได้รับการสอน แต่คุณเรียนรู้จากข้อมูล (ในกรณีนี้คือข้อมูลเกี่ยวกับสุนัข) หากเป็นการเรียนรู้แบบมีผู้กำกับดูแล เพื่อนของครอบครัวคงจะบอกเด็กทารกว่ามันคือสุนัข ดังที่แสดงในตัวอย่างการเรียนรู้แบบไม่มีผู้กำกับดูแลข้างต้น
ทำไมต้องเรียนรู้แบบไม่มีผู้ดูแล?
นี่คือเหตุผลหลักในการใช้การเรียนรู้แบบไม่มีผู้กำกับดูแล (Unsupervised Learning) เครื่องเรียนรู้:
- การเรียนรู้ของเครื่องจักรแบบไม่กำกับดูแลสามารถค้นพบรูปแบบที่ไม่รู้จักทุกประเภทในข้อมูลได้
- วิธีการที่ไม่มีผู้ดูแลช่วยให้คุณค้นหาคุณลักษณะที่เป็นประโยชน์สำหรับการจัดหมวดหมู่
- ระบบสามารถประมวลผลข้อมูลได้ทันทีที่เข้ามา ดังนั้นข้อมูลที่เข้ามาจะถูกวิเคราะห์และจัดกลุ่มโดยไม่ต้องรอให้มนุษย์ติดป้ายกำกับก่อน
- การได้รับข้อมูลที่ไม่มีป้ายกำกับจากคอมพิวเตอร์นั้นง่ายกว่าข้อมูลที่ติดป้ายกำกับซึ่งจำเป็นต้องมีการแทรกแซงด้วยตนเอง
Clusterประเภทของการเรียนรู้แบบไม่มีผู้ดูแล Algorithms
ปัญหาการเรียนรู้แบบไม่ใช้การกำกับดูแลยังแบ่งออกเป็นกลุ่มย่อยอีก ได้แก่ ปัญหาการจัดกลุ่ม ปัญหาความสัมพันธ์ และปัญหาการลดมิติ Clusterการจัดกลุ่มข้อมูลที่คล้ายกันเข้าด้วยกัน การค้นหาความสัมพันธ์จะค้นหารายการที่ปรากฏร่วมกัน และการลดมิติจะบีบอัดคุณลักษณะจำนวนมากให้เหลือเพียงไม่กี่อย่าง
Clusterไอเอ็นจี
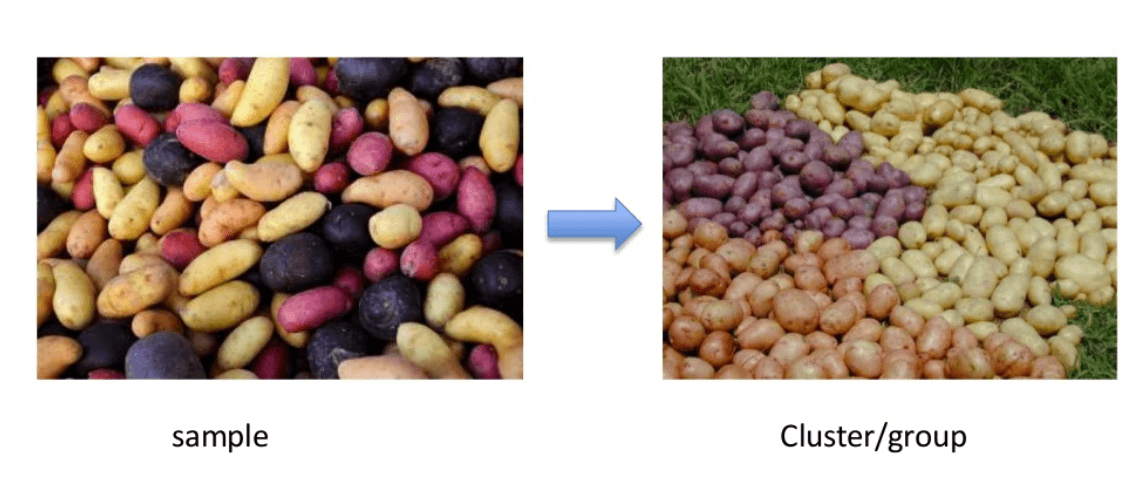
Clustering เป็นแนวคิดที่สำคัญเมื่อพูดถึงการเรียนรู้แบบไม่มีผู้ดูแล ส่วนใหญ่จะเกี่ยวข้องกับการค้นหาโครงสร้างหรือรูปแบบในการรวบรวมข้อมูลที่ไม่มีการจัดหมวดหมู่ การเรียนรู้แบบไม่มีผู้ดูแล Clusterอัลกอริทึมจะประมวลผลข้อมูลของคุณและค้นหากลุ่ม (คลัสเตอร์) ที่เป็นธรรมชาติหากมีอยู่ในข้อมูล คุณยังสามารถแก้ไขจำนวนคลัสเตอร์ที่อัลกอริทึมควรระบุได้ ซึ่งช่วยให้คุณปรับระดับความละเอียดของกลุ่มเหล่านี้ได้ แผนภาพด้านล่างแสดงบันทึกที่กระจัดกระจายซึ่งถูกจัดกลุ่มเป็นกลุ่มที่ชัดเจน
มีการจัดกลุ่มหลายประเภทที่คุณสามารถใช้ได้:
พิเศษ (การแบ่งพาร์ติชัน)
ในวิธีการจัดกลุ่มแบบนี้ ข้อมูลจะถูกจัดกลุ่มในลักษณะที่ว่า ข้อมูลหนึ่งรายการสามารถอยู่ในกลุ่มใดกลุ่มหนึ่งได้เท่านั้น
ตัวอย่าง: K หมายถึง
รวมตัวกัน
ในเทคนิคการจัดกลุ่มนี้ ข้อมูลแต่ละรายการเริ่มต้นด้วยการเป็นกลุ่มของตัวเอง จากนั้นการรวมกลุ่มแบบวนซ้ำระหว่างสองกลุ่มที่อยู่ใกล้กันที่สุดจะช่วยลดจำนวนกลุ่มลง
ตัวอย่าง: การจัดกลุ่มตามลำดับชั้น
คาบเกี่ยวกันping
ในเทคนิคนี้ ชุดคลุมเครือ ใช้สำหรับจัดกลุ่มข้อมูล จุดแต่ละจุดอาจอยู่ในสองกลุ่มขึ้นไป โดยมีระดับการเป็นสมาชิกที่แตกต่างกัน
ที่นี่ข้อมูลจะเชื่อมโยงกับค่าสมาชิกที่เหมาะสม ตัวอย่าง: Fuzzy C-Means
น่าจะเป็น
เทคนิคนี้ใช้การแจกแจงความน่าจะเป็นในการสร้างกลุ่มต่างๆ
ตัวอย่าง: คำหลักต่อไปนี้
- “รองเท้าของผู้ชาย”
- “รองเท้าผู้หญิง”
- “ถุงมือผู้หญิง”
- “ถุงมือของมนุษย์”
สามารถแบ่งออกเป็นสองประเภท คือ “รองเท้า” และ “ถุงมือ” หรือ “ผู้ชาย” และ “ผู้หญิง”
Clusterประเภทต่างๆ
ต่อไปนี้คืออัลกอริธึมที่พบได้บ่อยที่สุดในแมชชีนเลิร์นนิงแบบไม่ใช้การกำกับดูแล สองอัลกอริธึมแรกจัดกลุ่มข้อมูล สามอัลกอริธึมสุดท้ายลดมิติแทนที่จะสร้างคลัสเตอร์ และ K-NN ถูกระบุไว้เนื่องจากมักสับสนกับ K-means
- การจัดกลุ่มแบบลำดับชั้น — การจัดกลุ่ม
- การจัดกลุ่มแบบ K-means — การจัดกลุ่ม
- K-NN (k nearest neighbors) — เป็นตัวจำแนกประเภทแบบมีผู้กำกับดูแล ไม่ใช่วิธีการจัดกลุ่ม
- การวิเคราะห์ส่วนประกอบหลัก — การลดมิติ
- การแยกส่วนประกอบค่าเอกลักษณ์ — การลดมิติ
- การวิเคราะห์ส่วนประกอบอิสระ — การลดมิติ
ตามลำดับชั้น Clusterไอเอ็นจี
การจัดกลุ่มแบบลำดับชั้น (Hierarchical clustering) เป็นอัลกอริทึมที่สร้างลำดับชั้นของกลุ่มข้อมูล โดยเริ่มต้นจากการกำหนดข้อมูลทั้งหมดให้อยู่ในกลุ่มของตัวเอง จากนั้นกลุ่มข้อมูลสองกลุ่มที่ใกล้เคียงกันจะถูกรวมเข้าไว้ในกลุ่มเดียวกัน อัลกอริทึมนี้จะสิ้นสุดลงเมื่อเหลือกลุ่มข้อมูลเพียงกลุ่มเดียว นอกจากนี้ยังมีแนวคิดสำคัญสองประการที่ควรกล่าวถึงแยกกัน
การรวมกลุ่มแบบรวมกลุ่ม
รูปแบบการจัดกลุ่มแบบลำดับชั้นจากล่างขึ้นบนนี้ ไม่จำเป็นต้องระบุจำนวนกลุ่ม K เป็นข้อมูลป้อนเข้า กระบวนการรวมกลุ่มเริ่มต้นด้วยการสร้างแต่ละระเบียนให้เป็นกลุ่มเดียว
วิธีนี้ใช้การวัดระยะทางบางอย่างและลดจำนวนคลัสเตอร์ (หนึ่งคลัสเตอร์ในแต่ละรอบ) โดยกระบวนการรวมคลัสเตอร์ สุดท้าย เราจะมีคลัสเตอร์ขนาดใหญ่หนึ่งคลัสเตอร์ที่ประกอบด้วยวัตถุทั้งหมด และนักวิเคราะห์จะตัดต้นไม้ที่ความสูงที่ให้จำนวนกลุ่มที่เหมาะสม
เดนโดรแกรม
ในวิธีการจัดกลุ่มแบบเดนโดแกรม แต่ละระดับจะแสดงถึงกลุ่มที่เป็นไปได้ ความสูงของเดนโดแกรมแสดงถึงระดับความคล้ายคลึงกันระหว่างสองกลุ่มที่เชื่อมต่อกัน ยิ่งอยู่ใกล้ด้านล่างของกระบวนการมากเท่าไหร่ กลุ่มเหล่านั้นก็จะยิ่งคล้ายคลึงกันมากขึ้นเท่านั้น การเลือกจุดตัดที่กำหนดกลุ่มสุดท้ายนั้นไม่ใช่เรื่องอัตโนมัติและส่วนใหญ่ขึ้นอยู่กับดุลพินิจส่วนบุคคล
K หมายถึง Clusterไอเอ็นจี
K-means เป็นอัลกอริธึมการจัดกลุ่มแบบวนซ้ำซึ่งปรับปรุงกลุ่มให้ดียิ่งขึ้นping ในแต่ละรอบการทำงาน ในขั้นต้น จะมีการเลือกจำนวนคลัสเตอร์ที่ต้องการ ในวิธีการจัดคลัสเตอร์นี้ คุณต้องจัดคลัสเตอร์จุดข้อมูลเป็น k กลุ่ม ยิ่ง k มากเท่าไหร่ กลุ่มก็จะยิ่งเล็กและมีความละเอียดมากขึ้นเท่านั้น ในขณะที่ k น้อยลงหมายถึงกลุ่มที่ใหญ่ขึ้นและมีความละเอียดน้อยลง
ผลลัพธ์ของอัลกอริทึมคือกลุ่มของ "ป้ายกำกับ" โดยจะกำหนดจุดข้อมูลแต่ละจุดให้กับหนึ่งใน k กลุ่ม ในการจัดกลุ่มแบบ k-means แต่ละกลุ่มจะถูกกำหนดโดยการสร้างจุดศูนย์กลางสำหรับกลุ่มนั้น จุดศูนย์กลางเปรียบเสมือนหัวใจของกลุ่ม ซึ่งจะดึงดูดจุดที่อยู่ใกล้ที่สุดและเพิ่มเข้าไปในกลุ่ม
K- เพื่อนบ้านที่ใกล้ที่สุด
K-nearest neighbour (K-NN) เป็นตัวจำแนกประเภทข้อมูลแบบแมชชีนเลิร์นนิงที่ง่ายที่สุด มันแตกต่างจากเทคนิคแมชชีนเลิร์นนิงอื่นๆ ตรงที่มันไม่สร้างแบบจำลอง มันเป็นเพียงอัลกอริธึมง่ายๆ ที่เก็บกรณีที่มีอยู่ทั้งหมดและจำแนกอินสแตนซ์ใหม่โดยอาศัยการวัดความคล้ายคลึงกัน เนื่องจากมันต้องการกรณีที่มีป้ายกำกับเพื่อใช้ในการจำแนกประเภท K-NN จึงเป็นวิธีการแบบมีผู้กำกับดูแล ที่ปรากฏในที่นี้ก็เพราะตรรกะที่อิงตามระยะทางของมันคล้ายกับการจัดกลุ่มข้อมูล (clustering)
วิธีการนี้ได้ผลดีมากเมื่อตัวอย่างแต่ละตัวมีระยะห่างที่เหมาะสม แต่ความเร็วในการเรียนรู้จะช้าลงเมื่อชุดข้อมูลฝึกฝนมีขนาดใหญ่ และการคำนวณระยะห่างก็ซับซ้อนมาก
การวิเคราะห์องค์ประกอบหลัก
การวิเคราะห์ส่วนประกอบหลัก (Principal Component Analysis) ใช้พื้นที่มิติสูงและเลือกฐานใหม่ping เฉพาะคะแนนที่สำคัญที่สุดเท่านั้น แต่ละทิศทางในพื้นฐานนี้เรียกว่าส่วนประกอบหลัก ชุดย่อยที่คุณเก็บไว้จะก่อให้เกิดพื้นที่ใหม่ซึ่งมีขนาดเล็กกว่าพื้นที่เดิมมาก โดยจะรักษาความซับซ้อนของข้อมูลไว้ให้มากที่สุดเท่าที่จะเป็นไปได้
สมาคม
กฎความสัมพันธ์ช่วยให้คุณสร้างความสัมพันธ์ระหว่างวัตถุข้อมูลภายในฐานข้อมูลขนาดใหญ่ เทคนิคแบบไม่ใช้การกำกับดูแลนี้เกี่ยวกับการค้นหาความสัมพันธ์ที่น่าสนใจระหว่างตัวแปรในฐานข้อมูลขนาดใหญ่ และเป็นเทคนิคพื้นฐานอย่างหนึ่ง การทำเหมืองข้อมูลตัวอย่างเช่น คนที่ซื้อบ้านใหม่มักจะซื้อเฟอร์นิเจอร์ใหม่ด้วย
ตัวอย่างอื่น ๆ :
- กลุ่มย่อยของผู้ป่วยมะเร็งที่จัดกลุ่มตามการวัดการแสดงออกของยีน
- แบ่งกลุ่มผู้ซื้อตามประวัติการเรียกดูและการซื้อสินค้า
- ภาพยนตร์จัดกลุ่มตามคะแนนที่ผู้ชมให้ไว้
การเรียนรู้ของเครื่องแบบมีผู้ดูแลและแบบไม่มีผู้ดูแล
นี่คือความแตกต่างที่สำคัญระหว่าง การเรียนรู้แบบมีผู้ดูแลและแบบไม่มีผู้ดูแล:
| พารามิเตอร์ | เทคนิคการเรียนรู้ของเครื่องภายใต้การดูแล | เทคนิคการเรียนรู้ของเครื่องที่ไม่ได้รับการดูแล |
| ป้อนข้อมูล | Algorithms ได้รับการฝึกอบรมโดยใช้ข้อมูลที่ติดป้ายกำกับ | Algorithms ใช้กับข้อมูลที่ไม่มีป้ายกำกับ |
| ความซับซ้อนในการคำนวณ | การเรียนรู้แบบมีผู้สอนเป็นวิธีที่ง่ายกว่า | การเรียนรู้แบบไม่มีผู้ดูแลมีความซับซ้อนในการคำนวณ |
| ความถูกต้อง | ความแม่นยำสามารถวัดได้โดยตรงโดยเทียบกับฉลากที่ทราบแล้ว | ความแม่นยำไม่สามารถวัดได้โดยตรง ผลลัพธ์ต้องอาศัยการตีความ |
| ผลลัพธ์ทั่วไป | คำทำนายสำหรับสถิติใหม่แต่ละรายการ | กลุ่ม กฎ หรือคุณลักษณะที่ถูกบีบอัด |
การประยุกต์ใช้การเรียนรู้ของเครื่องแบบไม่มีผู้ดูแล
ตัวอย่างการประยุกต์ใช้เทคนิคการเรียนรู้แบบไม่มีผู้กำกับดูแล ได้แก่:
- Clusterระบบจะแบ่งชุดข้อมูลออกเป็นกลุ่มโดยอัตโนมัติตามความคล้ายคลึงกัน
- การตรวจจับความผิดปกติสามารถค้นพบจุดข้อมูลที่ผิดปกติในชุดข้อมูลของคุณได้ มีประโยชน์ในการค้นหาธุรกรรมที่เป็นการฉ้อโกง
- การขุดแบบเชื่อมโยงจะระบุชุดของรายการที่มักเกิดขึ้นร่วมกันในชุดข้อมูลของคุณ
- แบบจำลองตัวแปรแฝงถูกนำมาใช้กันอย่างแพร่หลายในการประมวลผลข้อมูลเบื้องต้น เช่น การลดจำนวนคุณลักษณะในชุดข้อมูล หรือการแยกชุดข้อมูลออกเป็นส่วนประกอบหลายส่วน
ข้อเสียของการเรียนรู้แบบไม่มีผู้ดูแล
- คุณไม่สามารถรับข้อมูลที่แม่นยำเกี่ยวกับการจัดเรียงข้อมูลได้ เนื่องจากข้อมูลที่ใช้ในการเรียนรู้แบบไม่มีผู้กำกับดูแลนั้นไม่มีป้ายกำกับ และกลุ่มที่แท้จริงของมันคือ...ping ไม่เป็นที่รู้จัก
- Less ความแม่นยำของผลลัพธ์ลดลง เนื่องจากข้อมูลที่ป้อนเข้าไม่เป็นที่รู้จักและไม่ได้ถูกกำหนดป้ายกำกับไว้ล่วงหน้าโดยมนุษย์ ซึ่งหมายความว่าเครื่องจักรจำเป็นต้องดำเนินการนี้ด้วยตนเอง
- คลาสสเปกตรัมไม่สอดคล้องกับคลาสข้อมูลเสมอไป
- ผู้ใช้ต้องใช้เวลาในการตีความและกำหนดป้ายกำกับให้กับกลุ่มต่างๆ ที่ได้จากการจำแนกประเภท
- คุณสมบัติเชิงสเปกตรัมของคลาสต่างๆ อาจเปลี่ยนแปลงไปตามเวลา ดังนั้นคุณจึงไม่สามารถเก็บข้อมูลคลาสเดิมไว้ได้เมื่อเปลี่ยนจากภาพหนึ่งไปยังอีกภาพหนึ่ง
