
การเรียนรู้ของเครื่องจักรภายใต้การดูแล: Algorithms, ประเภทและตัวอย่าง
 เอเวลิน คลาร์ก
⚡ สรุปอย่างชาญฉลาด
การเรียนรู้ของเครื่องแบบมีผู้กำกับดูแล (Supervised Machine Learning) ฝึกฝนอัลกอริทึมด้วยตัวอย่างที่มีป้ายกำกับ เพื่อให้สามารถทำนายผลลัพธ์สำหรับข้อมูลที่ไม่เคยเห็นมาก่อน โดยใช้การถดถอย (regression) สำหรับเป้าหมายเชิงตัวเลข และการจำแนกประเภท (classification) สำหรับเป้าหมายเชิงหมวดหมู่ เช่น สแปมหรือการฉ้อโกง
การเรียนรู้ของเครื่องภายใต้การดูแลคืออะไร?
การเรียนรู้ของเครื่องแบบมีผู้กำกับดูแล (Supervised Machine Learning) คืออัลกอริทึมที่เรียนรู้จากข้อมูลฝึกฝนที่มีการติดป้ายกำกับไว้แล้ว เพื่อช่วยในการทำนายผลลัพธ์สำหรับข้อมูลที่ไม่คาดคิด ในการเรียนรู้แบบมีผู้กำกับดูแล คุณจะฝึกฝนเครื่องจักรโดยใช้ข้อมูลที่ "ติดป้ายกำกับ" ไว้อย่างดีแล้ว ซึ่งหมายความว่าข้อมูลบางส่วนได้รับการติดแท็กด้วยคำตอบที่ถูกต้องแล้ว สามารถเปรียบเทียบได้กับการเรียนรู้ภายใต้การดูแลของผู้กำกับดูแลหรือครูผู้สอน
การสร้าง การขยายขนาด และการใช้งานโมเดลการเรียนรู้ของเครื่องแบบมีผู้กำกับดูแลที่แม่นยำนั้น ต้องใช้เวลาและความเชี่ยวชาญทางเทคนิคจากทีมงานนักวิทยาศาสตร์ข้อมูลที่มีทักษะสูง นักวิทยาศาสตร์ข้อมูลต้องสร้างโมเดลใหม่เป็นระยะๆ เพื่อให้ข้อมูลเชิงลึกที่ได้ยังคงถูกต้องแม่นยำแม้ว่าข้อมูลพื้นฐานจะเปลี่ยนแปลงไปก็ตาม
การเรียนรู้แบบมีผู้สอนทำงานอย่างไร
การเรียนรู้ของเครื่องภายใต้การดูแลใช้ชุดข้อมูลการฝึกอบรมเพื่อให้ได้ผลลัพธ์ที่ต้องการ ชุดข้อมูลเหล่านี้ประกอบด้วยอินพุตและเอาต์พุตที่ถูกต้องซึ่งช่วยให้โมเดลเรียนรู้ได้เร็วขึ้น ตัวอย่างเช่น คุณต้องการฝึกเครื่องจักรเพื่อช่วยคุณคาดการณ์ว่าจะใช้เวลานานแค่ไหนในการขับรถกลับบ้านจากที่ทำงาน
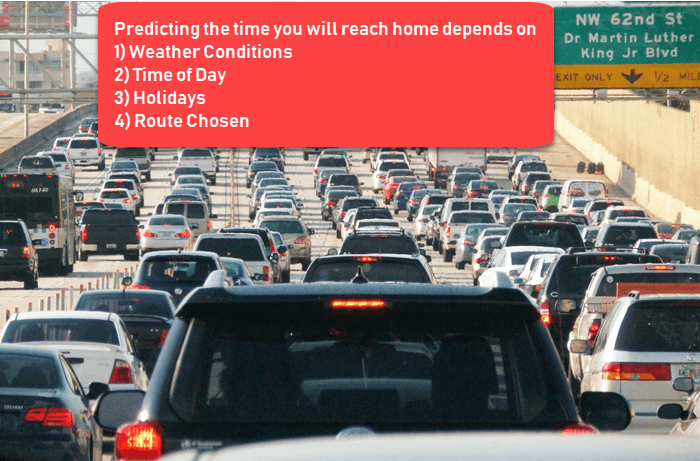
ที่นี่ คุณจะเริ่มต้นด้วยการสร้างชุดข้อมูลที่ติดป้ายกำกับ ข้อมูลนี้ประกอบด้วย:
- สภาพอากาศ
- เวลาของวัน
- เที่ยว
- เส้นทางที่เลือก
รายละเอียดทั้งหมดนี้คือข้อมูลป้อนเข้าของคุณในตัวอย่างการเรียนรู้แบบมีผู้กำกับดูแลนี้ ผลลัพธ์ที่ได้คือระยะเวลาที่ใช้ในการขับรถกลับบ้านในวันนั้น ๆ ดังที่แสดงในภาพด้านล่าง
คุณรู้โดยสัญชาตญาณว่าถ้าฝนตกข้างนอก การขับรถกลับบ้านก็จะใช้เวลานานขึ้น แต่เครื่องจักรต้องการข้อมูลและสถิติ
สิ่งแรกที่คุณต้องสร้างคือชุดข้อมูลฝึกฝน ซึ่งจะประกอบด้วยเวลาเดินทางทั้งหมดและปัจจัยที่เกี่ยวข้อง เช่น สภาพอากาศ เวลา เป็นต้น จากชุดข้อมูลฝึกฝนนี้ เครื่องของคุณอาจพบความสัมพันธ์โดยตรงระหว่างปริมาณน้ำฝนและเวลาที่คุณใช้ในการเดินทางกลับบ้าน
ดังนั้น จึงสรุปได้ว่า ยิ่งฝนตกมากเท่าไหร่ คุณก็จะยิ่งใช้เวลาขับรถกลับบ้านนานขึ้นเท่านั้น นอกจากนี้ยังอาจเห็นความสัมพันธ์ระหว่างเวลาที่คุณออกจากที่ทำงานและเวลาที่คุณอยู่บนท้องถนน ยิ่งใกล้เวลา 6 โมงเย็นมากเท่าไหร่ คุณก็จะยิ่งใช้เวลาเดินทางกลับบ้านนานขึ้นเท่านั้น
เครื่องของคุณอาจค้นพบความสัมพันธ์บางอย่างกับข้อมูลที่คุณติดป้ายกำกับไว้ ขั้นตอนการเรียนรู้นั้นแสดงไว้ด้านล่าง
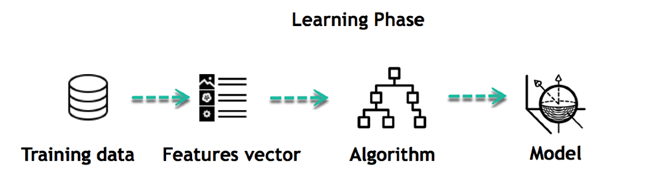
นี่คือจุดเริ่มต้นของแบบจำลองข้อมูลของคุณ มันเริ่มบันทึกว่าฝนส่งผลกระทบต่อพฤติกรรมการขับขี่ของผู้คนอย่างไร และมีผู้คนเดินทางมากขึ้นในช่วงเวลาใดของวัน
ประเภทของการเรียนรู้ของเครื่องภายใต้การดูแล Algorithms
ต่อไปนี้เป็นประเภทของอัลกอริทึมการเรียนรู้ของเครื่องจักรที่ได้รับการกำกับดูแล:
การถอยหลัง
เทคนิคการถดถอยทำนายค่าเอาต์พุตต่อเนื่องค่าเดียวโดยใช้ข้อมูลฝึกฝน
ตัวอย่าง: คุณสามารถใช้การถดถอยเพื่อทำนายราคาบ้านจากข้อมูลการฝึกอบรมได้ ตัวแปรอินพุตจะเป็นพื้นที่ ขนาดบ้าน ฯลฯ
จุดแข็ง: ผลลัพธ์ตีความได้ง่าย และสามารถปรับแต่งอัลกอริธึมเพื่อป้องกันการโอเวอร์ฟิตติ้งได้
จุดอ่อน: แบบจำลองเชิงเส้นไม่ยืดหยุ่น จึงไม่สามารถแสดงความสัมพันธ์ที่ซับซ้อนได้หากไม่มีการเพิ่มคุณลักษณะเพิ่มเติม
ต่อไปนี้เป็นประเภทการถดถอยบางส่วน Algorithms:
- การถดถอยเชิงเส้น
- การถดถอยพหุนาม
- การถดถอยแบบ Ridge และ Lasso
- การถดถอยโลจิสติก (สำหรับการจำแนกประเภท)
- ต้นไม้ตัดสินใจและการถดถอยป่าสุ่ม
- สนับสนุนการถดถอยเวกเตอร์
การถดถอยโลจิสติก:
การถดถอยโลจิสติกส์ใช้ในการประมาณค่าแบบไม่ต่อเนื่องโดยอาศัยชุดตัวแปรอิสระที่กำหนด ช่วยให้คุณทำนายความน่าจะเป็นของการเกิดเหตุการณ์โดยการปรับข้อมูลให้เข้ากับฟังก์ชันโลจิต ดังนั้นจึงเรียกอีกอย่างว่าการถดถอยโลจิต เนื่องจากเป็นการทำนายความน่าจะเป็น ค่าผลลัพธ์จึงอยู่ระหว่าง 0 ถึง 1 และอาจทำงานได้ไม่ดีนักเมื่อมีขอบเขตการตัดสินใจหลายจุดหรือที่ไม่เป็นเชิงเส้น
การจัดหมวดหมู่
การจำแนกประเภทหมายถึงการจัดกลุ่มผลลัพธ์ให้อยู่ในกลุ่มเดียวกัน หากอัลกอริทึมพยายามติดป้ายกำกับข้อมูลเข้าเป็นสองกลุ่มที่แตกต่างกัน จะเรียกว่าการจำแนกประเภทแบบไบนารี การเลือกจากมากกว่าสองกลุ่มเรียกว่าการจำแนกประเภทแบบหลายกลุ่ม
ตัวอย่าง: การพิจารณาว่าบุคคลนั้นจะผิดนัดชำระหนี้หรือไม่
จุดแข็ง: โครงสร้างข้อมูลแบบต้นไม้จำแนกประเภททำงานได้ดีมากในทางปฏิบัติ
จุดอ่อน: หากไม่มีข้อจำกัด ต้นไม้แต่ละต้นมีแนวโน้มที่จะเกิดการโอเวอร์ฟิตติ้งได้ง่าย
ต่อไปนี้เป็นประเภทการจำแนกประเภทบางส่วน Algorithms:
- ตัวจำแนกแบบ Naive Bayes
- ต้นไม้ตัดสินใจ
- สนับสนุนเครื่องเวกเตอร์
- K-เพื่อนบ้านที่ใกล้ที่สุด
- ป่าสุ่มและการเพิ่มประสิทธิภาพแบบไล่ระดับ
ตัวแยกประเภท Naive Bayes
การขอ ไร้เดียงสา Bayes โมเดลนี้สร้างง่ายและมีประโยชน์มากสำหรับชุดข้อมูลขนาดใหญ่ วิธีนี้ประกอบด้วยกราฟแบบมีทิศทางที่ไม่มีวงจร โดยมีโหนดแม่หนึ่งโหนดและโหนดลูกหลายโหนด โดยถือว่าโหนดลูกแต่ละโหนดเป็นอิสระต่อกันจากโหนดแม่
ต้นไม้แห่งการตัดสินใจ
ต้นไม้ตัดสินใจจำแนกประเภทของข้อมูลโดยการเรียงลำดับตามค่าคุณลักษณะ ในวิธีนี้ แต่ละโหนดคือคุณลักษณะของข้อมูลที่ต้องการจำแนกประเภท และแต่ละกิ่งแสดงถึงค่าที่โหนดนั้นสามารถรับได้ เป็นเทคนิคที่ใช้กันอย่างแพร่หลายในการจำแนกประเภท
โครงสร้างเดียวกันนี้สามารถใช้ได้กับการวิเคราะห์การถดถอยเช่นกัน: แผนผังการถดถอยช่วยให้คุณประมาณค่าที่แท้จริงได้ (เช่น ต้นทุนการซื้อรถยนต์ จำนวนการโทร ยอดขายรวมต่อเดือน เป็นต้น)
สนับสนุนเครื่องเวกเตอร์
เครื่องเรียนรู้แบบเวกเตอร์สนับสนุน (Support Vector Machine หรือ SVM) เป็นอัลกอริธึมการเรียนรู้ประเภทหนึ่งที่ถูกนำเสนอในช่วงทศวรรษ 1990 วิธีการนี้มีพื้นฐานมาจากผลลัพธ์ของทฤษฎีการเรียนรู้ทางสถิติที่พัฒนาโดยวลาดิมีร์ วาปนิกและเพื่อนร่วมงานของเขา
SVM ยังมีความเชื่อมโยงอย่างใกล้ชิดกับฟังก์ชันเคอร์เนล ซึ่งเป็นแนวคิดหลักสำหรับงานการเรียนรู้ส่วนใหญ่ กรอบงานเคอร์เนลและ SVM ถูกนำไปใช้ในหลากหลายสาขา รวมถึงการค้นหาข้อมูลมัลติมีเดีย ชีวสารสนเทศ และการรู้จำรูปแบบ ตัวประมาณค่าแต่ละตัวข้างต้นมีเอกสารอธิบายพร้อมพารามิเตอร์การปรับแต่งอยู่ในนั้น scikit เรียนรู้ การอ้างอิง
เทคนิคการเรียนรู้ของเครื่องแบบมีผู้กำกับดูแลเทียบกับแบบไม่มีผู้กำกับดูแล
วางวิธีการไว้ข้างๆ การเรียนรู้โดยไม่ได้รับการดูแล ทำให้ขอบเขตของมันชัดเจน
| ขึ้นอยู่กับ | เทคนิคการเรียนรู้ของเครื่องภายใต้การดูแล | เทคนิคการเรียนรู้ของเครื่องที่ไม่ได้รับการดูแล |
|---|---|---|
| ป้อนข้อมูล | Algorithms ได้รับการฝึกอบรมโดยใช้ข้อมูลที่ติดป้ายกำกับ | Algorithms ใช้กับข้อมูลที่ไม่มีป้ายกำกับ |
| ความซับซ้อนในการคำนวณ | การเรียนรู้แบบมีผู้สอนเป็นวิธีที่ง่ายกว่า | การเรียนรู้แบบไม่มีผู้ดูแลมีความซับซ้อนในการคำนวณ |
| ความถูกต้อง | วิธีการที่แม่นยำและเชื่อถือได้สูง | Less วิธีการที่แม่นยำและเชื่อถือได้ |
| อัลกอริทึมทั่วไป | การถดถอยโลจิสติกส์, ต้นไม้ตัดสินใจ, SVM, ไบเยสแบบง่าย | K-means, การจัดกลุ่มแบบลำดับชั้น, PCA |
| วิธีการประเมินผลลัพธ์ | วัดผลเทียบกับคำตอบที่ทราบแล้ว (ความถูกต้อง, RMSE) | ประเมินจากมาตรการภายในและการตรวจสอบโดยมนุษย์ |
ความท้าทายในการเรียนรู้ของเครื่องแบบมีผู้กำกับดูแล
นี่คือความท้าทายที่ต้องเผชิญในการเรียนรู้ของเครื่องภายใต้การดูแล:
- คุณลักษณะอินพุตที่ไม่เกี่ยวข้องในข้อมูลการฝึกอบรมอาจทำให้ได้ผลลัพธ์ที่ไม่ถูกต้อง
- การเตรียมข้อมูลและการประมวลผลล่วงหน้าถือเป็นเรื่องท้าทายเสมอ
- ความแม่นยำจะลดลงเมื่อป้อนค่าที่เป็นไปไม่ได้ ไม่น่าเป็นไปได้ และไม่สมบูรณ์ลงในข้อมูลฝึกฝน
- หากผู้เชี่ยวชาญที่เกี่ยวข้องไม่พร้อมให้ความช่วยเหลือ วิธีการอื่นก็คือ "การใช้กำลังทั้งหมด" ซึ่งหมายความว่าคุณต้องเดาว่าควรใช้คุณลักษณะใด (ตัวแปรป้อนเข้า) ในการฝึกเครื่องจักร และการเดานั้นอาจไม่ถูกต้อง
ข้อดีของการเรียนรู้แบบมีผู้สอน
เมื่อพิจารณาถึงความท้าทายเหล่านั้น นี่คือข้อดีของการเรียนรู้ของเครื่องจักรแบบมีผู้กำกับดูแล:
- การกำกับดูแลการเรียนรู้ใน เครื่องเรียนรู้ ช่วยให้คุณสามารถรวบรวมข้อมูลหรือสร้างผลลัพธ์ข้อมูลจากประสบการณ์ที่ผ่านมาได้
- ช่วยให้คุณปรับเกณฑ์ประสิทธิภาพให้เหมาะสมโดยใช้ประสบการณ์
- การเรียนรู้ของเครื่องภายใต้การดูแลช่วยให้คุณแก้ปัญหาการประมวลผลในโลกแห่งความเป็นจริงประเภทต่างๆ
ข้อเสียของการเรียนรู้แบบมีผู้สอน
ต่อไปนี้คือข้อเสียของการเรียนรู้ของเครื่องแบบมีผู้กำกับดูแล:
- เส้นแบ่งการตัดสินใจอาจได้รับการฝึกฝนมากเกินไป หากชุดข้อมูลฝึกฝนของคุณไม่มีตัวอย่างที่คุณต้องการให้มีอยู่ในคลาส
- คุณต้องเลือกตัวอย่างที่ดีมากมายจากแต่ละคลาสในขณะที่คุณกำลังฝึกตัวแยกประเภท
- การจำแนกประเภทข้อมูลขนาดใหญ่เป็นเรื่องที่ท้าทายมาก
- การฝึกอบรมการเรียนรู้แบบมีผู้สอนต้องใช้เวลาในการคำนวณมาก
แนวปฏิบัติที่ดีที่สุดสำหรับการเรียนรู้ภายใต้การกำกับดูแล
ลำดับขั้นตอนต่อไปนี้จะช่วยให้โครงการดำเนินต่อไปได้ track:
- ก่อนที่จะทำอย่างอื่น ให้ตัดสินใจก่อนว่าข้อมูลประเภทใดจะถูกใช้เป็นชุดข้อมูลฝึกฝน
- กำหนดโครงสร้างของฟังก์ชันที่เรียนรู้และอัลกอริธึมการเรียนรู้
- รวบรวมผลลัพธ์ที่เกี่ยวข้องจากผู้เชี่ยวชาญหรือจากการวัดผล
- เก็บชุดข้อมูลทดสอบชุดหนึ่งไว้ไม่ให้โมเดลเห็น และรายงานผลคะแนนจากชุดข้อมูลนั้น
