
SAP HANA Archiโครงสร้าง: ภาพรวมฐานข้อมูล
 ทีมบรรณาธิการ
⚡ สรุปอย่างชาญฉลาด
SAP HANA Archiโครงสร้าง ภูมิทัศน์ และการกำหนดขนาด เป็นรากฐานของแพลตฟอร์มข้อมูลในหน่วยความจำที่สร้างขึ้นบน SUSE Linux และ C++บทความนี้อธิบายเกี่ยวกับเซิร์ฟเวอร์ดัชนี กลไกการจัดเก็บข้อมูล ที่เก็บข้อมูลแบบแถวและแบบคอลัมน์ การผสานข้อมูลแบบเดลต้า และวิธีการกำหนดขนาดฮาร์ดแวร์
ความหมายของ SAP ฐานข้อมูล HANA?
SAP HANA เป็นแพลตฟอร์มการจัดการข้อมูลที่เน้นหน่วยความจำหลัก ฐานข้อมูลทำงานบน SUSE Linux Enterprise Server (SLES) และ Red Hat Enterprise Linux (RHEL) และเขียนด้วยภาษา C++สามารถขยายการทำงานไปยังเครื่องหลายเครื่องเพื่อรองรับปริมาณงานขนาดใหญ่มากได้
ข้อได้เปรียบที่สำคัญของ SAP ฮานะ:
- ประสิทธิภาพการสืบค้นข้อมูลรวดเร็วเป็นพิเศษ เนื่องจากข้อมูลทั้งหมดถูกโหลดลงในหน่วยความจำ ทำให้ขจัดปัญหาการอ่านเขียนข้อมูลจากดิสก์ที่ช้าออกไปจากเส้นทางวิกฤต
- การผสมผสาน OLAP (Online Analytical Processing) และ OLTP (Online Transaction Processing) ไว้ในฐานข้อมูลเดียวกัน ช่วยลดความซับซ้อนของระบบข้อมูล
SAP ฐานข้อมูล HANA สร้างขึ้นจากชุดของเอนจินประมวลผลในหน่วยความจำ เอนจินคำนวณเป็นเอนจินหลักและทำงานร่วมกับเอนจินอื่นๆ เช่น เอนจินเชิงสัมพันธ์ (แบบแถวและแบบคอลัมน์) เอนจิน OLAP เอนจินข้อความ และเอนจินกราฟ ตารางเชิงสัมพันธ์จะจัดเก็บอยู่ในแบบแถวหรือแบบคอลัมน์ และเอนจินเพิ่มเติมจะจัดการข้อมูลข้อความและกราฟตราบเท่าที่มีหน่วยความจำว่างอยู่
SAP HANA Archiเทคเจอร์
ข้อมูลในคอลัมน์สโตร์จะถูกบีบอัดโดยใช้เทคนิคต่างๆ เช่น การเข้ารหัสแบบพจนานุกรม การเข้ารหัสแบบรัน-เลิร์ต การเข้ารหัสแบบสปาร์ส การเข้ารหัสแบบคลัสเตอร์ และการเข้ารหัสแบบทางอ้อม เมื่อถึงขีดจำกัดของหน่วยความจำหลัก วัตถุในฐานข้อมูลที่ไม่ได้ใช้งาน (ตาราง มุมมอง ฯลฯ) จะถูกถ่ายโอนไปยังดิสก์โดยอัตโนมัติ และจะถูกโหลดกลับมาเมื่อมีการร้องขออีกครั้ง
ผู้ดูแลระบบยังสามารถโหลดหรือยกเลิกการโหลดตารางแต่ละตารางด้วยตนเองได้โดยการคลิกขวาที่ตารางนั้น SAP ฮานะ สตูดิโอ และเลือก ปลดปล่อย or โหลด.
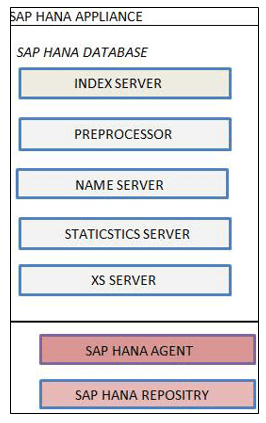
SAP HANA Server ประกอบด้วย:
- เซิร์ฟเวอร์ดัชนี
- เซิร์ฟเวอร์ตัวประมวลผลล่วงหน้า
- เซิร์ฟเวอร์ชื่อ
- เซิร์ฟเวอร์สถิติ
- เครื่องยนต์ XS
1. SAP เซิร์ฟเวอร์ดัชนี HANA
เซิร์ฟเวอร์ดัชนีเป็นส่วนหลัก SAP ส่วนประกอบฐานข้อมูล HANA:
- มันคือหัวใจของ SAP เอนจินฐานข้อมูล HANA
- ประกอบด้วยแหล่งเก็บข้อมูลจริงและเครื่องมือที่ใช้ประมวลผลข้อมูล
- โปรแกรมนี้จะทำการประมวลผลคำสั่ง SQL และ MDX ที่เข้ามา
โครงสร้างสถาปัตยกรรมของ Index Server แสดงไว้ด้านล่าง

SAP ภาพรวมเซิร์ฟเวอร์ดัชนี HANA
- เซสชันและผู้จัดการธุรกรรม: คอมโพเนนต์ Session ทำหน้าที่จัดการการเชื่อมต่อและเซสชันสำหรับฐานข้อมูล คอมโพเนนต์ Transaction Manager ทำหน้าที่ประสานงานและควบคุมธุรกรรมทั้งหมด
- โปรเซสเซอร์ SQL และ MDX: ตัวประมวลผล SQL จะส่งคำสั่งค้นหาไปยังเอนจินที่เหมาะสม (SQL / SQL Script / R / Calc Engine) ส่วนตัวประมวลผล MDX จะจัดการคำสั่งค้นหาแบบหลายมิติ (ตัวอย่างเช่น การค้นหาในมุมมองเชิงวิเคราะห์)
- SQL / สคริปต์ SQL / R / Calc Engine: ดำเนินการคำสั่ง SQL, สคริปต์ SQL, ภาษา R และแบบจำลองการคำนวณกับข้อมูล
- พื้นที่เก็บข้อมูล: รักษาการกำหนดเวอร์ชันสำหรับ SAP อ็อบเจ็กต์เมตาเดตาของ HANA เช่น Attribute Views, Analytic Views และ Stored Procedures
- ชั้นการคงอยู่ของข้อมูล: มีระบบกู้คืนข้อมูลอัตโนมัติเมื่อเกิดภัยพิบัติ โดยจะบันทึกจุดสำรองและบันทึกเหตุการณ์ลงในไดรฟ์ข้อมูลบนดิสก์
2. เซิร์ฟเวอร์พรีโปรเซสเซอร์
เซิร์ฟเวอร์พรีโปรเซสเซอร์ถูกใช้โดยการวิเคราะห์ข้อความtracts จะเตรียมข้อมูลจากเนื้อหาข้อความเมื่อมีการเรียกใช้ฟังก์ชันการค้นหา
3. เนมเซิร์ฟเวอร์
เนมเซิร์ฟเวอร์เก็บข้อมูลเกี่ยวกับโครงสร้างระบบทั้งหมด ในการใช้งานแบบกระจายศูนย์นั้น... tracks ระบุส่วนประกอบที่กำลังทำงานอยู่ทั้งหมดและตำแหน่งของข้อมูลในโหนดต่างๆ เพื่อให้สามารถส่งคำขอไปยังเซิร์ฟเวอร์ที่ถูกต้องได้
4. เซิร์ฟเวอร์สถิติ
เซิร์ฟเวอร์สถิติจะรวบรวมข้อมูลสถานะ การจัดสรรทรัพยากร การใช้งาน และประสิทธิภาพสำหรับ SAP ระบบ HANA หมายเหตุ: ใน HANA SPS 7 และเวอร์ชันที่ใหม่กว่า บริการสถิติแบบฝังตัวจะทำงานอยู่ภายในเซิร์ฟเวอร์ดัชนี แทนที่จะเป็นกระบวนการแบบแยกต่างหาก
5. XS Server
XS Server เป็นที่ตั้งของ XS Engine ซึ่งช่วยให้แอปพลิเคชันภายนอกและนักพัฒนาสามารถใช้งานได้ SAP ฐานข้อมูล HANA ผ่าน HTTP XS Engine ทำหน้าที่เป็นเซิร์ฟเวอร์ HTTP ขนาดเล็ก ทำให้ไคลเอนต์ที่ทำงานบนเว็บเบราว์เซอร์และ REST สามารถสื่อสารกับ HANA ได้โดยตรง
SAP ภูมิทัศน์ฮานะ
“HANA” ย่อมาจาก อุปกรณ์วิเคราะห์ประสิทธิภาพสูง และถูกส่งมอบในรูปแบบแพลตฟอร์มที่ผสานรวมทั้งฮาร์ดแวร์และซอฟต์แวร์
- ฮาร์ดแวร์สมัยใหม่มีจำนวนคอร์ CPU, RAM และแบนด์วิดท์ในการจัดเก็บข้อมูลมากกว่าที่เซิร์ฟเวอร์ฐานข้อมูลรุ่นเก่าได้รับการออกแบบมาให้ใช้งานอย่างมาก
- SAP HANA ใช้ประโยชน์จากจุดนี้โดย keeping ข้อมูลการทำงานทั้งหมดถูกจัดเก็บไว้ในหน่วยความจำหลัก ซึ่งช่วยขจัดปัญหาคอขวดด้านการอ่าน/เขียนข้อมูลจากดิสก์ (Disk I/O) ที่เป็นข้อจำกัดของฐานข้อมูลแบบดั้งเดิม
แผนภาพด้านล่างสรุปสิ่งต่อไปนี้ SAP นวัตกรรมด้านฮาร์ดแวร์และซอฟต์แวร์ของ HANA

SAP HANA รองรับระบบจัดเก็บข้อมูลเชิงสัมพันธ์สองประเภท: ร้านแถว และ ร้านขายคอลัมน์.
ร้านแถว
Row Store ทำงานเหมือนฐานข้อมูลแบบดั้งเดิม (Oracle(SQL Server) ความแตกต่างที่สำคัญคือ ข้อมูลทุกแถวจะถูกเก็บไว้ในหน่วยความจำหลักใน SQL Server SAP HANA เก็บข้อมูลไว้ในรูปแบบดิสก์เป็นหลัก ในขณะที่ฐานข้อมูลแบบดั้งเดิมเก็บข้อมูลไว้ในรูปแบบดิสก์เป็นหลัก
ร้านขายคอลัมน์
Column Store จัดเก็บข้อมูลในรูปแบบคอลัมน์ในหน่วยความจำ โดยตารางคอลัมน์จะถูกจัดเก็บไว้ที่นี่ และกลไกการทำงานจะปรับสมดุลระหว่างประสิทธิภาพการเขียนที่ดีกับประสิทธิภาพการอ่านที่เหมาะสมที่สุด แผนภาพด้านล่างแสดงโครงสร้างสองแบบที่ช่วยให้เกิดความสมดุลนี้

ที่เก็บข้อมูลหลัก
พื้นที่จัดเก็บข้อมูลหลักเป็นที่เก็บข้อมูลส่วนใหญ่ วิธีการบีบอัดข้อมูล เช่น การเข้ารหัสแบบพจนานุกรม การเข้ารหัสแบบคลัสเตอร์ การเข้ารหัสแบบสปาร์ส และการเข้ารหัสแบบรันเลนท์ ถูกนำมาใช้เพื่อประหยัดหน่วยความจำและเพิ่มความเร็วในการค้นหา
- การแก้ไขข้อมูลที่ถูกบีบอัดโดยตรงในหน่วยความจำหลักนั้นมีค่าใช้จ่ายสูง ดังนั้นการเขียนข้อมูลจึงไม่มุ่งเป้าไปที่หน่วยความจำหลัก
- แต่การเปลี่ยนแปลงทุกอย่างจะถูกบันทึกไว้ในพื้นที่แยกต่างหากที่เรียกว่า Delta พื้นที่จัดเก็บการอ่านข้อมูลสามารถทำได้ทั้งจากหน่วยความจำหลักหรือหน่วยความจำสำรอง (delta storage)
สามารถโหลดหรือดึงข้อมูลออกได้ด้วยตนเองโดยใช้ โหลดเข้าสู่หน่วยความจำ และ ยกเลิกการโหลดจากหน่วยความจำ ตัวเลือกแสดงอยู่ด้านล่าง

Delta พื้นที่จัดเก็บ
Delta พื้นที่จัดเก็บข้อมูลนี้ได้รับการปรับให้เหมาะสมสำหรับการเขียนข้อมูลและใช้การบีบอัดที่เบากว่า การเปลี่ยนแปลงทั้งหมดที่ยังไม่ได้ยืนยันในตารางคอลัมน์จะถูกเก็บไว้ที่นี่ เมื่อต้องการรวมการเปลี่ยนแปลงกลับไปยังพื้นที่จัดเก็บข้อมูลหลัก ให้เรียกใช้คำสั่ง Delta ผสาน การดำเนินการจาก SAP ฮานะ สตูดิโอ.

- การรวมเดลต้าจะย้ายการเปลี่ยนแปลงที่รวบรวมไว้ในพื้นที่จัดเก็บเดลต้าไปยังพื้นที่จัดเก็บหลัก
- หลังจากรวมข้อมูลแล้ว เนื้อหาในที่จัดเก็บหลักใหม่จะถูกบันทึกไปยังดิสก์ และจะคำนวณการบีบอัดใหม่อีกครั้ง
วิธีการเคลื่อนย้ายข้อมูลจาก Delta ไปยังที่เก็บหลัก

บัฟเฟอร์ที่จัดเรียงตามแถวเรียกว่า L1-Delta อยู่ด้านหน้าของตารางคอลัมน์ทุกตาราง ซึ่งเป็นเหตุผลว่าทำไมตารางคอลัมน์จึงสามารถรองรับการเขียนข้อมูลปริมาณมากได้
- ผู้ใช้ทำการอัปเดตหรือแทรกข้อมูลลงในตาราง
- ข้อมูลจะถูกส่งไปยัง L1 ก่อนDelta (ข้อมูลที่ยังไม่ได้บันทึก)
- เมื่อยืนยันข้อมูลแล้ว ข้อมูลจะถูกย้ายไปยัง L2- ซึ่งเป็นหน่วยความจำแบบคอลัมน์Delta buffer
- เมื่อ L2-Delta หากพื้นที่เต็มหรือกระบวนการผสานข้อมูลทำงาน ข้อมูลจะถูกเขียนไปยังพื้นที่จัดเก็บหลัก
ดังนั้น การจัดเก็บข้อมูลแบบคอลัมน์จึงได้รับการปรับให้เหมาะสมทั้งในด้านการเขียน (ผ่าน L1 และ L2 delta) และการอ่าน (ผ่านหน่วยเก็บข้อมูลหลัก) หลังจากประมวลผลแล้ว ข้อมูลจะถูกจัดเก็บอย่างถาวรลงดิสก์โดยเลเยอร์การคงอยู่ของข้อมูล
ตัวอย่างตารางแบบแถว:

ตารางเชิงตรรกะเดียวกันอาจถูกจัดเก็บลงดิสก์ในรูปแบบที่แตกต่างกัน ขึ้นอยู่กับประเภทของที่เก็บข้อมูล ในการจัดเก็บแบบแถว (Row Store) แถวต่างๆ จะถูกเขียนติดกัน:

ในการจัดเก็บแบบคอลัมน์ ค่าจากคอลัมน์เดียวกันจะถูกจัดเก็บไว้ด้วยกัน:

เนื่องจากค่าในคอลัมน์มีชนิดข้อมูลเดียวกันและมักซ้ำกัน โครงสร้างคอลัมน์จึงบีบอัดข้อมูลได้ดีมาก ซึ่งเป็นข้อได้เปรียบหลักด้านหน่วยความจำของที่เก็บข้อมูลแบบคอลัมน์

SAP การกำหนดขนาด HANA
การกำหนดขนาดคือกระบวนการในการพิจารณาทรัพยากรฮาร์ดแวร์ — RAM, ดิสก์ และ CPU — ที่จำเป็นสำหรับระบบ SAP ระบบ HANA หน่วยความจำเป็นปัจจัยสำคัญที่สุด รองลงมาคือ CPU และดิสก์เป็นผลสืบเนื่องมาจากสองปัจจัยแรก
ใน SAP ในการติดตั้งใช้งาน HANA การเลือกขนาดเซิร์ฟเวอร์ที่เหมาะสมกับปริมาณงานทางธุรกิจถือเป็นหนึ่งในงานที่สำคัญที่สุด เมื่อเปรียบเทียบกับระบบจัดการฐานข้อมูลแบบดั้งเดิม การกำหนดขนาดของ HANA จะแตกต่างกันในสามด้าน:
- หน่วยความจำหลัก: โดยอาศัยข้อมูลเมตา รวมถึงปริมาณข้อมูลธุรกรรมและข้อมูลวิเคราะห์ที่จัดเก็บไว้ในหน่วยความจำ
- ซีพียู: เป็นการประมาณการ ไม่ใช่การวัดโดยตรง โดยอิงจากคำถามพยากรณ์และรูปแบบการใช้โหลด
- ดิสก์: ออกแบบมาเพื่อการจัดเก็บข้อมูลถาวรและปริมาณไฟล์บันทึก ไม่ใช่สำหรับข้อมูลการสืบค้นแบบเรียลไทม์
CPU และหน่วยความจำของเซิร์ฟเวอร์แอปพลิเคชันยังคงไม่เปลี่ยนแปลงเมื่อเทียบกับฐานข้อมูลเดิม เนื่องจาก HANA แทนที่เฉพาะส่วนของฐานข้อมูลเท่านั้น
SAP มีวิธีการคำนวณขนาดที่ถูกต้องหลายวิธี:
- การกำหนดขนาดโดยใช้รายงาน ABAP (รหัสธุรกรรม) ST03 ข้อมูลและรายงาน /SDF/HDB_SIZING).
- การกำหนดขนาดโดยใช้สคริปต์ฐานข้อมูลสำหรับระบบที่ไม่ใช่ ABAP
- การกำหนดขนาดโดยใช้ SAP การวัดขนาดอย่างรวดเร็ว เครื่องมือบน SAP ตลาดซื้อขายบริการ
เมื่อใช้เครื่องมือ Quick Sizer ความต้องการจะแสดงในรูปแบบด้านล่างนี้

