
SAP DS (บริการข้อมูล) ใน HANA
 เมสัน การ์เซีย
⚡ สรุปอย่างชาญฉลาด
SAP Data Services คือแพลตฟอร์ม ETL ระดับองค์กรที่เคลื่อนย้ายและทำความสะอาดข้อมูลจากแหล่งข้อมูลที่หลากหลายเข้าสู่ระบบ SAP HANA ประกอบด้วย Designer, Job Server, Engine, Repository และ Access Server ที่ทำงานร่วมกันเพื่อสร้าง กำหนดเวลา และเรียกใช้งานโฟลว์ข้อมูล
ความหมายของ SAP บริการข้อมูล?
SAP Data Services คือเครื่องมือ ETL ที่มอบโซลูชันระดับองค์กรแบบครบวงจรสำหรับการบูรณาการข้อมูล การแปลงข้อมูล คุณภาพข้อมูล การวิเคราะห์ข้อมูล และการประมวลผลข้อมูลข้อความจากแหล่งข้อมูลที่หลากหลายไปยังฐานข้อมูลเป้าหมายหรือคลังข้อมูล
แอปพลิเคชัน หรือที่เรียกว่างาน จะถูกสร้างขึ้นใน Designer ซึ่งเป็นที่ที่ข้อมูลถูกแมปping และการเปลี่ยนแปลงได้รับการกำหนดไว้ ผลิตภัณฑ์นี้ยังถูกเรียกว่า SAP บริการข้อมูล BusinessObjects ซึ่งย่อว่า SAP BODS และชื่อทั้งสองนี้ใช้เรียกเครื่องมือชนิดเดียวกัน SAP Data Services เวอร์ชัน 4.3 เป็นเวอร์ชันปัจจุบัน เวอร์ชัน 4.2 สิ้นสุดการบำรุงรักษาหลักเมื่อวันที่ 31 พฤษภาคม 2023 ดังนั้นการใช้งานใหม่ควรเริ่มต้นที่เวอร์ชัน 4.3
ภายในไฟล์ SAP ภูมิทัศน์ของ HANA, SAP บริการจัดการข้อมูล (Data Services) เป็นตัวเลือกที่เหมาะสมเมื่อต้องการปรับเปลี่ยนรูปแบบข้อมูลระหว่างการนำเข้า แทนที่จะคัดลอกข้อมูลในรูปแบบเดิม ส่วนต่างๆ ด้านล่างนี้จะกล่าวถึงสิ่งที่เครื่องมือนี้มีให้ วิธีการทำงานร่วมกันของส่วนต่างๆ และขั้นตอนการทำงานทั้งหมดตั้งแต่ต้นจนจบ SAP ตาราง ECC ลงในตาราง SAP ฮานะ.
คุณสมบัติของ SAP บริการข้อมูล
ความสามารถด้านล่างนี้จะอธิบายว่าทำไม SAP Data Services ถูกวางตำแหน่งให้เป็นแพลตฟอร์มระดับองค์กร ไม่ใช่เพียงแค่โปรแกรมคัดลอกข้อมูลธรรมดา
- ให้การแปลงแบบขนานที่มีประสิทธิภาพสูง
- มีเครื่องมือบริหารจัดการที่ครบครันและเครื่องมือรายงานผล
- รองรับผู้ใช้หลายคน
- SAP ร่างกาย มีความยืดหยุ่นสูงในการใช้งานกับแอปพลิเคชันที่ใช้บริการบนเว็บ
- มันอนุญาตให้ใช้ภาษาสคริปต์ที่มีฟังก์ชันมากมาย
- SAP บริการข้อมูลสามารถบูรณาการร่วมกับ SAP เซิร์ฟเวอร์จำลองข้อมูล LT (SLT) โดยใช้เทคโนโลยีแบบทริกเกอร์ SLT เพิ่มความสามารถด้านเดลต้าให้กับทุกๆ SAP หรือไม่ -SAP ตารางต้นทาง ซึ่งอนุญาตให้บันทึกการเปลี่ยนแปลงข้อมูลและถ่ายโอนข้อมูลส่วนต่างจากตารางต้นทางได้
- การตรวจสอบข้อมูลด้วยแดชบอร์ดและการตรวจสอบกระบวนการ
- เครื่องมือบริหารจัดการที่มีฟังก์ชันการกำหนดตารางเวลาและแดชบอร์ดสำหรับการตรวจสอบ
- การดีบัก, การวิเคราะห์ประสิทธิภาพในตัว และการดูข้อมูล
- SAP ฝ่ายบริการข้อมูลรองรับแหล่งข้อมูลและเป้าหมายที่หลากหลาย:
- ตัวอย่างเช่น แอปพลิเคชันใดๆ ก็ได้ SAP.
- ฐานข้อมูลใดก็ได้ที่มีฟังก์ชันการโหลดข้อมูลจำนวนมากและการบันทึกการเปลี่ยนแปลงข้อมูล
- ไฟล์: ความกว้างคงที่, คั่นด้วยเครื่องหมายจุลภาค, COBOL, XML และอื่นๆ Excel.
คุณสมบัติเหล่านี้ถูกส่งมอบโดยชุดส่วนประกอบที่ติดตั้งได้จำนวนเล็กน้อย ซึ่งแต่ละส่วนมีบทบาทที่แตกต่างกัน
องค์ประกอบของ SAP บริการข้อมูล
SAP บริการข้อมูลประกอบด้วยส่วนประกอบดังต่อไปนี้
- นักออกแบบ – เป็นเครื่องมือพัฒนาซอฟต์แวร์ที่ช่วยให้เราสร้าง ทดสอบ และเรียกใช้งานกระบวนการที่เติมข้อมูลลงในคลังข้อมูลได้ เครื่องมือนี้ช่วยให้นักพัฒนาสามารถสร้างและกำหนดค่าวัตถุต่างๆ ได้โดยการเลือกไอคอนในแผนภาพการไหลจากแหล่งที่มาไปยังเป้าหมาย นอกจากนี้ยังสามารถใช้สร้างแอปพลิเคชันโดยการระบุเวิร์กโฟลว์และการไหลของข้อมูลได้อีกด้วย หากต้องการเปิด Data Services Designer ให้ไปที่ เมนูเริ่ม -> โปรแกรมทั้งหมด -> SAP บริการข้อมูล -> นักออกแบบบริการข้อมูล.

- เซิร์ฟเวอร์งาน – เป็นแอปพลิเคชันที่เรียกใช้งานกลไกประมวลผลข้อมูลของบริการข้อมูล และทำหน้าที่เป็นส่วนเชื่อมต่อกับกลไกดังกล่าวและชุดโปรแกรมบริการข้อมูล
- เครื่องยนต์ – เอ็นจิ้นบริการข้อมูลจะดำเนินการงานแต่ละงานที่กำหนดไว้ในแอปพลิเคชัน
- กรุ – ที่เก็บข้อมูล (Repository) คือฐานข้อมูลที่จัดเก็บวัตถุที่กำหนดไว้ล่วงหน้าของ Designer และวัตถุที่ผู้ใช้กำหนดเอง (เมตาเดต้าของแหล่งที่มาและเป้าหมาย กฎการแปลง) ที่เก็บข้อมูลมีสองประเภท:
- พื้นที่เก็บข้อมูลท้องถิ่น (ใช้โดย Designer และ Job Server)
- พื้นที่เก็บข้อมูลกลาง (ใช้สำหรับการแชร์วัตถุและการควบคุมเวอร์ชัน)
- เข้าถึงเซิร์ฟเวอร์ – เซิร์ฟเวอร์การเข้าถึง (Access Server) ทำหน้าที่ส่งต่อข้อความระหว่างเว็บแอปพลิเคชัน เซิร์ฟเวอร์งานบริการข้อมูล (Data Services Job Server) และเอนจิ้นต่างๆ
- ผู้บริหาร – ผู้ดูแลระบบเว็บมีหน้าที่จัดการทรัพยากรบริการข้อมูลผ่านทางเบราว์เซอร์ โดยมีรายละเอียดดังต่อไปนี้:
- การกำหนดค่า การเริ่มต้น และการหยุดping บริการแบบเรียลไทม์
- การวางแผน การตรวจสอบ และการดำเนินการงานแบบแบตช์
- การกำหนดค่าเซิร์ฟเวอร์งาน เซิร์ฟเวอร์การเข้าถึง และการใช้งานที่เก็บข้อมูล
- การจัดการผู้ใช้
- การเผยแพร่งานแบบแบตช์และบริการแบบเรียลไทม์ผ่านบริการเว็บ
- การกำหนดค่าและการจัดการอะแด็ปเตอร์
การรู้ว่าแต่ละส่วนประกอบทำหน้าที่อะไรนั้นเป็นเพียงครึ่งหนึ่งของภาพรวมทั้งหมด สถาปัตยกรรมด้านล่างแสดงให้เห็นว่าส่วนประกอบเหล่านั้นสื่อสารกันอย่างไรในระหว่างการทำงาน
SAP บริการข้อมูล Archiเทคเจอร์
สถาปัตยกรรมบริการข้อมูลประกอบด้วยส่วนประกอบดังต่อไปนี้:
- ที่เก็บข้อมูลส่วนกลาง – ใช้สำหรับการกำหนดค่าที่เก็บข้อมูลไปยังเซิร์ฟเวอร์งาน การจัดการความปลอดภัย การควบคุมเวอร์ชัน และการแชร์วัตถุ
- นักออกแบบ – ใช้ในการสร้างโครงการ งาน ขั้นตอนการทำงาน และการไหลของข้อมูล รวมถึงการบริหารจัดการสิ่งเหล่านั้น
- พื้นที่เก็บข้อมูลภายในเครื่อง – ที่นี่คุณสามารถสร้าง แก้ไข และเริ่มต้นงาน เวิร์กโฟลว์ และกระแสข้อมูลได้
- เซิร์ฟเวอร์และกลไกจัดการงาน – ทำหน้าที่จัดการงานต่างๆ
- เซิร์ฟเวอร์การเข้าถึง – ใช้สำหรับประมวลผลงานแบบเรียลไทม์ที่นักพัฒนาสร้างขึ้นในที่เก็บข้อมูล
ภาพด้านล่างแสดงให้เห็นถึงบริการข้อมูลและความสัมพันธ์ระหว่างส่วนประกอบต่างๆ

SAP ร่างกาย Archiเทคเจอร์
รายละเอียดหน้าต่างดีไซเนอร์
ส่วนออกแบบ (Designer) เป็นส่วนประกอบที่นักพัฒนาใช้เวลาอยู่ด้วยมากที่สุด ดังนั้นจึงควรเรียนรู้โครงสร้างของมันก่อน รายละเอียดของแต่ละส่วนใน Data Services Designer มีดังต่อไปนี้:
- แถบเครื่องมือ (ใช้สำหรับ เปิด, บันทึก, ย้อนกลับ, ตรวจสอบความถูกต้อง, เรียกใช้ ฯลฯ)
- พื้นที่โครงการ (ประกอบด้วยโครงการปัจจุบัน ซึ่งรวมถึงงาน กระบวนการทำงาน และการไหลของข้อมูล ในบริการข้อมูล เอนทิตีทั้งหมดเป็นอ็อบเจ็กต์)
- พื้นที่ทำงาน (พื้นที่หน้าต่างแอปพลิเคชันที่เราใช้ในการกำหนด แสดง และแก้ไขวัตถุ)
- ไลบรารีวัตถุในเครื่อง (ซึ่งประกอบด้วยอ็อบเจ็กต์ในที่เก็บข้อมูลภายในเครื่อง เช่น การแปลงข้อมูล งาน เวิร์กโฟลว์ การไหลของข้อมูล เป็นต้น)
- จานเครื่องมือ (ปุ่มบนแถบเครื่องมือช่วยให้คุณสามารถเพิ่มวัตถุใหม่ลงในพื้นที่ทำงานได้)

ลำดับชั้นของวัตถุ
แผนภาพด้านล่างแสดงความสัมพันธ์เชิงลำดับชั้นของประเภทวัตถุหลักภายในบริการข้อมูล

หมายเหตุ คำอธิบายด้านล่างระบุองค์ประกอบเสริมในลำดับชั้น

ขั้นตอนการทำงานและเงื่อนไขต่างๆ เป็นตัวเลือกเสริม
วัตถุที่ใช้ใน SAP รายละเอียดบริการข้อมูลมีดังต่อไปนี้
| วัตถุ | Descriptไอออน |
|---|---|
| โครงการ | โปรเจกต์เป็นวัตถุระดับสูงสุดในหน้าต่าง Designer โปรเจกต์ช่วยให้คุณจัดระเบียบวัตถุอื่นๆ ที่คุณสร้างใน Data Services ได้ โดยจะมีโปรเจกต์เปิดอยู่เพียงครั้งละหนึ่งโปรเจกต์เท่านั้น ซึ่ง "เปิดอยู่" หมายถึง "มองเห็นได้ในพื้นที่โปรเจกต์" |
| การสัมภาษณ์ | "งาน" คือหน่วยงานที่เล็กที่สุดที่คุณสามารถกำหนดตารางเวลาสำหรับการดำเนินการได้อย่างอิสระ |
| สคริปต์ | ชุดย่อยของบรรทัดในกระบวนงาน |
| Workflow | "เวิร์กโฟลว์" คือการผสานรวมกระแสข้อมูลหลายๆ กระแสเข้าด้วยกันเป็นขั้นตอนการทำงานที่สอดคล้องกันสำหรับงานทั้งหมด เวิร์กโฟลว์นั้นเป็นทางเลือก เวิร์กโฟลว์คือกระบวนการที่สามารถทำได้ดังนี้:
|
| กระแสข้อมูล | “โฟลว์ข้อมูล” คือกระบวนการที่ข้อมูลต้นทางถูกแปลงเป็นข้อมูลปลายทาง โฟลว์ข้อมูลเป็นวัตถุที่นำกลับมาใช้ใหม่ได้ โดยจะถูกเรียกใช้จากเวิร์กโฟลว์หรือจ็อบเสมอ และใช้เพื่อ:
|
| ที่เก็บข้อมูล | ช่องทางเชิงตรรกะที่เชื่อมต่อบริการข้อมูลกับฐานข้อมูลต้นทางและปลายทาง แหล่งเก็บข้อมูล:
|
| Target | ตารางหรือไฟล์ที่บริการข้อมูลใช้ในการโหลดข้อมูลจากแหล่งที่มา |
SAP บริการข้อมูล เทียบกับ SLT เทียบกับ DXC
SAP บริการข้อมูลเป็นหนึ่งในหลายๆ บริการ การจัดเตรียมข้อมูล ตัวเลือกสำหรับ SAP HANA และการเลือกวิธีที่ไม่ถูกต้องจะเพิ่มต้นทุนที่การปรับแต่งใดๆ ก็ไม่สามารถชดเชยได้ ตารางด้านล่างเปรียบเทียบวิธีการฝั่งเซิร์ฟเวอร์ทั้งสามวิธี
| หลักเกณฑ์ | SAP บริการข้อมูล | SLT | DXC |
|---|---|---|---|
| ความแอบแฝง | แบบกลุ่มหรือตามกำหนดเวลา | เวลาจริง | การประมวลผลแบบกลุ่ม ตามกำหนดเวลาโดยแหล่งข้อมูล |
| การแปลง | กระบวนการ ETL เต็มรูปแบบ การทำความสะอาดและวิเคราะห์ข้อมูล | กฎการกรองและฟิลด์แบบง่าย | ไม่มีอะไรนอกเหนือจากอดีตtracตรรกะทอร์ |
| ขอบเขตแหล่งที่มา | SAP และไม่ใช่ -SAPไฟล์ แอปพลิเคชัน | SAP และไม่ใช่ -SAP ฐานข้อมูล | SAP ห้องสวีทสำหรับนักธุรกิจเท่านั้น |
| ต้องใช้เซิร์ฟเวอร์เพิ่มเติม | ใช่ เซิร์ฟเวอร์งาน | โดยปกติใช่ | ไม่ |
| เหมาะที่สุดสำหรับ | คุณภาพข้อมูลและการรวมข้อมูลจากหลายแหล่ง | Operaการรายงานข่าวระดับชาติเกี่ยวกับข้อมูลแบบเรียลไทม์ | การนำเนื้อหาทางธุรกิจที่มีอยู่แล้วมาใช้ซ้ำ เช่นtracโปร |
สรุปคือเลือก SAP เลือกใช้บริการข้อมูล (Data Services) เมื่อข้อมูลจำเป็นต้องได้รับการทำความสะอาด เชื่อมโยง หรือจัดมาตรฐานก่อนที่จะส่งไปยังระบบ เลือก SLT เมื่อรายงานต้องสะท้อนถึงธุรกรรมตามที่เกิดขึ้นจริง และ DXC เมื่อผู้เชี่ยวชาญด้านเนื้อหาธุรกิจที่ได้รับการพิสูจน์แล้วtractor สร้างความหมายที่คุณต้องการไว้แล้ว สำหรับชุดข้อมูลแบบครั้งเดียวที่ไม่มีกำหนดการทำซ้ำ การอัปโหลดไฟล์แบบเรียบ เร็วกว่าการตั้งค่าทั้งสามวิธีใดๆ ทั้งสิ้น
วิธีการโหลดข้อมูลจาก SAP ตารางแหล่งที่มาโดยใช้ SAP บริการข้อมูล
ทุกอย่างใน Data Services เป็นอ็อบเจ็กต์ จึงจำเป็นต้องมีที่เก็บข้อมูลแยกต่างหากสำหรับฐานข้อมูลต้นทางและฐานข้อมูลปลายทางแต่ละแห่ง
ลำดับขั้นตอนทั้งหมดสำหรับการโหลดข้อมูลจาก SAP ตารางต้นฉบับแสดงอยู่ด้านล่าง จากนั้นจะแสดงแต่ละขั้นตอนโดยละเอียด
- สร้างที่เก็บข้อมูลระหว่างแหล่งข้อมูลและ BODS
- นำเข้าเมตาเดตา (โครงสร้าง) เข้าสู่ BODS
- กำหนดค่าเซิร์ฟเวอร์นำเข้า
- นำเข้าเมตาเดต้าเข้าสู่ระบบ HANA
- สร้างที่เก็บข้อมูลระหว่าง BODS และ HANA
- สร้างโครงการ
- สร้างงาน (แบบแบตช์หรือแบบเรียลไทม์)
- สร้างเวิร์กโฟลว์
- สร้างกระแสข้อมูล
- เพิ่มวัตถุลงในกระแสข้อมูล
- ดำเนินการงาน
- ตรวจสอบการแสดงตัวอย่างข้อมูลใน HANA
ขั้นตอน 1) สร้างที่เก็บข้อมูลระหว่าง SAP แหล่งที่มาและ BODS
- เพื่อโหลดข้อมูลจาก SAP แหล่งที่มาของ SAP ฮานะผ่าน. SAP BODS จำเป็นต้องมีที่เก็บข้อมูล ดังนั้นเราจึงสร้างที่เก็บข้อมูลก่อน ดังที่แสดงด้านล่าง – โปรเจ็กต์ -> สร้างใหม่ -> ที่เก็บข้อมูล

- หน้าต่างป๊อปอัพสำหรับสร้าง Datastore ใหม่จะปรากฏขึ้น กรอกรายละเอียดดังต่อไปนี้:
- ป้อนชื่อดาต้าสโตร์ “ds_ecc”
- เลือกชื่อประเภทที่เก็บข้อมูลเป็น “SAP แอพพลิเคชั่น”.
- ป้อนชื่อเซิร์ฟเวอร์ฐานข้อมูล
- ป้อนชื่อผู้ใช้และรหัสผ่าน
- คลิกที่ปุ่ม “สมัคร”
- คลิกที่ปุ่ม "ตกลง"

- ระบบจะสร้างดาต้าสโตร์ขึ้นมา ดูดาต้าสโตร์ที่สร้างเสร็จแล้วได้ตามภาพด้านล่าง
- ไปที่คลังวัตถุภายในเครื่อง (Local Object Library)
- เลือกแท็บ Datastore
- ฐานข้อมูล “ds_ecc” จะปรากฏขึ้น

ขั้นตอน 2) นำเข้าเมตาเดตา (โครงสร้าง) เข้าสู่เซิร์ฟเวอร์ BODS
เราได้สร้างแหล่งเก็บข้อมูลสำหรับ ECC ไปยัง BODS เรียบร้อยแล้ว ตอนนี้เราจะนำเข้าเมตาเดต้าจาก ECC ไปยัง BODS สำหรับการนำเข้า ให้ทำตามขั้นตอนด้านล่าง
- เลือก datastore “ds_ecc” แล้วคลิกขวา
- เลือกตัวเลือก "นำเข้าตามชื่อ"

หน้าต่างป๊อปอัพสำหรับนำเข้าตามชื่อจะปรากฏขึ้น กรอกรายละเอียดดังต่อไปนี้:
- เลือกพิมพ์เป็นตาราง
- ป้อนชื่อตารางที่จะนำเข้า ในที่นี้เราจะนำเข้าตาราง KNA1
- คลิกที่ปุ่ม “นำเข้า” ตาราง KNA1 จะปรากฏขึ้นภายใต้โหนดตารางของแหล่งข้อมูล “ds_ecc”

ข้อมูลเมตาของตารางจะถูกนำเข้าสู่ที่เก็บข้อมูล ds_ecc ดังต่อไปนี้

ขั้นตอน 3) กำหนดค่าเซิร์ฟเวอร์นำเข้า
จนถึงตอนนี้ เราได้นำเข้าตารางลงในที่เก็บข้อมูล “ds_ecc” ที่สร้างขึ้นสำหรับ ECC แล้ว SAP การเชื่อมต่อ BODS เพื่อนำเข้าข้อมูลเข้าสู่ระบบ SAP HANAเราจำเป็นต้องกำหนดค่าเซิร์ฟเวอร์นำเข้า
- เมื่อต้องการทำเช่นนี้ให้ไปที่ ดูอย่างรวดเร็ว -> กำหนดค่าเซิร์ฟเวอร์นำเข้า ดังต่อไปนี้.

- หน้าต่างป๊อปอัพสำหรับเลือกระบบจะปรากฏขึ้น เลือกตัวเลือกนั้น SAP ระบบ HANA (ในที่นี้คือ HDB) มีรายละเอียดดังนี้

- คลิกที่ปุ่ม “ถัดไป” หน้าต่างป๊อปอัพสำหรับป้อนข้อมูลรับรองการเข้าถึงบริการข้อมูลจะปรากฏขึ้น ป้อนรายละเอียดต่อไปนี้:
- SAP ที่อยู่เซิร์ฟเวอร์ BODS (ในที่นี้คือ BODS:6400)
- SAP ชื่อแหล่งเก็บข้อมูล BODS (ชื่อแหล่งเก็บข้อมูล HANAUSER)
- แหล่งข้อมูล ODBC (ZTDS_DS)
- พอร์ตเริ่มต้นสำหรับ SAP เซิร์ฟเวอร์ BODS (8080)

คลิกที่ปุ่ม “เสร็จสิ้น”
ขั้นตอน 4) นำเข้าเมตาเดตาเข้าสู่ระบบ HANA
ขณะนี้ได้ทำการตั้งค่าเซิร์ฟเวอร์นำเข้าเรียบร้อยแล้ว ดังนั้นจึงสามารถนำเข้าข้อมูลเมตาจากเซิร์ฟเวอร์ได้ SAP เซิร์ฟเวอร์ BODS
- คลิกตัวเลือก "นำเข้า" ใน "มุมมองด่วน"
- หน้าต่างป๊อปอัพสำหรับตัวเลือกการนำเข้าจะปรากฏขึ้น เลือกตัวเลือก “นำเข้าข้อมูลเมตาแบบเลือกเฉพาะ”

คลิกที่ปุ่ม "ถัดไป"
หน้าต่างป๊อปอัพสำหรับ “การนำเข้าเมตาเดต้าแบบเลือกเฉพาะ” จะปรากฏขึ้น ซึ่งเราจะเลือกไปยังระบบเป้าหมาย
- เลือก SAP ระบบ HANA (ที่นี่ใช้ HDB)

คลิกที่ปุ่ม "ถัดไป"
ขั้นตอน 5) สร้างที่เก็บข้อมูลระหว่าง BODS และ HANA
ใน BODS จำเป็นต้องมีดาต้าสโตร์แยกต่างหากสำหรับแหล่งข้อมูลและปลายทาง ดาต้าสโตร์แหล่งข้อมูลมีอยู่แล้ว ดังนั้นขั้นตอนต่อไปคือการสร้างดาต้าสโตร์ปลายทางระหว่าง BODS และ HANA โดยใช้ชื่อว่า “DS_BODS_HANA”
- ไปที่โครงการ -> ใหม่ -> Datastore
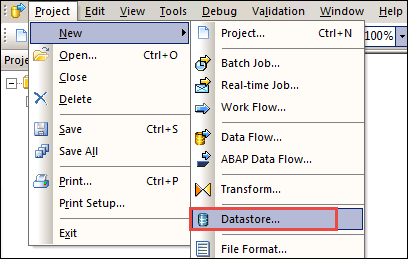
- หน้าจอสำหรับสร้าง Datastore ใหม่จะปรากฏขึ้นดังภาพด้านล่าง
- ป้อนชื่อดาต้าสโตร์ (DS_BODS_HANA)
- ระบุประเภทแหล่งเก็บข้อมูลเป็นฐานข้อมูล
- ระบุประเภทฐานข้อมูลเป็น SAP ฮานะ.
- เลือกเวอร์ชันฐานข้อมูล
- ป้อน SAP ชื่อเซิร์ฟเวอร์ฐานข้อมูล HANA
- ป้อนชื่อพอร์ตสำหรับ SAP ฐานข้อมูลฮาน่า
- ป้อนชื่อผู้ใช้และรหัสผ่าน
- ทำเครื่องหมายถูกที่ช่อง “เปิดใช้งานการถ่ายโอนข้อมูลอัตโนมัติ”

คลิกที่ปุ่ม “ใช้” จากนั้นคลิกที่ปุ่ม “ตกลง”
ดาต้าสโตร์ “DS_BODS_HANA” จะปรากฏอยู่ใต้แท็บ Datastore ใน Local Object Library ดังภาพด้านล่าง

- ต่อไปเราจะนำเข้าตารางลงในฐานข้อมูล “DS_BODS_HANA”
- เลือกดาต้าสโตร์ “DS_BODS_HANA” แล้วคลิกขวา
- เลือกนำเข้าตามชื่อ

- หน้าต่างป๊อปอัพสำหรับนำเข้าตามชื่อจะปรากฏขึ้นดังภาพด้านล่าง
- เลือกพิมพ์เป็นตาราง
- ป้อนชื่อเป็น KNA1
- เจ้าของจะแสดงเป็น Hanauser
- คลิกที่ปุ่มนำเข้า (Import)

ตารางนี้จะถูกนำเข้าสู่ฐานข้อมูล “DS_BODS_HANA” หากต้องการดูข้อมูลในตาราง ให้ทำตามขั้นตอนด้านล่าง
- คลิกที่ตาราง “KNA1” ในดาต้าสโตร์ “DS_BODS_HANA”
- ข้อมูลจะแสดงผลในรูปแบบตาราง

ขั้นตอนที่ 6) กำหนดขอบเขตของโครงการ โครงการคือการจัดกลุ่มและจัดการวัตถุที่เกี่ยวข้องเข้าด้วยกัน โครงการหนึ่งๆ สามารถประกอบด้วยงาน กระบวนการทำงาน และการไหลเวียนของข้อมูลได้มากมายหลายอย่าง
- ไปที่เมนู Designer Project
- เลือกตัวเลือก "ใหม่"
- เลือกตัวเลือก "โครงการ"

หน้าต่างป๊อปอัพสำหรับการสร้างโปรเจ็กต์ใหม่จะปรากฏขึ้นดังภาพด้านล่าง ป้อนชื่อโปรเจ็กต์แล้วคลิกปุ่ม "สร้าง" ระบบจะสร้างโฟลเดอร์โปรเจ็กต์ ในกรณีของเราคือ BODS_DHK

ขั้นตอนที่ 7) กำหนดขอบเขตงาน งาน (Job) คือวัตถุที่สามารถนำกลับมาใช้ใหม่ได้ ประกอบด้วยเวิร์กโฟลว์และกระแสข้อมูล งานสามารถเรียกใช้งานได้ด้วยตนเองหรือตามกำหนดเวลา ในการเรียกใช้กระบวนการ BODS จำเป็นต้องกำหนดงานก่อน
เราสร้างงานชื่อ JOB_Customer ขึ้นมา
- เลือกโปรเจ็กต์ (BODS_DHK) ที่สร้างไว้ในขั้นตอนก่อนหน้า คลิกขวา แล้วเลือก “สร้างงานแบตช์ใหม่”
- เปลี่ยนชื่อเป็น “JOB_Customer”

ขั้นตอนที่ 8) กำหนดขั้นตอนการทำงาน
- เลือกงาน “JOB_Customer” ในพื้นที่โครงการ
- คลิกปุ่มเวิร์กโฟลว์บนแถบเครื่องมือ คลิกที่พื้นที่ทำงานว่าง ไอคอนเวิร์กโฟลว์จะปรากฏขึ้นในพื้นที่ทำงาน
- เปลี่ยนชื่อเวิร์กโฟลว์เป็น “WF_Customer”

คลิกที่ชื่อของเวิร์กโฟลว์ จากนั้นมุมมองว่างของเวิร์กโฟลว์จะปรากฏขึ้นในพื้นที่ทำงาน

ขั้นตอนที่ 9) กำหนดการไหลของข้อมูล
- คลิกที่เวิร์กโฟลว์ “WF_Customer”
- คลิกปุ่มการไหลของข้อมูลบนแถบเครื่องมือ คลิกที่พื้นที่ทำงานว่าง ไอคอนการไหลของข้อมูลจะปรากฏขึ้นในพื้นที่ทำงาน
- เปลี่ยนชื่อโฟลว์ข้อมูลเป็น “DF_Customer”
- แผนผังการไหลของข้อมูลจะปรากฏในพื้นที่โครงการทางด้านซ้าย ใต้ชื่อของงานด้วย

ขั้นตอนที่ 10) เพิ่มวัตถุลงในกระแสข้อมูล
ภายในกระบวนการไหลของข้อมูล เราจะกำหนดคำสั่งเพื่อแปลงข้อมูลต้นทางให้เป็นรูปแบบที่ต้องการสำหรับตารางปลายทาง
มีการใช้วัตถุสามอย่าง:
- วัตถุสำหรับแหล่งที่มา
- วัตถุสำหรับตารางเป้าหมาย
- อ็อบเจ็กต์สำหรับการแปลงคิวรี ซึ่งทำหน้าที่แมปคอลัมน์จากแหล่งข้อมูลไปยังเป้าหมาย
คลิกที่โฟลว์ข้อมูล DF_Customer พื้นที่ทำงานว่างเปล่าจะปรากฏขึ้นดังภาพด้านล่าง
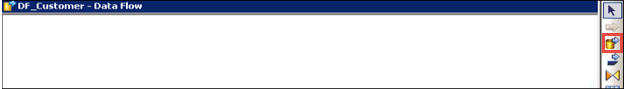
- ระบุวัตถุสำหรับแหล่งที่มา – ไปที่แหล่งเก็บข้อมูล “ds_ecc” เลือกตาราง KNA1 แล้วลากและวางลงบนหน้าจอแสดงการไหลของข้อมูลที่ว่างเปล่า
- ระบุวัตถุสำหรับเป้าหมาย – เลือกดาต้าสโตร์ “DS_BODS_HANA” จากรีโพสิทอรี และเลือกตาราง KNA1
- ลากและวางลงบนพื้นที่ทำงาน จากนั้นเลือก “สร้าง” Targetตัวเลือก “ตอนนี้จะมีสองตาราง ตารางหนึ่งเป็นแหล่งข้อมูล และอีกตารางหนึ่งเป็นเป้าหมาย”

- การแปลงคำค้นหา – นี่คือเครื่องมือที่ใช้ในการดึงข้อมูลตามรูปแบบข้อมูลขาเข้าสำหรับเงื่อนไขเฉพาะของผู้ใช้ และใช้ในการส่งต่อข้อมูลจากแหล่งที่มาไปยังปลายทาง
- เลือกไอคอน Query Transform จากแถบเครื่องมือ แล้วลากและวางลงระหว่างวัตถุต้นทางและวัตถุปลายทางในพื้นที่ทำงาน
- เชื่อมโยงอ็อบเจ็กต์ Query กับแหล่งข้อมูล
- เชื่อมโยงอ็อบเจ็กต์ Query กับตารางเป้าหมาย

Double-คลิกที่ไอคอน Query เพื่อแมปคอลัมน์จากสคีมาอินพุตไปยังสคีมาเอาต์พุต การแมปping หน้าต่างจะปรากฏขึ้น ซึ่งเราจะดำเนินการดังต่อไปนี้:
- เลือกตารางแหล่งข้อมูล KNA1 แล้ว
- เลือกคอลัมน์ทั้งหมดจากตารางต้นทาง คลิกขวา แล้วเลือก "แมปไปยังเอาต์พุต"
- เลือกผลลัพธ์เป้าหมายเป็น Query และจะทำการแมปคอลัมน์

บันทึกและยืนยันความถูกต้องของโปรเจ็กต์ คลิกที่ไอคอนตรวจสอบความถูกต้อง หน้าต่างป๊อปอัพเพื่อยืนยันการตรวจสอบความถูกต้องจะปรากฏขึ้น

ขั้นตอนที่ 11) ดำเนินการตามคำสั่ง หากต้องการดำเนินการดังกล่าว โปรดทำตามขั้นตอนด้านล่าง
- เลือกไอคอนพื้นที่โครงการเพื่อเปิดโครงการ จากนั้นเลือกโครงการที่สร้างไว้
- เลือกงานแล้วคลิกขวา
- เลือกตัวเลือก "ดำเนินการ" เพื่อเรียกใช้งานงานนั้น
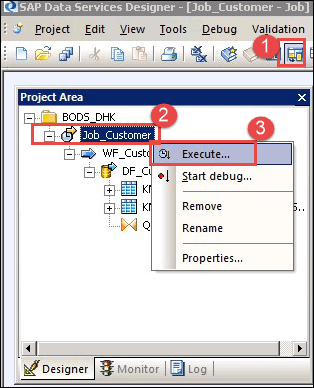
หลังจากดำเนินการเสร็จสิ้น หน้าต่างบันทึกการทำงานจะปรากฏขึ้น ซึ่งจะแสดงข้อความทั้งหมดที่เกี่ยวข้องกับการทำงาน ข้อความสุดท้ายจะเป็น “งาน” ดำเนินการเสร็จสมบูรณ์เรียบร้อยแล้ว”

ขั้นตอนที่ 12) ตรวจสอบและยืนยันข้อมูลใน SAP ฐานข้อมูลฮาน่า
- เข้าสู่ระบบเพื่อ SAP ฐานข้อมูล HANA ผ่าน SAP ฮานะ สตูดิโอและเลือกสคีมา HANAUSER
- เลือกตาราง KNA1 ในโหนดตาราง
- คลิกขวาที่ตาราง KNA1 แล้วเลือก เปิดดูตัวอย่างข้อมูล (Open Data Preview)
- ข้อมูล KNA1 ที่โหลดโดยกระบวนการ BODS จะแสดงในหน้าจอแสดงตัวอย่างข้อมูล

หากจำนวนแถวในตารางต้นทางและตัวอย่างที่แสดงตรงกัน แสดงว่าการโหลดเสร็จสมบูรณ์อย่างถูกต้องแล้ว จากนั้นสามารถตั้งเวลาให้ทำงานซ้ำได้จากหน้าผู้ดูแลระบบ
