
การทดสอบการกู้คืนคืออะไร? พร้อมตัวอย่าง
 ทีมบรรณาธิการ
⚡ สรุปอย่างชาญฉลาด
การทดสอบการกู้คืนระบบจะตรวจสอบว่าซอฟต์แวร์สามารถกลับมาทำงานได้ตามปกติหลังจากเกิดข้อผิดพลาด การเชื่อมต่อเครือข่ายขาดหาย หรือฮาร์ดแวร์ล้มเหลว โดยการกู้คืนระบบไปยังจุดที่ทราบว่าทำงานได้ดี และประมวลผลธุรกรรมซ้ำจนถึงจุดที่เกิดข้อผิดพลาด
การทดสอบการกู้คืนคืออะไร?
การทดสอบการกู้คืน การทดสอบการกู้คืน (Recovery Testing) เป็นเทคนิคการทดสอบซอฟต์แวร์ที่ตรวจสอบความสามารถของซอฟต์แวร์ในการกู้คืนจากความล้มเหลว เช่น การทำงานผิดพลาดของซอฟต์แวร์หรือฮาร์ดแวร์ และความล้มเหลวของเครือข่าย จุดประสงค์ของการทดสอบการกู้คืนคือการพิจารณาว่าการทำงานของซอฟต์แวร์สามารถดำเนินต่อไปได้หรือไม่หลังจากเกิดภัยพิบัติหรือการสูญเสียความสมบูรณ์ของข้อมูล การทดสอบการกู้คืนเกี่ยวข้องกับการย้อนกลับซอฟต์แวร์ไปยังจุดที่ทราบว่าข้อมูลมีความสมบูรณ์ และประมวลผลธุรกรรมซ้ำจนถึงจุดที่เกิดความล้มเหลว
ในวิศวกรรมซอฟต์แวร์ การทดสอบความสามารถในการกู้คืนเป็นประเภทหนึ่งของ การทดสอบที่ไม่เกี่ยวข้องกับการทำงาน — ครอบคลุมแง่มุมที่ไม่เกี่ยวข้องกับฟังก์ชันหรือการกระทำของผู้ใช้โดยเฉพาะ เช่น ความสามารถในการขยายขนาดหรือความปลอดภัย การทดสอบนี้ดำเนินการโดยผู้ทดสอบมืออาชีพ และมีการสำรองข้อมูลอย่างเพียงพอในสถานที่ที่ปลอดภัยล่วงหน้า
ตัวอย่างการทดสอบการกู้คืน
ตัวอย่างสองกรณีแสดงให้เห็นถึงเทคนิคนี้ในรูปแบบที่ง่ายที่สุด ในแต่ละกรณีจะมีการจงใจทำให้เกิดความล้มเหลว จากนั้นจะสังเกตการทำงานของแอปพลิเคชันขณะที่มันกลับมาทำงานต่อ
- การหยุดชะงักของเครือข่าย: ขณะที่แอปพลิเคชันกำลังรับข้อมูลจากเครือข่าย ให้ถอดสายเคเบิลที่เชื่อมต่อออก หลังจากนั้นสักพัก ให้เสียบสายเคเบิลกลับเข้าไปใหม่ แล้ววิเคราะห์ความสามารถของแอปพลิเคชันในการรับข้อมูลต่อจากจุดที่การเชื่อมต่อถูกตัดขาด
- กู้คืนเซสชัน: รีสตาร์ทระบบในขณะที่เบราว์เซอร์มีเซสชันเปิดอยู่จำนวนหนึ่ง และตรวจสอบว่าเบราว์เซอร์สามารถกู้คืนเซสชันทั้งหมดได้หรือไม่
ภาพประกอบด้านล่างนำเสนอแนวคิดเดียวกันในรูปแบบภาพ
เวลาที่ใช้ในการฟื้นตัวขึ้นอยู่กับ:
- จำนวนจุดรีสตาร์ท
- ปริมาณข้อมูลที่แอปพลิเคชันจัดเก็บไว้
- การฝึกอบรมและทักษะของผู้ที่ดำเนินกิจกรรมฟื้นฟู และเครื่องมือที่มีอยู่สำหรับการฟื้นฟู
เมื่อเกิดความล้มเหลวหลายจุด ควรทำการทดสอบการกู้คืนอย่างเป็นระบบ แทนที่จะทำทั้งหมดในคราวเดียว กล่าวคือ ดำเนินการทีละส่วน แล้วจึงดำเนินการกับส่วนอื่น
วงจรชีวิตของกระบวนการกู้คืน
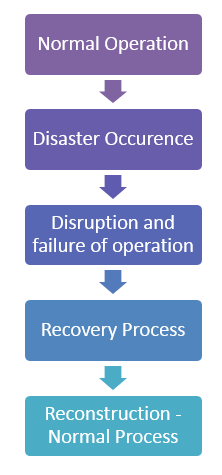
ก่อนที่จะออกแบบกรณีทดสอบ ควรพิจารณาก่อนว่าการทดสอบการกู้คืนเข้ามาเกี่ยวข้องตรงจุดใด กระบวนการกู้คืนมีวงจรชีวิตห้าขั้นตอน:
- ดำเนินการตามปกติ
- การเกิดภัยพิบัติ
- การหยุดชะงักและล้มเหลวของการดำเนินงาน
- การกวาดล้างภัยพิบัติผ่านกระบวนการฟื้นฟู
- การปรับปรุงกระบวนการและข้อมูลทั้งหมดใหม่ เพื่อให้ระบบทั้งหมดกลับมาทำงานได้ตามปกติ
แผนผังแสดงขั้นตอนทั้งห้าตามลำดับแสดงไว้ในภาพด้านล่าง
เรามาพิจารณาขั้นตอนทั้งห้าโดยละเอียดกัน:
- ดำเนินการตามปกติ. ระบบที่ประกอบด้วยฮาร์ดแวร์ ซอฟต์แวร์ และเฟิร์มแวร์ ซึ่งทำงานร่วมกันเพื่อให้บรรลุเป้าหมายเดียวกัน จะทำงานตามที่ออกแบบไว้ได้โดยไม่หยุดชะงักภายในระยะเวลาที่กำหนด
- การเกิดภัยพิบัติ อาจเกิดการหยุดชะงักเนื่องจากซอฟต์แวร์ทำงานผิดปกติ จากสาเหตุต่างๆ เช่น การทำงานผิดพลาดที่เกิดจากการป้อนข้อมูล การขัดข้องเนื่องจากฮาร์ดแวร์ล้มเหลว หรือความเสียหายจากไฟไหม้ การโจรกรรม หรือการหยุดงานประท้วง
- การหยุดชะงักและความล้มเหลว นี่คือช่วงเวลาที่เจ็บปวดที่สุด นำไปสู่ความสูญเสียทางธุรกิจ ความสัมพันธ์ที่แตกหัก โอกาสที่สูญเสียไป เวลาทำงานที่สูญเปล่า และที่หลีกเลี่ยงไม่ได้คือความสูญเสียทางการเงินและชื่อเสียง แผนการกู้คืนจากภัยพิบัติจะช่วยลดผลกระทบในระยะนี้ให้น้อยที่สุด
- การเคลียร์พื้นที่หลังภัยพิบัติ หากมีการวางแผนสำรองและกระบวนการลดความเสี่ยงไว้แล้ว การกู้คืนระบบจะใช้เวลาน้อยลงทั้งเวลาและแรงงาน การจัดตั้งทีมเฉพาะกิจ โดยกำหนดบทบาทของแต่ละคนไว้ล่วงหน้า จะช่วยกำหนดความรับผิดชอบและป้องกันช่วงเวลาที่ระบบหยุดชะงักเป็นเวลานาน
- การสร้างใหม่ ขั้นตอนนี้อาจต้องดำเนินการหลายครั้งเพื่อสร้างโฟลเดอร์ทั้งหมดรวมถึงไฟล์การกำหนดค่าขึ้นมาใหม่ จำเป็นต้องมีเอกสารประกอบที่เหมาะสมและกระบวนการสร้างใหม่ที่กำหนดไว้อย่างชัดเจนเพื่อให้การกู้คืนเป็นไปอย่างถูกต้อง
กลยุทธ์การฟื้นฟู
ทีมกู้คืนควรมีกลยุทธ์ของตนเองในการกู้คืนรหัสและข้อมูลสำคัญเพื่อนำการดำเนินงานกลับสู่ภาวะปกติ กลยุทธ์นั้นเป็นเอกลักษณ์เฉพาะของแต่ละองค์กร โดยขึ้นอยู่กับความสำคัญของระบบที่องค์กรนั้นดูแล และสำหรับระบบที่สำคัญ กลยุทธ์นั้นจะขึ้นอยู่กับการตัดสินใจหลายประการ:
- การสำรองข้อมูลครั้งเดียว หรือมากกว่าหนึ่งครั้ง
- การสำรองข้อมูลหลายชุดในที่เดียว หรือในสถานที่ต่างๆ กัน
- การสำรองข้อมูลออนไลน์ หรือการสำรองข้อมูลออฟไลน์
- การสำรองข้อมูลจะทำงานโดยอัตโนมัติตามนโยบาย หรือสามารถเรียกใช้งานได้ด้วยตนเอง
- ทีมงานบูรณะอิสระ หรือทีมพัฒนาที่รับผิดชอบงานนั้น
แต่ละทางเลือกล้วนมีต้นทุน และการสำรองข้อมูลหลายชุดอาจใช้ทรัพยากรทางกายภาพมากขึ้น หรืออาจต้องใช้ทีมงานอิสระ นอกจากนี้ ความสัมพันธ์ระหว่างผู้ให้บริการก็มีความสำคัญเช่นกัน บริษัทต่างๆ อาจมีความเสี่ยงจากโค้ดและข้อมูลที่เก็บไว้กับผู้ให้บริการรายเดียว และการสำรองข้อมูลขนาดใหญ่ก็อาจส่งผลกระทบอย่างมาก AWS เหตุการณ์ไฟดับได้ทำให้บริการผู้บริโภคที่มีชื่อเสียงหลายแห่งใช้งานไม่ได้พร้อมกันหลายครั้ง ความสามารถในการกู้คืนระบบอย่างอิสระจึงมีความสำคัญอย่างยิ่งในกรณีเช่นนี้
วิธีทำการทดสอบการกู้คืน
เมื่อวางกลยุทธ์เสร็จแล้ว คำถามต่อไปคือจะตั้งค่าการทดสอบอย่างไร ควรพิจารณาประเด็นต่อไปนี้ขณะทำการทดสอบการกู้คืน
- สร้างสภาพแวดล้อมทดสอบที่ใกล้เคียงกับสภาพการใช้งานจริงมากที่สุดเท่าที่จะเป็นไปได้: การเชื่อมต่อ โปรโตคอล เฟิร์มแวร์ ฮาร์ดแวร์ และซอฟต์แวร์ควรตรงกับสภาพการใช้งานจริง
- แม้ว่าการทดสอบอย่างละเอียดถี่ถ้วนอาจใช้เวลานานและมีค่าใช้จ่ายสูง แต่ก็ควรทำการตั้งค่าที่เหมือนกันทุกประการและตรวจสอบอย่างครบถ้วนอยู่ดี
- ถ้าเป็นไปได้ ให้ทดสอบบนฮาร์ดแวร์ที่จะใช้ในการกู้คืนข้อมูลจริง โดยเฉพาะอย่างยิ่งเมื่อกู้คืนไปยังเครื่องอื่นที่ไม่ใช่เครื่องที่สร้างไฟล์สำรองข้อมูลไว้
- ระบบสำรองข้อมูลบางระบบคาดว่าฮาร์ดไดรฟ์จะมีขนาดเท่ากันทุกประการกับขนาดที่สำรองข้อมูลมา
- จัดการกับปัญหาเทคโนโลยีล้าสมัย: เทคโนโลยีฮาร์ดไดรฟ์พัฒนาไปอย่างรวดเร็ว และฮาร์ดไดรฟ์เก่าอาจไม่สามารถใช้งานร่วมกับฮาร์ดไดรฟ์ใหม่ได้ การกู้คืนระบบไปยังเวอร์ชันเก่าจึงเป็นสิ่งสำคัญ เครื่องเสมือน ซึ่งเป็นประโยชน์ เนื่องจากซอฟต์แวร์เวอร์ชวลไลเซชันสามารถจำลองฮาร์ดแวร์ที่มีอยู่ได้ รวมถึงขนาดของดิสก์ด้วย
- ระบบสำรองข้อมูลออนไลน์ก็ไม่ต่างจากระบบอื่นๆ ที่ต้องผ่านการทดสอบ ผู้ให้บริการส่วนใหญ่ปกป้องผู้ใช้จากปัญหาของสื่อบันทึกข้อมูลด้วยระบบจัดเก็บข้อมูลที่ทนต่อความผิดพลาด ดังนั้นความล้มเหลวจึงมักปรากฏขึ้นเมื่อถึงช่วงหลังๆ
- แม้ว่าระบบสำรองข้อมูลออนไลน์จะมีความน่าเชื่อถือสูงมาก แต่ก็ต้องทดสอบด้านการกู้คืนข้อมูลเพื่อให้แน่ใจว่าไม่มีปัญหาเกี่ยวกับการดึงข้อมูล ความปลอดภัย หรือการเข้ารหัส
เนื่องจากการฟื้นฟูร่างกายเกิดขึ้นตั้งแต่ต้นจนจบ การวิ่งเหล่านี้จึงมักถูกกำหนดไว้ควบคู่กันไป การทดสอบระบบ แทนที่จะเป็นระดับหน่วยย่อย
ขั้นตอนการทดสอบหลังการบูรณะ
การกู้คืนข้อมูลเป็นเพียงครึ่งหนึ่งของกระบวนการเท่านั้น สำเนาที่กู้คืนมาได้ยังต้องได้รับการพิสูจน์ว่าใช้งานได้ บริษัทขนาดใหญ่ส่วนใหญ่จะมีผู้ตรวจสอบอิสระทำการทดสอบการกู้คืนข้อมูลเป็นระยะ แผนการกู้คืนระบบจากภัยพิบัติที่ครอบคลุมนั้นมีค่าใช้จ่ายสูงในการบำรุงรักษาและทดสอบ ดังนั้นองค์กรขนาดเล็กจึงมักพึ่งพาการสำรองข้อมูลและการจัดเก็บข้อมูลนอกสถานที่แทน
หลังจากกู้คืนโฟลเดอร์และไฟล์แล้ว การตรวจสอบต่อไปนี้จะยืนยันว่าได้กู้คืนอย่างถูกต้อง:
- เปลี่ยนชื่อโฟลเดอร์เอกสารที่เสียหาย เพื่อไม่ให้เกิดความสับสนกับสำเนาที่กู้คืนมา
- นับจำนวนไฟล์ในโฟลเดอร์ที่กู้คืนมา และเปรียบเทียบจำนวนไฟล์นั้นกับจำนวนไฟล์ในโฟลเดอร์เดิม
- ลองเปิดไฟล์บางไฟล์ด้วยโปรแกรมที่คุณใช้งานเป็นประจำ แล้วตรวจสอบว่าสามารถเรียกดูและอัปเดตข้อมูลได้ตามปกติหรือไม่
- เปิดไฟล์หลายประเภทพร้อมกัน เช่น รูปภาพ MP3จดหมายและเอกสารต่างๆ ทั้งขนาดใหญ่และขนาดเล็ก
- ใช้ยูทิลิตี้เปรียบเทียบไฟล์และไดเร็กทอรีที่คนส่วนใหญ่ใช้กัน ระบบปฏิบัติการ ให้.
