
การทดสอบ T ในการเขียนโปรแกรม R: ตัวอย่างเดียวและตัวอย่างแบบจับคู่
 ทีมบรรณาธิการ
⚡ สรุปอย่างชาญฉลาด
การทดสอบ T ใน R ใช้ฟังก์ชัน t.test() เพื่อเปรียบเทียบค่าเฉลี่ย ครอบคลุมการทดสอบหนึ่งตัวอย่างเทียบกับเป้าหมายคงที่ สองกลุ่มอิสระ และการวัดซ้ำแบบจับคู่ บทแนะนำนี้จะแสดงวิธีการรันแต่ละรูปแบบ อ่านค่า p-value อย่างถูกต้อง และตรวจสอบสมมติฐานพื้นฐาน
การอนุมานทางสถิติคืออะไร?
การอนุมานทางสถิติคือศิลปะในการสร้างข้อสรุปเกี่ยวกับลักษณะการกระจายตัวของข้อมูล นักวิทยาศาสตร์ข้อมูลมักเผชิญกับคำถามที่สามารถตอบได้ด้วยวิธีการทางวิทยาศาสตร์เท่านั้น ดังนั้น การอนุมานทางสถิติจึงเป็นกลยุทธ์ในการทดสอบว่าสมมติฐานนั้นเป็นจริงหรือไม่ กล่าวคือได้รับการยืนยันจากข้อมูลแล้ว
กลยุทธ์ทั่วไปในการประเมินสมมติฐานคือการทดสอบ t ซึ่งจะบอกว่าค่าเฉลี่ยสองค่าเท่ากันหรือไม่ การทดสอบนี้เรียกอีกอย่างว่า... การทดสอบนักเรียนสามารถคำนวณค่า t-test ได้สำหรับ:
- เวกเตอร์เดียวเทียบกับค่าคงที่ (การทดสอบ t แบบหนึ่งตัวอย่าง)
- เวกเตอร์สองตัวจากสองกลุ่มที่แยกจากกัน (การทดสอบ t แบบสองกลุ่มอิสระ)
- เวกเตอร์สองตัวที่วัดจากกลุ่มตัวอย่างเดียวกัน (การทดสอบ t แบบจับคู่)
การทดสอบ t ทุกแบบจะถือว่าข้อมูลได้มาจากการสุ่มตัวอย่าง และค่าต่างๆ (หรือในกรณีของการทดสอบแบบจับคู่ ค่าความแตกต่าง) มาจากประชากรที่มีการกระจายแบบปกติโดยประมาณ นอกจากนี้ การทดสอบแบบสองกลุ่มอิสระยังถือว่าทั้งสองกลุ่มเป็นอิสระต่อกัน และรูปแบบคลาสสิกจะถือว่าความแปรปรวนของทั้งสองกลุ่มเท่ากัน
T-Test ในการเขียนโปรแกรม R คืออะไร?
แนวคิดพื้นฐานเบื้องหลังการทดสอบ T คือการใช้สถิติเพื่อประเมินสมมติฐานที่ขัดแย้งกันสองข้อ:
- H0สมมติฐานว่าง (null hypothesis) คือ ค่าเฉลี่ยของประชากรเท่ากับค่าที่กำลังทดสอบ
- H1สมมติฐานทางเลือก คือ ค่าเฉลี่ยของประชากรแตกต่างจากค่าดังกล่าว
การทดสอบ t ออกแบบมาสำหรับตัวอย่างขนาดเล็ก ซึ่งการประมาณค่าด้วยการกระจายแบบปกติไม่น่าเชื่อถือ โดยจำเป็นต้องใช้ข้อมูลที่มีการกระจายแบบปกติโดยประมาณ
ไวยากรณ์ T-Test ใน R
ไวยากรณ์พื้นฐานสำหรับ t.test() ใน R คือ:
t.test(x, y = NULL,
       mu = 0, var.equal = FALSE)
arguments:
- x : A vector to compute the one-sample t-test
- y: A second vector to compute the two sample t-test
- mu: Mean of the population under the null hypothesis
- var.equal: Specify whether the variances of the two vectors are equal. By default, set to `FALSE`
- paired: Set to `TRUE` when the two vectors are repeated measures on the same subjects
ก่อนเริ่มดำเนินการใดๆ โปรดตรวจสอบให้แน่ใจว่ารูปแบบข้อมูลของคุณตรงกับรูปแบบการทดสอบที่ถูกต้อง
ประเภทของการทดสอบ T ใน R
การเลือกตัวเลือกที่ไม่ถูกต้องเป็นข้อผิดพลาดที่พบบ่อยที่สุดในการทดสอบ t ดังนั้นควรเริ่มต้นด้วยการจับคู่รูปแบบข้อมูลของคุณกับตัวเลือกที่ถูกต้อง
| ประเภท | ใช้เมื่อ | R เรียก |
|---|---|---|
| ตัวอย่างเดียว | กลุ่มหนึ่งถูกเปรียบเทียบกับค่าเป้าหมายที่ทราบแล้ว | t.test(x, mu = value) |
| การทดสอบแบบสองกลุ่มอิสระ (เวลช์) | สองกลุ่มที่แยกจากกัน ความแปรปรวนอาจไม่เท่ากัน | t.test(x, y) |
| ตัวอย่างอิสระสองตัวอย่าง (รวม) | สองกลุ่มแยกกันที่มีความแปรปรวนเท่ากัน | t.test(x, y, var.equal = TRUE) |
| จับคู่ | วัดค่าสองครั้งกับกลุ่มตัวอย่างเดียวกัน | t.test(x, y, paired = TRUE) |
| มีด้านเดียว | คุณสนใจแค่ความแตกต่างในทิศทางเดียวเท่านั้น | t.test(x, mu = value, alternative = “greater”) |
เมื่อเกินสามกลุ่ม การทดสอบ t-test จะไม่เหมาะสมอีกต่อไป ให้เปลี่ยนไปใช้การทดสอบอื่น การทดสอบ ANOVAซึ่งจะช่วยรักษาอัตราความผิดพลาดโดยรวมไว้ที่ 5 เปอร์เซ็นต์ แทนที่จะเพิ่มสูงขึ้นจากการเปรียบเทียบแบบคู่ซ้ำๆ
ตัวอย่าง T-Test หนึ่งตัวอย่างใน R
การทดสอบ t-test ของตัวอย่างเดียว หรือการทดสอบของนักเรียน เป็นการเปรียบเทียบค่าเฉลี่ยของเวกเตอร์กับค่าเฉลี่ยเชิงทฤษฎี  - สูตรที่ใช้คำนวณการทดสอบทีคือ:

ที่นี่
 หมายถึงค่าเฉลี่ย
 ถึงค่าเฉลี่ยทางทฤษฎี
- s คือส่วนเบี่ยงเบนมาตรฐาน
- n จำนวนการสังเกต
 หมายถึงค่าเฉลี่ย
ในการประเมินนัยสำคัญทางสถิติของการทดสอบที คุณต้องคำนวณ p-valueส่วน p-value มีตั้งแต่ 0 ถึง 1 และตีความได้ดังนี้:
- ค่า p-value ที่ต่ำกว่า 0.05 หมายความว่าคุณสามารถปฏิเสธสมมติฐานว่างได้ โปรดทราบว่าการปฏิเสธ H0 ไม่ได้หมายความว่า H1 เป็นจริงเสมอไป แต่หมายความว่าข้อมูลนั้นไม่น่าจะเป็นไปได้ภายใต้ H0 เท่านั้น
- ค่า p ที่สูงกว่า 0.05 แสดงว่าคุณไม่มีหลักฐานเพียงพอที่จะปฏิเสธสมมติฐานว่าง
คุณสามารถสร้างค่า p ได้โดยการดูค่าสัมบูรณ์ที่สอดคล้องกันของการทดสอบทีในการแจกแจงของนักเรียนโดยมีระดับความเป็นอิสระเท่ากับ 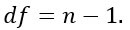
ตัวอย่างเช่น หากมีข้อมูล 5 ชุด คุณจะเปรียบเทียบค่า t กับการแจกแจงแบบ Student ที่มีองศาอิสระ 4 ที่ระดับความเชื่อมั่น 95 เปอร์เซ็นต์ ในการปฏิเสธสมมติฐานว่างในการทดสอบแบบสองด้าน ค่าสัมบูรณ์ของ t ต้องมากกว่า 2.776
ตาราง CF ด้านล่าง:

ตัวอย่างการทดสอบ T หนึ่งตัวอย่างใน R
สมมติว่าคุณเป็นบริษัทที่ผลิตคุกกี้ คุกกี้แต่ละชิ้นควรมีน้ำตาล 10 กรัม คุกกี้ผลิตโดยเครื่องจักรที่เติมน้ำตาลลงในชามก่อนจะผสมทุกอย่าง คุณเชื่อว่าเครื่องไม่ได้เติมน้ำตาล 10 กรัมต่อคุกกี้แต่ละอัน หากสมมติฐานของคุณเป็นจริง จำเป็นต้องซ่อมเครื่อง คุณเก็บระดับน้ำตาลไว้ที่ XNUMX คุกกี้
หมายเหตุ: คุณสามารถสร้างเวกเตอร์แบบสุ่มด้วยฟังก์ชัน rnorm() ฟังก์ชันนี้สร้างค่าที่แจกแจงแบบปกติ ไวยากรณ์พื้นฐานคือ:
rnorm(n, mean, sd)
arguments
- n: Number of observations to generate
- mean: The mean of the distribution. Optional
- sd: The standard deviation of the distribution. Optional
คุณสามารถสร้างการแจกแจงด้วยการสังเกต 30 ครั้ง โดยมีค่าเฉลี่ย 9.99 และค่าเบี่ยงเบนมาตรฐาน 0.04
set.seed(123)
sugar_cookie <- rnorm(30, mean = 9.99, sd = 0.04)
head(sugar_cookie)
Output:
## [1] 9.967581 9.980793 10.052348 9.992820 9.995172 10.058603
คุณสามารถใช้การทดสอบแบบตัวอย่างเดียวเพื่อตรวจสอบว่าระดับน้ำตาลแตกต่างจากสูตรหรือไม่ คุณสามารถทำแบบทดสอบสมมติฐานได้:
- H0: ระดับน้ำตาลเฉลี่ยเท่ากับ 10
- H1: ระดับน้ำตาลเฉลี่ยต่างกันกว่า 10
คุณใช้ระดับนัยสำคัญ 0.05
# H0 : mu = 10
t.test(sugar_cookie, mu = 10)
นี่คือผลลัพธ์:

ค่า p ของการทดสอบ t แบบหนึ่งตัวอย่างคือ 0.1079 ซึ่งสูงกว่าเกณฑ์ 0.05 ช่วงความเชื่อมั่น 95 เปอร์เซ็นต์สำหรับค่าเฉลี่ยอยู่ระหว่าง 9.973 ถึง 10.002 กรัม และครอบคลุมค่าเป้าหมาย 10 ดังนั้น คุณจึงไม่สามารถปฏิเสธ H0 ได้: ไม่มีหลักฐานเพียงพอที่จะสรุปว่าเครื่องจักรเบี่ยงเบนจากสูตร
การทดสอบ T สองกลุ่มอิสระใน R
การทดสอบ t-test แบบสองกลุ่มอิสระเป็นรูปแบบที่ใช้บ่อยที่สุด และใช้ได้เมื่อชุดการวัดทั้งสองชุดมาจากกลุ่มตัวอย่างที่แตกต่างกัน เช่น ร้านค้าสองแห่ง เครื่องจักรสองเครื่อง หรือกลุ่มทดลองสองกลุ่ม
สมมติว่าโรงงานแห่งหนึ่งมีสายการผลิตสองสาย และคุณต้องการทราบว่าขวดที่บรรจุของเหลวจากทั้งสองสายมีน้ำหนักเท่ากันหรือไม่
set.seed(123)
line_a <- rnorm(25, mean = 500, sd = 8)
line_b <- rnorm(25, mean = 505, sd = 8)

# Welch test, the safe default
t.test(line_a, line_b)

# Pooled test, only when the variances are equal
t.test(line_a, line_b, var.equal = TRUE)
อ่านผลลัพธ์ในสี่ขั้นตอน
- t คือขนาดมาตรฐานของช่องว่างระหว่างค่าเฉลี่ยทั้งสอง ค่าเครื่องหมายของมันสะท้อนถึงลำดับที่คุณส่งเวกเตอร์เข้ามาเท่านั้น
- df คือจำนวนองศาอิสระ การทดสอบแบบเวลช์ให้ค่าเป็นเศษส่วน ในขณะที่การทดสอบแบบรวมให้ค่าเป็นจำนวนเต็มเท่ากับ n1 + n2 – 2
- p-value คือความน่าจะเป็นที่จะเห็นช่องว่างขนาดใหญ่เช่นนี้ หากค่าเฉลี่ยที่แท้จริงเหมือนกันทุกประการ
- ช่วงความเชื่อมั่น กำหนดขอบเขตของความแตกต่างที่แท้จริง เมื่อขอบเขตนั้นประกอบด้วยศูนย์ แสดงว่าความแตกต่างนั้นไม่มีนัยสำคัญในระดับนั้น
หากข้อมูลของคุณอยู่ในเฟรมข้อมูลเดียวที่มีคอลัมน์ค่าหนึ่งคอลัมน์และคอลัมน์ปัจจัยหนึ่งคอลัมน์ ให้ใช้ส่วนติดต่อสูตรแทน ซึ่งอ่านง่ายกว่าและหลีกเลี่ยงการแยกข้อมูลด้วยตนเอง:
t.test(weight ~ line, data = jars)
ควรใช้เวอร์ชันใด ปล่อยค่า var.equal ไว้ที่ค่าเริ่มต้นคือ FALSE เว้นแต่คุณได้ทดสอบและยืนยันแล้วว่าค่าความแปรปรวนเท่ากัน การแก้ไขของ Welch แทบจะไม่สิ้นเปลืองพลังงานเลยเมื่อค่าความแปรปรวนตรงกัน และยังช่วยปกป้องคุณเมื่อค่าความแปรปรวนไม่ตรงกันด้วย
จับคู่ T-Test ใน R
การทดสอบ t แบบจับคู่ หรือที่เรียกว่าการทดสอบ t แบบกลุ่มตัวอย่างที่ขึ้นอยู่กัน ใช้เมื่อทำการวัดกลุ่มเดียวกันสองครั้ง การใช้งานทั่วไปได้แก่:
- การทดสอบ A / B: เปรียบเทียบสองรุ่น
- การศึกษาแบบควบคุมกรณี: ก่อนและหลังการรักษาในกลุ่มตัวอย่างเดียวกัน
ตัวอย่าง T-Test ที่จับคู่ใน R
บริษัทเครื่องดื่มแห่งหนึ่งสนใจที่จะทราบประสิทธิภาพของโปรแกรมส่วนลดในการขาย บริษัทจึงตัดสินใจติดตามยอดขายรายวันของร้านค้าแห่งหนึ่งที่โปรแกรมดังกล่าวกำลังโปรโมต เมื่อสิ้นสุดโปรแกรม บริษัทต้องการทราบว่ามีข้อแตกต่างทางสถิติระหว่างยอดขายเฉลี่ยของร้านค้าก่อนและหลังโปรแกรมหรือไม่
- บริษัท tracตรวจสอบยอดขายทุกวันก่อนเริ่มโครงการ นี่คือเวกเตอร์แรกของเรา
- โปรแกรมจะทำการโปรโมตเป็นเวลาหนึ่งสัปดาห์และบันทึกยอดขายทุกวัน นี่คือเวกเตอร์ที่สองของเรา
- คุณจะทำการทดสอบทีเพื่อตัดสินประสิทธิภาพของโปรแกรม สิ่งนี้เรียกว่าการทดสอบทีคู่กัน เนื่องจากค่าของเวกเตอร์ทั้งสองมาจากการแจกแจงแบบเดียวกัน (นั่นคือ ร้านเดียวกัน)
การทดสอบสมมติฐานคือ:
- H0: ค่าเฉลี่ยไม่มีความแตกต่าง
- H1: ทั้งสองวิธีแตกต่างกัน
โปรดจำไว้ว่าการทดสอบ t แบบคลาสสิกนั้นตั้งอยู่บนสมมติฐานว่าความแปรปรวนในทั้งสองกลุ่มนั้นไม่ทราบค่าแต่เท่ากัน ข้อมูลจริงมักไม่เป็นไปตามสมมติฐานนั้นอย่างแม่นยำ และการละเลยความแตกต่างนี้อาจทำให้ผลลัพธ์คลาดเคลื่อนได้
วิธีแก้ไขคือใช้การทดสอบ t ของเวลช์ (Welch's t-test) ซึ่งผ่อนคลายข้อสมมติฐานเรื่องความแปรปรวนเท่ากัน R จะใช้การทดสอบนี้โดยค่าเริ่มต้น เนื่องจาก var.equal จะเป็น FALSE เว้นแต่คุณจะระบุเป็นอย่างอื่น ในชุดข้อมูลนี้ เวกเตอร์ทั้งสองถูกสร้างขึ้นด้วยค่าเบี่ยงเบนมาตรฐานเดียวกัน ดังนั้นคุณสามารถตั้งค่า var.equal = TRUE ได้อย่างปลอดภัย
คุณสร้างเวกเตอร์สุ่มสองตัวจากการแจกแจงแบบเกาส์เซียนโดยมีค่าเฉลี่ยสูงกว่าสำหรับยอดขายหลังโปรแกรม
set.seed(123)
# sales before the program
sales_before <- rnorm(7, mean = 50000, sd = 50)
# sales after the program.This has higher mean
sales_after <- rnorm(7, mean = 50075, sd = 50)
# draw the distribution
t.test(sales_before, sales_after,var.equal = TRUE)

ค่า p-value คือ 0.04606 ซึ่งต่ำกว่าเกณฑ์ 0.05 เล็กน้อย ดังนั้นคุณจึงปฏิเสธสมมติฐานหลัก (H0) และสรุปได้ว่าค่าเฉลี่ยทั้งสองแตกต่างกันอย่างมีนัยสำคัญ โปรแกรมส่วนลดดูเหมือนจะช่วยเพิ่มยอดขายได้
⚠️ สำคัญ: การเรียกใช้ข้างต้นเปรียบเทียบเวกเตอร์ทั้งสองดังนี้ อิสระ ตัวอย่าง เนื่องจากทั้งสองชุดข้อมูลเป็นการวัดจากร้านค้าเดียวกัน การคำนวณที่ถูกต้องทางสถิติจึงเพิ่มค่าเข้าไป จับคู่ = จริง:
t.test(sales_before, sales_after, paired = TRUE)
การทดสอบแบบจับคู่จะทดสอบค่าเฉลี่ยของความแตกต่างในแต่ละวัน แทนที่จะทดสอบความแตกต่างของค่าเฉลี่ยสองค่า วิธีนี้จะขจัดความผันแปรในระดับร้านค้าซึ่งเป็นปัจจัยร่วมของทั้งสองเวกเตอร์ จึงทำให้มีประสิทธิภาพทางสถิติมากกว่า
วิธีการตรวจสอบข้อสมมติฐานของการทดสอบ T ใน R
ค่า p ของการทดสอบ t จะมีความหมายก็ต่อเมื่อข้อสมมติฐานของการทดสอบนั้นเป็นจริงเท่านั้น แต่ละข้อสมมติฐานมีวิธีการตรวจสอบโดยตรง
1. ภาวะปกติ การทดสอบแบบหนึ่งตัวอย่างและสองตัวอย่างถือว่าค่าต่างๆ มีการกระจายแบบปกติโดยประมาณ ส่วนการทดสอบแบบจับคู่ถือว่า ความแตกต่าง ตรวจสอบแผนภูมิ QQ และยืนยันด้วยการทดสอบ Shapiro-Wilk:
qqnorm(sugar_cookie); qqline(sugar_cookie)
shapiro.test(sugar_cookie)

# for a paired design, test the differences
shapiro.test(sales_after - sales_before)
ค่า p ของ Shapiro-Wilk ที่สูงกว่า 0.05 หมายความว่าไม่สามารถปฏิเสธสมมติฐานความปกติได้ และหากมีจำนวนข้อมูลมากกว่าประมาณ 30 ข้อมูลต่อกลุ่ม ทฤษฎีบทขีดจำกัดกลางจะทำให้การทดสอบ t มีความแข็งแกร่งต่อความเบี่ยงเบนระดับปานกลางอยู่แล้ว
2. ความแปรปรวนเท่ากัน เฉพาะการทดสอบแบบรวมสองกลุ่มตัวอย่างเท่านั้นที่ต้องการสิ่งนี้ ทดสอบด้วยการทดสอบ F:
var.test(line_a, line_b)
ค่า p-value ที่สูงกว่า 0.05 สนับสนุนสมมติฐานว่าความแปรปรวนเท่ากัน ซึ่งเป็นเหตุผลที่ทำให้ var.equal = TRUE เป็นจริง
3. ความเป็นอิสระ นี่เป็นผลมาจากการออกแบบการศึกษาและไม่สามารถทดสอบได้ภายหลัง หากบุคคลเดียวกันมีส่วนร่วมในทั้งสองเวกเตอร์ การทดสอบแบบอิสระเป็นเครื่องมือที่ไม่เหมาะสม และคุณจำเป็นต้องใช้การทดสอบแบบจับคู่ = ถูกต้อง
เมื่อสมมติฐานนั้นผิดพลาด สำหรับข้อมูลที่ไม่เป็นไปตามการแจกแจงแบบปกติอย่างชัดเจนและมีขนาดตัวอย่างเล็ก ให้ใช้ทางเลือกที่อิงตามลำดับ: wilcox.test(x, y) แทนที่การทดสอบ t สองกลุ่มตัวอย่าง และ wilcox.test(x, y, paired = TRUE) แทนที่เวอร์ชันแบบจับคู่ ทั้งสองวิธีไม่จำเป็นต้องให้ข้อมูลเป็นไปตามการแจกแจงแบบปกติ แต่จะลดกำลังการทดสอบลงเล็กน้อยเมื่อข้อมูลเป็นไปตามการแจกแจงแบบปกติ
การทดสอบ T ใน R: ประเด็นสำคัญและเอกสารอ้างอิงการทดสอบ
- การอนุมานทางสถิติเป็นศิลปะในการสร้างข้อสรุปเกี่ยวกับการกระจายตัวของข้อมูล
- การทดสอบ T เป็นการทดสอบในกลุ่มสถิติเชิงอนุมาน มักใช้เพื่อหาว่าค่าเฉลี่ยของสองกลุ่มมีค่าต่างกันในทางสถิติหรือไม่
- การทดสอบ t แบบหนึ่งตัวอย่าง หรือการทดสอบของสตูเดนต์ ใช้เปรียบเทียบค่าเฉลี่ยของเวกเตอร์กับค่าเฉลี่ยเชิงทฤษฎี
- การทดสอบ t แบบจับคู่ หรือการทดสอบ t สำหรับกลุ่มตัวอย่างที่ขึ้นอยู่กัน ใช้เมื่อทำการวัดกลุ่มเดียวกันสองครั้ง
ตารางด้านล่างนี้สรุปการทดสอบแต่ละรายการที่กล่าวถึงข้างต้น:
| เอกสาร | สมมติฐานที่จะทดสอบ | p-value | Code | อาร์กิวเมนต์ทางเลือก |
|---|---|---|---|---|
| การทดสอบทีหนึ่งตัวอย่าง | ค่าเฉลี่ยของเวกเตอร์แตกต่างจากค่าเฉลี่ยทางทฤษฎี | 0.05 |
t.test(x, mu = mean)
|
|
| จับคู่ตัวอย่างการทดสอบที | ค่าเฉลี่ย A แตกต่างจากค่าเฉลี่ย B สำหรับกลุ่มตัวอย่างเดียวกัน | 0.05 |
t.test(A, B, paired = TRUE) |
var.equal = TRUE
|
หากคุณยินยอมที่จะสมมติว่าความแปรปรวนเท่ากันในการทดสอบสองกลุ่มตัวอย่างอิสระ ให้ตั้งค่า var.equal = TRUE หากต้องการใช้การแก้ไขแบบ Welch ที่ปลอดภัยกว่า ให้ปล่อยไว้ที่ค่าเริ่มต้น FALSE
