
GLM ใน R: แบบจำลองเชิงเส้นทั่วไปและการถดถอยโลจิสติกส์
 เอเวลิน คลาร์ก
⚡ สรุปอย่างชาญฉลาด
แบบจำลองเชิงเส้นทั่วไป (Generalized Linear Model: GLM) ใน R ขยายการถดถอยแบบปกติไปสู่ผลลัพธ์ที่เป็นไบนารี ข้อมูลเชิงนับ หรือไม่เป็นไปตามการแจกแจงแบบปกติ บทแนะนำนี้จะสร้าง GLM แบบโลจิสติกบนชุดข้อมูลรายได้ของผู้ใหญ่ และประเมินผลด้วยความแม่นยำ ความเที่ยงตรง การเรียกคืน และ ROC
แบบจำลองเชิงเส้นทั่วไป (Generalized Linear Model หรือ GLM) ใน R คืออะไร?
A แบบจำลองเชิงเส้นทั่วไป (GLM) เป็นการขยายการถดถอยเชิงเส้นแบบธรรมดา เพื่อให้ตัวแปรตอบสนองอาจมีการกระจายตัวแบบอื่นนอกเหนือจากการกระจายตัวแบบปกติ ใน Rคุณติดตั้งอันที่มีช่องสำหรับติดตั้งในตัว จีแอลเอ็ม() ฟังก์ชันจากแพ็กเกจ stats
GLM ทุกตัวถูกกำหนดโดยองค์ประกอบสามส่วน:
- ส่วนประกอบแบบสุ่ม: การแจกแจงความน่าจะเป็นของตัวแปรตอบสนอง ซึ่งได้มาจากตระกูลเลขชี้กำลัง (ทวินาม ปัวซง แกมมา เกาส์เซียน และอื่นๆ)
- ส่วนประกอบที่เป็นระบบ: ตัวทำนายเชิงเส้น ซึ่งก็คือการรวมกันแบบถ่วงน้ำหนักของตัวแปรอธิบายของคุณ
- ฟังก์ชั่นลิงค์: ฟังก์ชันที่เชื่อมโยงค่าเฉลี่ยของผลตอบสนองกับตัวทำนายเชิงเส้น ตัวอย่างเช่น ฟังก์ชัน logit สำหรับข้อมูลไบนารี หรือฟังก์ชัน log สำหรับข้อมูลนับจำนวน
โครงสร้างนั้นเองที่ทำให้แบบจำลอง "เป็นแบบทั่วไป" แทนที่จะบังคับให้ผลลัพธ์มีการกระจายแบบปกติ คุณประกาศการกระจายที่ถูกต้องผ่านทาง ครอบครัว อาร์กิวเมนต์และ R ประมาณค่าสัมประสิทธิ์โดยใช้วิธีความน่าจะเป็นสูงสุด การถดถอยโลจิสติกส์เป็นเพียง GLM ที่มีตระกูลทวินามและลิงก์แบบ logit ดังนั้นจึงเป็นจุดเริ่มต้นที่เป็นธรรมชาติ
การถดถอยโลจิสติกส์ใน R คืออะไร?
การถดถอยโลจิสติกใช้ในการทำนายคลาส เช่น ความน่าจะเป็น การถดถอยโลจิสติกสามารถทำนายผลลัพธ์ไบนารี่ได้อย่างแม่นยำ
ลองจินตนาการว่าคุณต้องการคาดการณ์ว่าเงินกู้จะถูกปฏิเสธ/ยอมรับโดยพิจารณาจากคุณลักษณะหลายประการหรือไม่ การถดถอยโลจิสติกอยู่ในรูปแบบ 0/1 y = 0 หากเงินกู้ถูกปฏิเสธ y = 1 หากได้รับการยอมรับ
แบบจำลองการถดถอยโลจิสติกแตกต่างจากแบบจำลองการถดถอยเชิงเส้นในสองวิธี
- ประการแรก การถดถอยโลจิสติกยอมรับเฉพาะอินพุตแบบไดโคโตมัส (ไบนารี่) เป็นตัวแปรตาม (เช่น เวกเตอร์ 0 และ 1)
- ประการที่สอง ผลลัพธ์จะถูกแมปผ่านฟังก์ชันเชื่อมโยงความน่าจะเป็นที่เรียกว่า ซิกมอยด์ ฟังก์ชัน (โลจิสติกส์) เนื่องมาจากรูปทรงตัว S:

ผลลัพธ์ของฟังก์ชันจะอยู่ระหว่าง 0 ถึง 1 เสมอ ตรวจสอบรูปภาพด้านล่าง
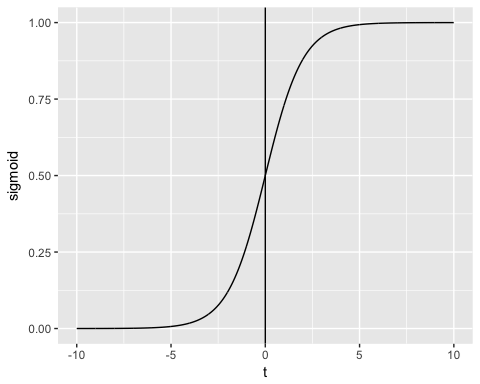
ฟังก์ชัน sigmoid ส่งคืนค่าจาก 0 ถึง 1 สำหรับงานการจัดหมวดหมู่ เราจำเป็นต้องมีเอาต์พุตแบบไม่ต่อเนื่องเป็น 0 หรือ 1
ในการแปลงการไหลต่อเนื่องเป็นค่าที่ไม่ต่อเนื่อง เราสามารถกำหนดขอบเขตการตัดสินใจไว้ที่ 0.5 ค่าทั้งหมดที่อยู่เหนือเกณฑ์นี้จัดเป็น 1

เมื่อเข้าใจฟังก์ชันเชื่อมโยงแล้ว ให้เปรียบเทียบแบบจำลองทั่วไปกับแบบจำลองเชิงเส้นธรรมดาที่คุณรู้จักอยู่แล้ว
GLM เทียบกับการถดถอยเชิงเส้น: ความแตกต่างที่สำคัญใน R
ก่อนที่คุณจะเขียนโค้ดใดๆ การรู้ว่ามาตรฐานนั้นใช้เมื่อใดจะช่วยได้มาก การถดถอยเชิงเส้น ฟังก์ชัน lm() ไม่เหมาะสมอีกต่อไปแล้ว และควรใช้ glm() แทน
| หลักเกณฑ์ | การถดถอยเชิงเส้น (lm) | แบบจำลองเชิงเส้นทั่วไป (glm) |
|---|---|---|
| ตัวแปรตอบสนอง | ต่อเนื่องและไร้ขอบเขต | ไบนารี, จำนวนนับ, สัดส่วน หรือค่าต่อเนื่องบวก |
| การกระจายข้อผิดพลาด | ปกติเท่านั้น | สมาชิกในครอบครัวใดๆ ที่เป็นแบบเลขชี้กำลัง |
| ฟังก์ชั่นการเชื่อมโยง | อัตลักษณ์ (โดยนัย) | ระบุอย่างชัดเจน: logit, log, inverse, probit |
| วิธีการประมาณค่า | สี่เหลี่ยมจัตุรัสน้อยที่สุดสามัญ | ความน่าจะเป็นสูงสุด (IRLS) |
| สมมติฐานความแปรปรวน | ค่าคงที่ตลอดการสังเกต | อนุญาตให้ขึ้นอยู่กับค่าเฉลี่ย |
| การวัดความพอดี | R-กำลังสอง | ค่า AIC และความเบี่ยงเบนตกค้าง |
| ฟังก์ชันอาร์ | lm(สูตร, ข้อมูล) | glm(สูตร, ข้อมูล, ตระกูล) |
โดยสรุป ให้เลือกใช้ lm() เมื่อผลลัพธ์เป็นการวัดที่มีการกระจายแบบปกติ และเลือกใช้ glm() เมื่อผลลัพธ์เป็นการตัดสินใจแบบใช่/ไม่ใช่ ซึ่งเป็นงานที่คุณสามารถมอบหมายให้คนอื่นทำได้ ต้นไม้ตัดสินใจ ตัวจำแนก, จำนวนเหตุการณ์ หรือปริมาณที่เป็นบวกอย่างเคร่งครัดซึ่งการกระจายตัวจะเพิ่มขึ้นตามค่าเฉลี่ย
วิธีการสร้างแบบจำลองเชิงเส้นทั่วไป (GLM) ใน R
เมื่อเข้าใจทฤษฎีอย่างถ่องแท้แล้ว ส่วนที่เหลือของบทช่วยสอนนี้จะนำแบบจำลอง GLM แบบทวินามมาประยุกต์ใช้กับชุดข้อมูลจริงตั้งแต่ต้นจนจบ
มาใช้ไฟล์ ผู้ใหญ่ ชุดข้อมูลนี้ใช้เพื่อแสดงตัวอย่างการถดถอยโลจิสติกส์ ชุดข้อมูล "ผู้ใหญ่" เหมาะอย่างยิ่งสำหรับงานจำแนกประเภท เป้าหมายคือการทำนายว่ารายได้ต่อปีของบุคคลในสกุลเงินดอลลาร์สหรัฐจะเกิน 50,000 หรือไม่ ชุดข้อมูลประกอบด้วยข้อมูลสังเกตการณ์ 48,842 รายการ และตัวแปรสิบตัว:
- อายุ: อายุของบุคคล ตัวเลข
- การศึกษา: ระดับการศึกษาของแต่ละบุคคล ปัจจัย.
- สถานะการสมรส: Mariสถานะของบุคคล ปัจจัย ได้แก่ ไม่เคยแต่งงาน, แต่งงานแล้ว-คู่สมรส, …
- เพศ: เพศของบุคคล ปัจจัย เช่น ชายหรือหญิง
- รายได้: Target ตัวแปร. รายได้สูงกว่าหรือต่ำกว่า 50K ปัจจัย เช่น >50K, <=50K
ท่ามกลางคนอื่น ๆ
library(dplyr)
data_adult <-read.csv("https://raw.githubusercontent.com/guru99-edu/R-Programming/master/adult.csv")
glimpse(data_adult)
Output:
Observations: 48,842
Variables: 10
$ x               <int> 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15,...
$ age             <int> 25, 38, 28, 44, 18, 34, 29, 63, 24, 55, 65, 36, 26...
$ workclass       <fctr> Private, Private, Local-gov, Private, ?, Private,...
$ education       <fctr> 11th, HS-grad, Assoc-acdm, Some-college, Some-col...
$ educational.num <int> 7, 9, 12, 10, 10, 6, 9, 15, 10, 4, 9, 13, 9, 9, 9,...
$ marital.status  <fctr> Never-married, Married-civ-spouse, Married-civ-sp...
$ race            <fctr> Black, White, White, Black, White, White, Black, ...
$ gender          <fctr> Male, Male, Male, Male, Female, Male, Male, Male,...
$ hours.per.week  <int> 40, 50, 40, 40, 30, 30, 40, 32, 40, 10, 40, 40, 39...
$ income          <fctr> <=50K, <=50K, >50K, >50K, <=50K, <=50K, <=50K, >5...
เราจะดำเนินการดังนี้:
- ขั้นตอนที่ 1: ตรวจสอบตัวแปรต่อเนื่อง
- ขั้นตอนที่ 2: ตรวจสอบตัวแปรปัจจัย
- ขั้นตอนที่ 3: วิศวกรรมคุณลักษณะ
- ขั้นตอนที่ 4: สถิติสรุป
- ขั้นตอนที่ 5: ฝึก/ชุดทดสอบ
- ขั้นตอนที่ 6: สร้างแบบจำลอง
- ขั้นตอนที่ 7: ประเมินประสิทธิภาพของแบบจำลอง
- ขั้นตอนที่ 8: ปรับปรุงโมเดล
งานของคุณคือคาดการณ์ว่าบุคคลใดจะมีรายได้สูงกว่า 50K
ในบทช่วยสอนนี้ แต่ละขั้นตอนจะมีรายละเอียดเพื่อทำการวิเคราะห์ชุดข้อมูลจริง
ขั้นตอนที่ 1) ตรวจสอบตัวแปรต่อเนื่อง
ในขั้นตอนแรก คุณจะเห็นการกระจายตัวของตัวแปรต่อเนื่อง
continuous <-select_if(data_adult, is.numeric)
summary(continuous)
Code คำอธิบาย
- ต่อเนื่อง <- select_if(data_adult, is.numeric): ใช้ฟังก์ชัน select_if() จากไลบรารี dplyr เพื่อเลือกเฉพาะคอลัมน์ตัวเลข
- summary(continuous): พิมพ์สถิติสรุป
Output:
##        X              age        educational.num hours.per.week
##  Min.   :    1   Min.   :17.00   Min.   : 1.00   Min.   : 1.00
##  1st Qu.:11509   1st Qu.:28.00   1st Qu.: 9.00   1st Qu.:40.00
##  Median :23017   Median :37.00   Median :10.00   Median :40.00
##  Mean   :23017   Mean   :38.56   Mean   :10.13   Mean   :40.95
##  3rd Qu.:34525   3rd Qu.:47.00   3rd Qu.:13.00   3rd Qu.:45.00
##  Max.   :46033   Max.   :90.00   Max.   :16.00   Max.   :99.00
จากตารางด้านบน คุณจะเห็นได้ว่าข้อมูลมีมาตราส่วนที่ต่างกันโดยสิ้นเชิง และชั่วโมงต่อสัปดาห์มีค่าผิดปกติที่มาก (เช่น ดูที่ควอร์ไทล์สุดท้ายและค่าสูงสุด)
คุณสามารถจัดการกับมันได้โดยปฏิบัติตามสองขั้นตอน:
- วาดกราฟแสดงการกระจายของชั่วโมงต่อสัปดาห์
- สร้างมาตรฐานให้กับตัวแปรต่อเนื่อง
- พล็อตการกระจาย
มาดูการกระจายของชั่วโมงต่อสัปดาห์กันอย่างใกล้ชิด
# Histogram with kernel density curve
library(ggplot2)
ggplot(continuous, aes(x = hours.per.week)) +
    geom_density(alpha = .2, fill = "#FF6666")
Output:

ตัวแปรมีค่าผิดปกติจำนวนมากและไม่มีการกระจายที่ชัดเจน คุณสามารถแก้ปัญหานี้บางส่วนได้โดยการลบ 0.01 เปอร์เซ็นต์ชั่วโมงสูงสุดในแต่ละสัปดาห์
ไวยากรณ์พื้นฐานของควอนไทล์:
quantile(variable, percentile)
arguments:
-variable:  Select the variable in the data frame to compute the percentile
-percentile:  Can be a single value between 0 and 1 or multiple value. If multiple, use this format:  `c(A,B,C, ...)
- `A`,`B`,`C` and `...` are all integer from 0 to 1.
เราคำนวณเปอร์เซ็นไทล์ที่ 99 ของชั่วโมงทำงานรายสัปดาห์
top_one_percent <- quantile(data_adult$hours.per.week, .99)
top_one_percent
Code คำอธิบาย
- quantile(data_adult$hours.per.week, .99): คำนวณเปอร์เซ็นไทล์ที่ 99 ของเวลาทำงานรายสัปดาห์
Output:
## 99%
##  80
99 เปอร์เซ็นต์ของประชากรทำงานน้อยกว่า 80 ชั่วโมงต่อสัปดาห์
คุณสามารถยกเลิกการสังเกตเหนือเกณฑ์นี้ได้ คุณใช้ตัวกรองจาก ดีพลีร์ ห้องสมุด.
data_adult_drop <-data_adult %>%
filter(hours.per.week<top_one_percent)
dim(data_adult_drop)
Output:
## [1] 45537 10
- สร้างมาตรฐานให้กับตัวแปรต่อเนื่อง
คุณสามารถกำหนดมาตรฐานแต่ละคอลัมน์เพื่อปรับปรุงประสิทธิภาพได้เนื่องจากข้อมูลของคุณไม่มีขนาดเท่ากัน คุณสามารถใช้ฟังก์ชัน mutate_if จากไลบรารี dplyr ไวยากรณ์พื้นฐานคือ:
mutate_if(df, condition, funs(function))
arguments:
-`df`: Data frame used to compute the function
- `condition`: Statement used. Do not use parenthesis
- funs(function):  Return the function to apply. Do not use parenthesis for the function
คุณสามารถกำหนดมาตรฐานคอลัมน์ตัวเลขได้ดังนี้:
data_adult_rescale <- data_adult_drop %>%
	mutate_if(is.numeric, funs(as.numeric(scale(.))))
head(data_adult_rescale)
Code คำอธิบาย
- mutate_if(is.numeric, funs(scale)): เงื่อนไขเป็นเพียงคอลัมน์ตัวเลขและฟังก์ชันคือมาตราส่วน
Output:
##           X         age        workclass    education educational.num
## 1 -1.732680 -1.02325949          Private         11th     -1.22106443
## 2 -1.732605 -0.03969284          Private      HS-grad     -0.43998868
## 3 -1.732530 -0.79628257        Local-gov   Assoc-acdm      0.73162494
## 4 -1.732455  0.41426100          Private Some-college     -0.04945081
## 5 -1.732379 -0.34232873          Private         10th     -1.61160231
## 6 -1.732304  1.85178149 Self-emp-not-inc  Prof-school      1.90323857
##       marital.status  race gender hours.per.week income
## 1      Never-married Black   Male    -0.03995944  <=50K
## 2 Married-civ-spouse White   Male     0.86863037  <=50K
## 3 Married-civ-spouse White   Male    -0.03995944   >50K
## 4 Married-civ-spouse Black   Male    -0.03995944   >50K
## 5      Never-married White   Male    -0.94854924  <=50K
## 6 Married-civ-spouse White   Male    -0.76683128   >50K
ขั้นตอนที่ 2) ตรวจสอบตัวแปรปัจจัย
ขั้นตอนนี้มีวัตถุประสงค์สองประการ:
- ตรวจสอบระดับในแต่ละคอลัมน์หมวดหมู่
- กำหนดระดับใหม่
เราจะแบ่งขั้นตอนนี้ออกเป็นสามส่วน:
- เลือกคอลัมน์หมวดหมู่
- เก็บแผนภูมิแท่งของแต่ละคอลัมน์ในรายการ
- พิมพ์กราฟ
เราสามารถเลือกคอลัมน์ปัจจัยด้วยรหัสด้านล่าง:
# Select categorical column
factor <- data.frame(select_if(data_adult_rescale, is.factor))
	ncol(factor)
Code คำอธิบาย
- data.frame(select_if(data_adult, is.factor)): เราจัดเก็บคอลัมน์ตัวประกอบเป็นตัวประกอบในประเภทเฟรมข้อมูล ไลบรารี ggplot2 ต้องการวัตถุกรอบข้อมูล
Output:
## [1] 6
ชุดข้อมูลประกอบด้วยตัวแปรหมวดหมู่ 6 ตัว
ขั้นตอนที่สองมีความซับซ้อนกว่า คุณต้องการสร้างแผนภูมิแท่งสำหรับแต่ละคอลัมน์ในเฟรมข้อมูลประเภทแฟกเตอร์ การทำให้กระบวนการนี้เป็นแบบอัตโนมัติจะสะดวกกว่า โดยเฉพาะอย่างยิ่งในกรณีที่มีคอลัมน์จำนวนมาก
library(ggplot2)
# Create graph for each column
graph <- lapply(names(factor),
    function(x)
	ggplot(factor, aes(get(x))) +
		geom_bar() +
		theme(axis.text.x = element_text(angle = 90)))
Code คำอธิบาย
- lapply() : ใช้ฟังก์ชัน lapply() เพื่อส่งผ่านฟังก์ชันในทุกคอลัมน์ของชุดข้อมูล คุณเก็บผลลัพธ์ไว้ในรายการ
- function(x): ฟังก์ชันจะถูกประมวลผลสำหรับแต่ละ x โดยที่ x คือคอลัมน์
- ggplot(factor, aes(get(x))) + geom_bar()+ theme(axis.text.x = element_text(angle = 90)): สร้างแผนภูมิแท่งถ่านสำหรับแต่ละองค์ประกอบ x หมายเหตุ หากต้องการคืนค่า x เป็นคอลัมน์ คุณต้องรวมไว้ใน get()
ขั้นตอนสุดท้ายค่อนข้างง่าย คุณต้องการพิมพ์ 6 กราฟ
# Print the graph
graph
Output:
## [[1]]

## ## [[2]]

## ## [[3]]

## ## [[4]]

## ## [[5]]

## ## [[6]]

หมายเหตุ: ใช้ปุ่มถัดไปเพื่อนำทางไปยังกราฟถัดไป

ขั้นตอนที่ 3) คุณสมบัติทางวิศวกรรม
ตัวแปรเชิงหมวดหมู่สองตัวมีระดับมากกว่าที่แบบจำลองต้องการ คุณจะต้องจัดกลุ่มตัวแปรเหล่านั้นใหม่เป็นหมวดหมู่ที่กว้างขึ้นและมีจำนวนข้อมูลมากขึ้น
หล่อหลอมการศึกษา
จากกราฟด้านบนจะเห็นว่าการศึกษาตัวแปรมี 16 ระดับ นี่เป็นเรื่องสำคัญ และบางระดับก็มีจำนวนการสังเกตค่อนข้างน้อย หากคุณต้องการปรับปรุงปริมาณข้อมูลที่คุณจะได้รับจากตัวแปรนี้ คุณสามารถเขียนใหม่ให้อยู่ในระดับที่สูงขึ้นได้ กล่าวคือ คุณสร้างกลุ่มขนาดใหญ่ขึ้นโดยมีระดับการศึกษาใกล้เคียงกัน ตัวอย่างเช่น การศึกษาในระดับต่ำจะถูกเปลี่ยนให้อยู่ในภาวะออกจากกลางคัน ระดับการศึกษาที่สูงขึ้นจะเปลี่ยนเป็นปริญญาโท
นี่คือรายละเอียด:
| ระดับเก่า | ระดับใหม่ |
|---|---|
| เด็กก่อนวัยเรียน | การออกกลางคัน |
| 10th | การออกกลางคัน |
| 11th | การออกกลางคัน |
| 12th | การออกกลางคัน |
| 1st-4th | การออกกลางคัน |
| 5th-6th | การออกกลางคัน |
| 7th-8th | การออกกลางคัน |
| 9th | การออกกลางคัน |
| HS-Grad | มัธยมศึกษาตอนปลาย |
| วิทยาลัยบางแห่ง | สังคม |
| รศ.อ | สังคม |
| รศ | สังคม |
| ปริญญาตรี | ปริญญาตรี |
| ปริญญาโท | ปริญญาโท |
| ศ.-โรงเรียน | ปริญญาโท |
| ปริญญาเอก | ปริญญาเอก |
recast_data <- data_adult_rescale %>%
	select(-X) %>%
	mutate(education = factor(ifelse(education == "Preschool" | education == "10th" | education == "11th" | education == "12th" | education == "1st-4th" | education == "5th-6th" | education == "7th-8th" | education == "9th", "dropout", ifelse(education == "HS-grad", "HighGrad", ifelse(education == "Some-college" | education == "Assoc-acdm" | education == "Assoc-voc", "Community",
    ifelse(education == "Bachelors", "Bachelors",
        ifelse(education == "Masters" | education == "Prof-school", "Master", "PhD")))))))
Code คำอธิบาย
- เราใช้คำกริยากลายพันธุ์จากไลบรารี dplyr เราเปลี่ยนคุณค่าของการศึกษาด้วยคำว่า ifelse
ในตารางด้านล่าง คุณสร้างสถิติสรุปเพื่อดูโดยเฉลี่ยว่าต้องใช้เวลากี่ปีในการศึกษา (ค่า z) เพื่อเข้าเรียนในระดับปริญญาตรี ปริญญาโท หรือปริญญาเอก
recast_data %>%
	group_by(education) %>%
	summarize(average_educ_year = mean(educational.num),
		count = n()) %>%
	arrange(average_educ_year)
Output:
## # A tibble: 6 x 3
## education average_educ_year count
##      <fctr>             <dbl> <int>
## 1   dropout       -1.76147258  5712
## 2  HighGrad       -0.43998868 14803
## 3 Community        0.09561361 13407
## 4 Bachelors        1.12216282  7720
## 5    Master        1.60337381  3338
## 6       PhD        2.29377644   557
แต่งใหม่ Mariสถานะทัล
นอกจากนี้ยังสามารถสร้างระดับที่ต่ำกว่าสำหรับสถานะการสมรสได้อีกด้วย ในโค้ดต่อไปนี้ คุณสามารถเปลี่ยนระดับได้ดังนี้:
| ระดับเก่า | ระดับใหม่ |
|---|---|
| ไม่เคยแต่งงาน | ยังไม่แต่งงาน |
| แต่งงาน-คู่สมรส-ไม่อยู่ | ยังไม่แต่งงาน |
| แต่งงาน-AF-คู่สมรส | แต่งงาน |
| สมรส-พลเมือง-คู่สมรส | |
| แยก | แยก |
| หย่า | |
| แม่ม่าย | แม่ม่าย |
# Change level marry
recast_data <- recast_data %>%
	mutate(marital.status = factor(ifelse(marital.status == "Never-married" | marital.status == "Married-spouse-absent", "Not_married", ifelse(marital.status == "Married-AF-spouse" | marital.status == "Married-civ-spouse", "Married", ifelse(marital.status == "Separated" | marital.status == "Divorced", "Separated", "Widow")))))
คุณสามารถตรวจสอบจำนวนบุคคลในแต่ละกลุ่มได้
table(recast_data$marital.status)
Output:
## ##     Married Not_married   Separated       Widow
##       21165       15359        7727        1286
ขั้นตอนที่ 4) สถิติสรุป
ถึงเวลาตรวจสอบสถิติเกี่ยวกับตัวแปรเป้าหมายของเราแล้ว ในกราฟด้านล่าง คุณนับเปอร์เซ็นต์ของบุคคลที่มีรายได้มากกว่า 50 ตามเพศ
# Plot gender income
ggplot(recast_data, aes(x = gender, fill = income)) +
    geom_bar(position = "fill") +
    theme_classic()
Output:

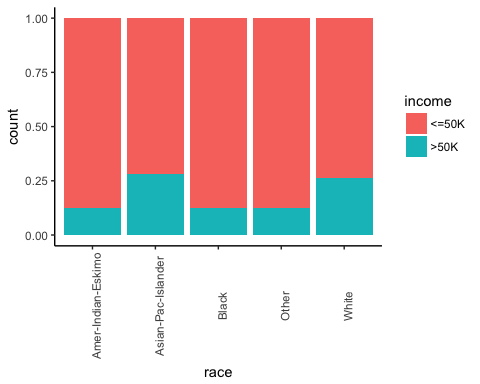
จากนั้น ตรวจสอบว่าที่มาของบุคคลส่งผลต่อรายได้หรือไม่
# Plot origin income
ggplot(recast_data, aes(x = race, fill = income)) +
    geom_bar(position = "fill") +
    theme_classic() +
    theme(axis.text.x = element_text(angle = 90))
Output:
จำนวนชั่วโมงการทำงานแยกตามเพศ
# box plot gender working time
ggplot(recast_data, aes(x = gender, y = hours.per.week)) +
    geom_boxplot() +
    stat_summary(fun.y = mean,
        geom = "point",
        size = 3,
        color = "steelblue") +
    theme_classic()
Output:

แผนภาพกล่องยืนยันว่าการกระจายเวลาทำงานเหมาะกับกลุ่มต่างๆ ในแผนภาพกล่อง ทั้งสองเพศไม่มีการสังเกตที่เป็นเนื้อเดียวกัน
คุณสามารถตรวจสอบความหนาแน่นของเวลาทำงานรายสัปดาห์ตามประเภทการศึกษาได้ การกระจายตัวมีจุดเด่นที่แตกต่างกันหลายจุด ซึ่งอาจอธิบายได้ด้วยประเภทของสัญญาtracในสหรัฐอเมริกา
# Plot distribution working time by education
ggplot(recast_data, aes(x = hours.per.week)) +
    geom_density(aes(color = education), alpha = 0.5) +
    theme_classic()
Code คำอธิบาย
- ggplot(recast_data, aes( x= hours.per.week)): กราฟความหนาแน่นต้องการตัวแปรเพียงตัวเดียว
- geom_density(aes(color = educational), alpha =0.5): วัตถุทางเรขาคณิตที่ใช้ควบคุมความหนาแน่น
Output:

เพื่อยืนยันความคิดของคุณ คุณสามารถดำเนินการทางเดียวได้ การทดสอบ ANOVA:
anova <- aov(hours.per.week~education, recast_data)
summary(anova)
Output:
##                Df Sum Sq Mean Sq F value Pr(>F)
## education       5   1552  310.31   321.2 <2e-16 ***
## Residuals   45531  43984    0.97
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
การทดสอบ ANOVA ยืนยันความแตกต่างในค่าเฉลี่ยระหว่างกลุ่ม
แบบไม่เชิงเส้น
ก่อนที่คุณจะรันโมเดล คุณสามารถดูว่าจำนวนชั่วโมงที่ทำงานเกี่ยวข้องกับอายุหรือไม่
library(ggplot2)
ggplot(recast_data, aes(x = age, y = hours.per.week)) +
    geom_point(aes(color = income),
        size = 0.5) +
    stat_smooth(method = 'lm',
        formula = y~poly(x, 2),
        se = TRUE,
        aes(color = income)) +
    theme_classic()
Code คำอธิบาย
- ggplot(recast_data, aes(x = age, y = hours.per.week)): กำหนดความสวยงามของกราฟ
- geom_point(aes(color= Income), size =0.5): สร้างจุดพล็อต
- stat_smooth(): เพิ่มเส้นแนวโน้มด้วยอาร์กิวเมนต์ต่อไปนี้:
- method='lm': พล็อตค่าที่ติดตั้งถ้า การถดถอยเชิงเส้น
- สูตร = y~poly(x,2): ปรับการถดถอยพหุนามให้พอดี
- se = TRUE: เพิ่มข้อผิดพลาดมาตรฐาน
- aes(color=income): แบ่งโมเดลตามรายได้
Output:

โดยสรุป คุณสามารถทดสอบเงื่อนไขการโต้ตอบในแบบจำลองเพื่อรับผลกระทบที่ไม่เป็นเชิงเส้นระหว่างเวลาทำงานรายสัปดาห์และคุณสมบัติอื่นๆ สิ่งสำคัญคือต้องตรวจสอบว่าเวลาทำงานแตกต่างกันภายใต้สภาวะใด
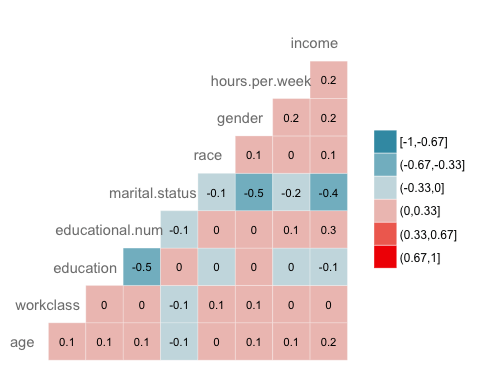
ความสัมพันธ์
การตรวจสอบครั้งต่อไปคือการแสดงภาพความสัมพันธ์ระหว่างตัวแปรต่างๆ คุณแปลงประเภทระดับปัจจัยเป็นตัวเลข เพื่อให้คุณสามารถพล็อตแผนที่ความร้อนที่มีค่าสัมประสิทธิ์สหสัมพันธ์ที่คำนวณด้วยวิธี Spearman
library(GGally)
# Convert data to numeric
corr <- data.frame(lapply(recast_data, as.integer))
# Plot the graphggcorr(corr,
    method = c("pairwise", "spearman"),
    nbreaks = 6,
    hjust = 0.8,
    label = TRUE,
    label_size = 3,
    color = "grey50")
Code คำอธิบาย
- data.frame(lapply(recast_data,as.integer)): แปลงข้อมูลเป็นตัวเลข
- ggcorr() พล็อตแผนที่ความร้อนด้วยอาร์กิวเมนต์ต่อไปนี้:
- วิธีการ: วิธีการคำนวณความสัมพันธ์
- nbreaks = 6: จำนวนการพัก
- hjust = 0.8: ตำแหน่งควบคุมของชื่อตัวแปรในพล็อต
- ป้าย = TRUE: เพิ่มป้ายชื่อที่กึ่งกลางของหน้าต่าง
- label_size = 3: ป้ายขนาด
- color = “grey50”): สีของฉลาก
Output:
ขั้นตอนที่ 5) ฝึก/ชุดทดสอบ
กำกับดูแลแต่อย่างใด เรียนรู้เครื่อง งานนี้ต้องการให้คุณแบ่งข้อมูลออกเป็นชุดฝึกฝนและชุดทดสอบ คุณสามารถใช้ "ฟังก์ชัน" ที่คุณสร้างไว้ในบทเรียนการเรียนรู้แบบมีผู้กำกับดูแลอื่นๆ เพื่อสร้างชุดฝึกฝน/ชุดทดสอบได้
set.seed(1234)
create_train_test <- function(data, size = 0.8, train = TRUE) {
    n_row = nrow(data)
    total_row = size * n_row
    train_sample <- 1: total_row
    if (train == TRUE) {
        return (data[train_sample, ])
    } else {
        return (data[-train_sample, ])
    }
}
data_train <- create_train_test(recast_data, 0.8, train = TRUE)
data_test <- create_train_test(recast_data, 0.8, train = FALSE)
dim(data_train)
Output:
## [1] 36429 9
dim(data_test)
Output:
## [1] 9108 9
ขั้นตอนที่ 6) สร้างแบบจำลอง
เพื่อดูว่าอัลกอริทึมทำงานอย่างไร ให้ใช้ฟังก์ชัน glm() จากแพ็กเกจ stats โมเดลเชิงเส้นทั่วไป เป็นการรวบรวมโมเดล ไวยากรณ์พื้นฐานคือ:
glm(formula, data=data, family=linkfunction()
Argument:
- formula:  Equation used to fit the model- data: dataset used
- Family:     - binomial: (link = "logit")
- gaussian: (link = "identity")
- Gamma:    (link = "inverse")
- inverse.gaussian: (link = "1/mu^2")
- poisson:  (link = "log")
- quasi:    (link = "identity", variance = "constant")
- quasibinomial:    (link = "logit")
- quasipoisson: (link = "log")
คุณพร้อมที่จะประมาณแบบจำลองลอจิสติกส์เพื่อแบ่งระดับรายได้ระหว่างชุดคุณลักษณะต่างๆ
formula <- income~.
logit <- glm(formula, data = data_train, family = 'binomial')
summary(logit)
Code คำอธิบาย
- สูตร <- รายได้ ~ .: สร้างโมเดลให้ลงตัว
- logit <- glm(formula, data = data_train, family = 'binomial'): ปรับโมเดลลอจิสติกส์ (family = 'binomial') ด้วยข้อมูล data_train
- summary(logit): พิมพ์ข้อมูลสรุปของโมเดล
Output:
##
## Call:
## glm(formula = formula, family = "binomial", data = data_train)
## ## Deviance Residuals:
##     Min       1Q   Median       3Q      Max
## -2.6456  -0.5858  -0.2609  -0.0651   3.1982
##
## Coefficients:
##                           Estimate Std. Error z value Pr(>|z|)
## (Intercept)                0.07882    0.21726   0.363  0.71675
## age                        0.41119    0.01857  22.146  < 2e-16 ***
## workclassLocal-gov        -0.64018    0.09396  -6.813 9.54e-12 ***
## workclassPrivate          -0.53542    0.07886  -6.789 1.13e-11 ***
## workclassSelf-emp-inc     -0.07733    0.10350  -0.747  0.45499
## workclassSelf-emp-not-inc -1.09052    0.09140 -11.931  < 2e-16 ***
## workclassState-gov        -0.80562    0.10617  -7.588 3.25e-14 ***
## workclassWithout-pay      -1.09765    0.86787  -1.265  0.20596
## educationCommunity        -0.44436    0.08267  -5.375 7.66e-08 ***
## educationHighGrad         -0.67613    0.11827  -5.717 1.08e-08 ***
## educationMaster            0.35651    0.06780   5.258 1.46e-07 ***
## educationPhD               0.46995    0.15772   2.980  0.00289 **
## educationdropout          -1.04974    0.21280  -4.933 8.10e-07 ***
## educational.num            0.56908    0.07063   8.057 7.84e-16 ***
## marital.statusNot_married -2.50346    0.05113 -48.966  < 2e-16 ***
## marital.statusSeparated   -2.16177    0.05425 -39.846  < 2e-16 ***
## marital.statusWidow       -2.22707    0.12522 -17.785  < 2e-16 ***
## raceAsian-Pac-Islander     0.08359    0.20344   0.411  0.68117
## raceBlack                  0.07188    0.19330   0.372  0.71001
## raceOther                  0.01370    0.27695   0.049  0.96054
## raceWhite                  0.34830    0.18441   1.889  0.05894 .
## genderMale                 0.08596    0.04289   2.004  0.04506 *
## hours.per.week             0.41942    0.01748  23.998  < 2e-16 ***
## ---## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
## ## (Dispersion parameter for binomial family taken to be 1)
## ##     Null deviance: 40601  on 36428  degrees of freedom
## Residual deviance: 27041  on 36406  degrees of freedom
## AIC: 27087
##
## Number of Fisher Scoring iterations: 6
การสรุปแบบจำลองของเราเผยให้เห็นข้อมูลที่น่าสนใจ ประสิทธิภาพของการถดถอยโลจิสติกได้รับการประเมินด้วยตัวชี้วัดหลักเฉพาะ
- AIC (เกณฑ์ข้อมูล Akaike): ซึ่งเทียบเท่ากับ R2 ในการถดถอยโลจิสติก โดยจะวัดความพอดีเมื่อมีการใช้การลงโทษกับจำนวนพารามิเตอร์ เล็กลง AIC ค่าบ่งชี้ว่าแบบจำลองนั้นใกล้เคียงกับความจริงมากขึ้น
- การเบี่ยงเบนแบบ Null: เหมาะกับโมเดลที่มีจุดตัดกันเท่านั้น ระดับความเป็นอิสระคือ n-1 เราสามารถตีความได้ว่าเป็นค่าไคสแควร์ (ค่าที่เหมาะสมแตกต่างจากการทดสอบสมมติฐานค่าจริง)
- ความเบี่ยงเบนตกค้าง: แบบจำลองที่มีตัวแปรทั้งหมด นอกจากนี้ยังตีความว่าเป็นการทดสอบสมมติฐานไคสแควร์ด้วย
- จำนวนการวนซ้ำของ Fisher Scoring: จำนวนการวนซ้ำก่อนที่จะมาบรรจบกัน
ผลลัพธ์ของฟังก์ชัน glm() จะถูกจัดเก็บไว้ในรายการ โค้ดด้านล่างแสดงรายการทั้งหมดที่มีอยู่ในตัวแปร logit ที่เราสร้างขึ้นเพื่อประเมินการถดถอยโลจิสติก
#รายการยาวมาก พิมพ์แค่ 3 องค์ประกอบแรกเท่านั้น
lapply(logit, class)[1:3]
Output:
## $coefficients
## [1] "numeric"
##
## $residuals
## [1] "numeric"
##
## $fitted.values
## [1] "numeric"
แต่ละค่าสามารถยกได้tracตามด้วยเครื่องหมาย $ และชื่อของตัวชี้วัด ตัวอย่างเช่น คุณจัดเก็บโมเดลเป็น logittracในเกณฑ์ AIC คุณใช้:
logit$aic
Output:
## [1] 27086.65
ขั้นตอนที่ 7) ประเมินประสิทธิภาพของแบบจำลอง
เมทริกซ์ความสับสน
การขอ เมทริกซ์ความสับสน เป็นตัวเลือกที่ดีกว่าในการประเมินประสิทธิภาพการจัดหมวดหมู่โดยเปรียบเทียบกับเมตริกต่างๆ ที่คุณเห็นก่อนหน้านี้ แนวคิดทั่วไปคือการนับจำนวนครั้งที่อินสแตนซ์ True ถูกจัดว่าเป็นเท็จ

ในการคำนวณเมทริกซ์ความสับสน คุณต้องมีชุดการคาดการณ์ก่อนจึงจะสามารถเปรียบเทียบกับเป้าหมายจริงได้
predict <- predict(logit, data_test, type = 'response')
# confusion matrix
table_mat <- table(data_test$income, predict > 0.5)
table_mat
Code คำอธิบาย
- Predict(logit,data_test, type = 'response'): คำนวณการทำนายบนชุดทดสอบ ตั้งค่า type = 'response' เพื่อคำนวณความน่าจะเป็นในการตอบสนอง
- table(data_test$income, ทำนาย > 0.5): คำนวณเมทริกซ์ความสับสน ทำนาย > 0.5 หมายความว่าจะส่งคืนค่า 1 หากความน่าจะเป็นที่คาดการณ์ไว้สูงกว่า 0.5 มิฉะนั้นจะเป็น 0
Output:
##
##         FALSE TRUE
##   <=50K  6310  495
##   >50K   1074 1229
แต่ละแถวในเมทริกซ์ความสับสนแสดงถึงเป้าหมายจริง ในขณะที่แต่ละคอลัมน์แสดงถึงเป้าหมายที่คาดการณ์ไว้ แถวแรกของเมทริกซ์นี้พิจารณารายได้ที่ต่ำกว่า 50 (คลาสเชิงลบ): มีการจำแนกข้อมูล 6,310 รายการได้อย่างถูกต้องว่าเป็นบุคคลที่มีรายได้ต่ำกว่า 50 (ลบจริง) ในขณะที่ 495 รายถูกจัดประเภทผิดว่ามีรายได้มากกว่า 50 (บวกเท็จ). แถวที่สองพิจารณารายได้ที่สูงกว่า 50 บาท: มีผู้ตอบถูก 1,229 คน (บวกจริง) ขณะที่พลาดไป 1,074 ราย (ลบเชิงลบ).
คุณสามารถคำนวณแบบจำลองได้ ความถูกต้อง โดยการรวมค่าบวกจริง + ค่าลบจริงเข้ากับการสังเกตทั้งหมด

accuracy_Test <- sum(diag(table_mat)) / sum(table_mat)
accuracy_Test
Code คำอธิบาย
- sum(diag(table_mat)): ผลรวมของเส้นทแยงมุม
- sum(table_mat): ผลรวมของเมทริกซ์
Output:
## [1] 0.8277339
ดูเหมือนว่าแบบจำลองนี้จะมีปัญหาอยู่หนึ่งอย่าง คือ มันสร้างผลลัพธ์ที่เป็นเท็จเชิงลบมากเกินไป ปัญหานี้เรียกว่า... ความขัดแย้งในการทดสอบความแม่นยำเราได้กล่าวไว้ว่า ความแม่นยำคืออัตราส่วนของการทำนายที่ถูกต้องต่อจำนวนเคสทั้งหมด เราอาจมีความแม่นยำสูง แต่โมเดลอาจไร้ประโยชน์ สิ่งนี้เกิดขึ้นเมื่อมีคลาสที่เด่นกว่า หากคุณย้อนกลับไปดูเมทริกซ์ความสับสน คุณจะเห็นว่าเคสส่วนใหญ่ถูกจัดประเภทเป็น True Negative ลองนึกภาพว่า โมเดลจัดประเภทข้อมูลทุกรายการเป็นลบ (เช่น น้อยกว่า 50 รายการ) คุณก็จะยังคงได้ความแม่นยำประมาณ 75 เปอร์เซ็นต์ (6,805 / 9,108) โมเดลของคุณทำงานได้ดีขึ้น แต่ยังคงมีปัญหาในการแยกแยะ True Positive กับ True Negative
ในสถานการณ์เช่นนี้ ควรมีการวัดที่กระชับกว่านี้จะดีกว่า เราสามารถดูได้ที่:
- ความแม่นยำ=TP/(TP+FP)
- เรียกคืน=TP/(TP+FN)
ความแม่นยำเทียบกับการเรียกคืน
ความแม่นยำ ดูความแม่นยำของการทำนายเชิงบวก จำ คืออัตราส่วนของอินสแตนซ์เชิงบวกที่ตัวแยกประเภทตรวจพบอย่างถูกต้อง
คุณสามารถสร้างฟังก์ชันสองฟังก์ชันเพื่อคำนวณเมตริกทั้งสองนี้ได้
- สร้างความแม่นยำ
precision <- function(matrix) {
	# True positive
    tp <- matrix[2, 2]
	# false positive
    fp <- matrix[1, 2]
    return (tp / (tp + fp))
}
Code คำอธิบาย
- mat[1,1]: ส่งกลับเซลล์แรกของคอลัมน์แรกของกรอบข้อมูล นั่นคือค่าบวกที่แท้จริง
- เสื่อ[1,2]; ส่งกลับเซลล์แรกของคอลัมน์ที่สองของกรอบข้อมูล เช่น ผลบวกลวง
recall <- function(matrix) {
# true positive
    tp <- matrix[2, 2]# false positive
    fn <- matrix[2, 1]
    return (tp / (tp + fn))
}
Code คำอธิบาย
- mat[1,1]: ส่งกลับเซลล์แรกของคอลัมน์แรกของกรอบข้อมูล นั่นคือค่าบวกที่แท้จริง
- เสื่อ[2,1]; ส่งกลับเซลล์ที่สองของคอลัมน์แรกของกรอบข้อมูล เช่น ผลลบลวง
คุณสามารถทดสอบการทำงานของคุณได้
prec <- precision(table_mat)
prec
rec <- recall(table_mat)
rec
Output:
## [1] 0.712877
## [2] 0.5336518
โปรดอ่านตัวเลขสองตัวนี้อย่างละเอียด ความแม่นยำ (Precision) คือ 0.71 ซึ่งหมายความว่าเมื่อแบบจำลองบอกว่าบุคคลนั้นมีรายได้มากกว่า 50 บาท มันจะถูกต้องใน 71 เปอร์เซ็นต์ของกรณีทั้งหมด ส่วนการเรียกคืน (Recall) คือ 0.53 ซึ่งหมายความว่าแบบจำลองตรวจจับได้เพียง 53 เปอร์เซ็นต์ของบุคคลที่มีรายได้มากกว่า 50 บาทจริง ๆ
คุณสามารถสร้าง  คะแนนขึ้นอยู่กับความแม่นยำและการจดจำ ที่ คือค่าเฉลี่ยฮาร์มอนิกของทั้งสองหน่วยเมตริก ซึ่งหมายความว่าค่าที่ต่ำกว่าจะให้น้ำหนักมากกว่า

f1 <- 2 * ((prec * rec) / (prec + rec))
f1
Output:
## [1] 0.6103799
ความแม่นยำเทียบกับการแลกเปลี่ยนการเรียกคืน
เป็นไปไม่ได้ที่จะมีทั้งความแม่นยำและการเรียกคืนสูง
หากเราเพิ่มความแม่นยำ บุคคลที่ถูกต้องจะถูกคาดการณ์ได้ดีขึ้น แต่เราจะพลาดจำนวนมาก (การเรียกคืนน้อยกว่า) ในบางสถานการณ์ เราต้องการความแม่นยำมากกว่าการเรียกคืน มีความสัมพันธ์แบบเว้าระหว่างความแม่นยำและการจดจำ
- ลองนึกภาพ คุณต้องคาดการณ์ว่าผู้ป่วยมีโรคหรือไม่ คุณต้องการที่จะแม่นยำที่สุด
- หากคุณต้องการตรวจจับผู้ที่อาจฉ้อโกงบนท้องถนนผ่านการจดจำใบหน้า คงจะดีกว่าถ้าจับคนจำนวนมากที่ถูกระบุว่าฉ้อโกงแม้ว่าจะมีความแม่นยำต่ำก็ตาม ตำรวจจะสามารถปล่อยตัวผู้ไม่ฉ้อโกงได้
เส้นโค้ง ROC
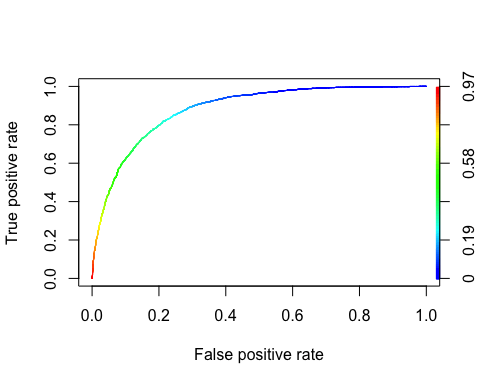
การขอ ผู้รับ Operaลักษณะเฉพาะ curve เป็นอีกหนึ่งเครื่องมือทั่วไปที่ใช้กับการจำแนกไบนารี มันคล้ายกับเส้นโค้งความแม่นยำ/การเรียกคืนมาก แต่แทนที่จะวางแผนความแม่นยำกับการเรียกคืน เส้นโค้ง ROC จะแสดงอัตราบวกที่แท้จริง (เช่น การเรียกคืน) เทียบกับอัตราบวกลวง อัตราผลบวกลวงคืออัตราส่วนของอินสแตนซ์เชิงลบที่จัดประเภทไม่ถูกต้องว่าเป็นบวก มันเท่ากับ 1 ลบอัตราติดลบจริง อัตราลบที่แท้จริงเรียกอีกอย่างว่า ความจำเพาะ- ดังนั้นกราฟ ROC ความไว (การเรียกคืน) กับ 1 ความจำเพาะ
ในการสร้างกราฟ ROC เราจำเป็นต้องติดตั้งแพ็กเกจที่ชื่อว่า ROCR ซึ่งสามารถหาได้จาก conda ห้องสมุด- คุณสามารถพิมพ์รหัส:
conda install -c r r-rocr --yes
เราสามารถพล็อต ROC ด้วยฟังก์ชันการทำนาย () และประสิทธิภาพ ()
library(ROCR)
ROCRpred <- prediction(predict, data_test$income)
ROCRperf <- performance(ROCRpred, 'tpr', 'fpr')
plot(ROCRperf, colorize = TRUE, text.adj = c(-0.2, 1.7))
Code คำอธิบาย
- การทำนาย(ทำนาย, data_test$income): ไลบรารี ROCR จำเป็นต้องสร้างออบเจ็กต์การทำนายเพื่อแปลงข้อมูลอินพุต
- ประสิทธิภาพ (ROCRpred, 'tpr', 'fpr'): ส่งคืนชุดค่าผสมทั้งสองเพื่อสร้างในกราฟ ที่นี่ tpr และ fpr ถูกสร้างขึ้น Tot พล็อตความแม่นยำและการเรียกคืนร่วมกัน ใช้ "prec", "rec"
Output:
ขั้นตอนที่ 8) ปรับปรุงโมเดล
คุณสามารถลองเพิ่มความไม่เชิงเส้นให้กับโมเดลด้วยการโต้ตอบระหว่าง
- อายุและชั่วโมงต่อสัปดาห์
- เพศและชั่วโมงต่อสัปดาห์
จากนั้นให้เปรียบเทียบค่า F1 ของทั้งสองรุ่น
formula_2 <- income~age: hours.per.week + gender: hours.per.week + .
logit_2 <- glm(formula_2, data = data_train, family = 'binomial')
predict_2 <- predict(logit_2, data_test, type = 'response')
table_mat_2 <- table(data_test$income, predict_2 > 0.5)
precision_2 <- precision(table_mat_2)
recall_2 <- recall(table_mat_2)
f1_2 <- 2 * ((precision_2 * recall_2) / (precision_2 + recall_2))
f1_2
Output:
## [1] 0.6109181
คะแนน F1 สูงกว่าครั้งก่อนเล็กน้อย คุณสามารถทำงานกับข้อมูลต่อไปและพยายามทำคะแนนให้สูงกว่านี้ได้
วิธีตีความค่าสัมประสิทธิ์ GLM และอัตราส่วนความน่าจะเป็นใน R
ตารางสรุปที่พิมพ์ในขั้นตอนที่ 6 แสดงค่าสัมประสิทธิ์ของ อัตราต่อรองลอการิทึม มาตราส่วน ซึ่งยากที่จะอธิบายให้ผู้ที่ไม่ใช่ผู้เชี่ยวชาญด้านเทคนิคเข้าใจ การแปลงเป็นอัตราส่วนความน่าจะเป็นทำให้แบบจำลองสื่อสารได้ง่ายขึ้นมาก
ทำตามสี่ขั้นตอนต่อไปนี้
- ยกกำลังสัมประสิทธิ์ ใช้ฟังก์ชัน exp() กับค่าประมาณทุกค่า เพื่อให้ค่าลอการิทึมของอัตราต่อรองกลายเป็นอัตราส่วนอัตราต่อรองแบบคูณ
- เพิ่มช่วงความเชื่อมั่น ใช้ฟังก์ชัน confint() ครอบไว้ใน exp() เพื่อให้ได้ช่วงความเชื่อมั่น 95 เปอร์เซ็นต์บนมาตราส่วนอัตราต่อรองเดียวกัน
- เปรียบเทียบค่าแต่ละค่ากับ 1 อัตราส่วนความน่าจะเป็นที่สูงกว่า 1 จะเพิ่มโอกาสของกลุ่มที่เป็นบวก ค่าที่ต่ำกว่า 1 จะลดโอกาส และค่าที่ใกล้เคียงกับ 1 หมายความว่าตัวทำนายนั้นมีประโยชน์เพียงเล็กน้อย
- ตรวจสอบความสำคัญทางสถิติ ควรตีความเฉพาะตัวแปรทำนายที่มีค่า p-value ในผลลัพธ์สรุปต่ำกว่าเกณฑ์ที่คุณเลือกไว้ ซึ่งโดยทั่วไปคือ 0.05 เท่านั้น
# Convert log-odds coefficients into odds ratios
odds_ratio <- exp(coef(logit))
round(odds_ratio, 3)

# Odds ratios with 95% confidence intervals
exp(cbind(OddsRatio = coef(logit), confint(logit)))
อ่านผลลัพธ์ ค่าสัมประสิทธิ์ของชั่วโมงต่อสัปดาห์ในแบบจำลองของเราคือ 0.41942 เมื่อยกกำลังจะได้ exp(0.41942) = 1.52 ซึ่งหมายความว่า การเพิ่มขึ้นหนึ่งส่วนเบี่ยงเบนมาตรฐานของชั่วโมงทำงานต่อสัปดาห์ จะเพิ่มโอกาสในการมีรายได้มากกว่า 50 บาท ประมาณ 1.5 เท่า โดยที่ตัวแปรอื่นๆ คงที่
สัมประสิทธิ์ที่เป็นลบก็ทำงานในลักษณะเดียวกัน marital.statusNot_married คือ -2.50346 ดังนั้น exp(-2.50346) = 0.08: บุคคลที่ยังไม่แต่งงานมีโอกาสประมาณ 8 เปอร์เซ็นต์ของบุคคลที่แต่งงานแล้ว เนื่องจากตัวแปรทำนายแบบต่อเนื่องได้รับการทำให้เป็นมาตรฐานในขั้นตอนที่ 1 แล้ว จึงควรอธิบายการเปลี่ยนแปลงในหน่วยส่วนเบี่ยงเบนมาตรฐาน ไม่ใช่หน่วยชั่วโมงดิบ
หมายเหตุสำหรับครอบครัวอื่นๆ: ค่าสัมประสิทธิ์ที่ยกกำลังแล้วจะเป็นอัตราส่วนความน่าจะเป็นเฉพาะภายใต้ตระกูลทวินามที่มีฟังก์ชันเชื่อมโยงแบบ logit เท่านั้น หากใช้ตระกูล “poisson” และฟังก์ชันเชื่อมโยงแบบ log ค่า exp() เดียวกันจะถูกอ่านเป็นอัตราส่วนอัตราแทน
GLM ใน R: คู่มืออ้างอิงฟังก์ชันฉบับย่อ
โปรดวางตารางนี้ไว้ข้างๆ ขณะที่คุณเขียนโค้ด ตารางนี้แสดงรายการฟังก์ชันทุกฟังก์ชันที่ใช้ในแปดขั้นตอนข้างต้น พร้อมด้วยแพ็กเกจที่จัดหาฟังก์ชันนั้น และอาร์กิวเมนต์ที่ฟังก์ชันนั้นต้องการ
| แพ็คเกจ | วัตถุประสงค์ | ฟังก์ชัน | ข้อโต้แย้ง |
|---|---|---|---|
| - | สร้างชุดข้อมูลฝึก/ทดสอบ | create_train_set() | ข้อมูล ขนาด รถไฟ |
| กล | ฝึกโมเดลเชิงเส้นทั่วไป | จีแอลเอ็ม() | สูตร ข้อมูล ครอบครัว* |
| กล | สรุปแบบจำลอง | สรุป() | รุ่นที่ติดตั้ง |
| ฐาน | ทำนายกัน | ทำนาย() | รุ่นที่ติดตั้ง, ชุดข้อมูล, ประเภท = 'การตอบสนอง' |
| ฐาน | สร้างเมทริกซ์ความสับสน | โต๊ะ() | ใช่ ทำนาย() |
| ฐาน | สร้างคะแนนความแม่นยำ | ผลรวม (diag (ตาราง ()) / ผลรวม (ตาราง () | |
| โรซีอาร์ | สร้าง ROC : ขั้นตอนที่ 1 สร้างการทำนาย | การทำนาย() | ทำนาย (), y |
| โรซีอาร์ | สร้าง ROC : ขั้นตอนที่ 2 สร้างประสิทธิภาพ | ผลงาน() | การทำนาย (), 'tpr', 'fpr' |
| โรซีอาร์ | สร้าง ROC : ขั้นตอนที่ 3 พล็อตกราฟ | พล็อต() | ผลงาน() |
อื่น ๆ GLM ครอบครัวที่มีสิทธิ์เข้าร่วมการโต้แย้งในครอบครัว ได้แก่:
- ทวินาม: (ลิงก์ = “logit”)
- เกาส์เซียน: (ลิงก์ = “เอกลักษณ์”)
- แกมมา: (ลิงก์ = “ผกผัน”)
- inverse.gaussian: (link = “1/mu^2”)
- ปัวซง: (ลิงก์ = “ล็อก”)
- quasi: (link = “identity”, variance = “constant”)
- ควาซิไบโนเมียล: (ลิงก์ = “โลจิต”)
- ควาซิปัวซง: (ลิงก์ = “ล็อก”)
